AI 인문학 산책
시민을 위한 인공지능 물리학 길라잡이
서문. 인공지능 시대를 맞아
2024년, 노벨 물리학상은 존 홉필드(John Hopfield)와 제프리 힌턴(Geoffrey Hinton)에게 돌아갔습니다. 이는 인공지능(AI)이 단지 컴퓨터 과학이라는 울타리에 머무는 기술이 아니라, 우주와 물질을 설명하는 물리학의 깊은 언어와 맞닿아 있음을 세계가 인정한 상징적인 사건이었습니다. 힌턴은 “기계가 스스로 표현을 배울 수 있다”는 아이디어를 오랫동안 붙잡고 있던 연구자입니다. 사람이 일일이 규칙을 주입하는 대신, 기계가 데이터의 바다에서 스스로 패턴을 찾고 맥락을 읽어내게 하려 했습니다. 신경망 연구가 철저히 외면받던 시절 그가 취한 대담하고도 외로운 선택이, 오늘날 거대 언어 모델과 생성형 AI 혁명의 진원이 되었습니다. 힌턴은 가능성이 의심받던 혹독한 겨울에도 묵묵히 불씨를 지켰고, 뒤따르는 연구자들이 딛고 올라설 튼튼한 어깨가 되었습니다. 그와 더불어 홉필드, 얀 르쿤, 요슈아 벤지오를 비롯한 수많은 연구자가 물리학과 통계학, 신경과학의 전통 위에서 함께 오늘의 인공지능 시스템을 직조해냈습니다.
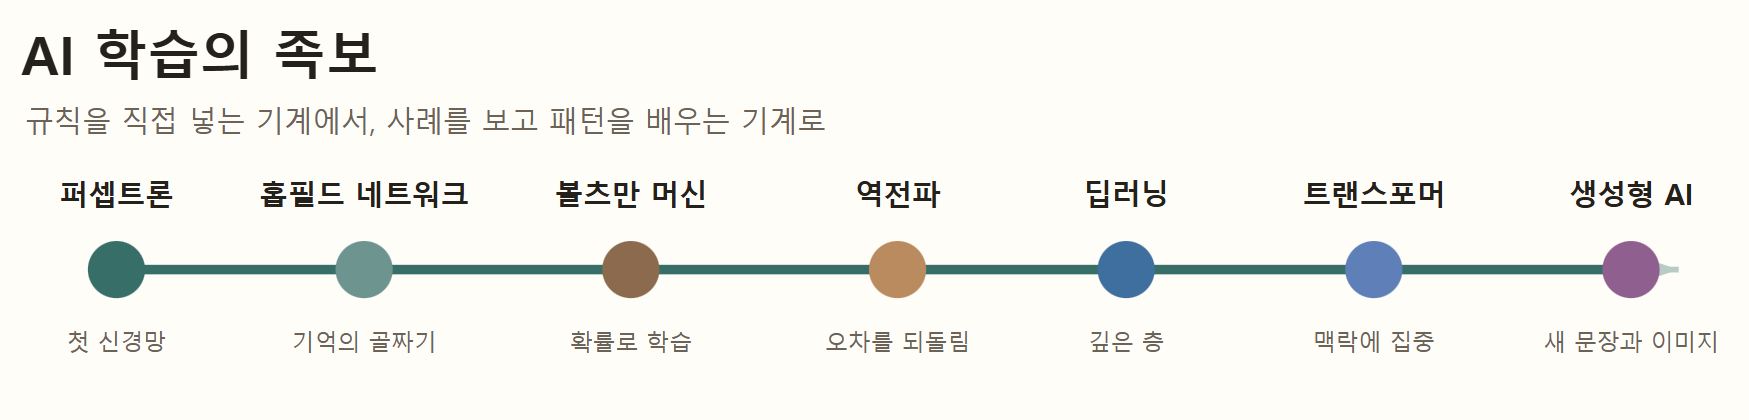
인공지능 학습의 역사는 단 한 번의 발명으로 완성된 것이 아닙니다. 여러 아이디어가 겹치고 이어지며 만들어진 긴 서사입니다. 낯선 용어가 등장하더라도, “사례를 보고 스스로 패턴을 배우는 기계”라는 큰 줄기를 붙들면 충분합니다.
흥미로운 점은, 힌턴이 자신이 세운 이 기술적 다리의 유려함만을 찬양하지 않는다는 사실입니다. 그는 다리가 견뎌야 할 하중과 보이지 않는 균열, 그리고 필수적인 안전장치에 대해 끊임없이 묻고 경고해 왔습니다. 오늘날 인공지능을 마주한 우리는 그가 평생을 바쳐 던진 두 가지 질문을 피할 수 없습니다. 하나는 “지능은 어떻게 세계를 배우는가?”이고, 다른 하나는 “우리가 창조한 지능을 어떻게 다룰 것인가?”입니다. 이 두 질문은 하나로 얽혀 있습니다. AI의 능력을 제대로 이해하려면, 그 계산이 어떤 물질적 장치 위에서 일어나는지, 데이터가 어떻게 신호로 치환되는지, 그리고 그 과정에서 막대한 에너지가 어떻게 소비되는지 알아야 합니다. 동시에 그 기계가 내놓은 결과를 누가 신뢰하고 책임질 것인지도 물어야 합니다. 물리학이 AI의 가능성과 한계를 명확히 긋는다면, 인문학은 인류의 삶과 사회적 맥락에 AI를 어떻게 배치할 것인지 물어야 합니다. 이 두 영역의 교차점을 탐구하는 것이 이 책의 과제입니다.
돌이켜보면 인공지능의 역사는 기대와 좌절이 반복된 치열한 퇴고의 과정이었습니다. 1960년대에는 인간의 사고를 기호의 조합으로 재현하려 했고, 1980년대에는 전문가 시스템이 성과를 냈으나 규칙의 경직성 앞에서 한계를 드러냈습니다. 어린아이가 문법책이 아닌 경험의 파편 속에서 언어를 배우듯, 지능 역시 정적인 규칙이 아닌 '연결' 속에서 세계를 학습해야만 했습니다. 1990년대 이후 AI는 “미리 써넣는 기계”에서 “데이터의 패턴을 읽는 기계”로 방향을 틀었습니다. 2010년대에 들어서야 GPU와 방대한 데이터가 맞물리며 딥러닝이 폭발했고, 2020년대의 생성형 AI는 이 기술을 우리의 대화 상대이자 창작의 동료로 무대 전면에 끌어냈습니다. 대형 언어모델과 멀티모달 모델은 글과 그림, 소리와 영상을 능수능란하게 오가며 하나의 완성된 씬(Scene)을 연출합니다. 하지만 화려한 화면 뒤편에는 육중한 물질의 세계가 버티고 있습니다. 고성능 반도체 칩, 거대한 데이터센터, 끊임없이 뿜어내는 냉각수, 그리고 쉼 없이 전력을 나르는 송전망과 해저 케이블이 그것입니다. 오늘날 AI 산업의 패권은 알고리즘 하나로 결정되지 않습니다. 에너지 인프라와 첨단 반도체 공급망이라는 지정학적 현실이 승패를 가릅니다. AI를 온전히 이해한다는 것은, 모니터 너머 보이지 않는 광산과 공장, 그리고 수많은 노동의 질서까지 함께 조망하는 일입니다. 기술이 눈앞에 다가올수록 관계와 책임의 문제가 도드라집니다. 의료, 법률, 행정처럼 타인의 삶에 직접적인 영향을 미치는 영역에서는 단순히 '정확도 수치'만으로 면죄부를 받을 수 없습니다. 어떤 데이터가 배제되었는지, 판단의 근거는 무엇인지 끊임없이 이의를 제기할 수 있어야 합니다. 편리함을 누리면서도 '검증의 책임'을 포기하지 않는 태도, 그것이 바로 이 시대 시민의 새로운 교양입니다. 인공지능은 단순히 답변하는 도구를 넘어 스스로 목표를 세우고 개입하는 '행동하는 시스템'으로 진화하고 있습니다. 진정한 과학적 지식은 현실 세계의 엄밀한 검증을 통과해야만 완성됩니다. 계산이 탐색의 속도를 높여줄 수는 있어도, 자연을 상대로 한 인간의 검증을 대신할 수는 없기 때문입니다. 이를 위해 이 책은 먼저 에너지, 정보, 공간 등 AI 하드웨어를 이해하는 데 필수적인 물리학의 기초를 짚어봅니다. 나아가 신경망과 데이터센터의 물리적 현실을 살피고, 이 기술이 우리의 노동과 의료, 민주주의에 어떤 파장을 일으킬지 인문학적 시선으로 되짚을 것입니다. 수식의 암기보다는 개념 간의 맥락을 연결하는 것이 이 여정의 진정한 목표입니다. 이 강의는 물리학을 전공하지 않은 시민, 교육자, 정책 담당자, 그리고 창의적인 예술가와 기획자를 위한 글입니다. 기술의 시대에 과학의 작동 원리를 모르는 것은 더 이상 겸손이 아닙니다. 과학을 모른 채 기술에만 의존한다면, 우리는 주체적인 사용자가 아니라 도구가 설계한 환경에 수동적으로 머무는 거주자로 전락하고 맙니다. 이 책이 인공지능의 모든 것을 설명할 수는 없습니다. 하지만 인공지능을 두려워하기 전에 이해하고, 맹신하기 전에 주체적으로 검증하며, 다가올 변화 앞에서 한 명의 시민으로서 더 나은 질문을 던질 수 있도록 돕는 튼튼한 지렛대가 되기를 바랍니다. 이 책에서는 『AI 인문학 산책』이라는 제목 아래 열두 번의 시민 강의가 이어집니다. 이 강의는 전문 지식을 위한 자리가 아닙니다. 현대 물리학과 인공지능을 시민의 언어로 번역하고, 그 번역을 통해 우리의 사회와 몸과 자연을 다시 읽어보는 자리입니다. 개념은 천천히 비유는 조심스럽게 다루고 과장은 되도록 문밖에 세워두겠습니다. 그러면 이제부터 현대 물리학과 인공지능이 만나는 매혹적인 산책을 시작해 봅시다.
<hr class="chapter-divider">
제1강. 인공지능 물리학
1.1 물리학은 왜 인공지능을 자기 문제로 보게 되었나
인공지능은 컴퓨터공학의 산물이라고 하는데 왜 물리학자가 여기에 관심을 가질까요? 두 갈래로 답할 수 있습니다. 하나는 인공지능이 물리적 장치 위에서 작동하기 때문이고, 다른 하나는 인공지능의 학습 방식이 물리학의 오래된 개념들과 닮아 있기 때문입니다. 첫 번째 이유는 비교적 직관적입니다. AI는 전기를 먹고 열을 뿜어냅니다. 거대한 AI를 학습시키려면 수만 개의 GPU가 필요한데, GPU는 반도체이며 반도체는 양자역학과 고체물리학이 낳은 정교한 결정체입니다. 우리가 “클라우드에서 AI가 돌아간다”고 말할 때, 그 클라우드는 하늘의 낭만적인 구름이 아닙니다. 차가운 냉각 장치, 육중한 전력망, 거대한 데이터센터라는 육중한 '물질의 몸'이 버티고 있다는 뜻입니다. 두 번째 이유는 더욱 흥미롭습니다. 인공지능이 배우는 과정은 안개 낀 산길을 내려가는 일과 비슷합니다. 처음에는 어디가 골짜기인지 막막하지만, 여러 번 발을 내디디며 더 낮고 안정된 곳을 찾아갑니다. 물리학자들은 이를 “에너지가 가장 낮은 안정 상태를 찾아가는 과정”이라 표현합니다. 홉필드 네트워크와 볼츠만 머신 같은 초기 인공지능 모델들은 바로 이런 물리학적 직관을 기계 학습에 적용한 결과물입니다.
산과 골짜기의 기억
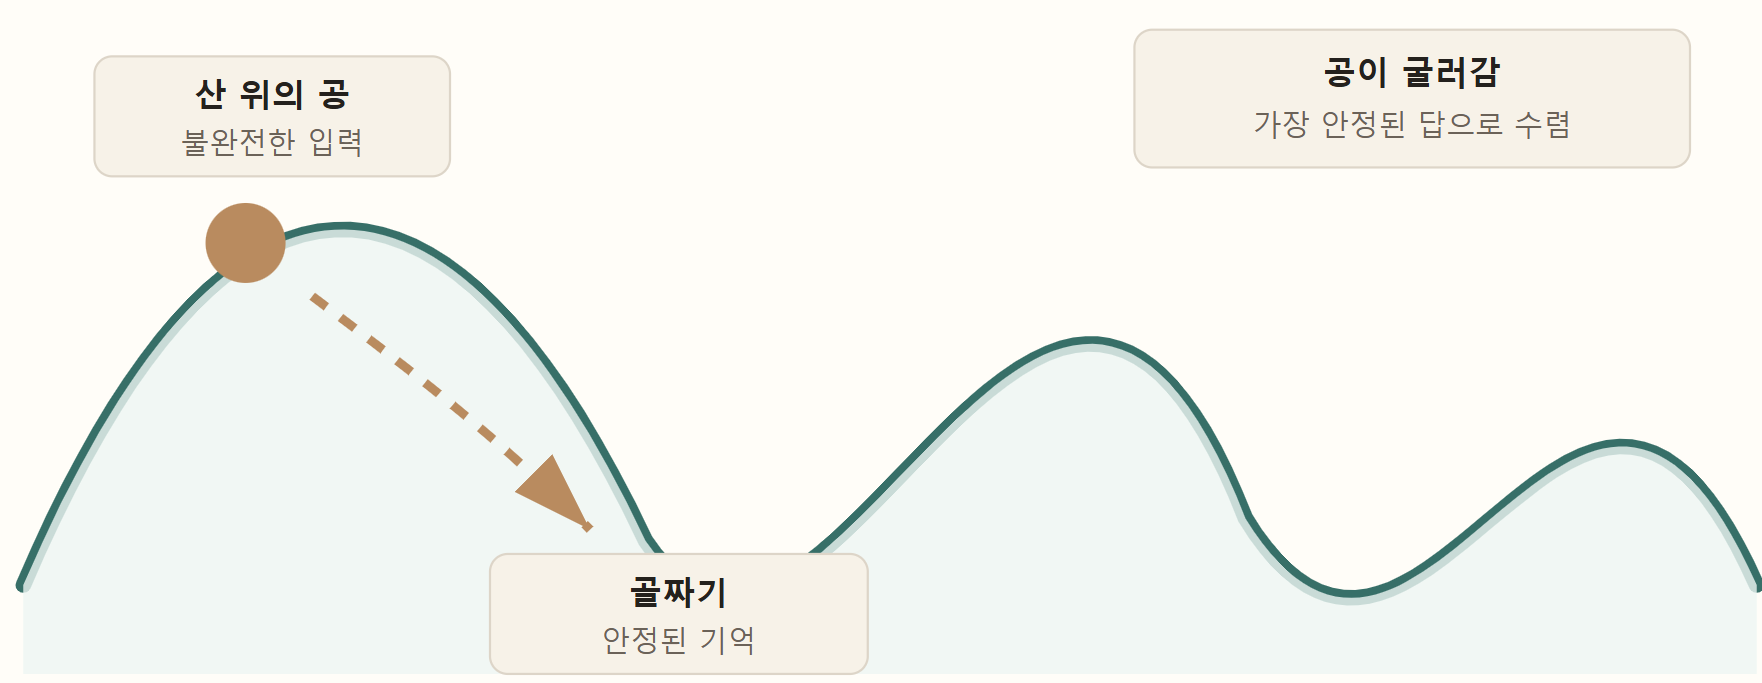
산 위의 공은 파편화된 불완전한 입력이고, 골짜기는 우리가 저장한 안정된 기억입니다. 공이 중력을 따라 골짜기로 굴러가듯, 신경망은 흐릿한 단서만으로도 가장 안정적인 패턴을 스스로 복원해 냅니다.
그러므로 인공지능 물리학은 "인공지능을 전부 물리학으로 환원하자"는 오만한 주장이 아닙니다. 오히려 "인공지능을 제대로 이해하려면 컴퓨터 공학의 코드뿐만 아니라, 자연의 원리라는 깊은 시선이 동반되어야 하지 않을까?"라는 질문입니다. 이 책이 물리학과 인문학을 교차시키는 이유가 바로 여기에 있습니다.
1.2 뉴턴의 물체에서 인공지능의 상태공간으로
고전 물리학은 물체의 ‘위치와 속도’를 추적합니다. 공이 현재 어디에 있는지, 얼마나 빠르게 날아가는지, 어떤 힘을 받아 궤적이 꺾이는지 묻지요. 여기서 가장 중요한 것은 '상태(State)'입니다. 물체의 현재 상태를 정확히 안다면 다음 상태를 예측할 수 있다는 확신, 이것이 뉴턴 역학이 가진 서사의 힘이었습니다. 인공지능에도 이러한 '현재 상태'가 있습니다. 사람으로 치면 지금까지 습득한 지식과 미처 고치지 못한 습관이 섞인 '현재의 실력'이지요. 전문가들은 이를 수많은 숫자의 묶음, 즉 '매개변수(Parameter)'라 부릅니다. 인공지능 모델은 이 매개변수들이 만드는 거대한 차원의 공간 안에서 한 점으로 존재하며, 학습이란 오차를 줄이는 방향을 향해 그 점을 조금씩 이동시키는 행위입니다. 앞으로 자주 언급하겠지만, 여기서 말하는 '모델'은 일정한 수준의 학습을 거쳐 판단과 계산 능력을 갖춘 AI의 핵심 계산 장치, 또는 학습된 신경망을 의미합니다. 가령 AI가 자동차라면 그 자동차의 엔진이 모델이라 생각하면 좋습니다.
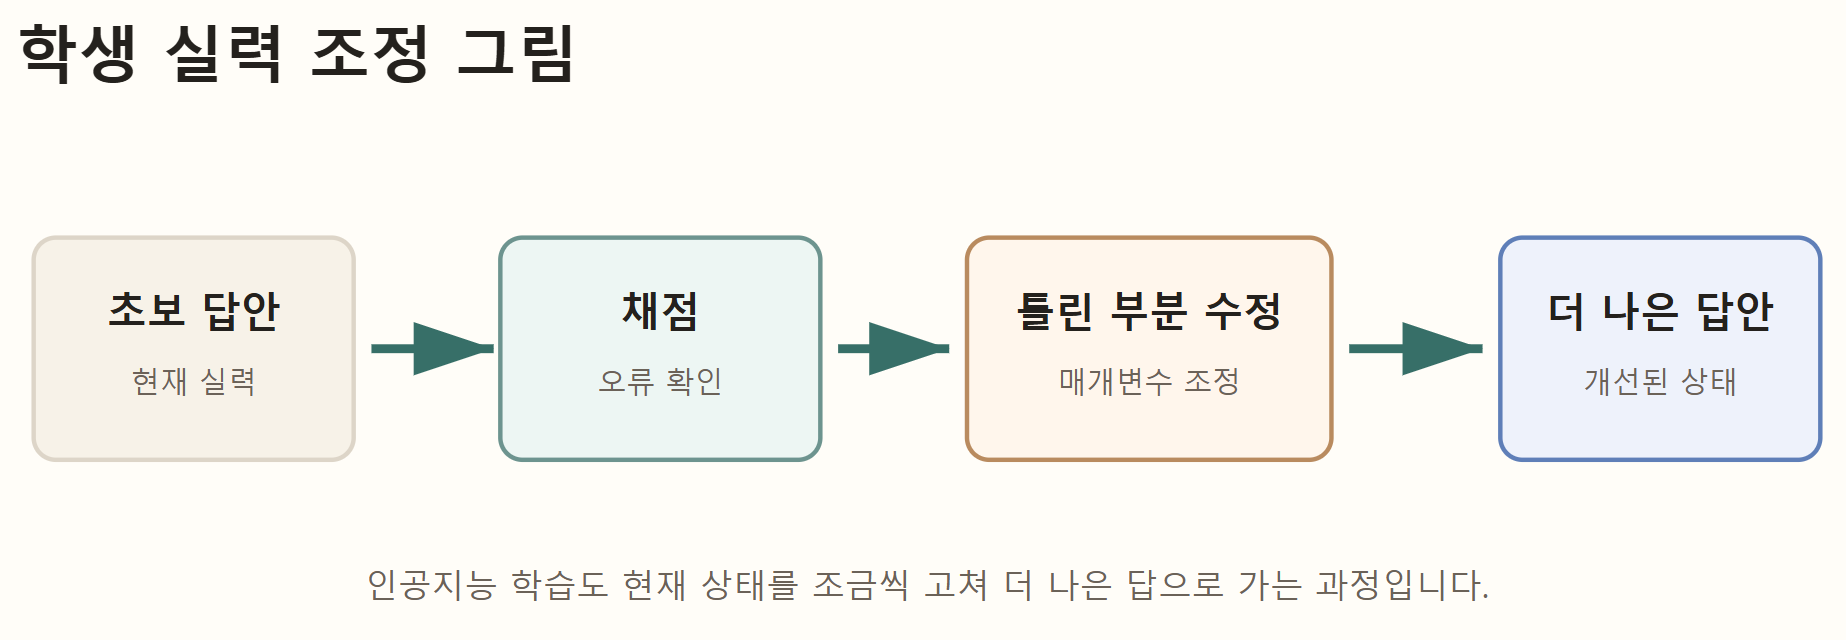
초고가 치열한 퇴고를 거쳐 완성된 원고가 되듯, 인공지능 역시 오류를 확인하고 매개변수를 세밀하게 조정하며 더 나은 상태로 진화합니다.
한 작가의 문체를 이해한다는 것은 단순히 그가 쓴 단어들을 암기하는 것이 아니라, 그가 문장을 직조해 내는 '가능성의 공간'을 감각적으로 익힌다는 말입니다. 마찬가지로 인공지능 역시 방대한 데이터의 바다를 통과하며, 그 거대한 표현의 공간 안에서 스스로의 맥락과 자리를 찾아가는 중이라고 보면 좋습니다.
1.3 힘, 에너지, 정보: 인공지능을 읽는 세 가지 물리 언어
인공지능 물리학을 읽기 위해 우리는 세 가지 렌즈를 장착해야 합니다. 힘, 에너지, 정보입니다.
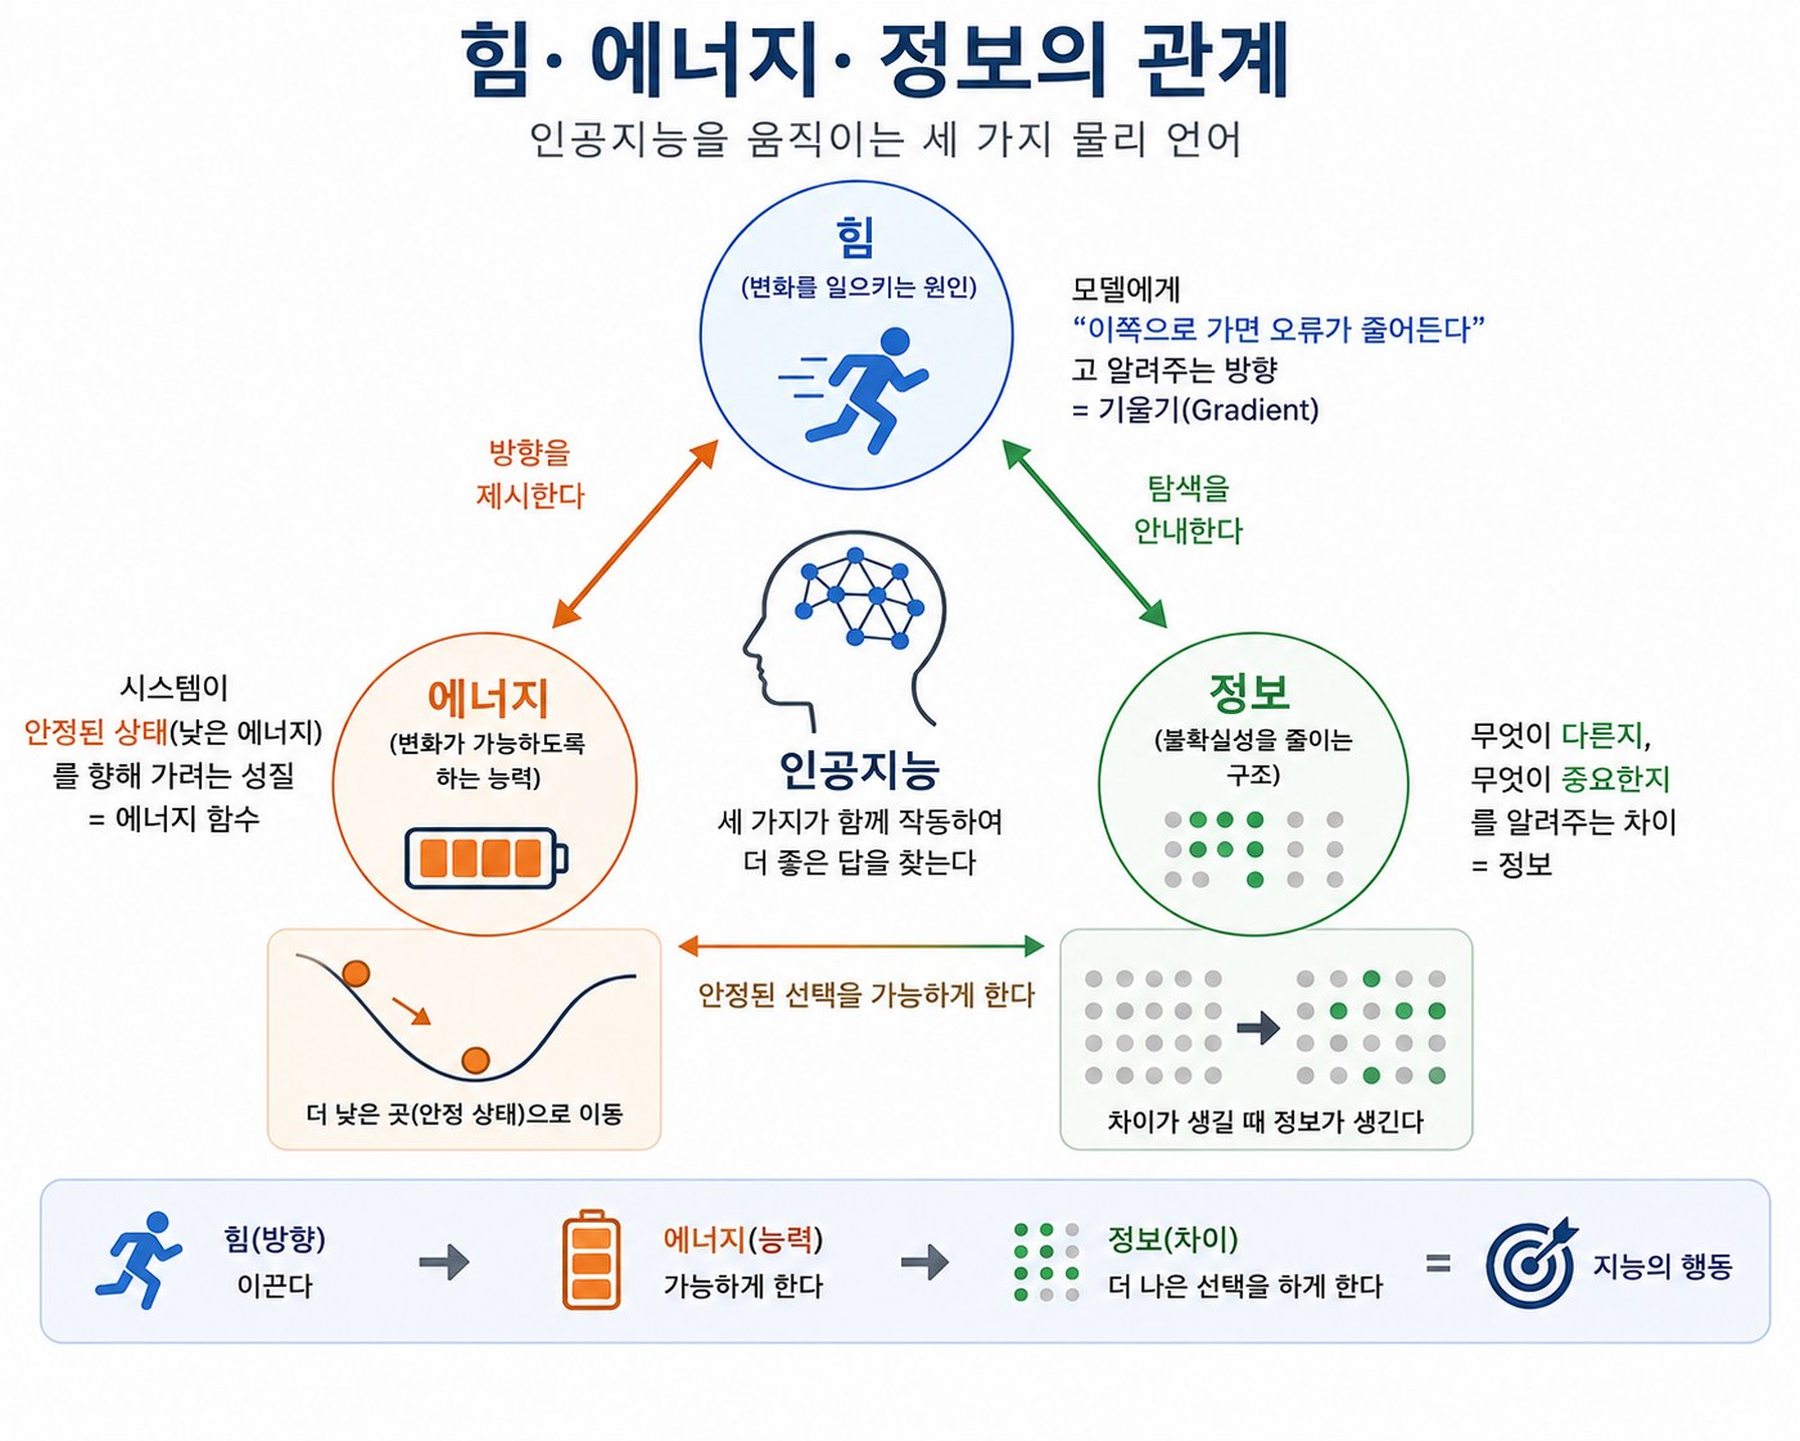
힘은 방향을, 에너지는 동력을, 정보는 질서를 줍니다. 이 셋이 조화롭게 얽힐 때 지능은 비로소 도약합니다.
비유하자면 힘은 길을 보여주고, 에너지는 그 길을 갈 수 있게 해주며, 정보는 무엇을 믿고 선택해야 할지 알려줍니다. 그러면 인공지능에서 힘에 해당하는 것은 무엇일까요? 엄밀히 말해 신경망 안에 뉴턴식 힘이 있는 것은 아닙니다. 그러나 비유적으로는 기울기(gradient)가 힘처럼 작동합니다. 손실함수의 기울기는 모델에게 “이쪽으로 움직이면 오류가 줄어든다”고 알려줍니다. 에너지는 조금 더 직접적인 관계를 지닙니다. 홉필드 네트워크에서는 실제로 에너지 함수라는 개념이 쓰입니다. 시스템은 에너지가 낮은 안정 상태로 가려 하고, 그 안정 상태가 기억의 역할을 합니다. 여러분이 어떤 노래의 앞부분만 듣고 나머지를 떠올리는 것처럼, 신경망은 불완전한 입력에서 안정된 기억 패턴으로 수렴해 갑니다. 정보는 우리에게 가장 익숙한 언어입니다. 인공지능은 데이터에서 정보를 추출하는데, 이 정보는 단순히 많은 데이터가 아닙니다. 같은 말을 반복해서 백만 번 들려주는 것은 가치 있는 정보가 아닙니다. 그와 달리 서로 다른 상황에서 어떤 패턴이 반복되는지를 알려주는 데이터는 가치 있는 정보가 됩니다. 정보는 구별을 가능하게 하는 차이입니다. 기호학자 움베르토 에코의 통찰처럼, 도서관 바닥에 아무렇게나 흩어진 책 더미는 지식이 아닙니다. 섬세한 분류 체계와 맥락이라는 '질서'가 부여될 때 비로소 의미가 탄생합니다. 물리학에서 엔트로피가 질서와 무질서의 관계라면, 인문학에서 의미는 기호가 조직되는 방식입니다. 인공지능이 데이터를 학습한다는 것은 결국 무질서한 파편 속에서 정교한 구조를 읽어내는 해석적 행위입니다.
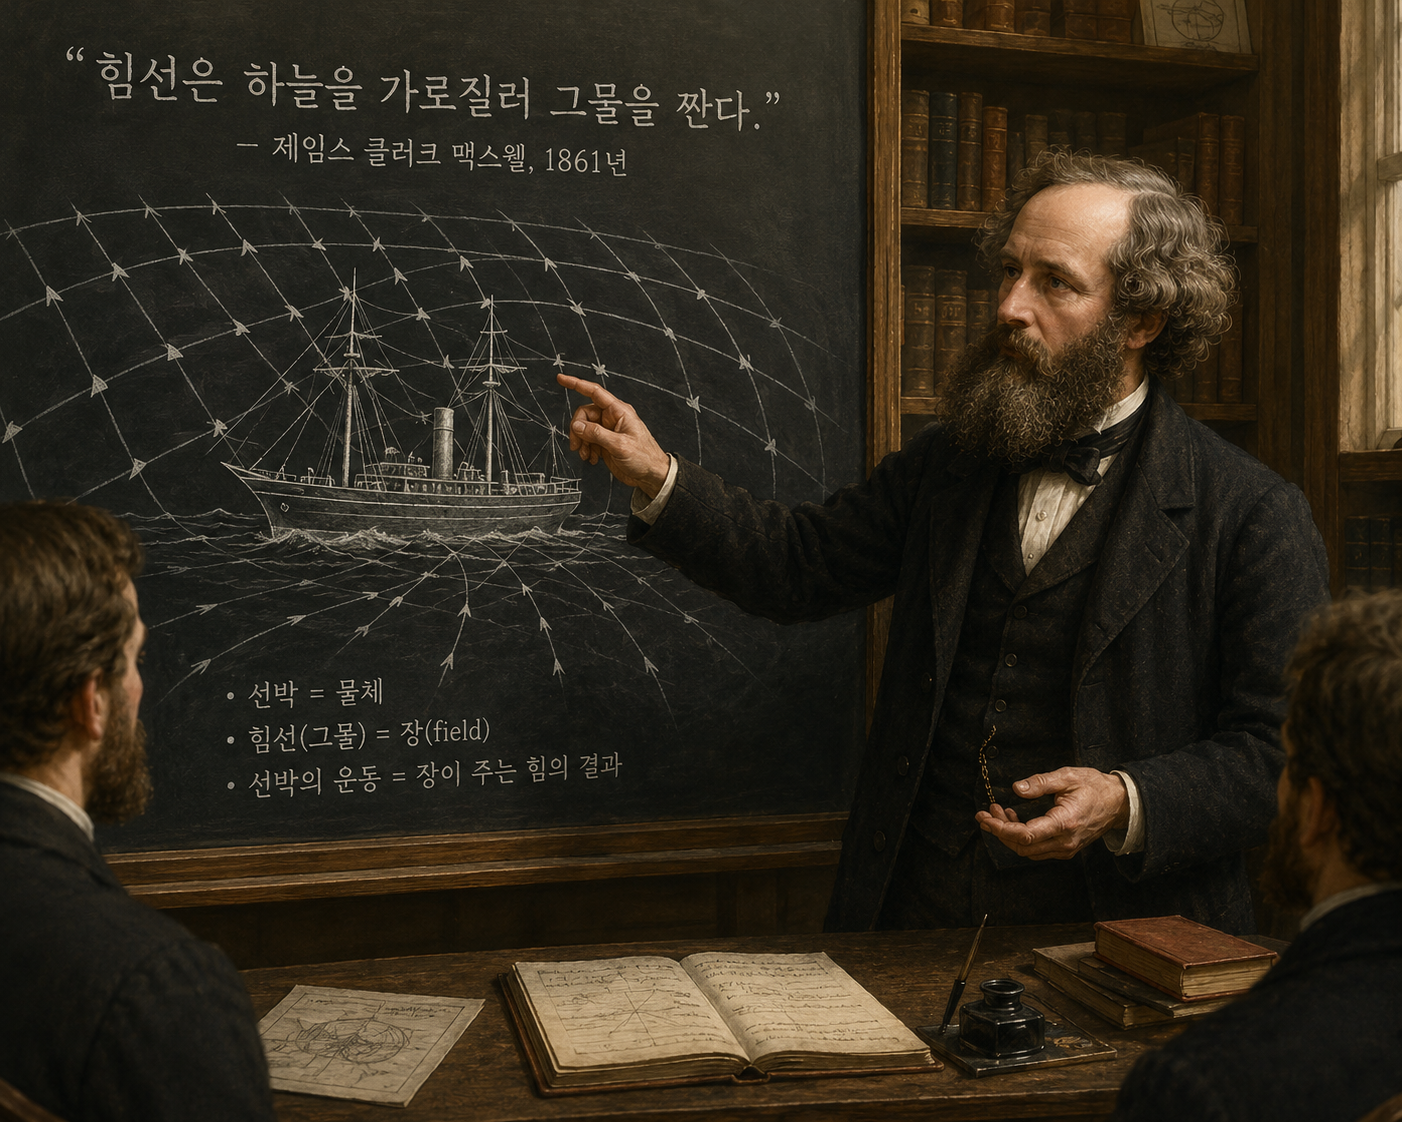
> 맥스웰이 본 힘선의 상상력 > 맥스웰은 1857년 패러데이에게 보낸 편지에서 힘선(lines of force)이 “하늘을 가로질러 그물을 짠다”고 표현했습니다. 이 짧은 문장은 장(field) 개념의 역동성을 잘 보여 줍니다. 보이지 않는 관계가 공간을 채우고, 그 관계가 물체의 운동을 이끕니다. 인공지능의 신경망을 볼 때도 비슷한 감각이 필요합니다. 뉴런 하나가 아니라 연결 전체의 장을 보아야 합니다. > 장 개념을 설명하는 맥스웰
1.4 통계물리학과 신경망의 만남
통계물리학은 많은 입자가 모일 때 나타나는 집단적 성질을 다루는 물리학의 한 분야입니다. 이를 이용하면 물 분자 하나하나의 움직임을 모두 계산하지 않아도 우리는 온도, 압력, 엔트로피 같은 거시적 개념을 사용할 수 있습니다. 이때 중요한 것은 개별 입자가 아니라 집단의 패턴입니다. 신경망도 비슷합니다. 뉴런 하나, 가중치 하나만 보아서는 모델의 행동을 이해하기 어렵습니다. 그러나 수많은 뉴런과 가중치가 함께 작동하면 분류, 번역, 생성, 추론처럼 보이는 거시적 기능이 나타납니다. 물리학자는 이런 현상을 낯설어하지 않습니다. 이미 물리학은 “많은 작은 것들이 모여 전혀 다른 큰 성질을 만든다”는 문제를 오래 다루어왔기 때문입니다.
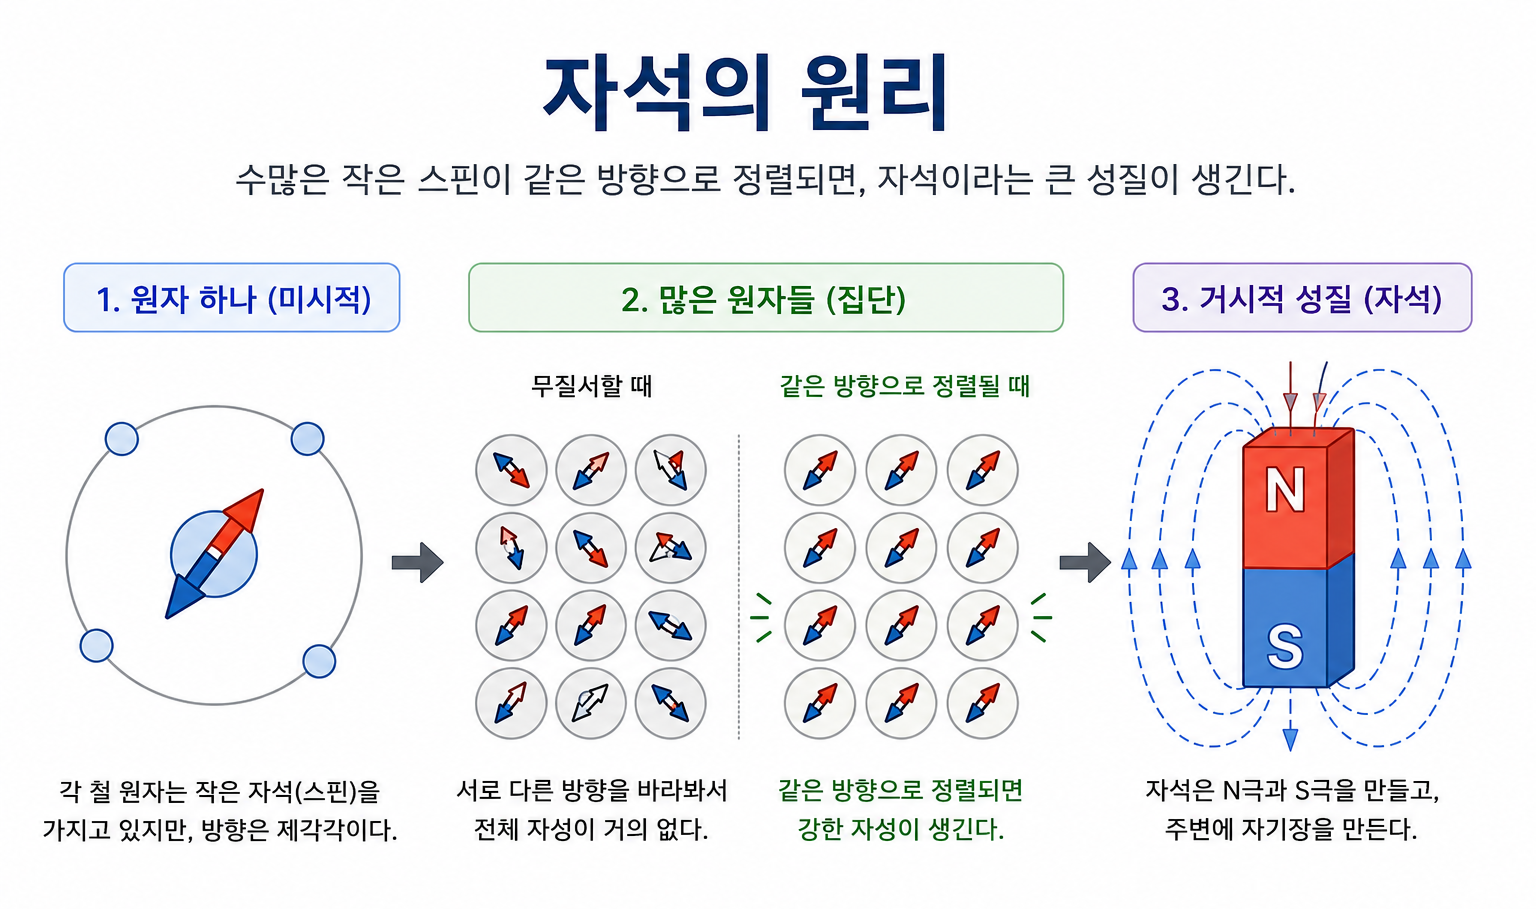
작은 스핀들이 정렬될 때 '자석'이라는 완전히 새로운 성질이 탄생하듯, 무수한 신경망 연결은 '추론과 생성'이라는 거대한 지능을 빚어냅니다.
이 비유는 인공지능을 신비화하지 않게 해줍니다. 인공지능이 갑자기 “마음”을 얻었다고 말하기 전에, 우리는 물어야 합니다. “어떤 물리적 구조가 어떤 기능을 만들고 있는가?” 하고 말입니다. 통계물리학은 바로 이런 질문을 훈련시켜 줍니다.
1.5 홉필드 네트워크: 기억은 에너지 골짜기다
어린 시절 즐겨 듣던 노래의 첫 소절만 들어도 나머지 가사가 저절로 입가에 맴돌았던 경험이 있을 것입니다. 우리 뇌는 완벽한 입력을 기다리지 않습니다. 파편화된 단서만으로도 전체의 맥락을 스스로 복원해 내지요. 이처럼 우리의 기억은 언제나 완전한 정보를 기다리지 않습니다. 작은 단서만 주어져도 나머지 부분을 스스로 채워 넣습니다. 과학자들은 오래전부터 이런 신기한 능력을 컴퓨터로 흉내 낼 수 없을까 고민했습니다. 이를 설명하기 위해 물리학에서 가져온 흥미로운 비유가 있습니다. 산과 골짜기가 있는 지형을 상상해 봅시다. 공을 산비탈 어디에 놓더라도 결국 가장 가까운 골짜기로 굴러가 멈춥니다. 공의 출발점은 조금씩 달라도, 같은 골짜기 근처에 있다면 결국 같은 곳에 도착합니다. 우리의 기억도 비슷하게 생각할 수 있습니다. 흐릿한 단서에서 시작하더라도 생각은 익숙한 기억으로 흘러갑니다. 마치 공이 골짜기로 굴러가듯 말입니다. 1980년대 물리학자 존 홉필드(John Hopfield)는 이러한 아이디어를 이용해 기억을 설명하는 인공지능 모델을 제안했습니다. 이것이 홉필드 네트워크(Hopfield network)에서 말하는 에너지 지형(Energy Landscape)입니다. 홉필드의 설명에 따르면 각각의 기억은 산속의 깊은 골짜기이며 우리의 생각은 그 산비탈 위에 놓인 공과 같습니다. 흐릿한 단서가 주어지면, 공은 가장 가까운 골짜기로 굴러떨어져 '완벽한 기억'의 상태로 수렴합니다. 이는 기억이 단순한 '창고'가 아니라, 의미가 흘러가는 '지형'임을 시사합니다.
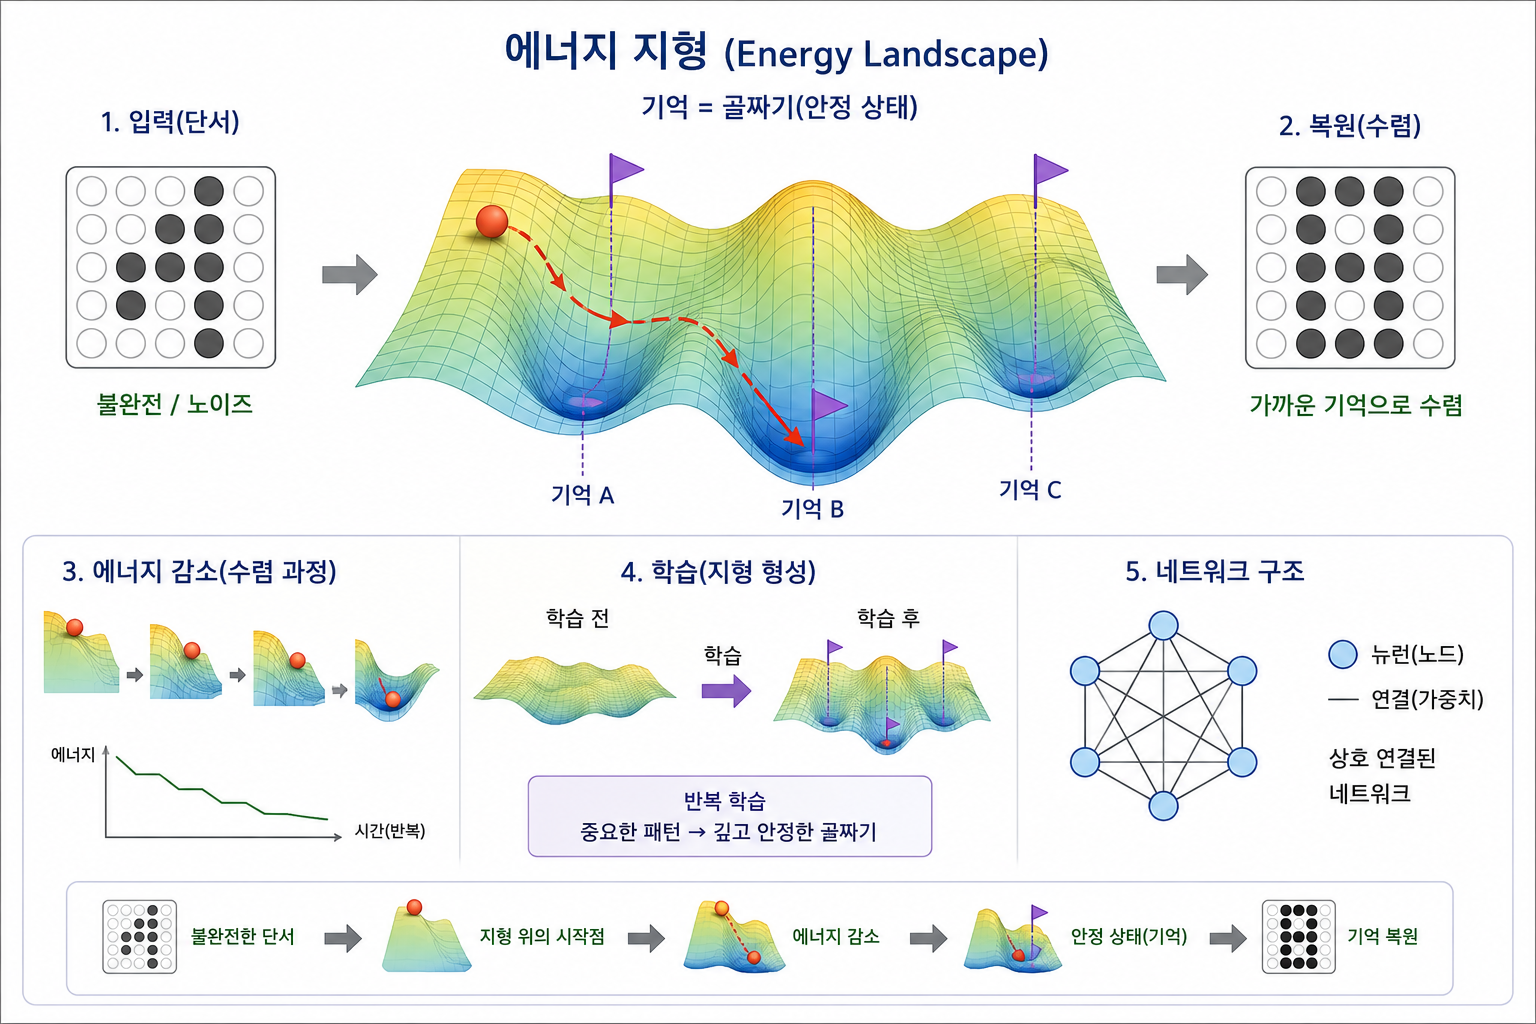
불완전한 입력값이 주어져도 신경망은 가장 이끌림이 강한 기억의 골짜기로 굴러가 온전한 패턴을 재생해 냅니다.
이 비유는 매우 인문학적이기도 합니다. 기억은 머릿속 창고에 정보를 차곡차곡 저장하는 일이 아니라, 의미의 지형을 만드는 일에 가깝습니다. 어떤 단서가 주어졌을 때 우리의 생각은 익숙한 골짜기로 흘러갑니다. 인간의 습관, 편견, 상상력도 어쩌면 이런 지형을 갖고 있을지 모릅니다.
플라톤의 《메논》과 떠올림의 철학
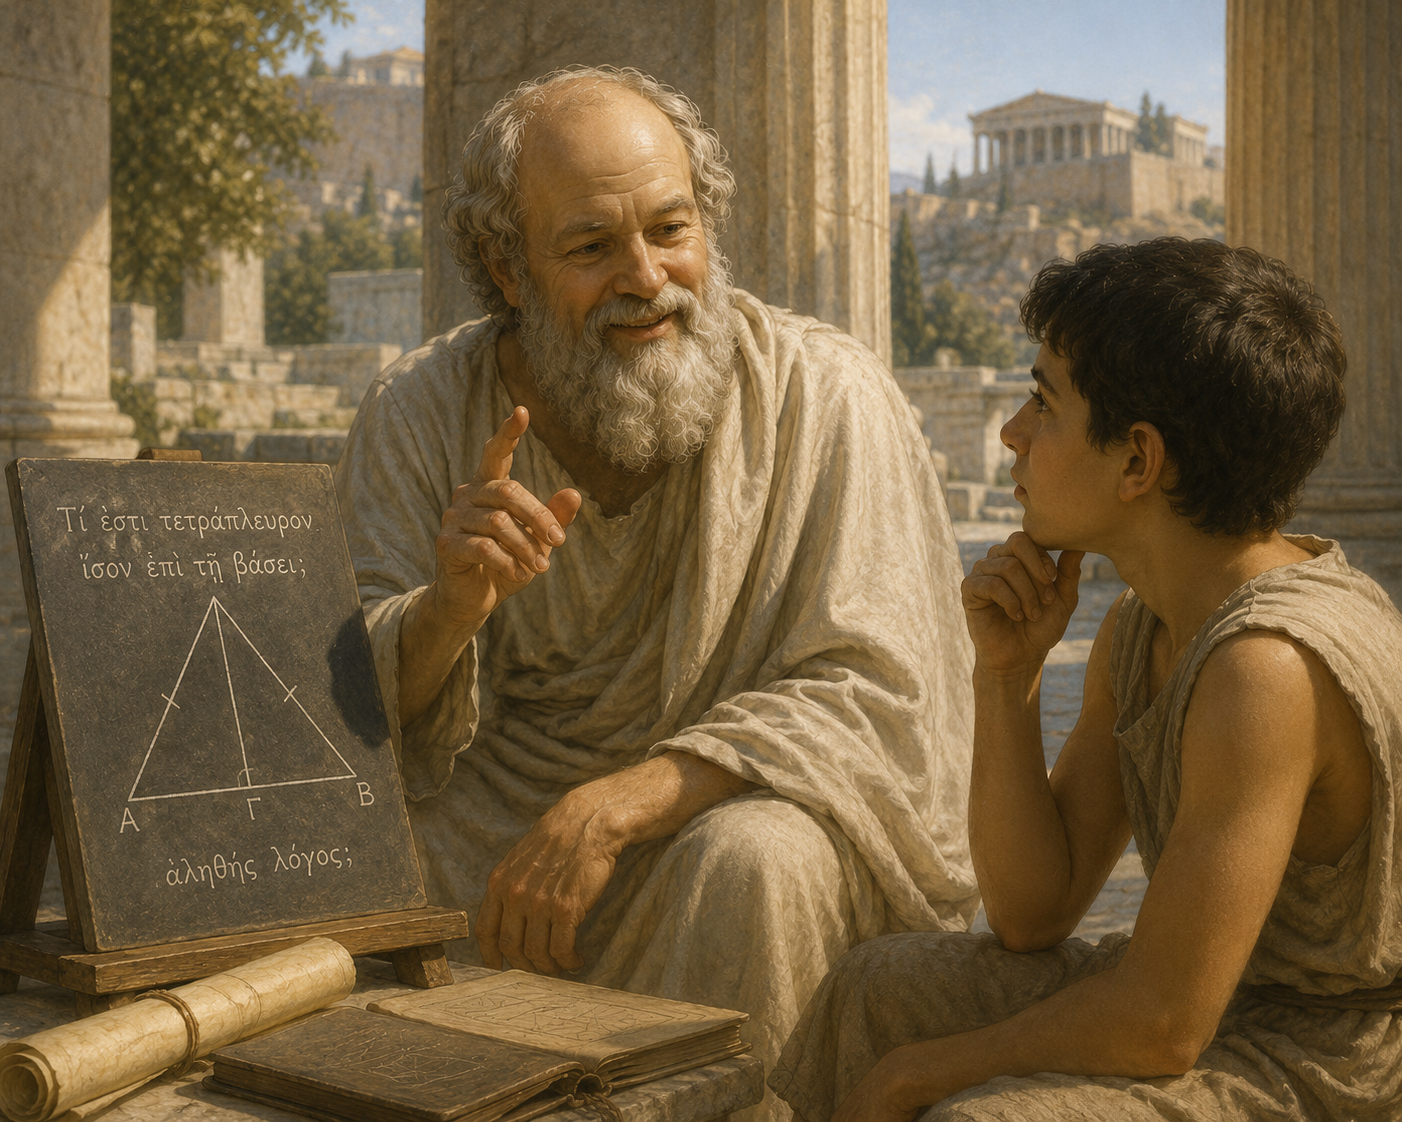
플라톤은 《메논》에서 '소크라테스가 교육받지 못한 소년에게 기하학 문제를 묻는 장면'을 소개합니다. 소년은 정답을 모르지만 질문을 따라가면서 스스로 답에 가까워집니다. 그런 다음 플라톤은 '배움'이란 단순히 새로운 지식을 밖에서 받아들이는 일이 아니라, 잊고 있던 것을 다시 떠올리는 과정이라 설명했습니다. 이를 흔히 ‘상기’라고 부릅니다. 물론 오늘날 우리는 지식을 플라톤처럼 영혼의 기억으로 설명하지는 않습니다. 그러나 일부 단서에서 전체를 되살리는 경험은 여전히 중요합니다. 흥미롭게도 홉필드 네트워크 역시 완전한 정보를 처음부터 새로 만드는 것이 아니라, 흐릿한 단서에서 저장된 패턴을 복원합니다. 2400년 전 철학자의 질문이 오늘날 인공지능의 기억 모델과 뜻밖의 자리에서 만나는 셈입니다.
소년에게 기하학 문제를 묻는 소크라테스
1.6 볼츠만 머신: 학습은 확률 지형을 조정하는 일이다
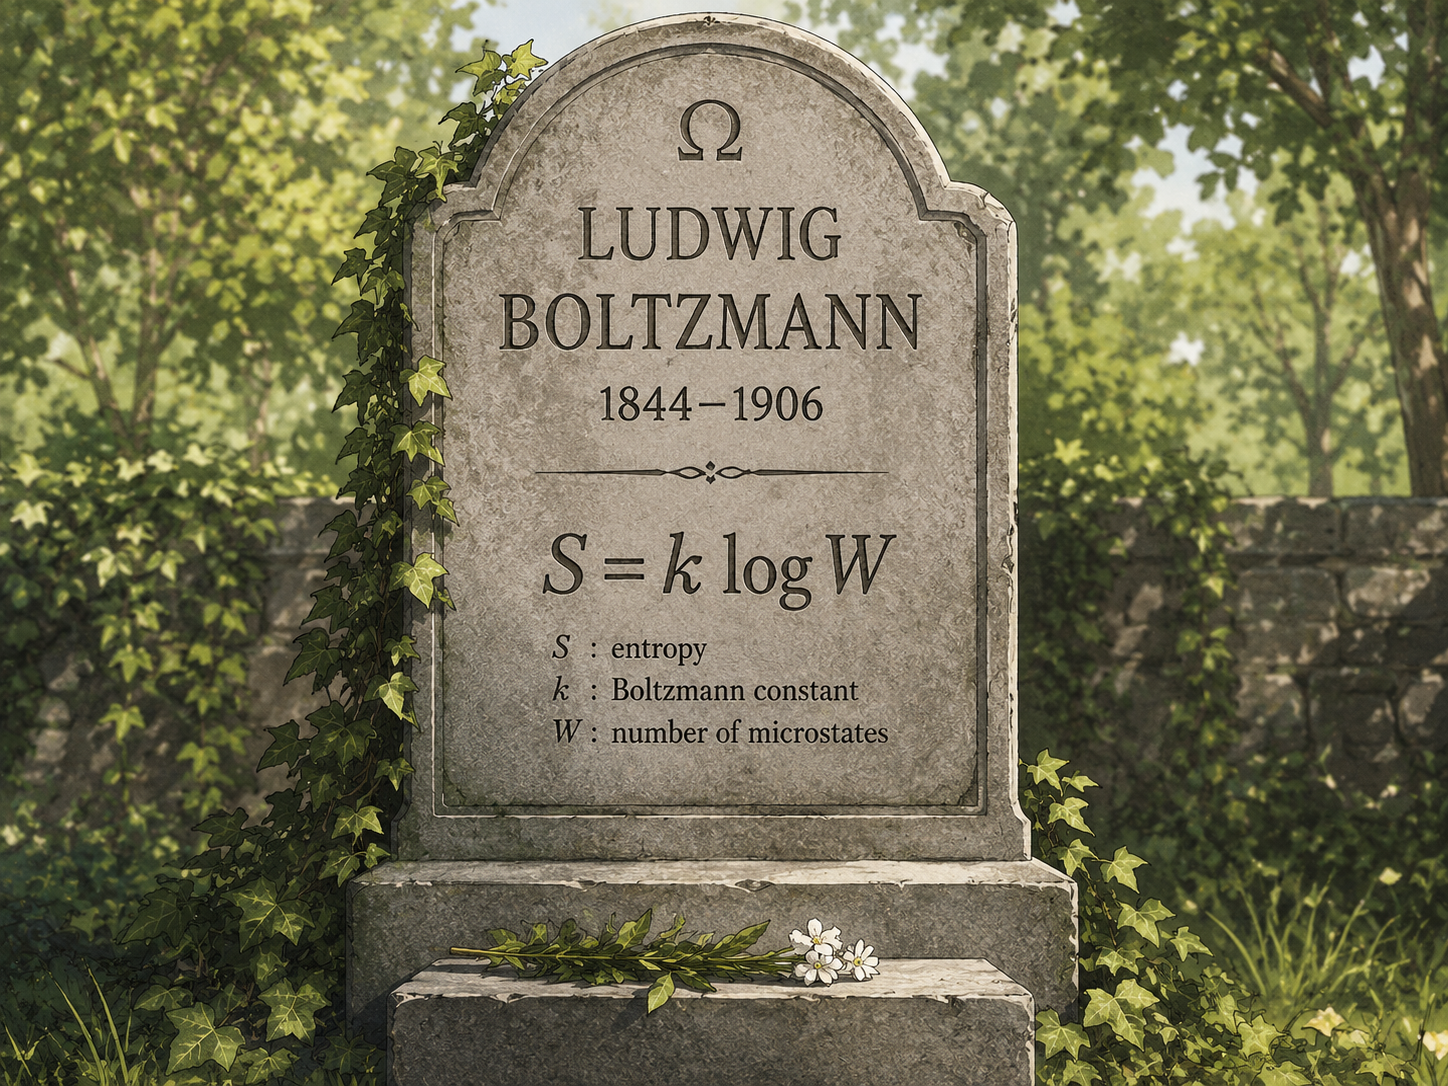
"오늘 날씨가..."라는 문장을 듣는 순간, 우리 머릿속엔 '좋다', '흐리다', '춥다' 등 수많은 가능성이 동시에 떠오릅니다. 지능은 고정된 정답을 맞히는 사격술이 아니라, 가능성의 미로 속에서 가장 그럴듯한 서사를 골라내는 공간 지각력입니다. 사람의 판단은 생각보다 자주 이런 방식으로 이루어집니다. 소설의 다음 전개를 예상할 때도, 친구의 반응을 짐작할 때도, 우리는 하나의 답을 계산하기보다 여러 가능성 가운데 더 그럴듯한 것을 선택합니다. 물리학에도 비슷한 생각이 있습니다. 주사위를 던지기 전에는 어떤 숫자가 나올지 알 수 없습니다. 그러나 각 숫자가 나올 가능성은 이야기할 수 있습니다. 많은 물리 현상도 마찬가지입니다. 공기 분자 하나하나의 움직임을 모두 계산할 수는 없지만, 어떤 상태가 더 자주 나타날지는 알 수 있습니다. 19세기 물리학자 루드비히 볼츠만(Ludwig Boltzmann)은 이러한 확률적 사고를 이용해, 수많은 입자의 무작위 운동 속에서도 전체적으로는 일정한 패턴이 나타난다고 보았으며, 연구 끝에 다음과 같은 공식을 내놓았습니다.
<p>S = k log W<br> (엔트로피 S는 세계를 이루는 가능한 미시상태의 수 W의 로그값에 볼츠만 상수 k를 곱한 값으로 나타난다.)</p>
이 공식은 "겉보기에 같은 상태처럼 보여도, 그 상태를 만들어낼 수 있는 내부 배열의 수가 많을수록 자연은 그쪽으로 더 쉽게 흘러간다"는 사실을 말해주는 것이며, 그 ‘가능성의 크기’를 물리량으로 나타낸 값이기도 합니다. 흥미롭게도 볼츠만의 묘비에 이 공식이 새겨져 있는데, 말하자면 "우주가 얼마나 많은 가능성을 품고 있는지 알리려 한 유언장"인 셈입니다.
루드비히 볼츠만의 묘비
이러한 아이디어를 바탕으로 만들어진 인공지능 모델이 볼츠만 머신(Boltzmann machine) 입니다. 볼츠만 머신은 정답 하나를 저장하는 대신, 가능한 여러 상태 가운데 어떤 상태가 더 그럴듯한지를 학습합니다. 즉, "무엇이 맞는가?"보다 "무엇이 더 자주 나타나는가?"를 배웁니다. 생성형 인공지능도 이와 비슷한 방식으로 작동합니다. "오늘 날씨가" 다음에 올 말을 하나만 외우는 것이 아니라, 다양한 후보 가운데 어떤 말이 더 자연스러운지를 확률적으로 판단합니다. 이 관점에서 보면 지능은 언제나 하나의 정답을 찾아내는 능력만은 아닙니다. 오히려 수많은 가능성 가운데 어떤 가능성이 더 그럴듯한지를 조직하는 능력에 가깝습니다. 문학작품을 읽을 때도 마찬가지입니다. 한 문장이 반드시 하나의 의미만 갖는 것은 아닙니다. 우리는 여러 가능한 해석을 떠올리고, 그중 가장 설득력 있는 의미를 찾아갑니다.
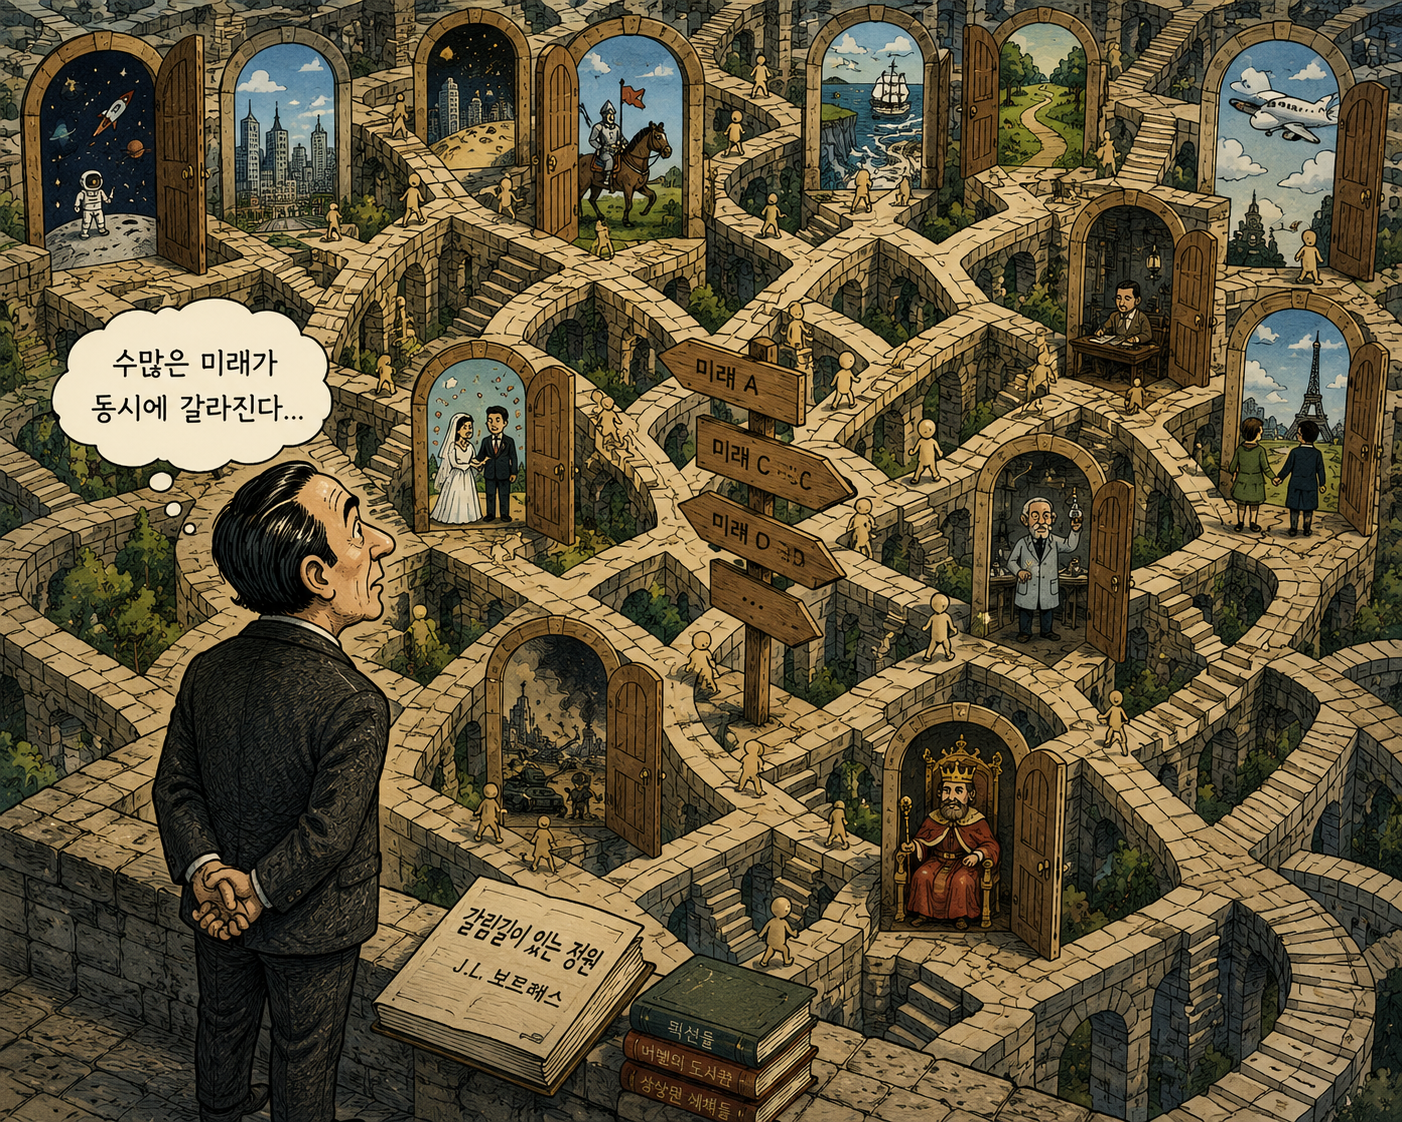
보르헤스의 《갈림길이 있는 정원》과 가능성의 미로
호르헤 루이스 보르헤스의 단편 《갈림길이 있는 정원》에는 수많은 미래가 동시에 갈라지는 미로 같은 세계가 등장합니다. 한 인물이 어떤 선택을 하느냐에 따라 서로 다른 이야기들이 펼쳐지고, 길은 하나로 닫히지 않습니다. 볼츠만 머신도 하나의 정답만 찾는 기계가 아닙니다. 여러 가능한 상태의 풍경을 동시에 놓고, 어떤 상태가 더 그럴듯한지 확률적으로 살핍니다. 그래서 이 모델을 이해할 때는 정답표보다 미로를 떠올리는 편이 좋습니다. 지능은 때로 길 하나를 고르는 능력이 아니라, 갈림길 전체의 지도를 그리는 능력입니다.
보르헤스의 《갈림길이 있는 정원》
1.7 2024년 노벨 물리학상과 인공지능 물리학의 상징성
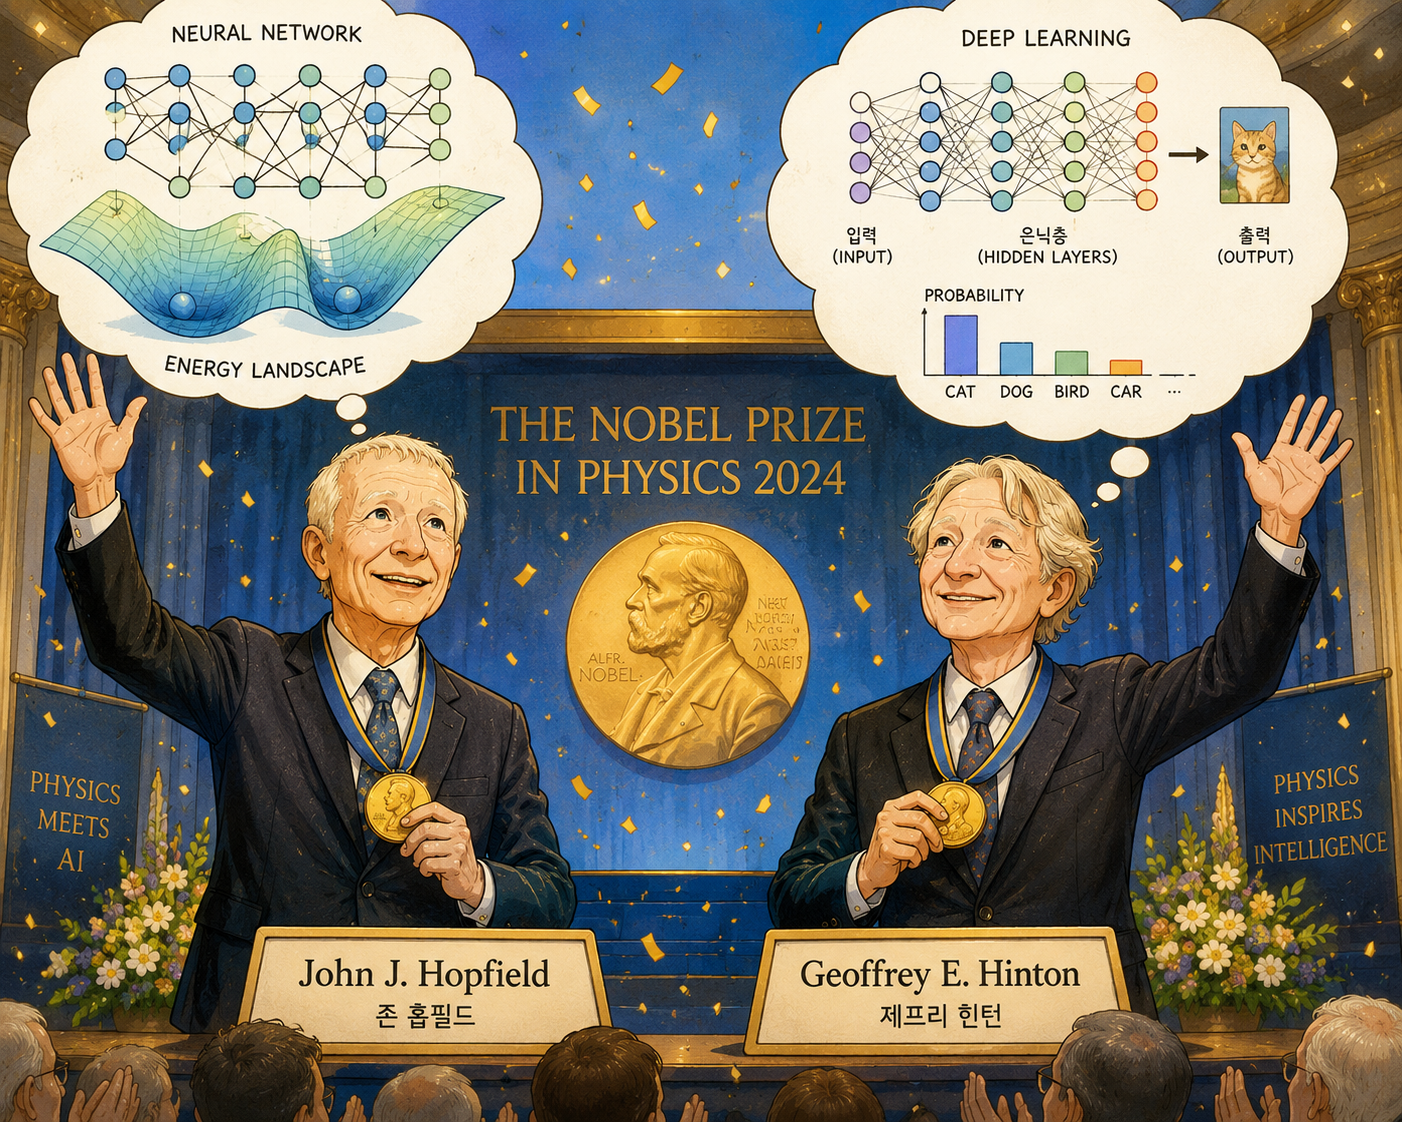
2024년 노벨 물리학상이 홉필드와 힌턴에게 돌아간 것은, 인공지능이 더 이상 공학의 울타리에 갇힌 기술이 아니라 우주와 물질을 설명하는 물리학의 언어와 맞닿아 있음을 세계가 공인한 사건입니다. 홉필드는 신경망을 물리계처럼 보았습니다. 힌턴은 볼츠만 머신과 딥러닝의 발전에 결정적 역할을 했습니다. 그들은 인공지능을 생명 없는 코드가 아니라 약동하는 물리계로 상상했습니다. 이 여정은 "컴퓨터도 사람처럼 논리적으로 생각할 것"이라는 초창기의 순진한 상상을 부수고, 연결과 패턴, 확률적 질서라는 지극히 물리적인 세계관 위에서 피어난 성취입니다. 비전공자에게 이 사건은 무엇을 말해줄까요? 학문은 생각보다 훨씬 많이 섞여 있다는 것입니다. 물리학, 심리학, 컴퓨터과학, 인지과학, 생물학이 서로의 언어를 빌려 새로운 분야를 만듭니다. 인공지능 물리학은 그런 경계 넘기의 대표 사례입니다. 또 하나 중요한 점이 있습니다. 힌턴은 인공지능의 가능성뿐 아니라 위험도 경고해왔습니다. 즉 인공지능 물리학은 단지 기술 찬양의 학문이 아닙니다. 강력한 기술이 어떤 물질적 조건과 사회적 결과를 갖는지 묻는 학문이기도 합니다.
존 홉필드와 제프리 힌턴
> 신경망 이론 60년 : 약사 > > 신경망의 역사는 기계가 인간의 마음을 단번에 흉내 낸 성공담이 아니라, 기대와 좌절을 여러 차례 통과하며 조금씩 학습 능력을 키워온 긴 시행착오의 역사입니다. 1950년대 말과 1960년대에는 퍼셉트론(perceptron)이 등장했습니다. 퍼셉트론은 여러 입력값에 각각의 중요도, 곧 가중치를 붙인 뒤 그 합이 일정 기준을 넘는지에 따라 판단하는 초기 신경망 모델이었습니다. 구조는 단순했지만, 기계도 경험을 통해 스스로 판단 기준을 조정할 수 있다는 상상력을 열어주었습니다. > > 그러나 단층 신경망, 곧 입력층과 출력층만 가진 얕은 신경망은 복잡한 문제 앞에서 곧 한계를 드러냈습니다. 특히 배타적 논리합(XOR) 문제는 그 한계를 상징하는 사례가 되었습니다. XOR은 두 조건 가운데 하나만 참일 때 참이 되는 문제인데, 단순한 직선 하나로는 답을 나눌 수 없기 때문에 단층 퍼셉트론으로는 해결하기 어려웠습니다. 이 한계가 알려지면서 신경망 연구에 대한 기대는 크게 식었고, 인공지능 연구는 첫 번째 ‘겨울’, 곧 투자와 관심이 줄어드는 침체기를 맞았습니다. > > 1980년대에는 다층 신경망과 오차역전파가 다시 길을 열었습니다. 다층 신경망은 입력과 출력 사이에 여러 개의 중간층을 두어 더 복잡한 패턴을 배울 수 있게 한 구조이고, 오차역전파는 모델이 낸 답이 실제 정답과 얼마나 다른지를 계산한 뒤, 그 오차를 출력층에서 입력층 쪽으로 거꾸로 보내며 각 연결의 가중치를 조금씩 고치는 학습 방법입니다. 말하자면 기계에게 “어디서 얼마나 틀렸는지 되짚어보고, 다음번에는 덜 틀리도록 고치는 절차”가 주어진 셈입니다. > > 제프리 힌턴, 데이비드 럼멜하트, 로널드 윌리엄스 등을 비롯한 연구자들의 작업은 이 흐름에서 중요한 전환점이 되었습니다. 하지만 당시에는 깊은 신경망을 안정적으로 학습시키기 어려웠고, 계산 능력과 데이터도 충분하지 않았습니다. 신경망은 가능성을 인정받았지만, 아직 널리 쓰일 만큼 강력한 도구가 되지는 못했습니다. 다시 긴 우회로가 시작되었습니다. > > 2000년대 후반과 2010년대에 들어 상황은 크게 바뀌었습니다. 인터넷은 방대한 데이터를 만들어냈고, 그래픽처리장치(GPU)는 원래 게임 화면을 빠르게 그리기 위해 개발된 병렬 계산 장치였지만, 수많은 계산을 동시에 처리해야 하는 신경망 학습에도 잘 맞았습니다. 여기에 더 나은 신경망 구조가 더해지면서 딥러닝, 곧 여러 층을 쌓아 복잡한 패턴을 배우는 신경망 기술의 봄이 열렸습니다. > > 2012년 이미지넷(ImageNet) 대회에서 알렉스넷(AlexNet)이 보여준 성과는 그 상징적 장면이었습니다. 이미지넷은 수많은 사진을 보고 사물을 분류하는 대회였고, 알렉스넷은 깊은 합성곱 신경망을 이용해 기존 방식보다 훨씬 뛰어난 성능을 보였습니다. 합성곱 신경망(CNN)은 이미지의 작은 부분에서 선, 모서리, 형태 같은 특징을 차례로 찾아내는 구조로, 이후 컴퓨터가 이미지를 인식하는 방식을 크게 바꾸었습니다. > > 그 뒤 순환 신경망(RNN)과 그 변형들은 음성과 문장처럼 순서가 중요한 데이터를 다루는 데 쓰였습니다. 순환 신경망은 앞에서 나온 소리나 단어의 정보를 일정 부분 기억하면서 다음 정보를 처리하는 구조입니다. 그리고 2017년 이후에는 트랜스포머(Transformer)가 등장했습니다. 트랜스포머는 문장 속 단어들이 서로 어떤 관계를 맺는지를 한꺼번에 살피는 구조로, 긴 문맥을 처리하는 능력을 크게 높였습니다. 오늘날의 대규모 언어모델과 생성형 인공지능은 이 구조 위에서 발전했습니다. > > 따라서 2020년대의 생성형 인공지능은 어느 날 갑자기 나타난 수다스러운 기계가 아닙니다. 그것은 입력을 연결하고, 답을 내고, 틀린 만큼 고치고, 다시 배우는 과정을 수십 년 동안 쌓아온 결과입니다. 챗봇의 자연스러운 대화 뒤에는 퍼셉트론의 단순한 판단에서 오차역전파의 학습 절차, 딥러닝의 깊은 층, 트랜스포머의 문맥 이해에 이르는 60년 신경망 역사가 놓여 있습니다. > >
1.8 인공지능은 도구인가, 과학적 대상인가
인공지능은 이제 망원경이나 현미경처럼 과학의 강력한 도구가 되었습니다. 단백질 구조를 예측하고, 날씨와 우주 데이터를 분석하며, 새로운 물질 후보를 찾는 데까지 쓰입니다. 그러나 인공지능은 단순한 관찰 도구에 머물지 않습니다. 우리는 인공지능이 내놓은 답을 읽고, 평가하고, 때로는 그 판단에 의존합니다.
그렇다면 중요한 질문이 생깁니다. 인공지능은 왜 그런 답을 내놓았을까요? 언제는 정확하고, 언제는 틀릴까요? 어떤 데이터에는 강하면서, 어떤 정보에는 편향될까요?
이 질문은 기술자만의 문제가 아닙니다. 인공지능이 우리의 생각과 선택, 사회의 판단 방식에 영향을 미치는 시대라면, 시민 역시 인공지능의 원리와 한계를 이해해야 합니다. 렌즈의 왜곡을 모르면 하늘을 잘못 읽듯이, 인공지능의 작동 방식을 모르면 그 답을 과신하거나 오해할 수 있습니다. 인공지능 물리학은 바로 이 지점에서 필요합니다. 인공지능을 세계를 연구하는 도구로 쓰는 동시에, 인공지능 자체를 연구해야 할 대상으로 바라보게 하기 때문입니다.
인공지능 자율주행자동차
1.9 인문학은 왜 인공지능 물리학을 읽어야 하는가
인문학은 의미, 해석, 역사, 가치, 인간 경험을 다룹니다. 그렇다면 인공지능 물리학은 인문학과 거리가 먼 분야처럼 보일 수 있습니다. 그러나 사실은 그렇지 않습니다. 인공지능 물리학은 단순한 기술이 아니라, 우리가 세계를 이해하는 방식을 바꾸고 있기 때문입니다. 과학의 역사를 돌아보면 중요한 물리학 이론들은 언제나 인간의 세계관에도 영향을 주었습니다. 뉴턴 역학은 자연이 일정한 법칙에 따라 움직인다는 확신을 주었습니다. 근대인은 세계를 거대한 시계처럼 이해하기 시작했고, 예측과 통제가 가능하다는 믿음을 갖게 되었습니다. 상대성이론은 또 다른 질문을 던졌습니다. 시간과 공간은 누구에게나 똑같은 것이 아니라 관찰자의 위치와 운동 상태에 따라 달라질 수 있다는 사실이 밝혀졌습니다. 물리학의 문제였지만, 사람들은 여기에서 관점과 객관성의 관계를 다시 생각하게 되었습니다. 서로 다른 시각이 존재할 수 있지만, 그 속에서도 변하지 않는 법칙이 있다는 통찰은 철학과 인문학에도 적지 않은 영향을 주었습니다. 양자역학 역시 마찬가지입니다. 양자역학은 세계가 단순히 결정된 상태로 존재하는 것이 아니라 여러 가능성을 품고 있으며, 관측 과정이 중요하다는 사실을 보여주었습니다. 물론 물리학자들은 이를 엄밀한 수학으로 다루지만, 일반인에게는 "가능성", "불확실성", "관찰"이라는 새로운 사고방식을 제시했습니다. 양자역학이 철학과 예술, 문학에까지 영향을 준 이유도 여기에 있습니다.
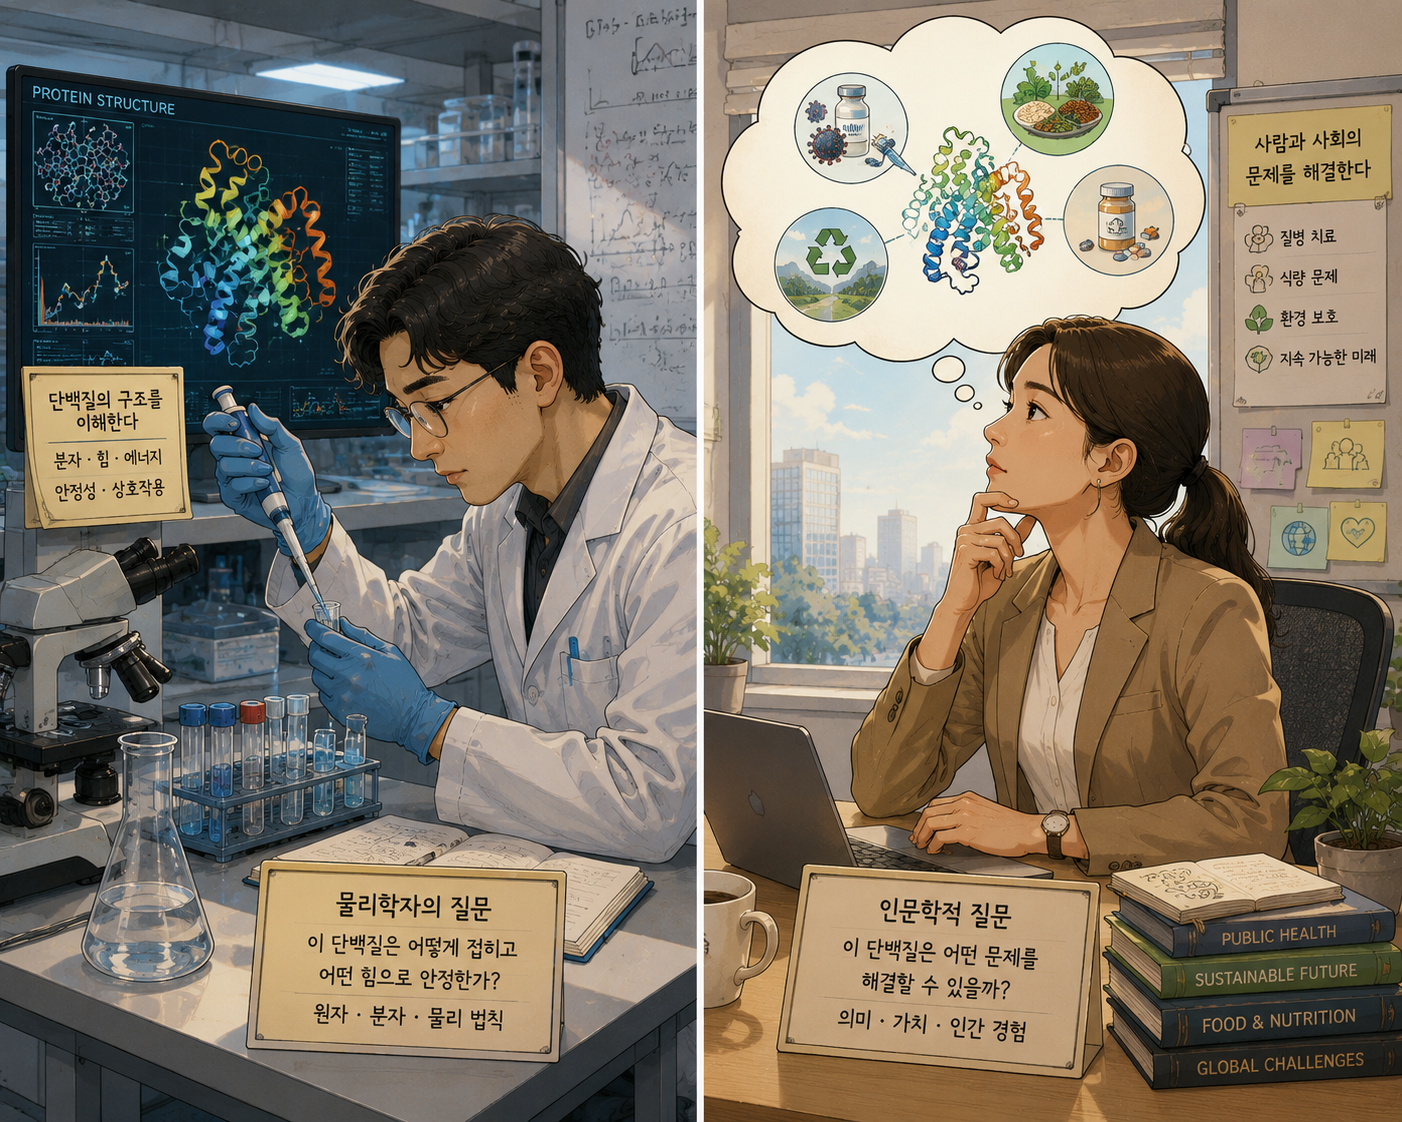
인공지능 물리학도 비슷한 위치에 있습니다. 그것은 단순히 컴퓨터를 더 똑똑하게 만드는 기술이 아닙니다. 오히려 지능이란 무엇인지, 이해란 무엇인지, 발견이란 무엇인지를 다시 묻게 만드는 새로운 세계관입니다. 이를 단백질 구조 예측의 사례로 생각해 볼 수 있습니다. 물리학적 관점에서 단백질은 원자와 분자의 집합입니다. 연구자는 분자 사이의 힘과 에너지, 구조의 안정성을 계산하여 단백질이 어떤 형태를 취할지 설명합니다. 여기서 중요한 것은 구조가 어떻게 만들어지는가 하는 문제입니다. 반면 인문학적 관점에서는 다른 질문이 등장합니다. 왜 인간은 단백질 구조를 알고자 하는가? 그 지식은 어떤 질병을 치료하고 어떤 삶을 가능하게 하는가? 인공지능이 예측한 결과를 인간은 어떻게 이해하고 활용해야 하는가? 여기서 중요한 것은 구조 자체가 아니라 그 구조가 인간의 삶 속에서 어떤 의미를 갖는가 하는 문제입니다. 즉 물리학은 단백질이 어떻게 접히는지를 설명하고, 인문학은 그 지식이 인간에게 무엇을 의미하는지를 묻습니다. 인공지능 역시 마찬가지입니다. 인공지능이 과학 논문을 쓰고, 실험을 설계하고, 단백질 구조를 예측하고, 날씨를 예보한다면 우리는 물어야 합니다.
이해란 무엇이며 발견이란 무엇인가? 인간 연구자는 어떤 역할을 하는가? 좋은 예측은 곧 좋은 설명인가? 지능은 몸과 물질 없이 존재할 수 있는가?
이 질문들은 모두 인문학적입니다. 따라서 인공지능 물리학은 비전공 시민에게 새로운 인문학이기도 합니다. 뉴턴 역학이 근대인의 세계관을 바꾸고, 상대성이론과 양자역학이 인간의 사고방식을 넓혔듯이, 인공지능 물리학은 지능과 인간 이해에 관한 새로운 질문을 제기합니다. 인공지능 물리학을 배운다는 것은 결국 기술 문명의 내부를 이해하고, 그 문명이 인간에게 어떤 의미를 갖는지를 읽어내는 일입니다. 그 의미를 읽어내다 보면 인공지능 물리학은 낯선 기술이 아니라 현대 세계를 이해하는 지도가 될 것입니다.
단백질을 대하는 서로 다른 관점
<hr class="chapter-divider">
제2강. AI의 운동 법칙
강의를 시작하며
우리는 흔히 인공지능이 인간의 뇌처럼 번뜩이는 영감으로 '생각'한다고 믿고 싶어 합니다. 하지만 그 이면의 물리적 현실은 조금 다릅니다. 기계의 학습은 단 한 번의 깨달음이 아니라, 자신이 얼마나 틀렸는지를 끊임없이 묻고 수백만 번의 미세한 궤도 수정을 통해 숫자를 다듬어가는 치열한 조율의 과정입니다. 이제부터 그 과정에 숨겨진 운동 법칙을 살펴봅니다.
2.1 손실함수: 완벽을 향한 퇴고의 지형도
학생이 시험을 봤다고 떠올려 봅시다. 100점을 받았다면 거의 틀린 것이 없다는 뜻입니다. 60점을 받았다면 아직 더 공부해야 할 부분이 있다는 뜻입니다. 시험 점수는 현재 상태가 목표에 얼마나 가까운지를 알려주는 하나의 기준입니다. 인공지능에도 비슷한 기준이 필요합니다. 다만 인공지능은 점수를 높이는 대신 실수를 줄이는 방향으로 학습합니다. 그래서 연구자들은 모델이 얼마나 틀렸는지를 숫자로 나타내는 값을 사용합니다. 이것이 손실함수(loss function) 입니다. 학생의 시험 점수가 성취 정도를 나타낸다면, 손실값은 부족한 정도를 나타냅니다. 따라서 시험 점수는 높을수록 좋지만, 손실값은 낮을수록 좋습니다. 이제 이 손실값을 하나의 지형으로 상상해 봅시다. 어떤 곳은 산꼭대기처럼 높고, 어떤 곳은 골짜기처럼 낮습니다. 높은 곳은 오류가 많은 상태이고, 낮은 곳은 오류가 적은 상태입니다. 공을 산비탈에 놓으면 아래로 굴러가듯이, 인공지능도 더 낮은 손실값을 향해 조금씩 이동합니다. 바로 여기서 물리학적 비유가 힘을 얻습니다. 학습은 마치 안개가 낀 산속에서 가장 낮은 골짜기를 찾아 내려가는 과정처럼 보입니다. 인공지능은 매번 조금씩 방향을 수정하며 더 좋은 길을 찾습니다. 물론 실제 인공지능의 지형은 우리가 지도에서 보는 산과는 다릅니다. 수많은 변수들이 얽혀 만들어진 매우 복잡한 공간입니다. 인간은 그것을 직접 볼 수 없지만, "높은 곳은 오류가 크고 낮은 곳은 오류가 작다"는 비유는 여전히 유효합니다.
손실함수(loss function)
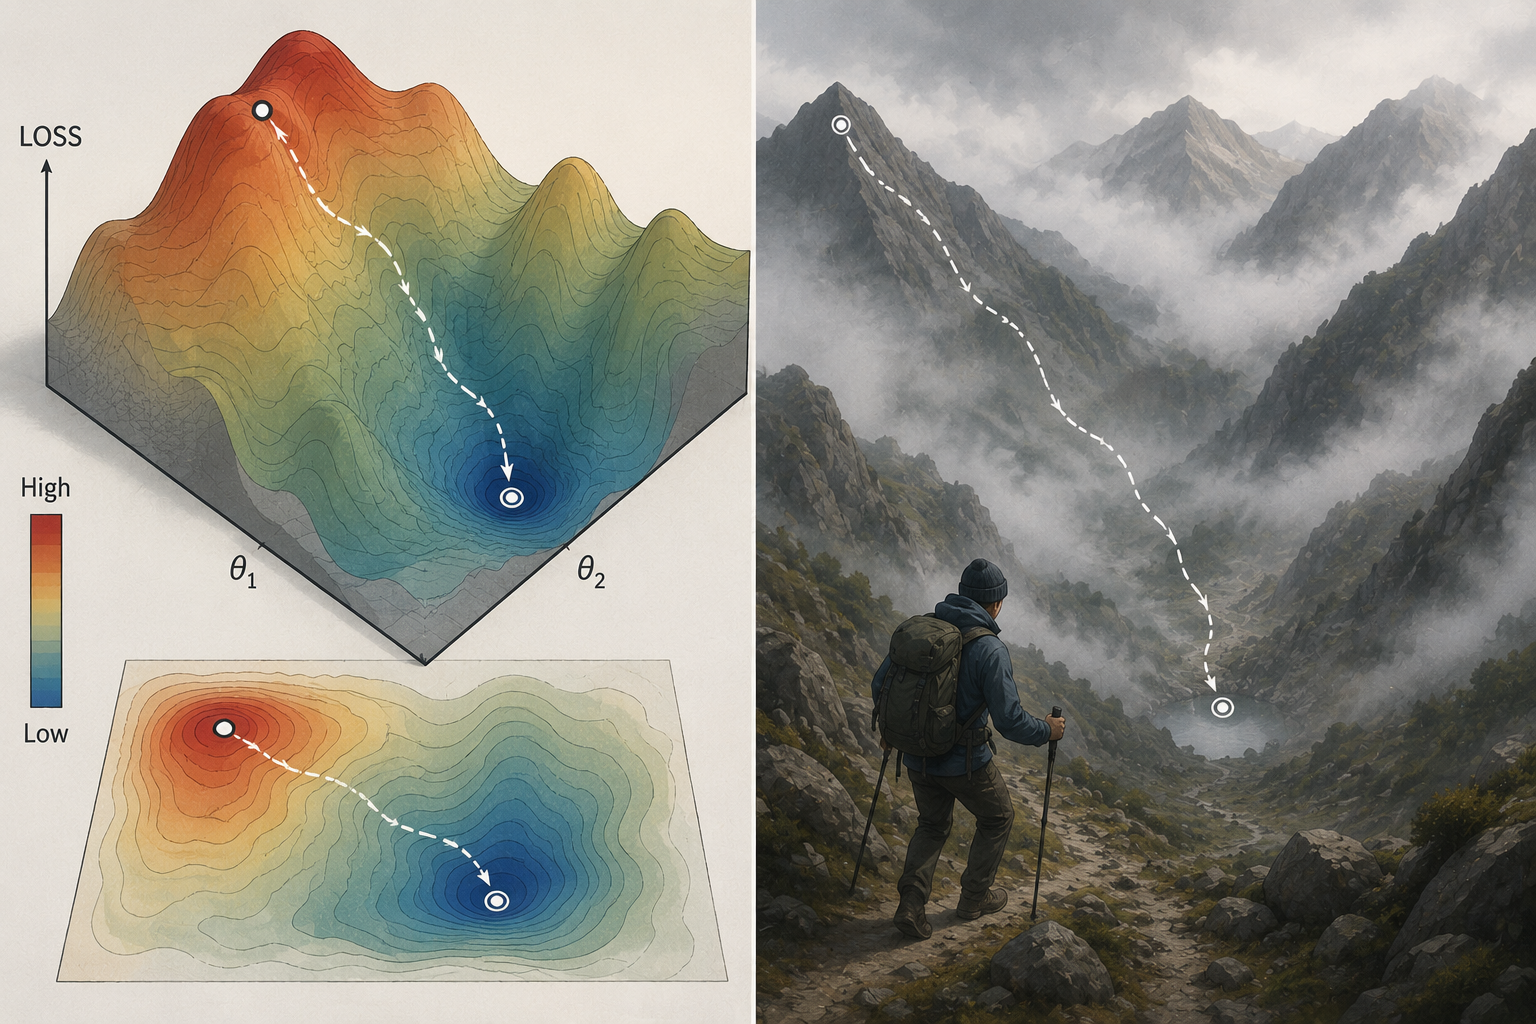
손실함수(loss function)는 인공지능이 안개 낀 산속의 등산객처럼 현재 위치를 조금씩 수정하며 가장 낮은 골짜기(오류가 가장 작은 상태)를 찾아 내려가는 과정을 보여주는 지형도입니다.
이 개념은 인문학적으로도 흥미롭습니다. 작가가 원고를 쓸 때를 떠올려 봅시다. 첫 번째 초고는 대개 거칠고 어색합니다. 문장이 길기도 하고, 논리가 매끄럽지 않을 수도 있습니다. 작가는 문장을 고치고, 단어를 바꾸고, 문단의 순서를 다시 배열하면서 조금씩 더 좋은 형태를 찾아갑니다. 어떤 의미에서 글쓰기란 더 설득력 있는 문장을 향해 내려가는 여정입니다. 처음의 초고가 높은 언덕이라면, 여러 번의 퇴고를 거친 원고는 더 안정되고 자연스러운 골짜기에 가까워집니다. 인공지능의 학습도 이와 비슷합니다. 다만 작가가 의미와 감각, 경험을 바탕으로 문장을 다듬는다면, 인공지능은 손실함수라는 숫자가 알려주는 방향을 따라 자신을 수정합니다. 인간이 퇴고를 통해 더 나은 글을 만들어 가듯, 인공지능도 수많은 수정 과정을 거치며 더 나은 답을 찾습니다. 그래서 손실함수는 단순한 수학 공식이 아닙니다. 그것은 인공지능이 스스로의 부족함을 측정하고, 조금씩 더 나은 상태를 향해 나아가도록 안내하는 나침반과도 같은 역할을 합니다.
2.2 경사하강법: 미세한 궤도 수정의 축적
인공지능이 공부를 시작했다고 떠올려 봅시다. 처음에는 정답을 거의 맞히지 못합니다. 마치 처음 시험을 본 학생처럼 실수가 많습니다. 그렇다면 인공지능은 어떻게 더 나은 답을 찾게 될까요? 문제는 인공지능이 무엇을 고쳐야 할지 처음부터 알지 못한다는 점입니다. 수천 개, 수백만 개, 때로는 수십억 개의 숫자가 서로 연결되어 있기 때문입니다. 어느 부분을 어떻게 바꾸어야 오류가 줄어드는지 한눈에 볼 수 없습니다. 거대한 안개 속에서 기계가 선택한 방식은 단순하지만 우아합니다. 현재 발을 딛고 있는 위치에서 가장 가파른 내리막을 찾아 한 걸음 이동하고, 멈춰서 다시 주변의 기울기를 계산하는 반복. 이 과정을 반복하면 결국 가장 낮은 곳에 가까워질 수 있습니다. 인공지능도 비슷합니다. 현재 상태에서 오류가 가장 빨리 줄어드는 방향을 찾아 조금씩 이동합니다. 그리고 다시 오류를 계산한 뒤, 더 좋은 방향으로 조금씩 수정합니다. 이처럼 현재 위치에서 가장 가파른 내리막 방향을 따라 반복적으로 이동하는 방법을 경사하강법(Gradient Descent) 이라고 부릅니다.
경사하강법의 원리
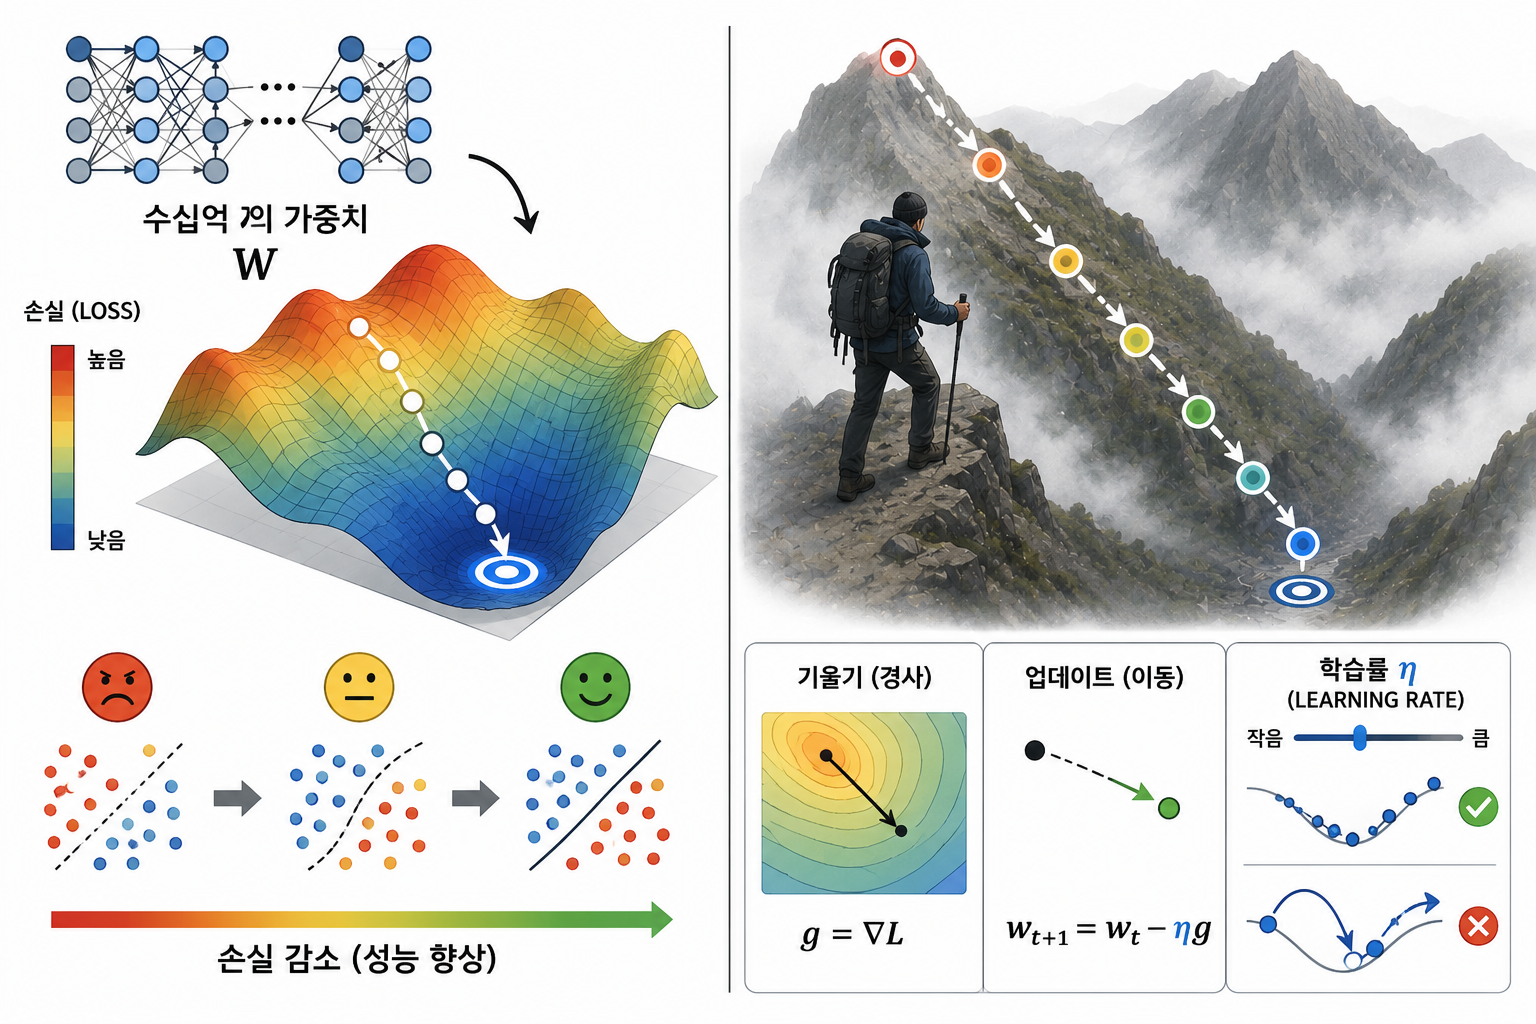
경사하강법은 수십억 개의 가중치가 있는 거대한 신경망이 스스로 개선할 수 있게 만든, 인공지능 구현의 핵심 원리입니다.
경사하강법은 오늘날 거의 모든 딥러닝 시스템의 핵심 엔진입니다. 이미지 인식, 음성 인식, 번역, 생성형 인공지능까지 대부분의 현대 인공지능은 이 방법을 이용해 학습합니다. 경사하강법이 없다면 오늘날의 딥러닝 혁명도 없었을 것입니다. 여기서 중요한 것이 이동하는 속도입니다. 한 번에 너무 크게 움직이면 골짜기를 지나쳐 버릴 수 있습니다. 반대로 너무 조금 움직이면 올바른 방향은 찾더라도 시간이 지나치게 오래 걸립니다. 이 이동 폭을 학습률(learning rate) 이라고 부릅니다. 학생이 공부할 때도 비슷합니다. 하루에 책 한 권을 모두 외우려 하면 금방 지치고, 하루에 한 줄만 읽으면 진도가 나가지 않습니다. 적절한 속도로 꾸준히 공부해야 가장 좋은 결과를 얻을 수 있습니다. 인공지능 역시 적절한 학습률을 찾아야 합니다. 너무 성급해도 안 되고, 너무 느려도 안 됩니다. 물리학적으로 보면 이 비유는 더욱 흥미롭습니다. 뉴턴 역학에서 물체는 힘을 받으면 움직입니다. 인공지능에서는 손실함수의 기울기가 일종의 안내자 역할을 합니다. 물론 실제 힘과 동일한 것은 아니지만, "어느 방향으로 가야 더 좋은 상태에 가까워지는가"를 알려준다는 점에서는 비슷합니다. 그래서 경사하강법은 인공지능이 자신의 실수를 발견하고, 조금씩 수정하며, 더 나은 답을 향해 스스로 길을 찾아가는 방법이라고 할 수 있습니다.
안개 낀 산길의 비유
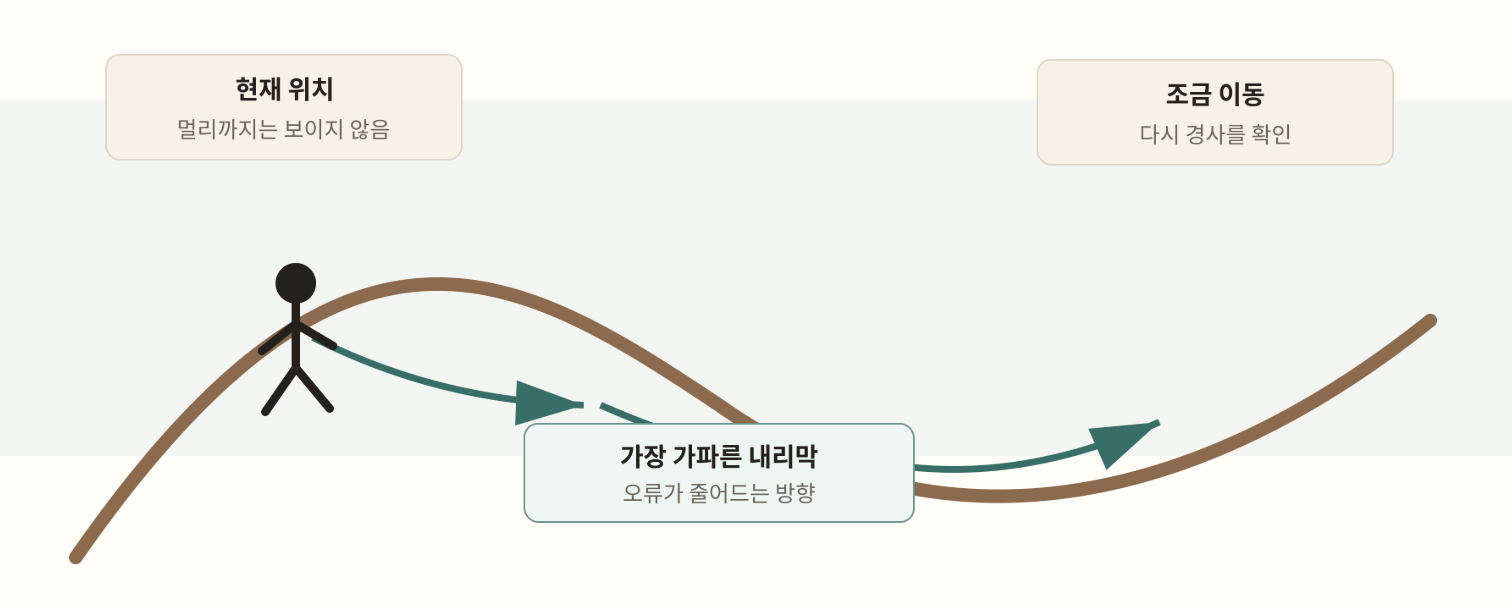
경사하강법은 한 번에 정답을 보는 방법이 아닙니다. 지금 자리에서 오류가 줄어드는 방향을 찾고, 조금 이동한 뒤 다시 확인하는 반복 과정입니다.
경사하강법의 아름다움은 단순함에 있습니다. 복잡한 지능처럼 보이는 결과도 아주 단순한 반복에서 출발합니다. 현재 상태를 평가하고, 조금 고치고, 다시 평가합니다. 인간의 학습도 어느 정도 그렇습니다. 글을 쓰고, 피드백을 받고, 수정하고, 다시 써봅니다. 이와 비슷한 개념이 하나 더 있습니다. 인공지능은 애써 가정한 모델이 틀렸을 때, 단순히 “틀렸다” 하고 끝내지 않습니다. 결과의 오차를 거꾸로 거슬러 올라가며 어느 연결이 너무 강했는지, 어느 연결이 너무 약했는지를 조금씩 조정합니다. 이것이 오차역전파 알고리즘입니다. 사람의 언어로 말하면 기계가 반성을 배운 셈입니다. 물론 기계가 인간처럼 후회한다는 뜻은 아닙니다. 다만 실패를 흘려보내지 않고, 실패의 흔적을 다음 행동의 수정 방향으로 바꾼다는 점에서 오차역전파는 현대 인공지능 학습의 중요한 전환점이 되었습니다.
아리스토텔레스의 《니코마코스 윤리학》과 작은 수정의 반복
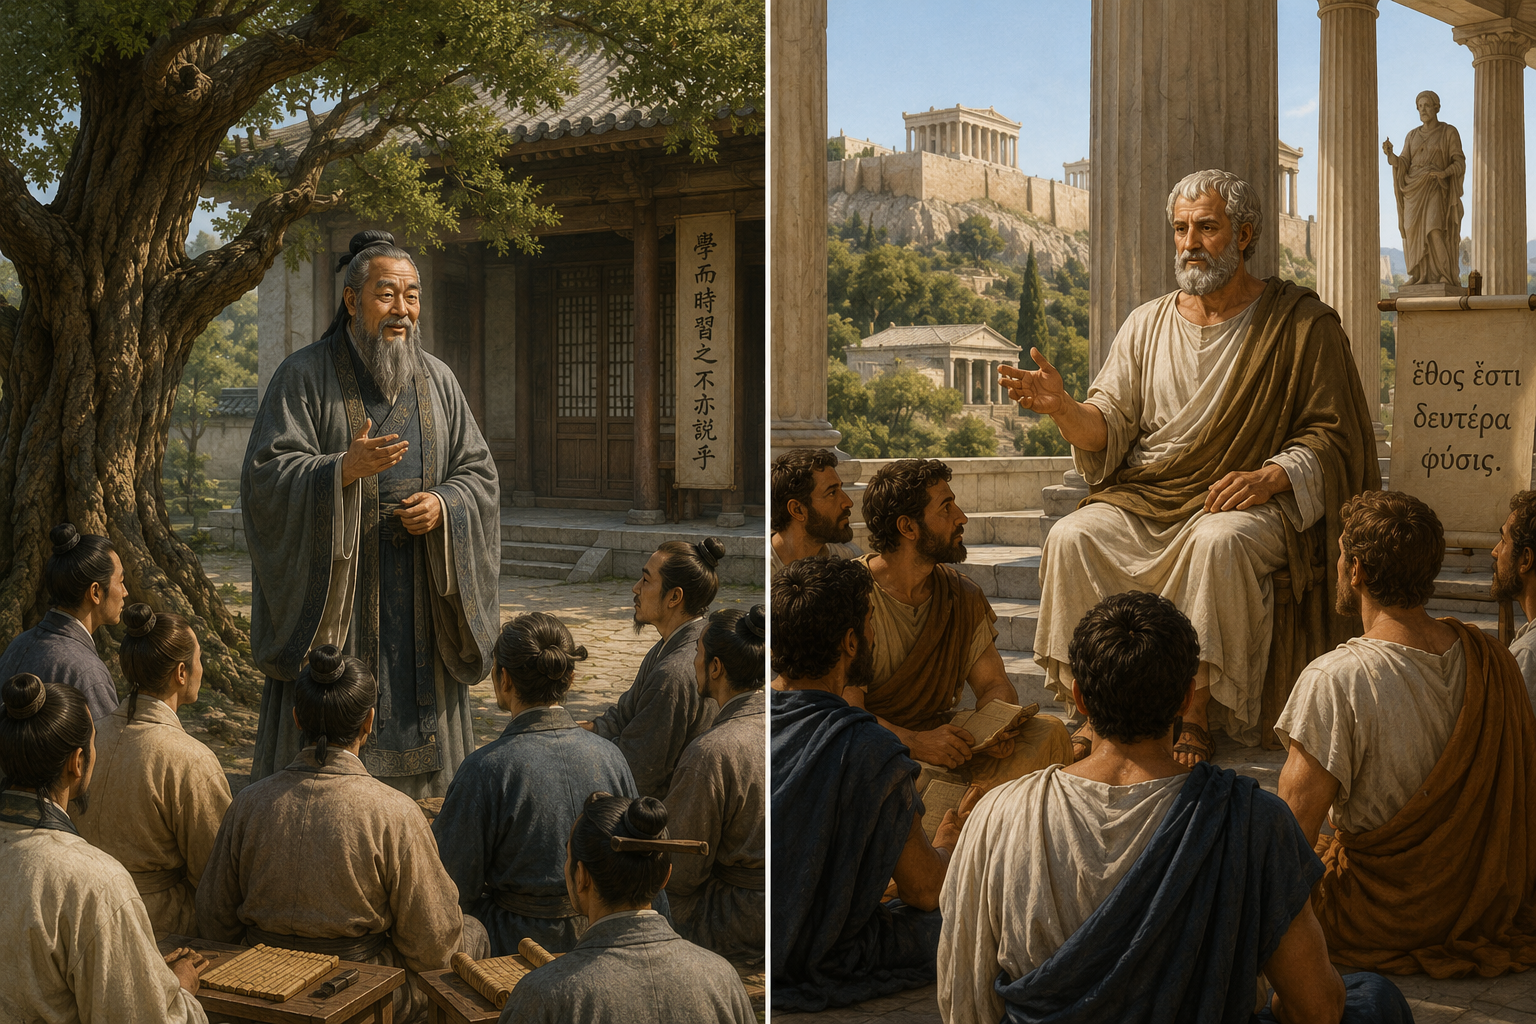
공자는 《논어》 첫머리에서 "배우고 때때로 익히면 또한 기쁘지 아니한가"라고 말했습니다. 공자가 말한 익힘은 한 번의 깨달음이 아니라 반복을 뜻합니다. 또 아리스토텔레스는 《니코마코스 윤리학》에서 인간의 덕이 타고나는 것이 아니라 반복된 습관 속에서 형성된다고 보았습니다. 오늘의 나는 어제의 선택들이 쌓인 결과입니다. 대표적인 인공지능 알고리즘 중 하나인 경사하강법도 이와 비슷한 과정을 거칩니다. 인공지능은 한 번의 거대한 깨달음으로 똑똑해지는 것이 아니라, 수많은 작은 수정의 반복을 통해 더 나은 상태로 이동합니다. 좋은 습관이 사람의 성격을 조금씩 만들듯, 작은 조정들이 모델의 실력을 만듭니다. 학습이란 결국 방향을 잃지 않고 여러 번 다시 고치는 일입니다.
제자들에게 강의하는 공자와 아리스토텔레스
2.3 모멘텀과 마찰: AI 최적화 알고리즘
여러분이 처음 가보는 산길을 걷고 있다고 상상해 봅시다. 목적지는 가장 낮은 골짜기입니다. 그런데 길은 울퉁불퉁하고 안개까지 끼어 있습니다. 매 걸음마다 발밑만 보고 방향을 정한다면 어떻게 될까요? 왼쪽이 조금 낮아 보이면 왼쪽으로 가고, 다음 순간에는 오른쪽이 조금 낮아 보여 다시 방향을 틀게 될 것입니다. 이렇게 되면 앞으로 나아가기는커녕 지그재그로 흔들리며 걷게 됩니다. 그래서 사람은 보통 조금 더 현명하게 움직입니다. 방금 전까지 내려가던 방향을 어느 정도 유지하면서, 새로운 정보를 참고해 방향을 조금씩 수정합니다. 그래야 더 안정적으로 목적지에 도달할 수 있습니다. 인공지능도 마찬가지입니다. 앞에서 살펴본 경사하강법은 현재 위치에서 가장 낮아지는 방향을 찾는 방법입니다. 하지만 거대한 신경망에서는 그보다 길이 훨씬 복잡합니다. 매 순간의 정보만 따르면 방향이 계속 흔들릴 수 있습니다. 그래서 연구자들은 이전까지 이동해 온 방향도 함께 고려하는 방법을 사용합니다. 이것이 최적화 알고리즘의 중요한 아이디어 중 하나인 모멘텀(momentum)입니다. 여러분은 무거운 쇼핑카트를 밀어 본 적이 있을 것입니다. 처음 움직일 때는 힘이 많이 들지만, 일단 움직이기 시작하면 어느 정도 계속 앞으로 나아가려는 경향이 있습니다. 움직이는 물체가 관성에 의해 같은 방향으로 나아가려는 이 성질을 물리학에서는 운동량 즉 모멘텀이라고 부릅니다. 인공지능의 모멘텀은 실제 운동량은 아니지만 아이디어는 비슷합니다. 지금까지 내려오던 방향을 기억해 두었다가 다음 이동에 반영하는 것입니다. 그러면 다음 언덕길에서 이전과 같은 방향으로 간다면 인공지능은 작은 굴곡에 일일이 흔들리지 않고, 더 부드럽고 안정적으로 골짜기를 향해 내려갈 수 있습니다. 또 빙판길을 달리는 자전거를 생각해 봅시다. 길이 미끄러우니 속도는 잘 붙지만 제어가 어렵습니다. 조금만 방향을 잘못 잡아도 멀리 미끄러질 수 있습니다. 반면 적당한 마찰이 있으면 속도는 조금 느려져도 훨씬 안정적으로 움직일 수 있습니다. 인공지능 학습도 비슷합니다. 너무 빠르게 움직이면 좋은 지점을 지나쳐 버릴 수 있으므로 적당한 마찰을 주어 자신을 제어하려 합니다. 노자의 도덕경에서 말한 “매사를 어렵게 여기고 신중하게 대하면 어려운 일이 없다”는 것과 같은 이치입니다. 인공지능은 이와 같은 최적화 알고리즘을 이용하여 적절한 "가속"과 "제동" 사이의 균형을 찾아 해답으로 나아가는 것입니다.
도해 2-3. 운동량을 쓰는 AI 학습
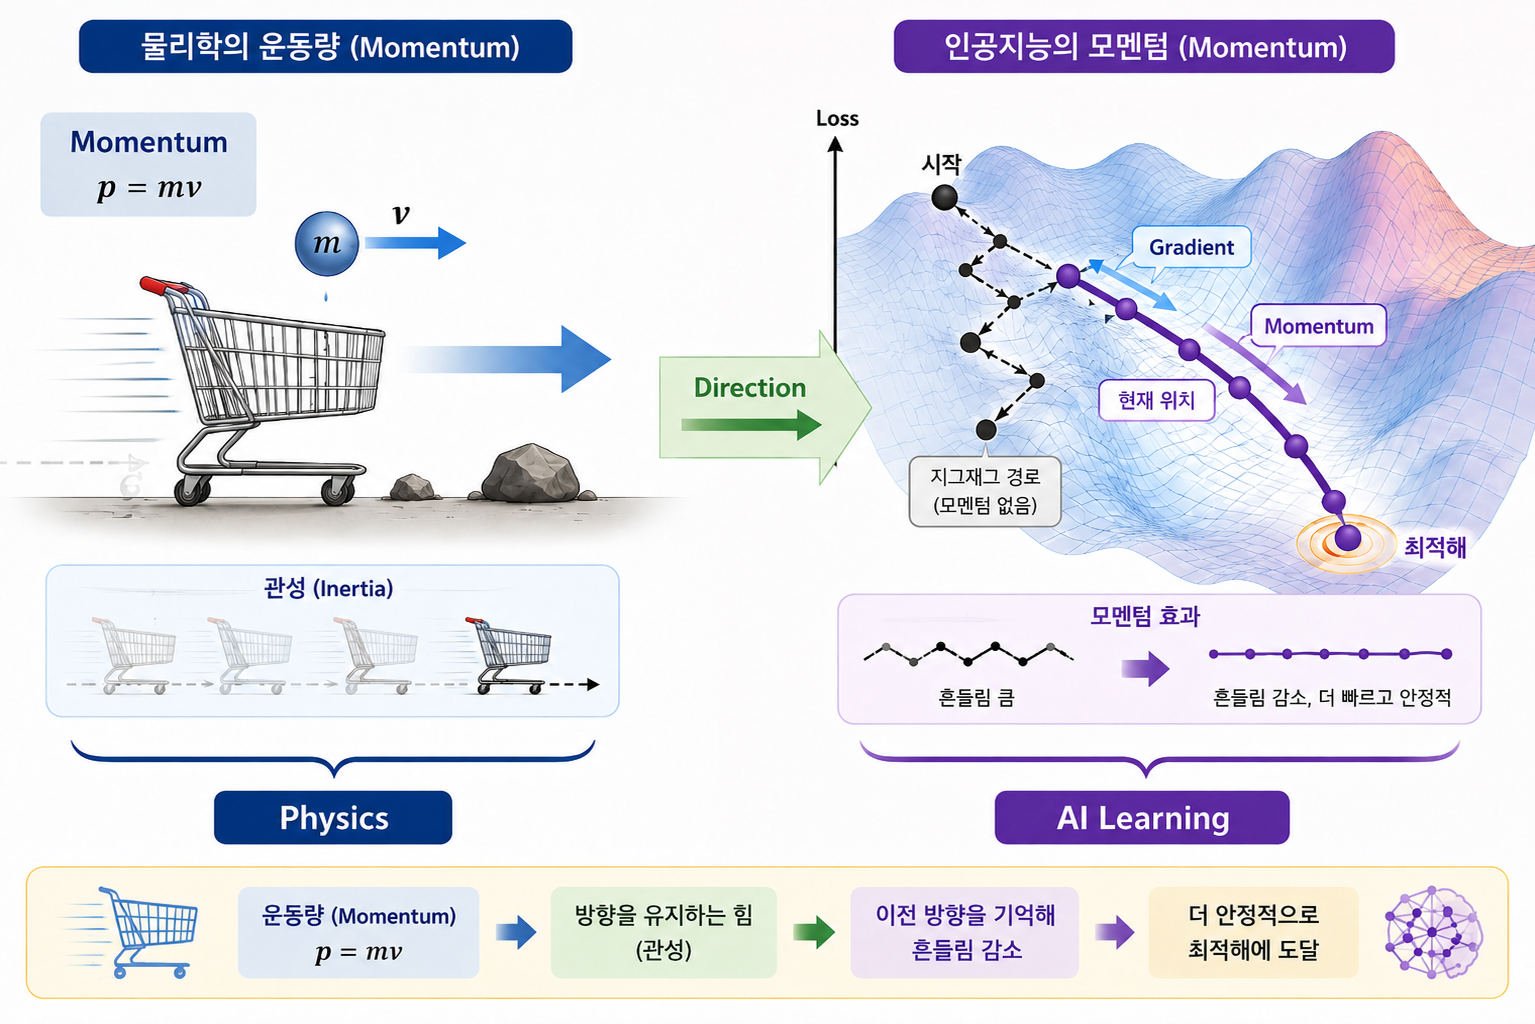
운동량이 물체의 진행 방향을 유지하듯, 인공지능의 모멘텀은 이전 학습 방향을 기억해 흔들림을 줄이고 더 안정적으로 좋은 해답을 찾도록 돕습니다.
이 개념은 인문학적으로도 흥미롭습니다. 논문이나 책을 쓸 때를 떠올려 봅시다. 매번 새로운 아이디어가 떠오를 때마다 방향을 완전히 바꾼다면 글은 산만해질 것입니다. 반대로 처음 생각만 끝까지 고집한다면 더 좋은 관점이 나타나도 받아들일 수 없습니다. 좋은 글쓰기는 방향성을 유지하면서도 새로운 피드백을 받아들이는 일입니다. 오늘 쓴 문장을 내일 다시 읽고, 내일의 생각을 모레의 글에 반영하면서도 전체 주제는 잃지 않는 것입니다. 인공지능의 최적화 알고리즘인 모멘텀도 이와 비슷합니다. 이전까지 쌓아 온 방향성을 존중하면서도 새로운 정보를 반영해 조금씩 수정해 나갑니다. 단순히 가장 빠른 길을 찾는 방법이 아니라 방향을 잃지 않으면서도 계속 배우려는 알고리즘입니다. 사람의 성장과 인공지능의 학습이 닮아 보이는 이유도 바로 여기에 있습니다.
2.4 낮은 곳을 찾아서: 국소 최소와 전역 최소
산길을 걷다 보면 “이제 충분히 낮은 곳에 도착했다”고 느끼는 순간이 있습니다. 주변을 둘러보면 더 내려갈 길이 없어 보입니다. 그래서 그곳이 목적지라고 생각할 수 있습니다. 그런데 조금 더 멀리 보면, 그곳은 산 전체에서 가장 낮은 곳이 아니라 그 근처에서만 낮은 작은 골짜기일 수도 있습니다. 이처럼 주변에서는 가장 낮지만, 전체로 보면 가장 낮지는 않은 지점을 국소 최소(local minimum) 라고 부릅니다. 반대로 넓은 지형 전체를 통틀어 가장 낮은 지점은 전역 최소(global minimum)입니다. 이 차이는 생각보다 중요합니다. 우리는 종종 눈앞의 문제를 해결했다고 생각하지만, 더 큰 관점에서 보면 더 좋은 방법이 있을 수 있기 때문입니다. 자동차를 타고 집에서 회사까지 가는 길을 찾는다고 해봅시다. 내비게이션 없이 눈앞의 길만 보고 ‘지금 가장 덜 막혀 보이는 쪽’으로만 계속 달리면, 당장은 괜찮아 보여도 전체적으로 더 오래 걸리는 길에 들어설 수 있습니다. 골목길 하나는 한산해 보여도 그 길들이 이어지는 전체 경로가 비효율적일 수 있기 때문입니다. 반대로 조금 돌아가더라도 내비게이션을 이용해 큰길과 신호 흐름, 전체 교통 상황을 함께 고려하면 처음에는 덜 좋아 보여도 전체적으로 더 빠른 길을 찾을 수 있습니다.
국소 최소와 전역 최소의 비유
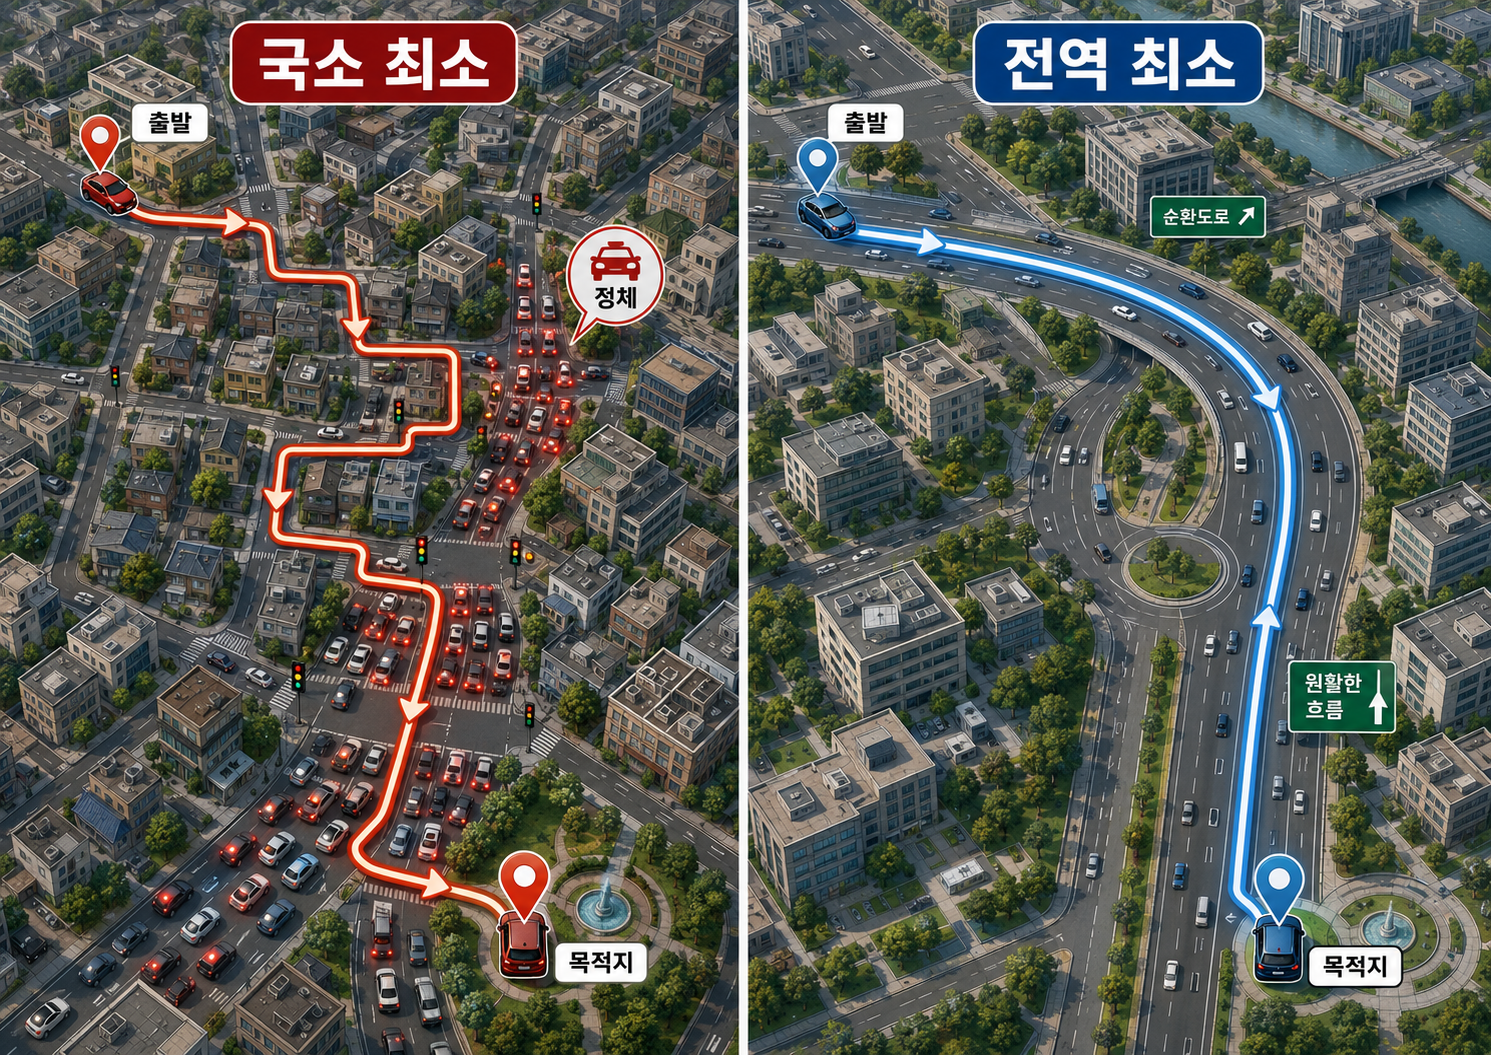
국소최소는 눈앞에서 가장 덜 막혀 보이는 길만 따라가다 결국 더 비효율적인 경로에 머무는 경우이고, 전역최소는 전체 교통 흐름을 함께 보아 처음엔 돌아가더라도 결국 목적지에 가장 효율적으로 도달하는 경우를 연상케 합니다.
인공지능 학습도 이와 비슷합니다. 인공지능은 손실함수라는 지형 위에서 더 낮은 곳을 찾으려 합니다. 그 지형은 매우 복잡해서 작은 골짜기가 여기저기 많습니다. 그래서 어느 정도 괜찮은 지점에 도달해도, 그것이 전체적으로 가장 좋은 해답은 아닐 수 있습니다. 이럴 때 인공지능은 국소 최소에 머물 수 있습니다. 실제로 인공지능은 항상 완벽한 전역 최소를 찾지 않습니다. 왜냐하면 현실에서는 ‘알고 있는 데이터에 딱 맞는 해답’보다, ‘새로운 데이터에서도 안정적으로 작동하는 해답’이 더 중요하기 때문입니다. 학생의 시험 공부를 예로 들어 보면 더 분명해집니다. 어떤 학생이 기출문제만 완벽하게 외워 시험에서는 높은 점수를 받을 수 있습니다. 그러나 문제가 조금만 달라지면 제대로 풀지 못할 수도 있습니다. 반대로 모든 문제를 외우지는 못했더라도 원리를 이해한 학생은 새로운 문제에도 더 잘 대응할 수 있습니다. 인공지능도 마찬가지입니다. 훈련 데이터에서 손실이 아주 낮다고 해서 그것이 반드시 가장 좋은 모델은 아닙니다. 때로는 좁고 깊은 골짜기보다 조금 덜 낮더라도 넓고 안정된 골짜기가 더 좋은 해답이 됩니다. 그런 지점에 있는 모델이 새로운 상황에서도 더 잘 버티기 때문입니다.
이 점은 인문학적으로도 시사하는 바가 큽니다. 문학 작품을 해석할 때 어떤 해석이 한 문장에는 정확히 들어맞을 수 있습니다. 그러나 작품 전체의 흐름이나 시대적 맥락까지 함께 설명하지는 못할 수 있습니다. 그런 해석은 마치 좁은 골짜기와 비슷합니다. 특정 부분에는 딱 맞지만, 전체를 품지는 못합니다. 좋은 해석은 조금 더 넓은 골짜기와 같습니다. 세부를 무시하지 않으면서도 작품 전체와 시대의 분위기, 작가의 문제의식까지 함께 설명할 수 있어야 합니다. 부분에만 맞는 해석보다 전체에 대해 더 넓은 설명력을 가진 해석이 더 나은 답입니다. 괴테의 《파우스트》를 예로 들면, 악마 메피스토펠레스가 파우스트에게 끊임없이 제공하는 쾌락과 권력은 곧 달콤한 '국소 최솟값'의 유혹입니다. 만약 파우스트가 눈앞의 쾌락에 취해 유혹에 빠진다면, 그는 머지 않아 영혼을 잃고 악마에게 종속될 것입니다. 그와 달리 끊임없이 고뇌하며 앞으로 나아가는 투쟁만이 파우스트를 구원으로 이끄는 '전역 최솟값'에 이르는 길임을, 이 위대한 작품은 말해줍니다. 인공지능이든 인간의 해석이든, 중요한 것은 가장 빨리 만족스러운 답에 도달하는 것만이 아니라, 더 넓은 맥락 속에서 얼마나 좋은 답인가를 함께 묻는 일입니다.
2.5 잡음 : 무질서가 창조하는 틈새
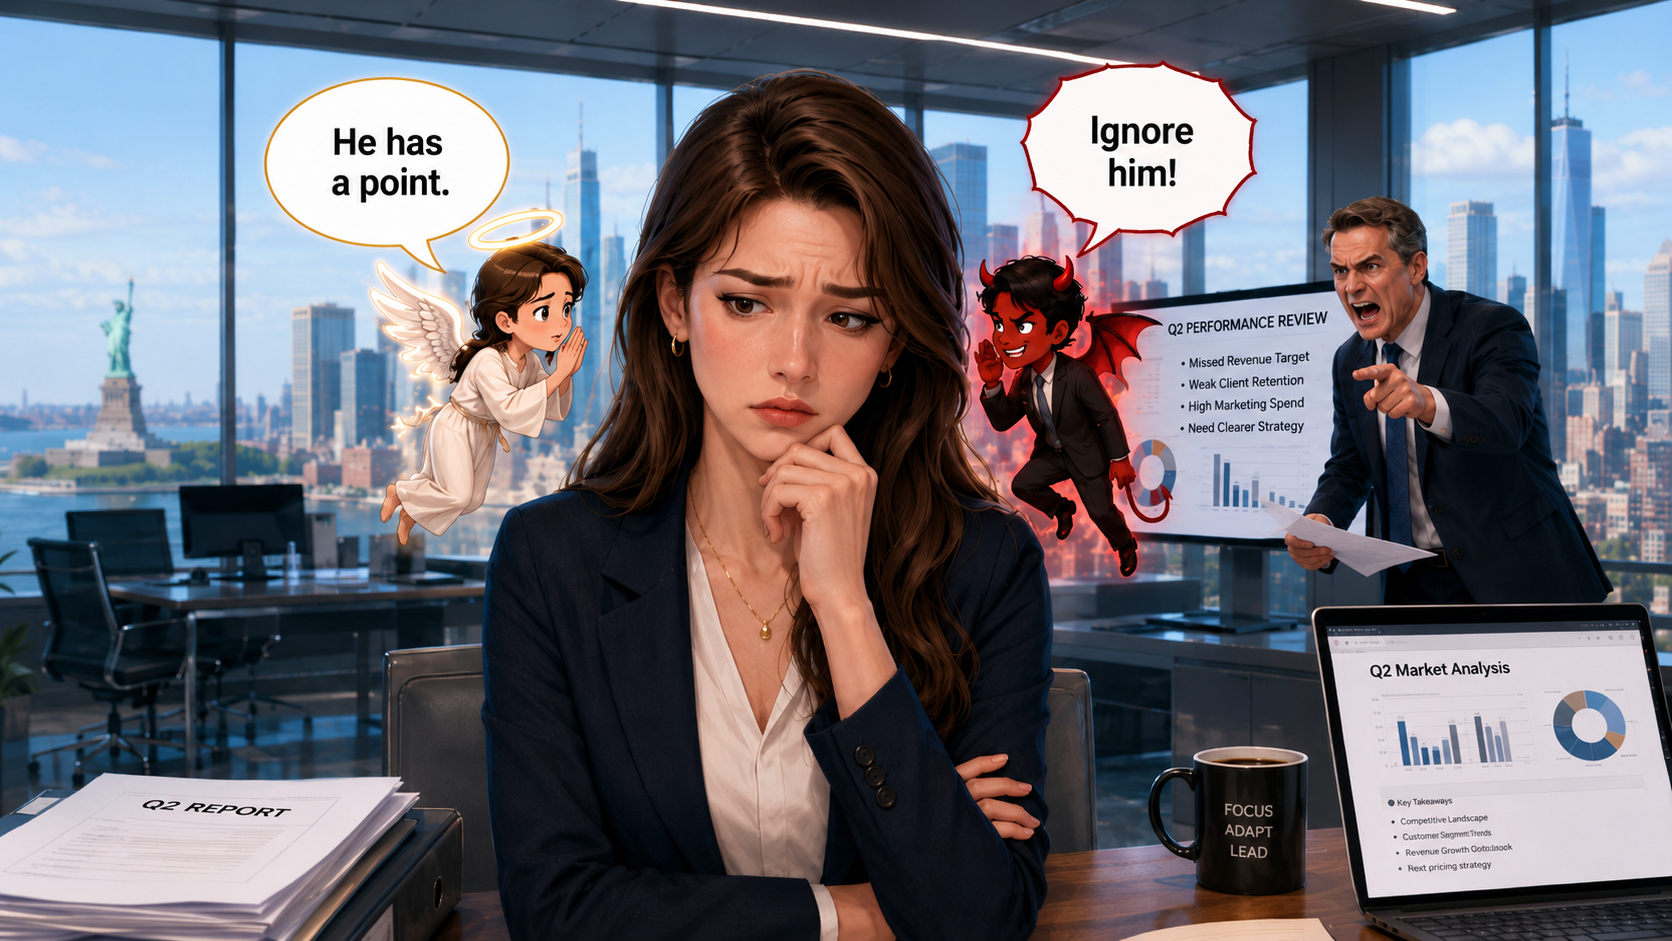
우리는 보통 잡음을 나쁜 것으로 생각합니다. 라디오에서 지지직거리는 소리, 영상의 흐릿한 화면, 시끄러운 주변 소음은 집중을 방해합니다. 그래서 잡음은 없을수록 좋다고 느끼기 쉽습니다. 그러나 모든 잡음이 나쁜 것은 아닙니다. 때로는 약간의 흔들림이 새로운 길을 찾게 해줍니다. 예를 들어 한 젊은 직장인이 보고서를 제출했는데, 상사에게 꾸지람을 들었다고 떠올려 봅시다. 처음에는 그 말이 불쾌하게 들릴 수 있습니다. 그 말을 전부 무시해 버릴 수도 있습니다. 그러나 조금 지나서 다시 생각해 보면, 그 꾸지람 속에 쓸 만한 신호가 섞여 있을 수 있습니다. 표현 방식은 거칠었지만, 보고서의 결론이 흐릿했다거나, 자료의 순서가 독자를 헷갈리게 했다거나, 핵심 근거가 부족했다는 지적은 실제로 도움이 될 수 있습니다. 중요한 것은 잡음 속에서 신호를 가려내는 일입니다. 감정적인 말투나 불필요한 표현은 걸러내고, 그 안에 들어 있는 개선의 단서를 붙잡는다면 그 경험은 단순한 상처가 아니라 다음 보고서를 더 좋게 만드는 계기가 됩니다. 인공지능 학습에서도 비슷한 일이 일어납니다. 예를 들어 인공지능 모델이 내려가려는 지형에 작은 골짜기가 너무 많고 심지어 바람도 거셉니다. 어떤 골짜기는 주변보다 낮아 보이지만, 전체적으로 보면 그리 좋은 지점이 아닐 수 있습니다. 모델이 너무 빨리 그곳에 안주하면 더 좋은 해답을 찾지 못해 실패할 가능성이 큽니다. 이때 적당한 잡음이 도움이 될 수 있습니다. 잡음은 모델이 가는 방향을 조금 뒤틀어 줍니다. 덕분에 모델은 작은 골짜기에 너무 일찍 갇히지 않고, 다른 가능성을 더 탐색할 수 있습니다. 실제로 인공지능은 학습할 때 모든 데이터를 한꺼번에 보지 않고, 일부 데이터만 보고 조금씩 자신을 고치는 경우가 많습니다. 그러면 매번 이동 방향이 약간 흔들리는데, 바로 그 흔들림이 모델을 더 넓게 탐색하게 해줍니다. 물리학에는 이와 닮은 개념으로 ‘천천히 식힌다’는 뜻을 지닌 어닐링(annealing)이 있습니다. 금속을 예로 들어 봅시다. 금속을 뜨겁게 달구면 내부의 작은 입자들이 활발하게 움직입니다. 이때 입자들은 여러 배열을 시도할 수 있습니다. 그러다가 천천히 식히면 입자들은 점차 안정된 배열을 찾아갑니다. 너무 빨리 식히면 내부 구조가 엉성해질 수 있지만, 천천히 식히면 더 단단하고 안정된 구조가 만들어질 수 있습니다. 인공지능도 이와 비슷하게 경로를 탐색합니다. 문제를 처리하다 약간의 잡음에 부딪히면 인공지능은 이를 이용하여 여러 가능성을 탐색합니다. 그러면 처음에는 더디지만 학습이 진행될수록 점차 안정된 방향으로 수렴해 갑니다. 그렇게 하면 이후 다양한 경우에 대처할 능력을 갖추게 됩니다. 사소한 잡음을 감지하여 넓게 봄으로써 미처 학습하지 않은 문제까지 해결할 능력을 갖추는 것입니다.
가열 냉각과 잡음 처리
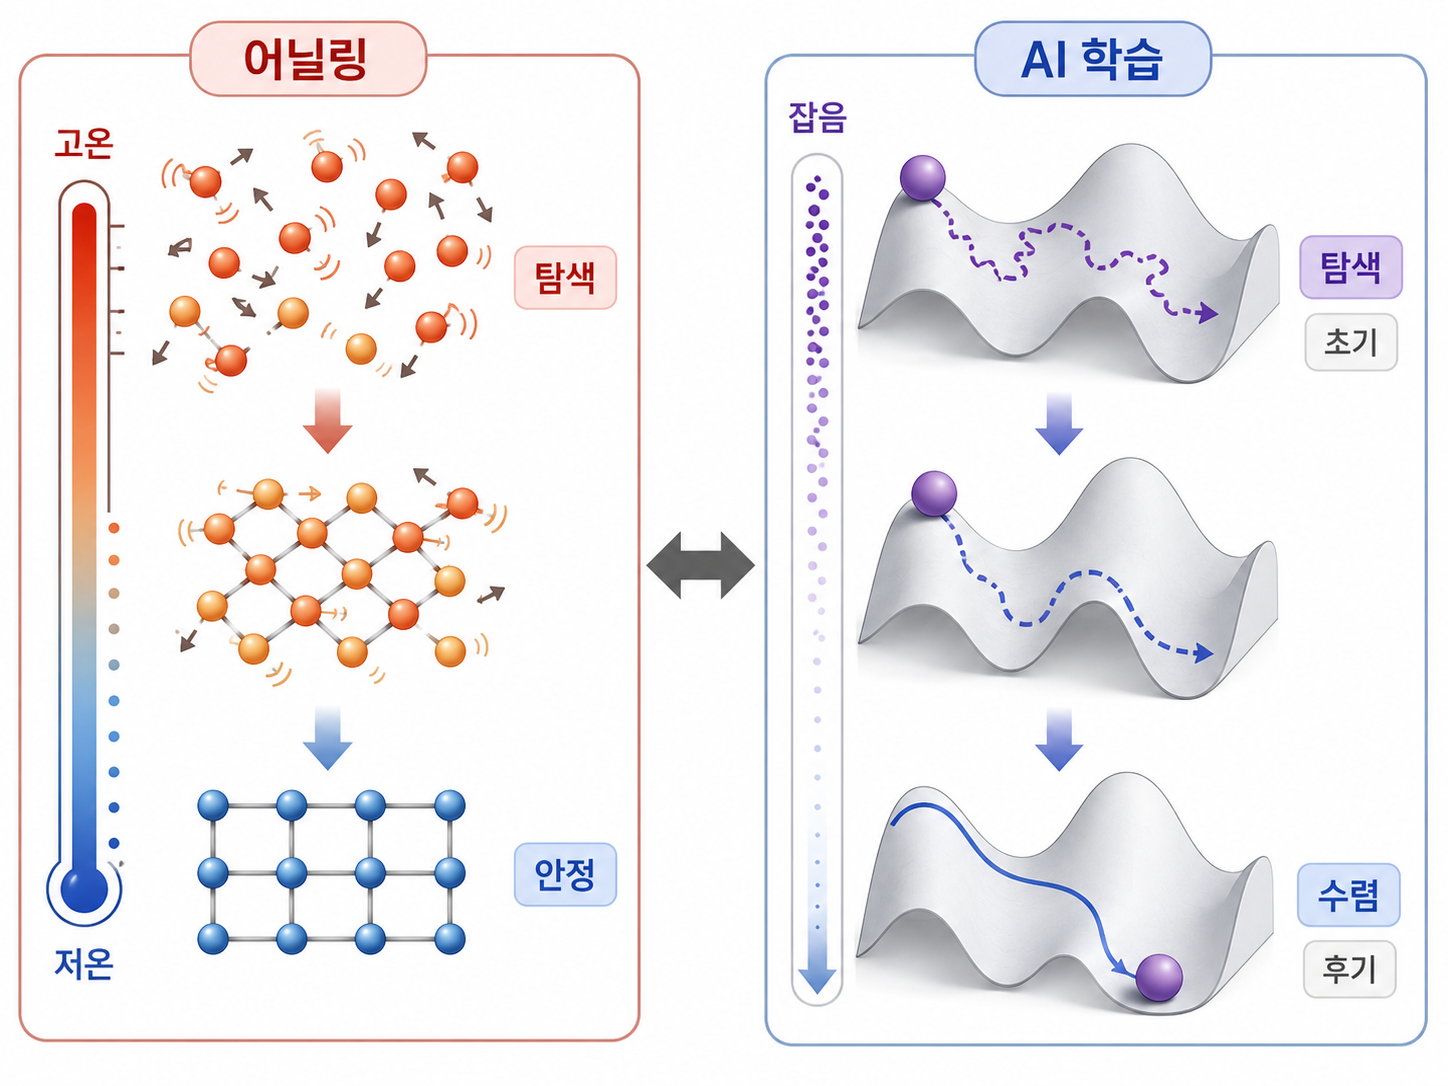
금속 입자들이 뜨거울 때는 여러 상태를 넓게 탐색하고 식으면서 안정된 구조를 갖추듯, 인공지능도 처음에는 잡음을 활용해 여러 가능성을 살펴보다가 점차 흔들림을 줄이며 더 좋은 해답으로 수렴합니다.
인간의 사고도 완벽한 질서 정연함 속에선 굳어버리기 쉽습니다. 많은 사람들이 항상 논리적이고 질서정연하게 생각해야 한다고 믿습니다. 물론 깊은 사고에는 질서가 필요합니다. 그러나 창의성은 종종 작은 잡음에서 시작됩니다. 산책 중에 떠오른 생각, 우연히 들은 대화, 잘못 읽은 문장, 일상의 작은 균열에서 기발한 상상력을 점화시킬 수 있습니다. 인공지능에게 잡음이 가능성을 열어 두는 장치가 될 수 있듯, 인간에게 우연한 흔들림이 더 깊은 이해와 창조의 출발점이 될 수 있습니다.
소음과 조언 사이
2.6 과적합: 기계적인 암기의 함정
시험을 앞둔 학생을 떠올려 봅시다. 어떤 학생은 문제집의 답을 거의 통째로 외웁니다. 같은 문제가 나오면 놀랄 만큼 잘 풉니다. 그러나 숫자가 조금 바뀌거나 질문 방식이 달라지면 갑자기 막힙니다. 답은 외웠지만 원리를 이해한 것은 아니기 때문입니다. 인공지능에서도 비슷한 일이 일어납니다. 즉 미리 학습하여 익숙한 데이터 앞에서는 잘 작동하지만, 처음 보는 데이터를 만나면 헤매는 경우가 있습니다. 이를 과적합(overfitting) 이라고 부릅니다. 앞서 1강 2회차 강의에서 'AI 모델이란 학습된 신경망'이라 언급한 적 있는데, 과적합은 인공지능이 “공부를 너무 잘못한 상태”입니다. 제대로 이해한 것이 아니라, 본 것만 지나치게 세밀하게 외워 버린 것입니다. 겉으로는 성적이 좋아 보이지만, 실제 문제 해결력은 약하다는 뜻입니다. 이를 우주 탐사선의 항로 보정 작업으로 설명할 수 있습니다. 탐사선이 먼 행성을 향해 날아갈 때, 관제실은 탐사선의 위치와 속도를 계속 확인합니다. 그런데 측정값에는 언제나 작은 흔들림이 섞입니다. 센서의 오차, 우주선의 미세한 진동, 통신 신호의 잡음 같은 것들입니다. 만약 관제실이 이런 작은 흔들림 하나하나에 모두 반응해 탐사선의 방향을 계속 바꾼다면 어떻게 될까요? 탐사선은 더 정확해지는 것이 아니라 오히려 불안정해질 수 있습니다. 연료를 낭비하고, 큰 항로를 잃고, 목적지에서 멀어질 수도 있습니다. 좋은 항로 보정은 모든 흔들림을 따라가는 일이 아닙니다. 중요한 흐름과 단순한 잡음을 구별하는 일입니다. 우주 탐사선은 순간적인 흔들림을 모두 믿기보다, 전체 궤도와 목적지를 기준으로 안정적으로 방향을 잡아야 합니다. 인공지능도 마찬가지입니다. 좋은 AI 모델은 훈련 데이터의 작은 우연과 잡음까지 모두 외우지 않습니다. 대신 여러 데이터 속에서 반복되는 중요한 구조를 배웁니다. 그래야 처음 보는 상황에서도 비교적 안정적으로 판단할 수 있습니다. 그래서 인공지능 연구자들은 과적합을 막기 위해 여러 방법을 사용합니다. 훈련에 쓰지 않은 데이터를 따로 남겨 두고 모델을 시험해 보기도 합니다. 이를 검증 데이터라고 부릅니다. 또 모델이 지나치게 복잡해지지 않도록 조절하거나, 학습을 너무 오래 하지 않도록 중간에 멈추기도 합니다. 때로는 일부 정보를 일부러 가려두거나, 데이터를 조금씩 변형해 다양한 상황을 경험하게 만들기도 합니다. 이 모든 방법의 목표는 하나입니다. 모델이 문제집을 외우는 학생이 아니라 원리를 이해하는 학생에 가까워지게 하려는 것입니다.
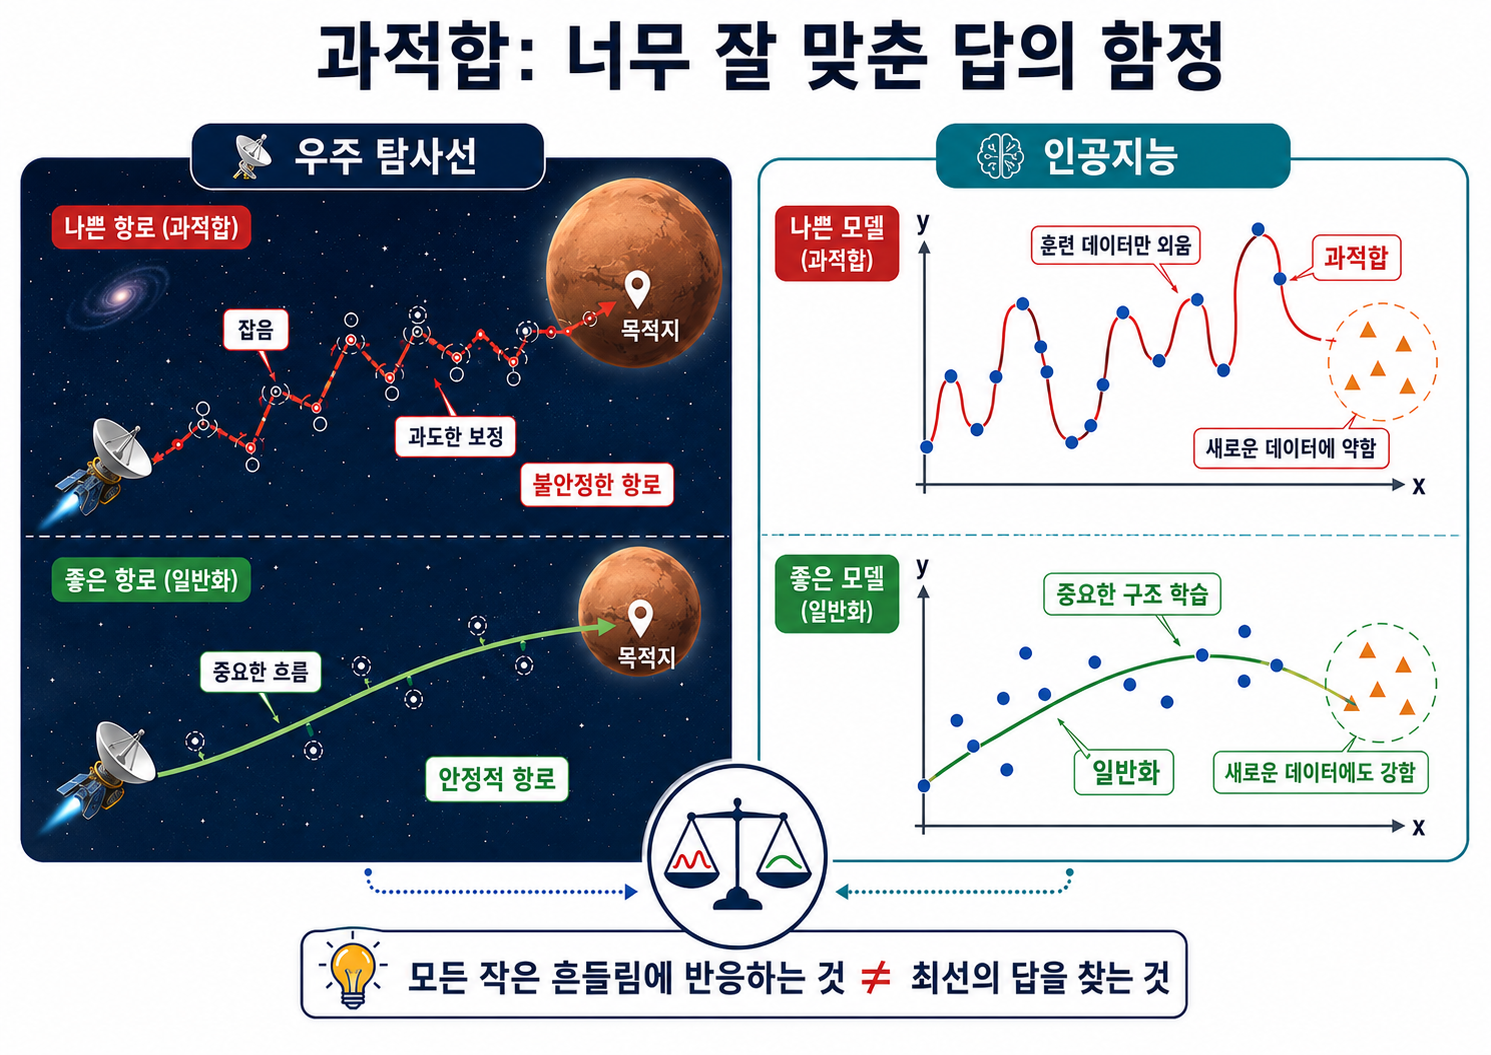
과적합은 현대 사회의 문제와도 닮아 있습니다. 예를 들어 도시화로 인한 과밀 인구 문제를 떠올려 봅시다. 사람들이 일자리와 교육, 의료, 문화 시설을 찾아 대도시로 몰리면 처음에는 효율이 높아 보입니다. 기업은 인재를 쉽게 구하고, 사람들은 더 많은 기회를 얻습니다. 도시는 마치 모든 요구에 딱 맞춘 거대한 해답처럼 보입니다. 그러다 너무 많은 기능과 인구가 한곳에 몰리면 문제가 생깁니다. 집값은 오르고, 교통은 막히고, 공기는 나빠지고, 아이를 키우거나 노년을 보내기 어려워집니다. 특정 도시의 성공 공식에 한 사회 전체가 지나치게 꿰맞춰진 것입니다. 이것은 일종의 사회적 과적합이라고 볼 수 있습니다. 이때 정부가 해야 할 일은 더 많은 사람을 한 도시 안에 억지로 밀어 넣는 것이 아닙니다. 대도시 하나에 모든 기능을 집중시키는 대신, 여러 지역이 각자의 역할을 갖고 살아날 수 있도록 해야 합니다. 일자리, 교육, 의료, 문화, 교통을 분산시키고, 사람들이 한곳에 몰리지 않아도 좋은 삶을 살 수 있게 해야 합니다. 인공지능에서 과적합을 막는 일이 훈련 데이터 하나에 갇히지 않도록 하는 것이라면, 사회 정책에서 과밀을 해결하는 일은 특정 도시 하나의 성공 방식에 사회 전체가 갇히지 않도록 하는 일입니다. 중요한 것은 한곳에 지나치게 잘 맞는 해답이 아니라, 다양한 상황에서도 안정적으로 작동하는 구조입니다.
2.7 일반화: 보지 않은 세계를 읽는 통찰
물리학의 힘은 하나의 현상을 설명하는 데 있지 않습니다. 물리학은 어떤 원리가 다른 상황에서도 통한다는 것을 보여줄 때 더 큰 힘을 갖습니다. 이것이 일반화(Generalization)입니다. 여기 AI 가속기용 고대역폭 메모리로 널리 사용되는 HBM과, 최근 자주 거론되는 차세대 고대역폭 플래시 메모리인 HBF가 있습니다. HBM이 AI 서버의 GPU(그래픽 처리 장치) 옆에서 초고속 계산을 돕는 ‘빠른 작업대’라면, HBF는 플래시 메모리를 고대역폭으로 쌓아 더 큰 데이터를 가까이 두고 쓸 수 있게 한 ‘넓은 창고형 작업대’라 할 수 있습니다. 아래 그림에서 보듯 이는 양자 터널링 원리를 극단적으로 집약한 장비입니다.
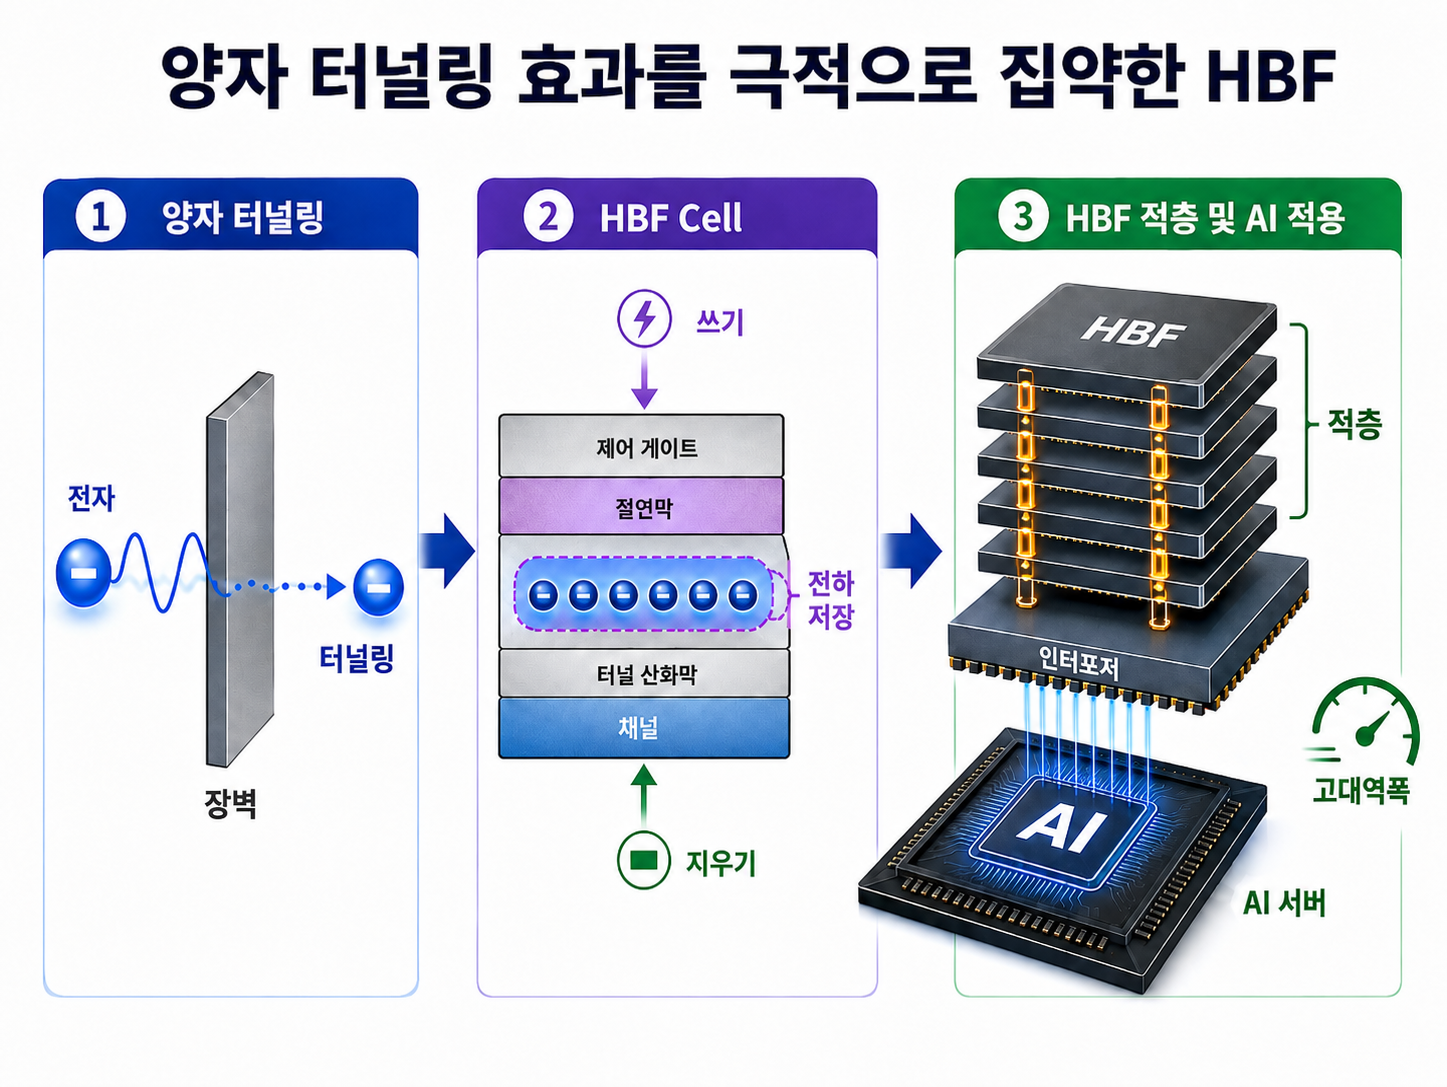
두 종류의 AI 가속 장비: HBM이 GPU의 초고속 계산을 돕는 ‘빠른 작업대’라면, HBF는 초대용량 데이터를 GPU에 연결한 ‘창고형 작업대’라 할 수 있습니다.
고전 물리학의 눈으로 보면 입자는 벽을 넘을 만큼 충분한 에너지가 없으면 그 벽을 통과할 수 없습니다. 그러나 양자역학에서는 아주 작은 세계에서 입자가 마치 얇은 벽을 스며 지나가듯 반대편에 나타날 수 있습니다. 이것을 양자 터널링, 줄여서 터널링 효과라고 부릅니다. 처음 들으면 마술처럼 들리는 이 이상한 현상은 오늘날 매우 현실적인 기술이 되었습니다. 플래시 메모리는 이 원리를 이용해 전자를 아주 작은 공간에 넣거나 빼면서 정보를 저장합니다. 우리가 스마트폰에 사진을 저장하고, 노트북의 SSD에 문서를 저장하고, 대규모 AI 서버가 엄청난 데이터를 빠르게 읽고 쓰는 데에도 이 원리가 바탕에 놓여 있습니다. 여기서 중요한 것은 물리학의 일반화입니다. 양자역학은 원래 원자와 전자처럼 아주 작은 세계를 설명하기 위해 등장했습니다. 그런데 그 원리는 실험실 안에만 머물지 않았습니다. 반도체와 플래시 메모리, 데이터 저장장치, 그리고 오늘날 인공지능을 떠받치는 거대한 컴퓨팅 인프라 속으로 확장되었습니다. 작은 입자의 이상한 행동을 이해한 것이 현대 정보 문명의 기반 기술로 이어진 것입니다. 인공지능의 일반화도 이와 닮아 있습니다. 초기와 달리 오늘날 인공지능 모델은 훈련 중에 본 데이터만 외우지 않습니다. 고양이 사진을 수천 장 보았다고 해서 그 사진들을 그대로 기억하는 데 그친다면 좋은 모델이 아닙니다. 처음 보는 고양이, 다른 각도에서 찍힌 고양이, 어두운 방 안에 있는 고양이도 알아볼 수 있어야 합니다. 즉, 개별 사례를 넘어 그 안에 숨어 있는 구조를 배워야 합니다. 이러한 학습 방법을 인공지능에 적용시킨 것이 딥러닝에 기초한 신경망 학습법입니다. 이 방법에 따라 인공지능은 먼저 낮은 층에서 선, 색, 모서리 같은 단순한 특징을 배우고, 높은 층으로 갈수록 눈, 귀, 얼굴, 사물 같은 더 복잡한 구조를 배웁니다. 언어 학습도 마찬가지입니다. 특정 문장을 통째로 외우는 것이 아니라 단어 사이의 관계, 문맥의 흐름, 문장 구조, 의미의 연결 방식을 배워 처음 보는 문장에도 반응하게 합니다. 오늘날 인공지능에는 다양한 학습기법이 적용되고 있지만, 그 모두가 결국 일반화를 더 잘하기 위한 장치라고 볼 수 있습니다. 일부 데이터를 가려 놓고 맞히게 하는 자기지도학습, 비슷한 것과 다른 것을 구별하게 하는 대조학습, 데이터를 조금씩 변형해 다양한 상황을 경험하게 하는 데이터 증강, 모델이 특정 단서에 지나치게 의존하지 못하게 하는 드롭아웃 같은 방법들이 그렇습니다. 이들은 모두 모델이 답을 외우는 대신 구조를 배우도록 돕습니다. 요약하면 일반화란 AI 모델이 훈련 중에 보지 않은 데이터에도 잘 작동하는 능력입니다. 이것이야말로 인공지능의 핵심입니다. 외운 답을 반복하는 것만으로는 지능이라고 부르기 어렵습니다. 새로운 상황에서 적절히 대응할 수 있어야 합니다. 물리학에서 법칙은 일반화의 극단적 형태입니다. 사과가 떨어지는 것과 달이 지구를 도는 것을 하나의 중력 법칙으로 설명하는 것이 물리학의 힘입니다. 인공지능의 일반화는 물리 법칙만큼 명시적이지 않을 수 있지만, 데이터 속 반복 구조를 찾아 새로운 사례에 적용한다는 점에서 비슷한 목표를 갖습니다. 일반화 능력이야말로 AI 지능의 정수라 할 수 있습니다. 수만 장의 고양이 사진에서 개별 픽셀의 값을 암기하는 것이 아니라, 선과 질감, 형태가 이루는 관계망을 '추상화'하여 처음 보는 어둠 속의 고양이마저 식별해 내는 것입니다. 지능이란 결국 흩어진 개별적 파편들 너머에 존재하는 세계의 보편적인 문법을 읽어내는 공간 지각력이기 때문입니다.
2.8 상전이와 학습의 임계점 : 양(量)에서 질(質)로
물을 끓여 본 경험을 떠올려 봅시다. 냄비 속 물의 온도는 처음에는 조금씩 올라갑니다. 그런데 어느 순간 끓기 시작하면 상황이 달라집니다. 액체였던 물이 수증기로 바뀌기 시작합니다. 온도는 조금씩 올라갔지만, 어느 지점에서 물질의 상태는 질적으로 달라집니다. 이처럼 작은 변화가 계속 쌓이다가 어느 순간 물질의 성질이 갑자기 바뀌는 현상을 상전이(phase transition) 라고 부릅니다. 상전이는 우리 주변에서 흔히 볼 수 있습니다. 물이 얼음이 되는 것도 상전이입니다. 온도를 낮추면 물 분자들의 움직임이 점점 느려지다가, 어느 순간 액체의 자유로운 흐름을 잃고 단단한 결정 구조를 이룹니다. 액체가 고체로 바뀌는 것입니다. 자석도 좋은 예입니다. 뜨거운 철은 자석의 성질을 잃을 수 있습니다. 그러나 온도가 어느 지점 아래로 내려가면 원자들의 작은 방향들이 하나로 정렬되기 시작합니다. 그 순간 철은 자석이라는 새로운 성질을 갖게 됩니다. 이때의 경계가 바로 임계점입니다. 초전도 현상도 있습니다. 어떤 물질은 온도를 극도로 낮추면 전기 저항이 갑자기 크게 떨어집니다. 아예 저항이 0에 가까워져 전기가 멈추지 않고 흐르는 상태가 됩니다. 양이 조금 달라진 것이 아니라 질이 달라진 것입니다. 여기서 중요한 말이 임계점(critical point) 입니다. 임계점은 변화가 쌓이다가 성질이 바뀌는 경계입니다. 그 전까지는 변화가 눈에 잘 띄지 않을 수 있습니다. 그러나 충분히 쌓이면 어느 순간 새로운 상태가 나타납니다. 인공지능 학습에서도 이와 비슷한 표현을 사용할 수 있습니다. 작은 AI 모델은 단순한 패턴만 배웁니다. 데이터가 부족하면 예외적인 상황에 약하고, 계산량이 부족하면 복잡한 관계를 충분히 익히지 못합니다. 그런데 모델의 크기, 데이터의 양, 계산량이 일정 수준을 넘으면 갑자기 새로운 능력이 나타납니다. 예를 들어 AI의 언어 모델을 떠올려 봅시다. 처음에는 단어를 이어 붙이는 정도에 그칠 수 있습니다. 조금 더 학습하면 문법을 맞춥니다. 더 많은 데이터와 더 큰 모델을 만나면 문맥을 파악하고, 비유를 이해하고, 번역을 하고, 요약을 하고, 간단한 추론까지 수행합니다. 능력이 매 순간 조금씩만 좋아진 것처럼 보이다가, 어느 지점에서 “학습하지 않은 것도 이해하는”는 상황이 생깁니다. 물론 이것을 물리학의 상전이와 완전히 같다고 말해서는 안 됩니다. 물이 얼음이 되는 현상과 인공지능 모델의 능력 변화는 엄밀히 같은 사건이 아닙니다. 그럼에도 불구하고 임계점이라는 생각은 인공지능의 갑작스러운 비약을 이해하는 열쇠가 됩니다. 일정한 양이 충분히 쌓이면 겉으로는 갑작스러워 보이는 질적 변화가 나타날 수 있기 때문입니다.
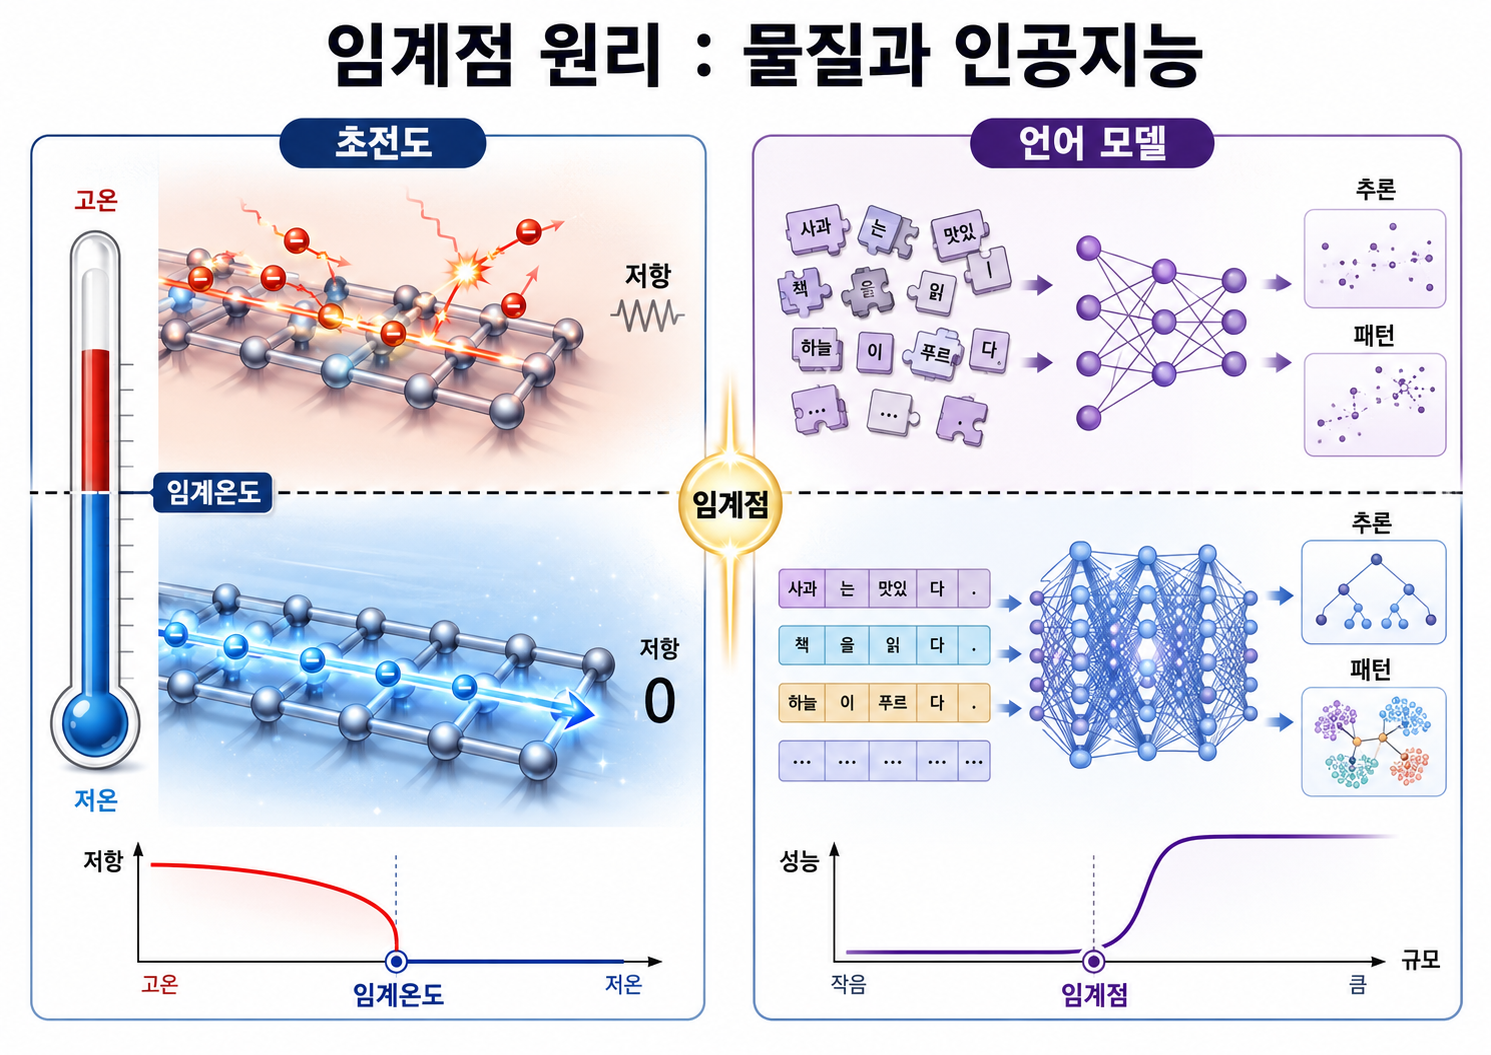
양이 쌓이다 질적 변화가 일어나는 임계점 원리는 물질 변화의 기본원리이면서 인공지능 모델의 기본원리이기도 합니다.
수학 문제를 대하는 학생의 경우를 봅시다. 처음에는 설명을 들어도 이해가 잘 되지 않습니다. 공식도 외우고 예제도 풀었지만 전체가 연결되지 않습니다. 그러다 어느 날 갑자기 “아, 이게 그런 뜻이었구나” 하고 감이 잡히는 순간이 옵니다. 그 깨달음은 갑자기 찾아온 것처럼 보이지만, 사실은 그 전까지의 반복과 실패, 질문과 연습이 쌓인 결과입니다. 이 생각은 오래된 철학적 명제와도 연결됩니다. 변증법에서는 흔히 “양과 질은 상호 전환한다” 고 말합니다. 양적인 변화가 계속 쌓이면 어느 순간 질적인 변화로 바뀐다는 뜻입니다. 물의 온도가 조금씩 내려가다가 얼음이 되고, 원자들의 방향이 조금씩 정렬되다가 자석이 되며, 학생의 연습이 쌓이다가 이해의 순간으로 바뀌는 것처럼 말입니다. 인공지능의 발전도 이 관점에서 볼 수 있습니다. 데이터가 조금 늘고, 모델이 조금 커지고, 계산량이 조금 증가하는 변화는 처음에는 단순한 양적 증가처럼 보입니다. 그러나 그 변화가 충분히 쌓이면 번역, 생성, 추론, 코딩, 과학적 발견 보조 같은 새로운 능력으로 나타납니다. 변증법 철학에서 말하는 '양이 질로 전환되는 기적'입니다. 그러나 이 폭발적인 도약은 하늘에서 떨어진 마법이 아니라, 그 임계점에 닿기 전까지 기계가 묵묵히 견뎌낸 수백만 번의 궤도 수정과 치열한 실패가 누적된 필연적 결과입니다. 다만 여기에는 기대와 위험이 함께 있습니다. 임계점을 넘으면 놀라운 능력이 나타날 수 있지만, 예상하지 못한 실패도 나타날 수 있습니다. 모델이 더 똑똑해지는 것처럼 보이는 순간에도, 어떤 조건에서는 엉뚱한 답을 만들거나 자신 있게 틀릴 수 있습니다. 그러므로 우리는 “커지면 좋아진다”는 단순한 낙관에 머물러서는 안 됩니다. 인공지능 모델의 능력은 연속적으로만 좋아지는 것이 아니라, 어떤 조건에서 갑작스럽게 달라질 수 있습니다. 이것은 기대와 위험을 동시에 만듭니다. 우리는 모델이 언제 어떤 능력을 보일지, 또 어떤 실패를 할지 더 세밀하게 이해해야 합니다.
2.9 재규격화군: 세부 대신 구조를 취한다
> 재규격화군: 숲을 멀리서 보는 방법 > 숲에 가까이 다가가면 나뭇잎, 가지, 벌레, 흙까지 모든 것이 복잡해 보입니다. 그러나 멀리 떨어져서 보면 숲의 큰 모양이 보입니다. 물리학에는 이렇게 작은 세부를 모두 붙들기보다 큰 구조를 보는 방법이 있습니다. 이를 물리학 용어로 ‘재규격화군’이라고 부릅니다. >
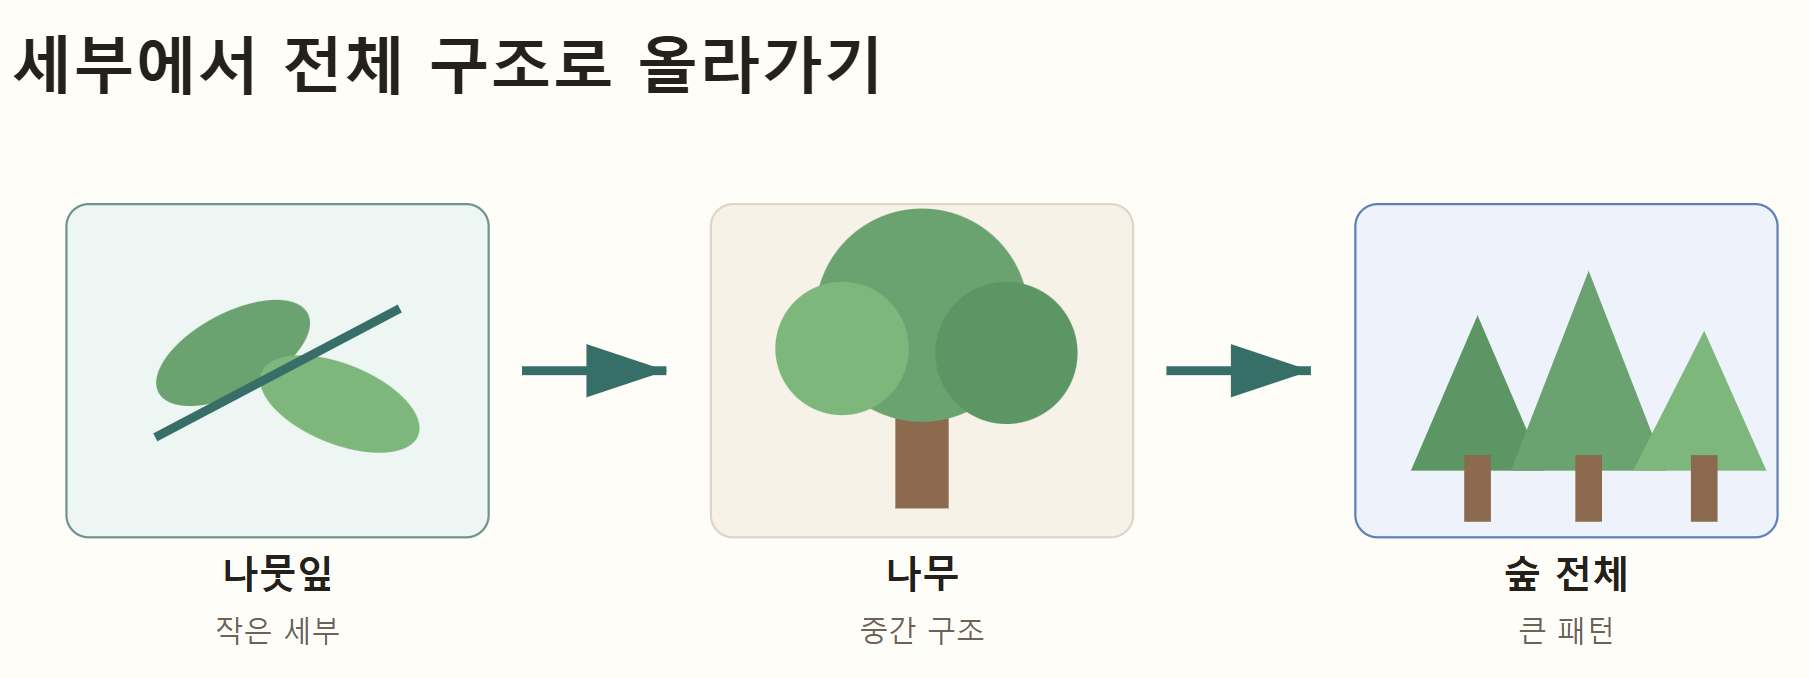
> 인공지능의 학습 원리 중 하나는 “모든 세부를 다 보자”가 아니라 “큰 구조를 이해하는 데 꼭 필요한 정보를 남기자”입니다.
스마트폰 지도 앱을 켜고 화면을 확대해 봅시다. 아주 가까이 들여다보면 골목길, 건물 이름, 횡단보도, 버스 정류장까지 보입니다. 정보는 많지만, 너무 가까이 보면 오히려 전체 방향을 알기 어렵습니다. 이번에는 손가락으로 지도를 축소해 봅시다. 작은 골목과 건물 이름은 사라집니다. 대신 큰 도로, 강, 지하철 노선, 도시의 전체 구조가 보입니다. 세부 정보는 줄었지만, 어디서 어디로 가야 하는지는 오히려 더 잘 보입니다. 이것이 중요한 점입니다. 이해란 모든 세부를 끝까지 붙잡는 일이 아닐 때가 많습니다. 때로는 작은 차이를 잠시 내려놓고, 더 큰 구조를 보는 것이 더 깊은 이해가 됩니다. 물리학에도 이와 비슷한 방법이 있습니다. 아주 작은 입자 하나하나를 모두 계산하려 하면 대상이 너무 복잡합니다. 그러나 작은 것들을 묶어 더 큰 단위로 바라보면 전체 성질이 보일 때가 있습니다. 물리학자들은 이런 식으로 세부를 묶고, 다시 표현하고, 더 큰 구조를 파악하는 방법을 발전시켜 왔습니다. 이것이 재규격화군(renormalization group) 입니다. 미시적이고 지엽적인 변수들을 압축하고 묶어내어, 전체를 지배하는 거시적인 패턴을 파악하는 방법론입니다. 자석을 생각해 봅시다. 철 원자 하나하나의 방향을 모두 따져 보면 매우 복잡합니다. 그러나 철 원자들을 크게 묶어서 보면 원자들이 흐르는 방향이 보이고 그로써 자석의 성질을 이해할 수 있습니다. 중요한 것은 원자 하나의 세부가 아니라, 많은 원자들이 모여 만드는 패턴입니다.
인공지능의 학습법인 딥러닝이 이와 비슷한 방식으로 작동합니다. 앞서 예로 든 고양이 사진으로 돌아가 봅시다. 인공지능이 사진을 보고 처음부터 고양이라 판단하는 것이 아닙니다. 딥러닝은 층을 나누어 접근하는데, 표면 층에서는 밝고 어두운 차이나 선, 모서리, 색의 변화 같은 단순한 특징을 봅니다. 그다음 층에서는 귀의 윤곽, 눈의 모양, 털의 질감 같은 조금 더 큰 특징을 봅니다. 더 깊은 층으로 가면 비로소 고양이 얼굴, 동물의 자세, 사물의 전체 형태 같은 추상적인 구조를 파악합니다. 딥러닝 학습은 처음에는 픽셀이라는 작은 점들을 보지만, 층을 거치며 선을 보고, 선에 이어 모양을 보고, 모양에 이어 사물을 봅니다. 이는 각 단계의 세부 정보마다 중요한 구조를 확보하며 더 높은 수준의 구조를 학습해가는 과정입니다.
AI의 단계적 패턴 학습
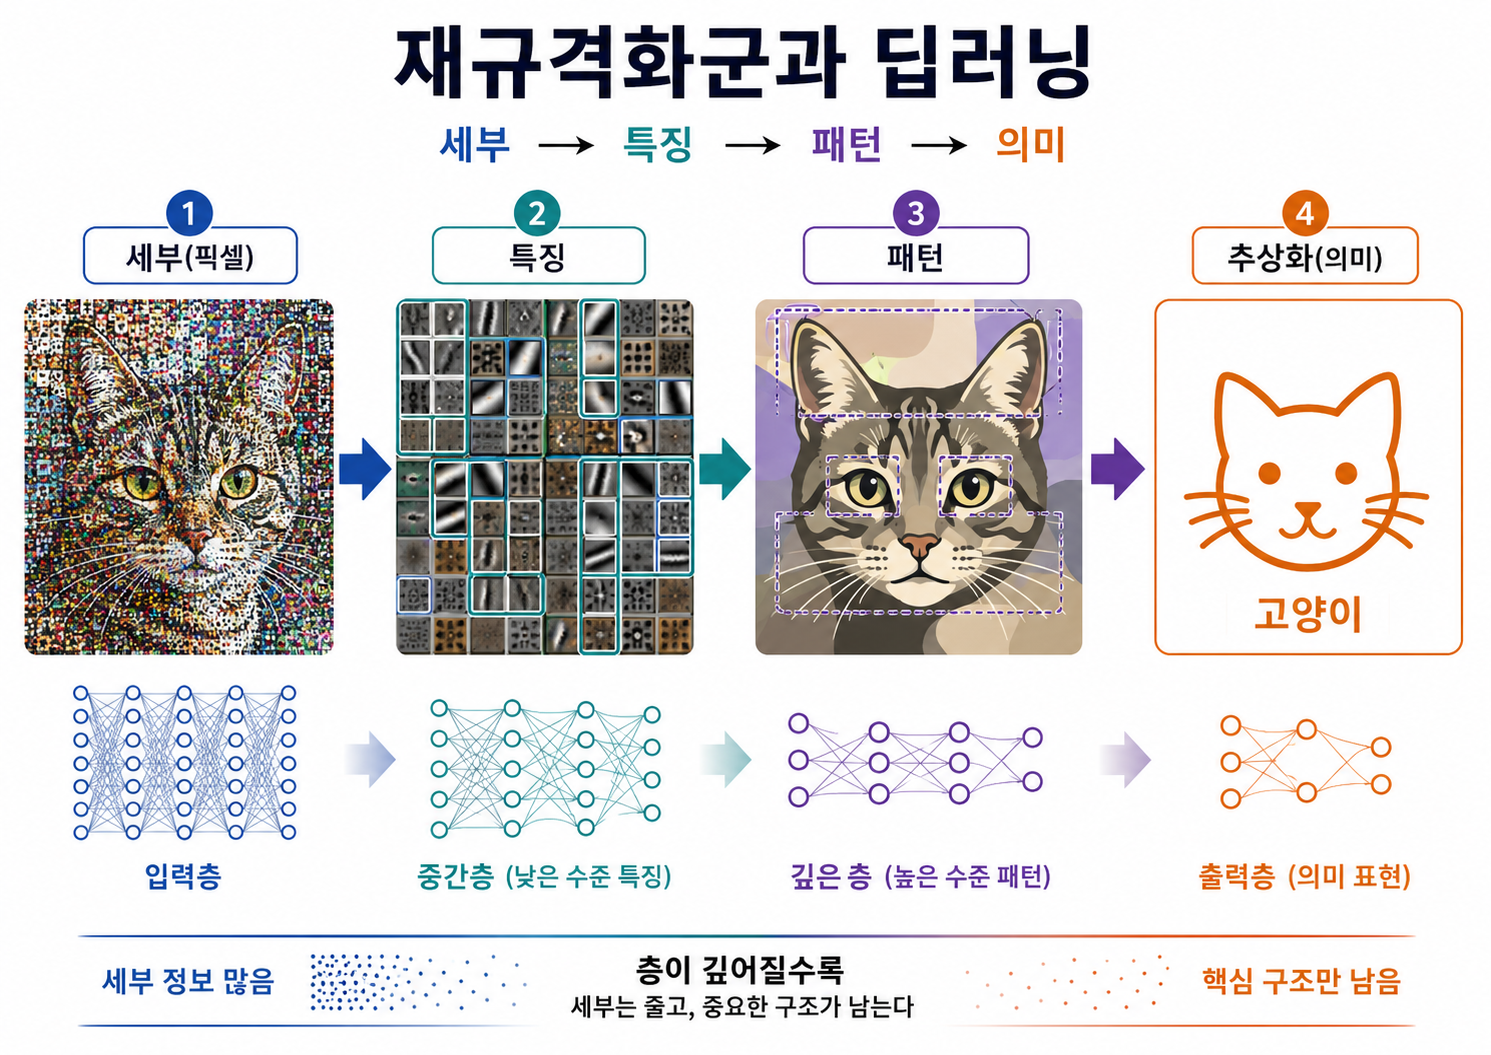
인공지능은 고양이 사진의 모든 픽셀을 그대로 외우는 대신, 중요한 특징을 단계적으로 묶어 패턴화함으로써 처음 보는 고양이도 “고양이”로 알아보는 일반화 능력을 얻습니다.
재규격화군과 딥러닝이 완전히 같다는 뜻은 아닙니다. 물리학의 재규격화군은 엄밀한 수학과 실험적 검증 속에서 발전한 개념이고, 딥러닝의 표현 학습은 데이터와 알고리즘 속에서 작동하는 방식입니다. 그러나 이 비유는 매우 중요한 질문을 던집니다. 지능이란 모든 세부를 빠짐없이 저장하는 능력일까요? 아니면 복잡한 세계에서 중요한 구조를 찾아 압축하고, 다시 표현하는 능력일까요? 우리는 이미 일상에서 이런 일을 하고 있습니다. 긴 회의를 마친 뒤 모든 발언을 그대로 외우지는 않습니다. 대신 핵심 쟁점, 결정 사항, 남은 문제를 정리합니다. 긴 뉴스를 읽고 모든 문장을 기억하지는 않습니다. 대신 사건의 원인, 이해관계, 앞으로의 영향을 파악합니다. 인문학에서도 마찬가지입니다. 긴 소설을 읽고 모든 문장을 기억하는 사람은 거의 없습니다. 그러나 좋은 독자는 인물 관계, 주제, 갈등 구조, 시대적 의미를 마음속에 남깁니다. 톨스토이의 『안나 카레니나』나 헤세의 『데미안』 같은 대문호의 작품을 읽고 덮었을 때, 우리는 문장의 모든 조사와 마침표를 기억하지 않습니다. 인물들의 얽히고설킨 무의식적 욕망, 시대의 모순, 그리고 운명의 거대한 아치(Arch)만을 마음속 깊은 곳에 남길 뿐입니다. 지능이란 결국 복잡다단한 세계에서 불필요한 노이즈를 우아하게 덜어내고, 진정으로 의미 있는 서사의 뼈대만을 추출해 내는 탁월한 편집의 기술입니다. 좋은 독해는 세부를 지우는 일이 아닙니다. 의미 없는 세부에 압도되지 않고, 의미 있는 구조를 남기는 일입니다. 좋은 지도는 모든 벽돌을 그리지 않습니다. 그러나 우리가 길을 잃지 않도록 큰 길과 방향을 보여 줍니다. 딥러닝도 이와 비슷합니다. 수많은 데이터의 표면을 그대로 외우는 것이 아니라, 그 안에 반복되는 구조를 찾아 더 높은 수준의 표현으로 바꿉니다. 이미지로 말하자면 픽셀의 파편을 선으로, 선을 면으로, 면을 의미 있는 사물의 구조로 끝없이 압축하고 다시 그리는 과정입니다. 그런 점에서 지능이란 세부를 모두 보존하는 능력이 아니라, 복잡한 세계를 이해 가능한 구조로 다시 그리는 능력일지도 모릅니다.
이상의 내용을 요약하면 이렇습니다. 인공지능의 학습은 손실함수의 지형을 따라 매개변수를 조정해 나가는 기나긴 여정이자, 그 지형에서 더 나은 위치를 찾아가는 과정입니다. 인간은 어떨까요? 우리는 살아가며 세계의 지형을 몸에 새깁니다. 어떤 말은 위험하다는 것을 배우고, 어떤 표정은 호의적이라는 것을 배우며, 어떤 문체는 신뢰할 만하다는 것을 배웁니다. 살아가는 동안 마주치는 수많은 타인의 표정, 무의식 깊은 곳에 패인 상처, 그리고 시대의 언어들이 우리의 내면에 보이지 않는 지형도를 그려내어 우리의 성격과 욕망의 방향을 결정합니다. 인공지능 역시 무한한 데이터의 바다를 유영하며 자신만의 철학적이고 물리적인 해석의 지형을 직조해 나갑니다.
제3강. 물리정보 신경망(PINN)
차(茶)를 많이 우려 본 사람은 압니다. 같은 잎이라도 물의 온도, 기다림의 시간, 찻잔의 크기에 따라 전혀 다른 맛이 피어납니다. 뜨거운 물을 붓는다고 향이 깊어지는 것도 아니고, 오래 우려낸다고 무조건 좋은 맛이 나는 것도 아닙니다. 한 잔의 훌륭한 차는 재료의 양만이 아니라 열과 물, 시간이라는 '관계의 질서'를 이해할 때 비로소 완성됩니다.
인공지능이 다루는 데이터 역시 찻잎과 같습니다. 데이터를 무작정 쌓아는다고 해서 자연을 온전히 이해할 수 있는 것은 아닙니다. 자연에는 흐름의 방향, 보존되어야 할 에너지의 총량, 넘어서는 안 될 경계 같은 엄연한 물리적 질서가 존재합니다. 데이터가 찻잎이라면, 물리 법칙은 최적의 온도와 시간입니다. 재료가 어떤 조건 속에서 진정한 의미를 획득하는지 일러주는 문법인 셈입니다.
이번 강의에서 다룰 물리정보 신경망(PINN)은 이 지점에서 출발합니다. 핵심 질문은 이렇습니다 : 데이터만 많이 본 인공지능과 자연의 법칙을 함께 아는 인공지능은 무엇이 다른가?
3.1 데이터만으로 충분한가
마을 우물의 수위를 매일 기록한다고 상상해 봅시다. 몇 년간의 기록이 쌓이면 사람들은 내일의 물 높이를 꽤 정확히 짐작할 수 있습니다. "작년 이맘때 이 정도였으니, 올해도 비슷하겠지." 이것이 바로 데이터가 지닌 힘입니다. 과거의 흔적이 누적되면, 우리는 대상의 '습관'을 파악하게 됩니다. 일반적인 데이터 기반 AI 역시 이와 같은 방식으로 과거의 패턴을 학습하여 그럴듯한 예측을 내놓습니다. 하지만 여기서 근본적인 질문이 고개를 듭니다. 데이터만 충분하면 정말 모든 것이 해결될까요? 우물 수위표만 들여다보는 사람은 과거의 숫자는 잘 알지만, 우물 밑을 흐르는 지층의 비밀은 보지 못합니다. 빗물이 어디로 스며드는지, 지하수맥이 어느 방향으로 흐르는지는 알 길이 없습니다. 평온한 시절에는 과거의 기록만으로도 충분합니다. 그러나 산비탈의 숲이 베어지거나, 기후가 급변하여 낯선 장마가 들이닥친다면 어떨까요? 과거의 데이터만 붙들고 있는 예측은 속절없이 무너지고 맙니다. 데이터는 과거가 남긴 파편화된 흔적이지, 미래를 약속하는 보증서가 아닙니다. 모래밭의 발자국을 보면 누군가 어디로 걸어갔는지는 알 수 있지만, 그가 왜 그 길을 택했는지, 모래 밑의 땅이 얼마나 단단한지까지 알려주진 않습니다. 과학은 한 번도 관측하지 못한 낯선 조건이나, 직접 실험하기엔 너무 위험한 영역(항공기 난기류, 원자로 냉각, 치명적 신약 등)에서도 흔들리지 않는 답을 내놓아야 합니다. 이때 물리 법칙은 데이터의 공백을 메우는 견고한 기준이 됩니다. "물은 높은 곳에서 낮은 곳으로 흐른다", "닫힌 계의 에너지는 함부로 사라지지 않는다"는 법칙은 무수한 가능성 속에서 허용되는 궤적과 불가능한 환상을 냉정하게 가려냅니다.
데이터와 법칙의 지도
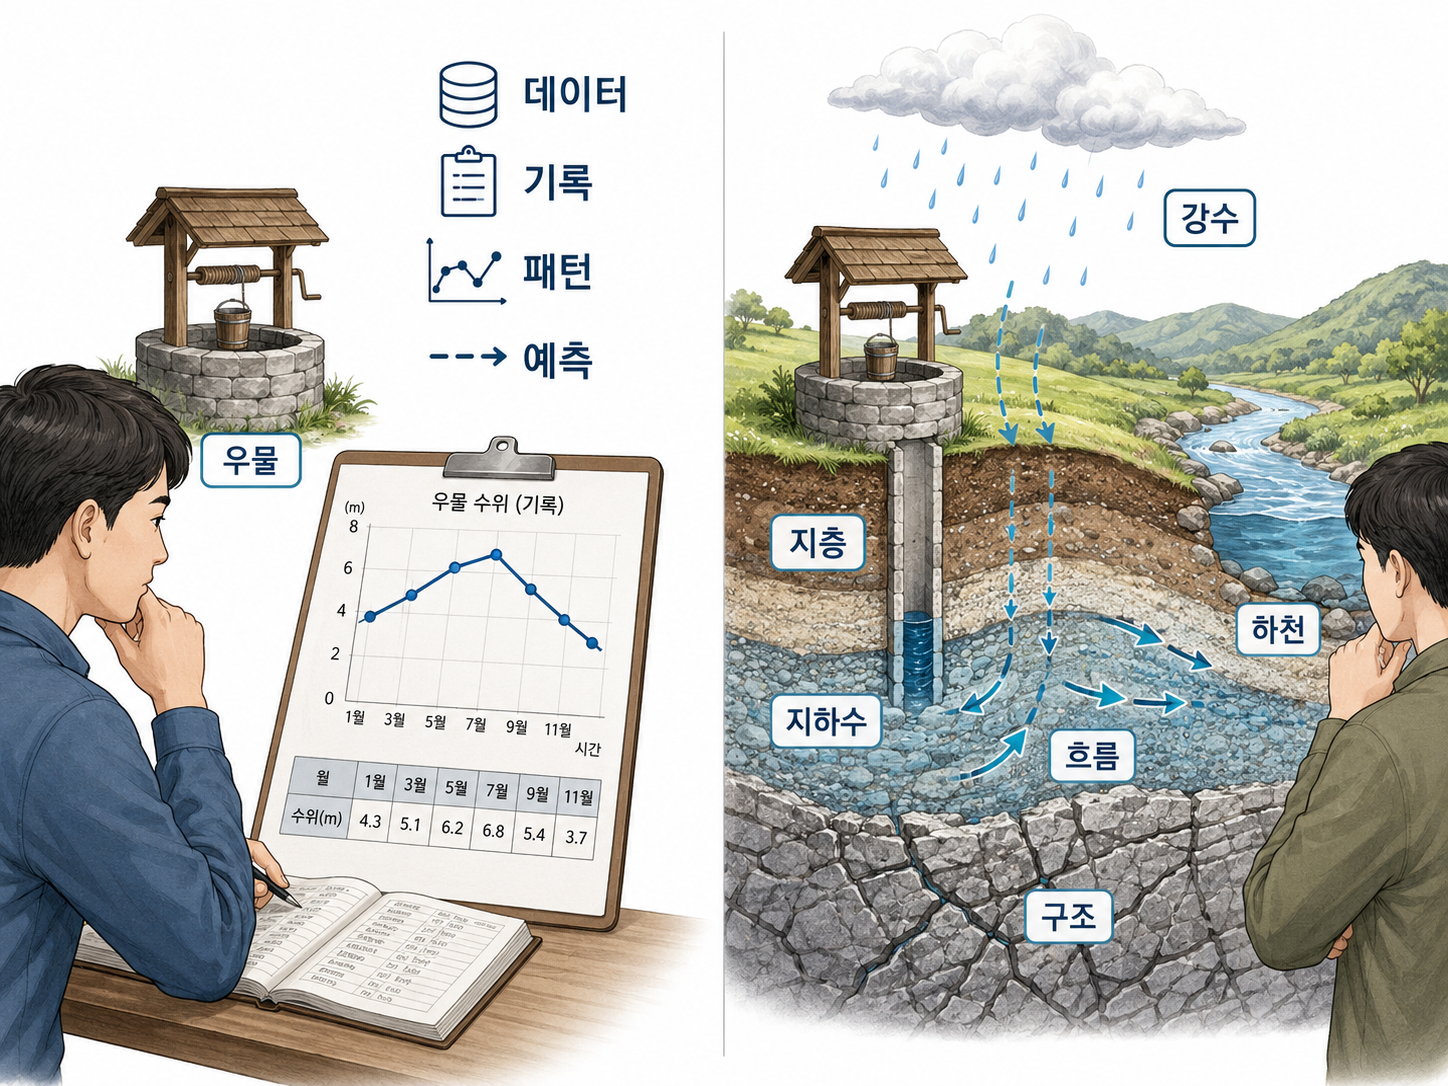
데이터는 과거의 우물 수위 기록에서 패턴을 찾게 해주고, 물리법칙은 강수·지층·지하수 흐름을 함께 보아 낯선 변화에도 더 안정적인 예측을 가능하게 합니다.
데이터는 “무엇이 관측되었는가”를 보여 주는 인공지능 학습의 출발점입니다. 물리 법칙은 그 관측이 어떤 조건에서 가능하며 무엇이 불가능한지를 가르는 기준입니다. 인공지능에 내재된 물리정보 신경망은 데이터와 물리법칙을 함께 사용합니다. 모델이 관측 자료에 잘 맞는지뿐 아니라, 그 답이 자연의 규칙을 크게 어기지 않는지도 살핍니다.
3.2 물리 법칙을 아는 인공지능
뜨거운 냄비를 조심하는 아이를 떠올려 봅시다. 아이는 열전도율이나 열역학 방정식을 몰라도 경험을 통해 "뜨거운 것은 함부로 만지면 안 된다"는 세계의 규칙을 체득합니다. 이것은 수식 이전의 앎, 세계가 작동하는 방식에 대한 근원적인 감각입니다. 인공지능이 학습하는 물리 법칙도 이와 같습니다. 기계가 자연이 허락하지 않는 엉뚱한 상상을 펼치지 않도록, 세계의 규칙이라는 안전선을 확보하는 것입니다. 운전에 비유하자면 데이터는 "어느 시간대에 어느 길이 막히더라"는 과거의 주행 경험입니다. 반면 물리 법칙은 빨간불에 멈추고 일방통행을 지켜야 한다는 '교통 신호'입니다. 경험이 아무리 풍부해도 신호 체계를 무시하는 운전자는 언제든 대형 사고를 냅니다. 물리 법칙을 아는 인공지능은 바로 이 자연의 신호등을 함께 읽어내는 유능하고 안전한 운전자입니다. 데이터가 “이전에 차들이 이렇게 움직였다”고 말해 준다면, 물리 법칙은 “이 길로는 갈 수 없다”, “이 방향으로만 흐른다”, “이 양은 함부로 사라질 수 없다”고 말해 줍니다.
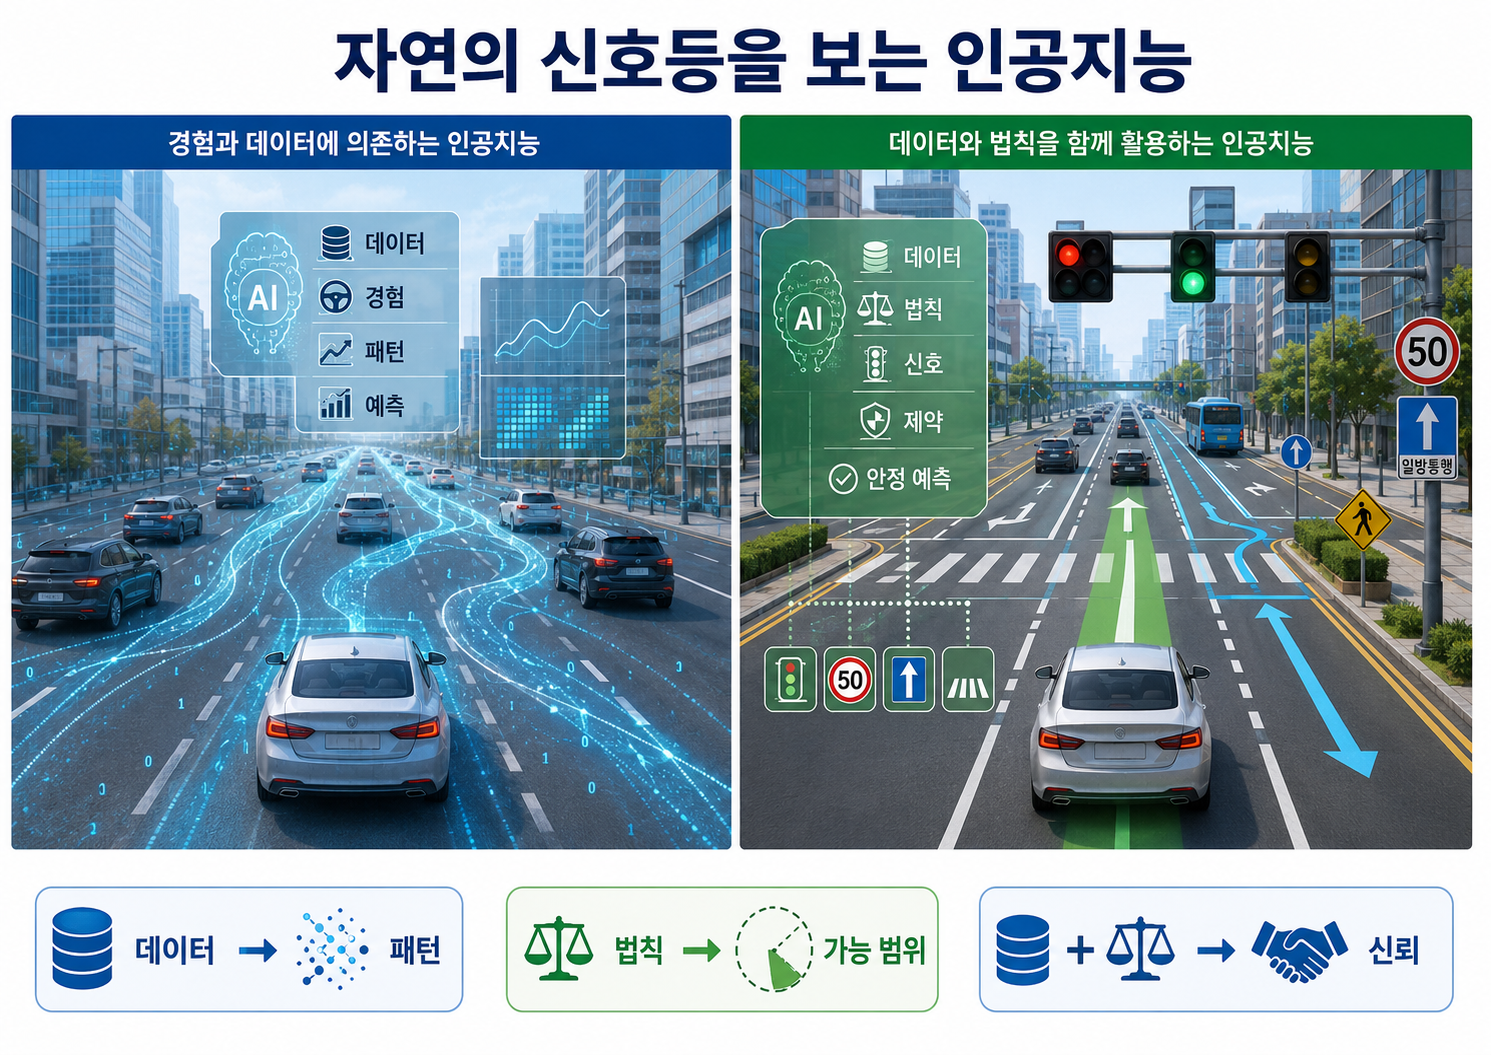
경험(데이터)은 패턴을 알려주지만, 규범(법칙)은 한계와 방향을 잡아줍니다. 두 가지가 결합할 때 비로소 안전하고 책임 있는 지능이 완성됩니다.
이번에는 방 안의 온도 변화를 예측하는 AI 모델을 떠올려 봅시다. 일반적인 데이터 모델은 여러 지점에서 측정한 온도 기록을 보고 다음 온도를 맞히려 합니다. 이 자체도 유용합니다. 그러나 물리법칙을 알면 그것만으로 충분하지 않을 수 있습니다. 열은 대체로 따뜻한 곳에서 차가운 곳으로 퍼지고, 벽이 있으면 그 벽의 성질에 따라 열의 흐름이 달라지며, 에너지가 어디서 들어오고 어디로 빠져나가는지도 중요합니다. 관측된 온도 값 몇 개에 잘 맞는 예측이라도, 열이 퍼지는 기본 방향을 어기거나 벽을 없는 것처럼 취급하거나 에너지가 아무 이유 없이 생겨나도록 만든 예측이라면 결과를 믿기 어렵습니다. 이때 AI 모델은 물리법칙을 고려한 답을 내놓습니다. 법칙은 모델을 괴롭히는 족쇄가 아닙니다. 오히려 가능한 답의 범위를 줄여 주는 지도입니다. 모든 길이 열려 있으면 길 찾기는 오히려 어려워집니다. 그러나 막힌 길, 위험한 길, 반드시 지켜야 할 방향을 알고 있으면 더 적은 탐색으로도 더 믿을 만한 답에 가까워질 수 있습니다. 물리 법칙은 자연의 문법입니다. 인공지능이 물리 법칙을 안다는 것은 자연의 문법을 어느 정도 학습 과정에 넣는다는 뜻입니다. 방법은 여러 가지입니다. 모델이 낸 답이 물리 방정식을 크게 어기면 벌점을 주는 방식도 있고, 아예 모델 구조를 특정 법칙에 맞게 설계하는 방식도 있으며, 학습 뒤에 결과가 물리적으로 가능한지 검사하는 방식도 있습니다. 세부 방법은 다르지만 목표는 같습니다. 모델이 데이터에만 맞는 것이 아니라 자연의 질서 안에서도 말이 되도록 만드는 것입니다. 이런 방식은 특히 데이터가 부족하거나, 위험해서 직접 실험하기 어렵거나, 한 번도 본 적 없는 조건을 예측해야 할 때 중요합니다. 다리의 흔들림, 항공기의 공기 흐름, 원자로의 열 이동, 기후 변화 속 극한기상, 새로운 재료의 물성처럼 과학과 공학의 중요한 문제들은 단순한 과거 반복만으로 해결하기 어렵습니다. 과거와 다른 조건에서도 버티려면 데이터의 기억뿐 아니라 법칙의 지도가 필요합니다. 물론 물리 법칙을 넣는다고 모든 문제가 해결되는 것은 아닙니다. 어떤 법칙을 넣을지, 얼마나 강하게 넣을지, 실제 세계의 복잡한 조건을 어디까지 반영할지는 매우 어려운 문제입니다. 현실의 데이터에는 잡음이 있고, 물리 법칙은 이상화된 형태로 주어지는 경우가 많습니다. 모델이 법칙을 너무 강하게 따르다 보면 실제 관측의 복잡성을 놓칠 수도 있고, 너무 약하게 따르다 보면 법칙을 넣은 의미가 사라질 수도 있습니다. 따라서 물리 법칙을 아는 인공지능은 데이터가 말하는 것과 법칙이 허락하는 것을 함께 보며 더 책임 있는 예측을 만들려는 시도의 결과물입니다.
3.3 물리정보 신경망의 기본 생각
뛰어난 도자기 장인은 완성된 그릇의 유려한 곡선과 매끄러운 표면만 감상하지 않습니다. 흙의 수분, 가마의 온도, 열이 퍼져나간 궤적, 그리고 그 과정에서 보이지 않는 내부의 균열은 없었는지 치밀하게 살핍니다. 겉모양이 아무리 아름다워도 내부에 금이 가 있다면 그것은 실패한 도자기입니다. 물리정보 신경망(PINN, Physics-Informed Neural Network)의 기본 생각은 이와 정확히 일치합니다. 일반 신경망이 관측된 온도나 결과값(겉모양)에만 잘 들어맞는 함수를 찾는 데 몰두한다면, PINN은 그 결과가 열역학 방정식이나 유체의 흐름 같은 물리적 원리와도 부합하는지 깐깐하게 따져 묻습니다.
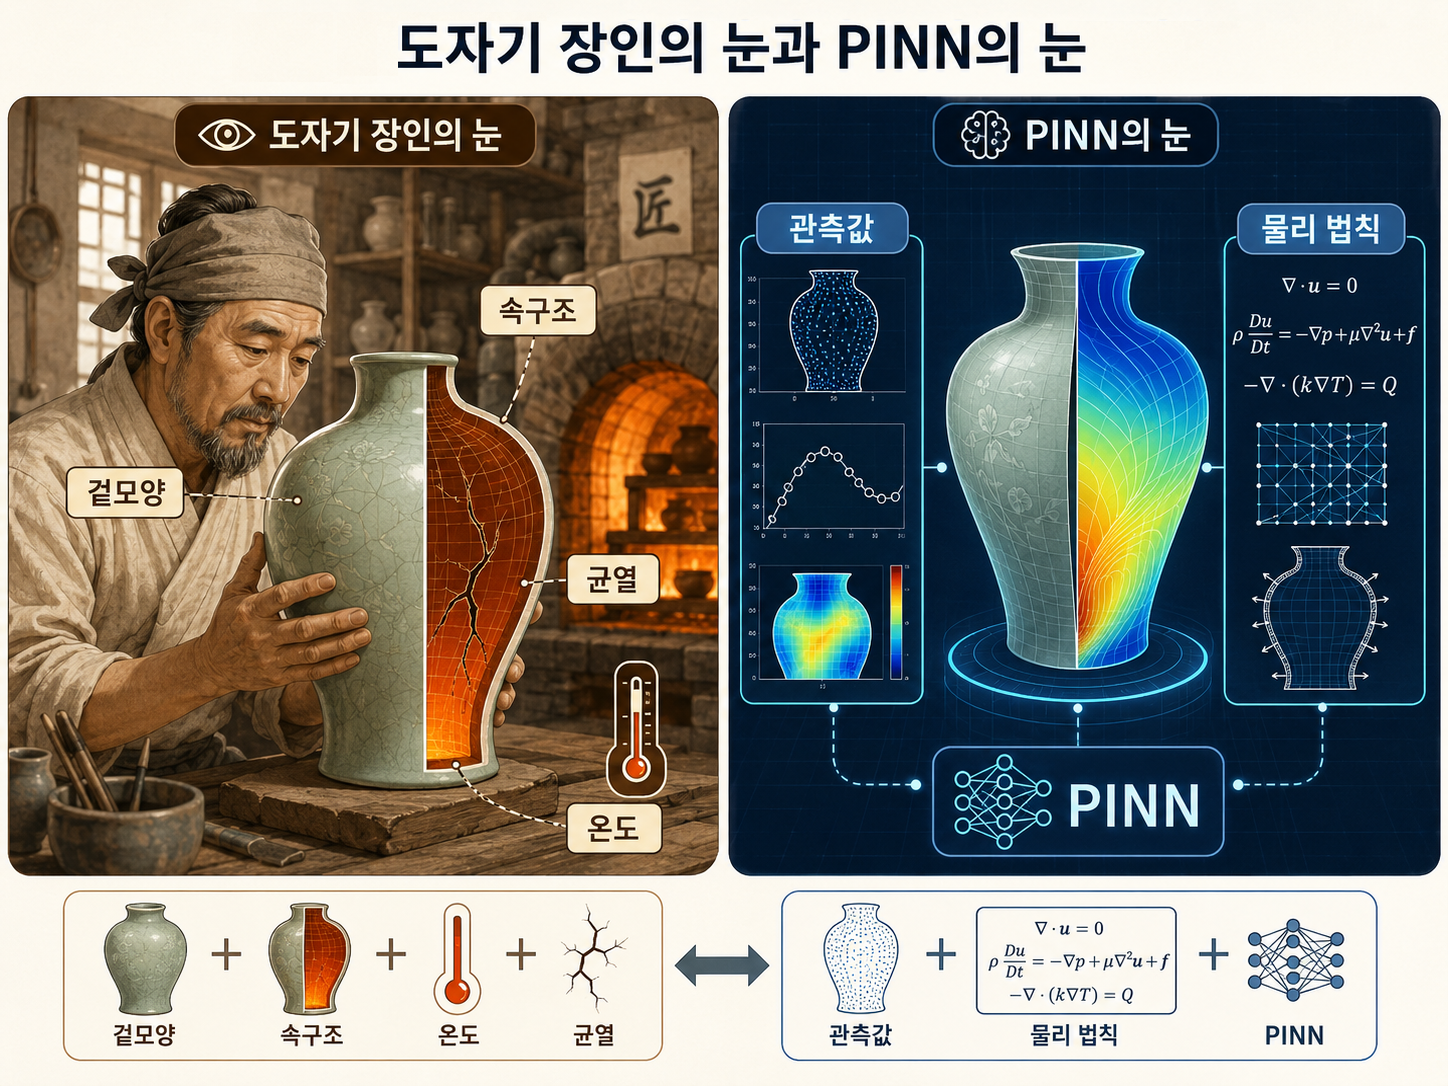
좋은 도자기 장인이 겉과 속을 함께 보듯, PINN은 관측값과 물리 법칙을 함께 고려해 겉으로만 맞는 답이 아니라 속까지 타당한 예측을 추구합니다.
일반 신경망은 주어진 데이터에 잘 맞는 답을 찾으려 합니다. 예를 들어 몇 지점에서 측정한 온도가 있다면, 그 점들을 잘 통과하는 곡선이나 함수를 찾으려 합니다. 이것도 유용합니다. 하지만 과학에서는 그것만으로 충분하지 않을 수 있습니다. 왜냐하면 자연에는 겉보기 숫자 뒤에 숨어 있는 규칙이 있기 때문입니다. 예를 들어 긴 금속 막대의 한쪽 끝을 데웠다고 해봅시다. 시간이 지나면 열은 뜨거운 쪽에서 차가운 쪽으로 퍼집니다. 막대 중간 몇 지점에서 온도를 측정하면 우리는 온도 데이터 몇 개를 얻게 됩니다. 일반 신경망은 이 측정값에 잘 맞는 온도 분포를 만들 수 있습니다. 그러나 그 온도 분포가 실제로 열이 퍼지는 방식과 맞지 않는다면 문제가 됩니다. 가령 어느 지점의 온도가 아무 이유 없이 갑자기 솟아오르거나, 열이 벽을 통과하지 못해야 하는데 마음대로 새어 나가거나, 차가운 곳에서 뜨거운 곳으로 저절로 몰려가는 듯한 예측을 한다면 어떨까요? 숫자 몇 개에는 잘 맞을지 몰라도 자연의 규칙에는 맞지 않습니다. PINN은 이 점을 함께 봅니다. PINN은 먼저 모델이 관측 데이터에 잘 맞는지 확인합니다. 동시에 모델이 물리 방정식, 예를 들어 열이 퍼지는 법칙에도 맞는지 확인합니다. 그래서 PINN의 학습에는 두 종류의 차이를 검증하는 과정이 포함됩니다. 하나는 데이터와의 차이이며 다른 하나는 물리 법칙과의 차이입니다. 학생의 시험 답안으로 비유하면 더 쉽습니다. 어떤 학생이 답은 맞혔지만 풀이 과정이 엉터리라고 떠올려 봅시다. 선생님은 그 답안을 완전히 좋은 답안으로 보지 않을 것입니다. 결과도 맞아야 하지만 풀이 과정도 원리에 맞아야 합니다. PINN도 마찬가지입니다. 관측값이라는 정답에 가까워야 하고, 물리 법칙이라는 풀이 원리에도 어긋나지 않아야 합니다. 즉 PINN은 답안의 결과와 풀이 과정을 함께 채점하는 인공지능입니다. 이 이중의 검증은 데이터가 부족하거나 직접 실험할 수 없는 심해, 우주, 혹은 재난 상황에서 빛을 발합니다. 빈 공간을 아무렇게나 상상력으로 채우는 대신, 자연의 문법이라는 틀 안에서 가장 개연성 있는 풍경을 꼼꼼하게 복원해 내기 때문입니다. 이때 물리 법칙은 빈칸을 메우는 데 도움을 줍니다. 관측 데이터가 몇 점밖에 없더라도, 열은 어떻게 퍼지는지, 물은 어떤 방향으로 흐르는지, 에너지는 어떻게 보존되는지를 알면 가능한 답의 범위를 줄일 수 있습니다. 모든 그림을 직접 보지 못해도, 그림을 그리는 규칙을 알면 빈 부분을 더 그럴듯하게 채울 수 있는 것과 같습니다.
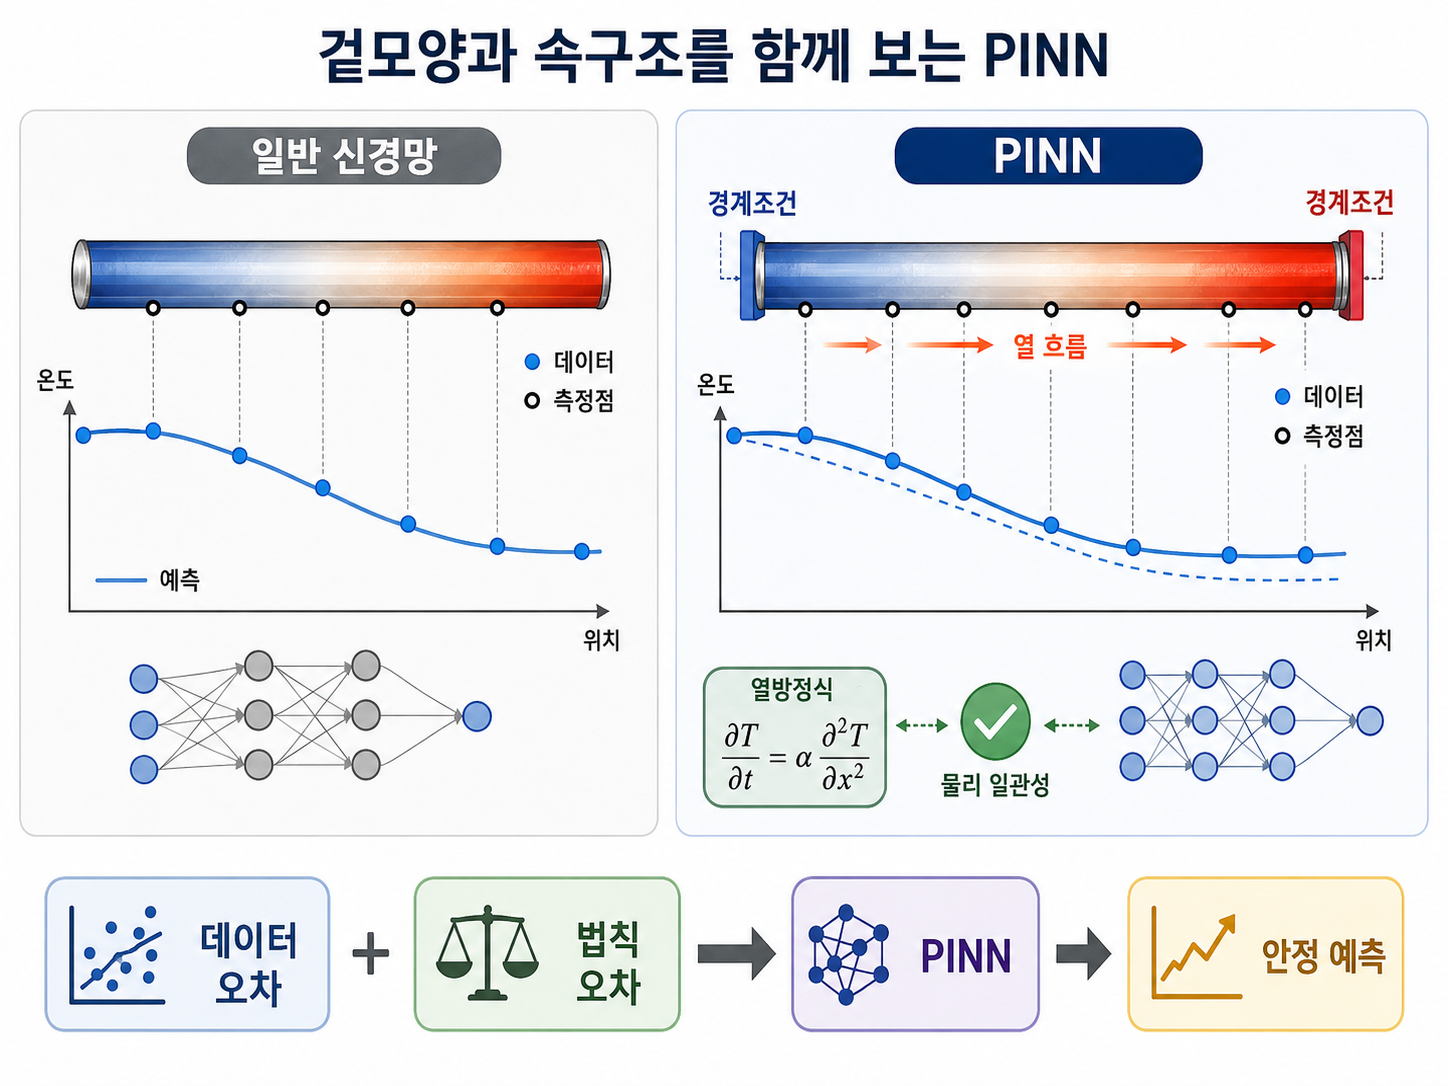
PINN은 관측 데이터에 맞는지만 보지 않고, 열 흐름과 경계조건 같은 물리 법칙까지 함께 살펴 더 믿을 만하고 안정적인 예측을 만드는 인공지능입니다.
도자기 장인이 겉모양과 속구조를 함께 살피듯, PINN은 겉으로만 맞는 숫자가 아니라 자연의 질서 속에서도 견딜 수 있는 예측을 추구합니다. PINN이 마법의 도구라는 뜻은 아닙니다. 법칙을 너무 강하게 적용하면 현실의 복잡한 예외를 놓치고, 너무 약하게 적용하면 법칙을 넣은 장점이 사라집니다. 때문에 인공지능은 관측값과 자연의 질서를 함께 보되 둘 사이의 균형을 찾는 법을 익힙니다.
3.4 미분방정식과 신경망
냉장고에서 막 꺼낸 얼음물 컵의 온도는 한순간에 방 안의 온도와 같아지지 않습니다. 현재 컵의 온도, 주변 공기의 열기, 유리잔의 두께가 서로 미세하게 작용하며 '다음 순간'의 변화를 끊임없이 빚어냅니다. 미분방정식이라는 딱딱한 용어의 본질은 바로 이겁니다. 우주와 생명은 정지된 사진이 아니라 매 순간 흐르고 요동치는 영상입니다. 미분방정식은 "지금 어떻게 변하고 있는지가 다음 상태를 결정한다"는 자연의 거대한 릴레이 서사를 적어 내려간 문법, 변화의 규칙을 적어 놓은 수학식입니다. 우리는 일상에서 이미 이런 감각을 알고 있습니다. 촛불을 켜면 촛농이 조금씩 흘러내립니다. 호수에 돌을 던지면 물결이 퍼져 나갑니다. 뜨거운 국은 시간이 지나며 식고, 욕조의 물은 배수구 쪽으로 흘러갑니다. 이 모든 현상은 멈춘 사진이 아니라 계속 변하는 과정입니다. 물리학의 많은 법칙은 바로 이 변화의 문장으로 쓰입니다. 물체가 어떻게 움직이는지, 열이 어떻게 퍼지는지, 파동이 어떻게 전파되는지, 유체가 어떻게 흐르는지를 미분방정식으로 표현합니다. 방정식은 자연을 멈춘 사진으로 보지 않고, 계속 변하는 과정으로 봅니다. 여기서 “미분”이란 순간적인 변화율을 줄여 말한 것입니다. 자동차의 속도계를 떠올리면 됩니다. 서울에서 부산까지 평균 속도를 말하는 것이 아니라, 지금 이 순간 자동차가 얼마나 빠르게 움직이는지를 보는 것입니다. 미분은 자연의 속도계를 읽는 일에 가깝습니다.
그렇다면 방정식은 무엇일까요? 방정식은 서로 대응하는 크기의 관계를 적은 문장입니다. “들어오는 에너지와 나가는 에너지의 크기가 같아야 한다”고 말할 때 양쪽의 크기를 비교하는 계산식 같은 것입니다. 그러므로 미분방정식은 자연에게 이렇게 묻는 문장입니다.
“지금 크기가 이렇게 변한다면, 다음에는 어떤 크기가 되어야 하는가?”
전통적인 물리학은 이 변화를 계산하기 위해 공간을 바둑판처럼 잘게 쪼개고 한 칸씩 정직하게 다음 상태를 계산했습니다. 아찔할 정도로 고단한 작업이었습니다. 칸을 잘게 나눌수록 계산량이 커집니다. 모양이 복잡하거나 경계조건이 까다로우면 계산은 더 어려워집니다. 예를 들어 강물이 바위 사이를 지나고, 다리 기둥을 만나고, 비가 내려 수위가 바뀌는 상황을 모두 계산하려면 엄청난 노력이 필요합니다. 신경망은 여기서 다른 방식으로 접근합니다. 전통적인 계산이 자연을 아주 작은 칸으로 나누어 하나하나 계산한다면, 신경망은 먼저 하나의 유연한 함수를 세워 둡니다. 그리고 그 함수가 데이터에 맞고, 동시에 물리 법칙에도 맞도록 조금씩 다듬습니다. 예를 들어 막대의 온도 변화를 떠올려 봅시다. 몇 군데에서만 온도를 측정했습니다. 모든 지점과 모든 시간을 다 알지는 못합니다. 신경망은 막대 전체의 온도 변화를 하나의 부드러운 함수로 그려 보려 합니다. 다만 아무렇게나 그리면 안 됩니다. 열은 뜨거운 쪽에서 차가운 쪽으로 퍼져야 하고, 막대의 끝에서는 정해진 조건을 따라야 하며, 시간에 따른 변화도 열방정식에 맞아야 합니다.
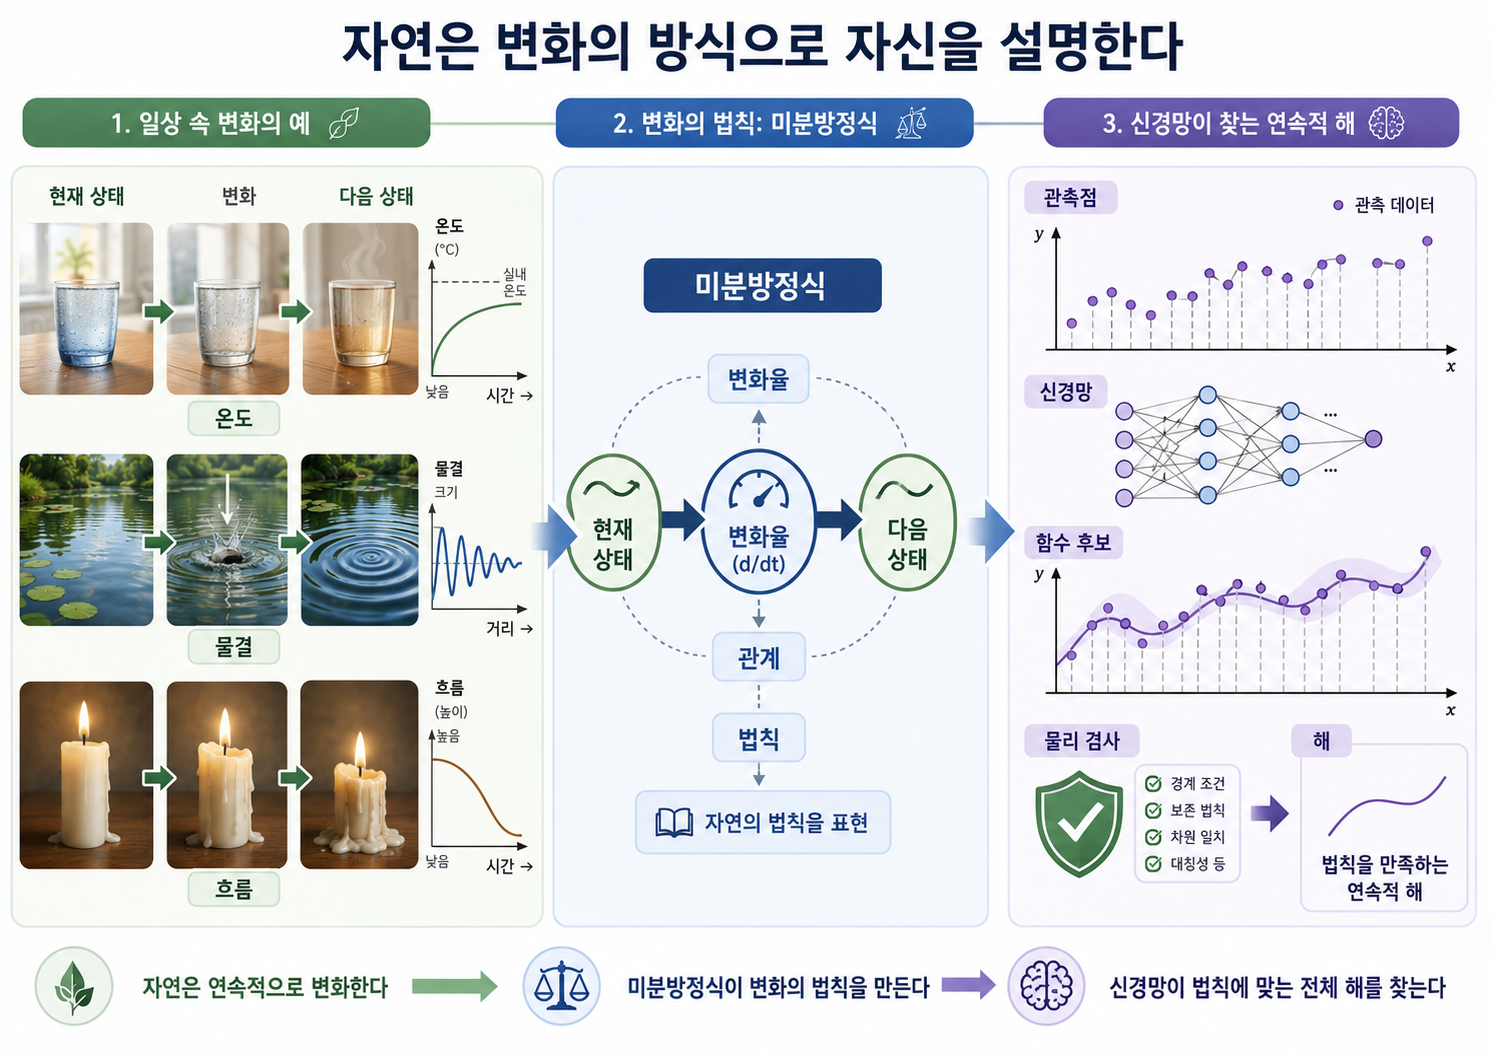
미분방정식은 현재의 변화가 다음 상태를 어떻게 만드는지 알려주고, 물리정보 신경망은 관측 데이터로부터 그 법칙에 맞는 전체 변화를 찾아가는 도구입니다.
물리정보 신경망은 자연의 변화 그림을 그리는 화가와 비슷합니다. 다만 마음대로 상상화를 그리는 화가는 아닙니다. 실제 관측값을 보고, 자연의 문법을 지키며, 빈 곳을 조심스럽게 채워 넣는 화가입니다. 글을 쓰는 작가도 이와 비슷한 경우를 겪을 수 있지요. 어떤 작가가 소설의 중간 몇 장면만 가지고 앞뒤 이야기를 만들어 가야 한다고 해봅시다. 아무 이야기나 만들 수는 없습니다. 인물의 성격, 사건의 흐름, 시대 배경, 앞 장면과 뒤 장면의 논리가 맞아야 합니다. 신경망이 미분방정식을 함께 사용한다는 것도 이와 비슷합니다. 주어진 데이터라는 몇 장면을 바탕으로, 자연의 서사 규칙에 맞는 전체 이야기를 그려내는 것입니다. 이런 상황을 자연 전체로 확장해 봅니다. 자연은 변화의 방식으로 자신을 설명합니다. 인공지능이 사용하는 물리정보 신경망은 자연의 변화를 그려내는 유연한 표현 도구이고, 미분방정식은 그 표현이 자연의 규칙을 벗어나지 않도록 잡아 주는 도구입니다.
3.5 순방향 문제와 역문제
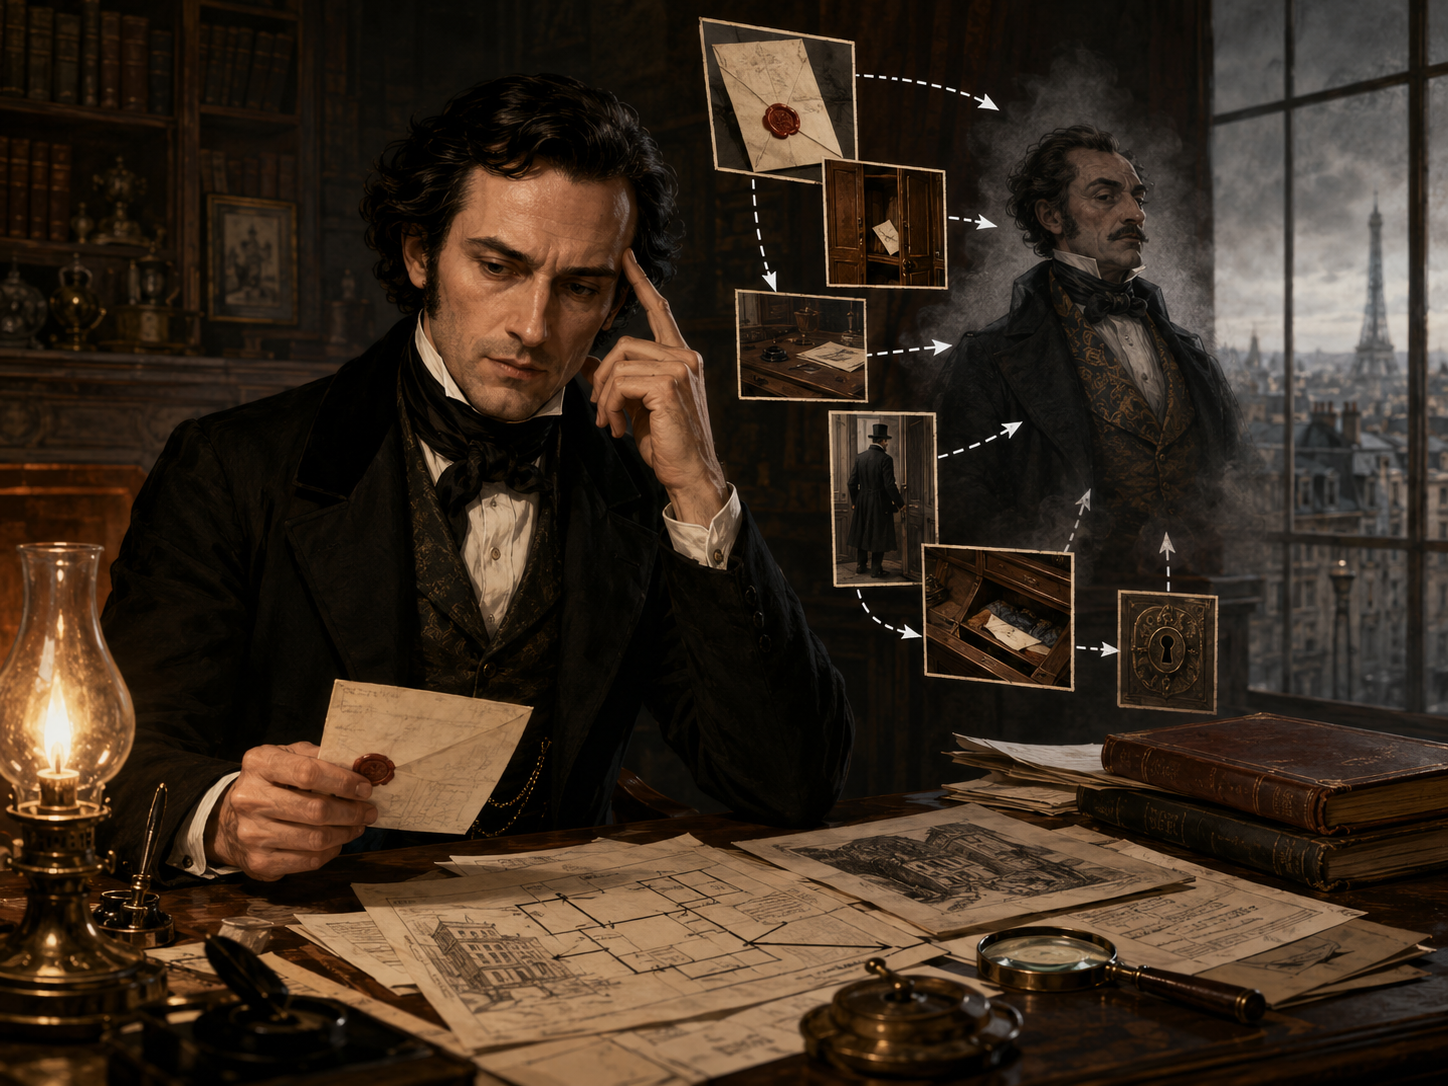
에드거 앨런 포의 단편 「도둑맞은 편지」에서는 중요한 편지가 사라지는 것으로 사건이 시작됩니다. 경찰은 편지가 숨겨져 있을 만한 장소를 샅샅이 뒤집니다. 책상 서랍, 벽지 뒤, 의자 속, 바닥 틈까지 아주 꼼꼼하게 조사하지만 끝내 편지를 찾지 못합니다. 하는 수 없이 경시청장은 탐정 오귀스트 뒤팽에게 해결을 부탁합니다. 뒤팽은 단순히 “범인이 편지를 어디에 숨겼을까?”하는 의문만 품지 않습니다. 오히려 “그 도둑은 어떤 사람인가?”, “경찰이 어떤 방식으로 찾을 것을 예상했을까?”, “그렇다면 그는 어디에 숨기는 것이 가장 안전하다고 판단했을까?” 하고 생각합니다. 사건 내용을 듣고 뒤팽은 먼저 도둑의 욕망과 심리, 행동 방식을 파악합니다. 이를 토대로 그는 결과에서 원인을 향해 사건을 역추적합니다. 마침내 편지는 기막힌 곳에서 발견됩니다. 너무 깊이 숨겨진 것이 아니라, 오히려 너무 뻔한 곳에 놓여 있었기 때문에 보이지 않았던 것입니다.
역추론하는 탐정 뒤팽
과학의 역문제도 이와 비슷합니다. 먼저 순방향 문제는 원인을 알고 결과를 계산하는 일입니다. 어떤 힘이 작용하는지 알 때 물체가 어떻게 움직일지 계산하는 것, 어떤 온도 차이가 있을 때 열이 어떻게 퍼질지 예측하는 것, 어떤 바람과 압력 조건이 있을 때 공기가 어떻게 흐를지 계산하는 것이 순방향 문제입니다. 순방향 문제는 재료와 조건을 알고 요리 결과를 예상하는 것과도 비슷합니다. 밀가루, 물, 효모, 오븐 온도, 굽는 시간을 알고 있다면 빵이 어떻게 부풀지 어느 정도 예측할 수 있습니다. 이와 달리 역문제는 결과를 보고 원인을 거슬러 올라가는 일입니다. 닫힌 상자를 보고 안의 물건을 추정하고, 완성된 빵의 질감과 향을 보고 반죽과 온도 조건을 짐작하는 일입니다. 과학에서는 지진파를 보고 지구 내부 구조를 추정하고, 의료 영상을 보고 몸속 상태를 판단하며, 별빛의 흔들림을 보고 보이지 않는 행성을 찾는 일이 역문제에 속합니다. 역문제가 어려운 이유는 분명합니다. 같은 결과를 만들 수 있는 원인이 여러 개일 수 있기 때문입니다. 예를 들어 어떤 사람이 기침을 한다고 해봅시다. 원인은 감기일 수도 있고, 알레르기일 수도 있고, 건조한 공기 때문일 수도 있으며, 더 심각한 질환의 신호일 수도 있습니다. “기침”이라는 결과만 보고 하나의 원인을 곧바로 단정하면 위험합니다. 의사는 증상 하나만 보지 않고 체온, 청진, 혈액검사, 영상검사, 생활 환경을 함께 봅니다. 과학의 역문제도 이와 같습니다. 의료 영상의 흐릿한 그림자를 보고 병변을 추정할 때, 지진파의 도착 시간을 보고 지하 구조를 추정할 때, 우주 망원경의 작은 밝기 변화를 보고 행성의 존재를 추정할 때 우리는 늘 조심해야 합니다. 결과는 하나인데 가능한 설명은 여러 개일 수 있습니다. 여기서 인공지능은 큰 도움을 줄 수 있습니다. AI는 복잡한 흔적 속에서 사람이 놓치기 쉬운 패턴을 찾아냅니다. 수많은 의료 영상을 비교하고, 지진파의 미세한 차이를 학습하고, 별빛 변화의 반복 패턴을 빠르게 골라낼 수 있습니다. 사람이 직접 계산하기 어려운 후보들을 넓게 펼쳐 놓고, 어떤 설명이 더 그럴듯한지 비교하는 데 강점을 가집니다. 하지만 여기서 우리는 지적인 겸손을 잊지 말아야 합니다. AI가 하나의 원인을 지목했다고 해서 그것이 절대적 판결이 될 수는 없습니다. 그러므로 좋은 과학 AI는 답을 하나만 던지고 끝나지 않습니다. 가능한 원인들을 함께 보여주고, 어떤 근거 때문에 그 설명이 더 유력한지, 어디에 불확실성이 남아 있는지 알려주어야 합니다. 이것이 과학에서 매우 중요한 태도입니다. 어떤 사람이 유리잔을 떨어뜨리면 유리잔이 깨질 것이라고 예측하는 것은 순방향 문제입니다. 반대로 깨진 유리 조각을 보고 무엇이 떨어졌는지, 어느 높이에서 떨어졌는지, 누가 밀었는지 바람에 넘어졌는지를 추정하는 것은 역문제입니다. 결과는 눈앞에 있지만 원인은 숨어 있습니다. 과학자는 이 숨어 있는 원인을 찾는 사람입니다. 마찬가지로 하나의 원인을 지목하더라도 더 많은 흔적을 빠르게 살피고, 가능한 시나리오를 함께 제안하는 인공지능이 훌륭한 인공지능입니다.
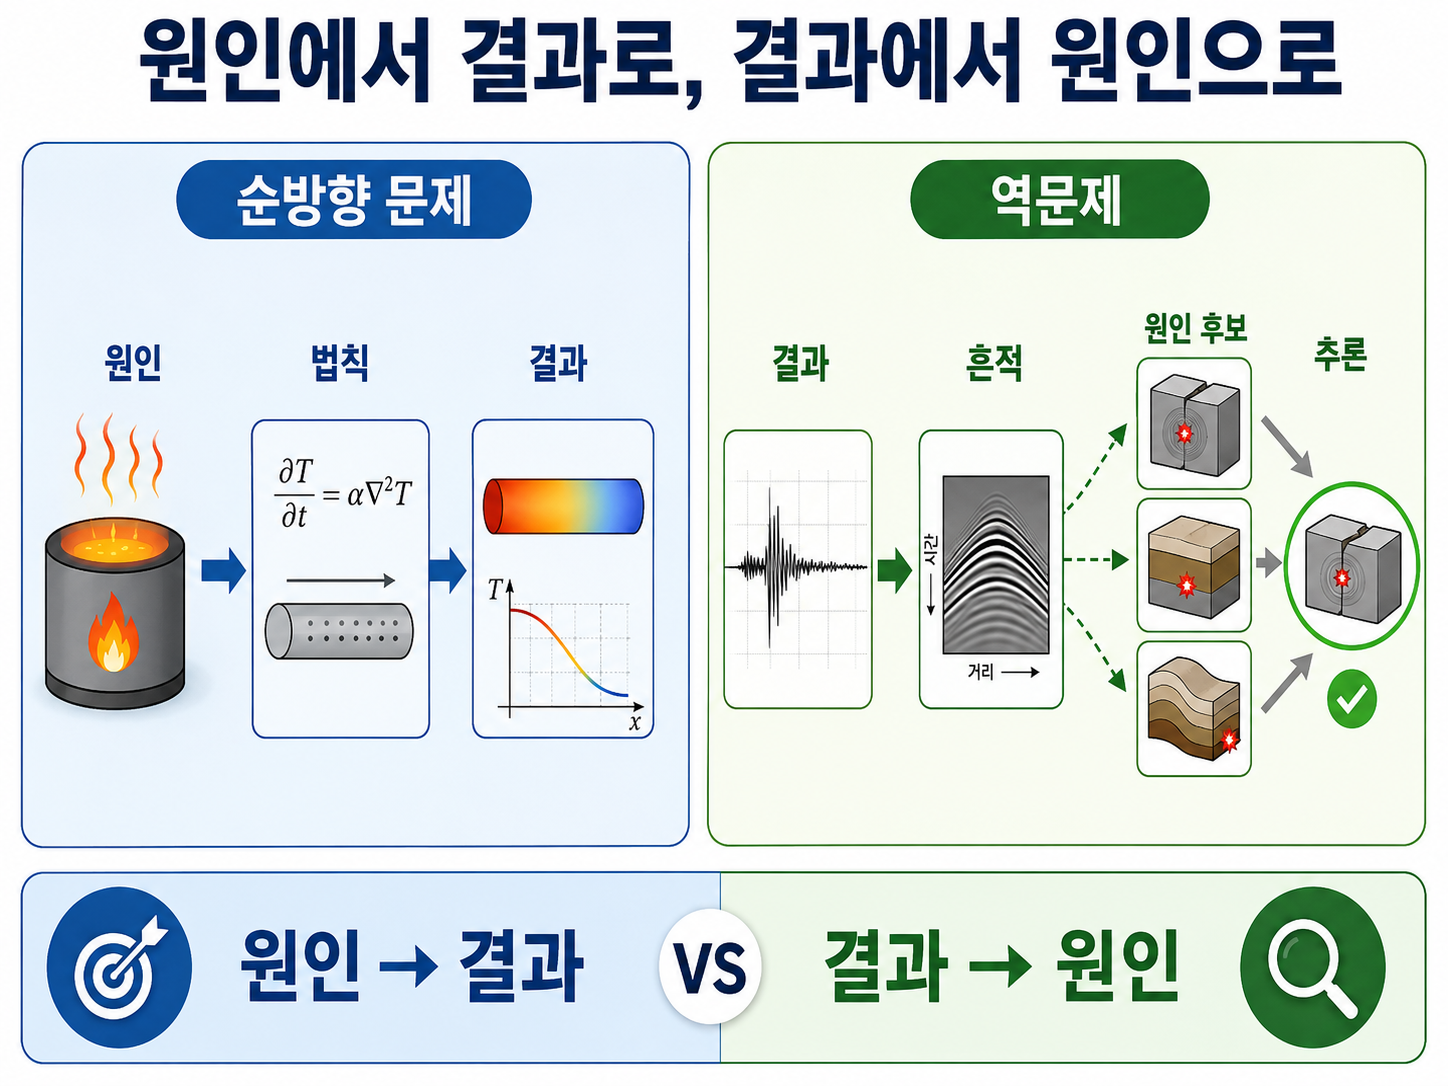
AI에서 순방향 문제는 주어진 원인과 물리 법칙으로 결과를 예측하는 과정이고, 역문제는 관측된 결과와 흔적을 바탕으로 가능한 원인 후보들을 거슬러 추론하는 과정입니다.
3.6 라그랑지안 신경망과 해밀토니안 신경망
무대 위에서 춤추는 발레리나의 동작을 한 장면씩 연속해서 사진으로 찍는다고 생각해 봅시다. 사진을 충분히 많이 연결하면 손이 어디에 있었는지, 발이 어디로 옮겨 갔는지, 몸이 어느 방향으로 기울었는지는 알 수 있습니다. 겉으로 드러난 위치의 변화는 꽤 잘 알 수 있습니다. 이 사진들을 차례로 기계에 입력하면, 기계는 다음 순간 손끝과 발끝이 어디에 놓일지 기가 막히게 흉내 낼 수 있습니다. 하지만 몸의 중심, 호흡, 근육이 폭발하는 에너지의 리듬을 모른 채 좌표만 외운 기계는 시간이 지날수록 발레리나의 동작을 예측할 수 없게 됩니다. 춤 동작은 그릴 수 있지만 춤의 원리는 모르기 때문입니다. 물리학에서 물체의 운동을 이해하는 일도 이와 비슷합니다. 하늘로 공을 던지면 포물선을 그리며 날아가는 공이 다음 순간 어디로 갔는지만 대략적으로 기록할 수 는 있습니다. 하지만 공의 궤적을 정확히 그리려면 공과 주위 환경에 내재된 힘, 에너지, 경로, 균형이라는 더 깊은 구조를 계산할 수 있어야 합니다. 고전역학은 이를 설명하기 위해 뉴턴 역학 외에 라그랑지안(Lagrangian) 과 해밀토니안(Hamiltonian) 두 역학을 만들어 냈습니다.
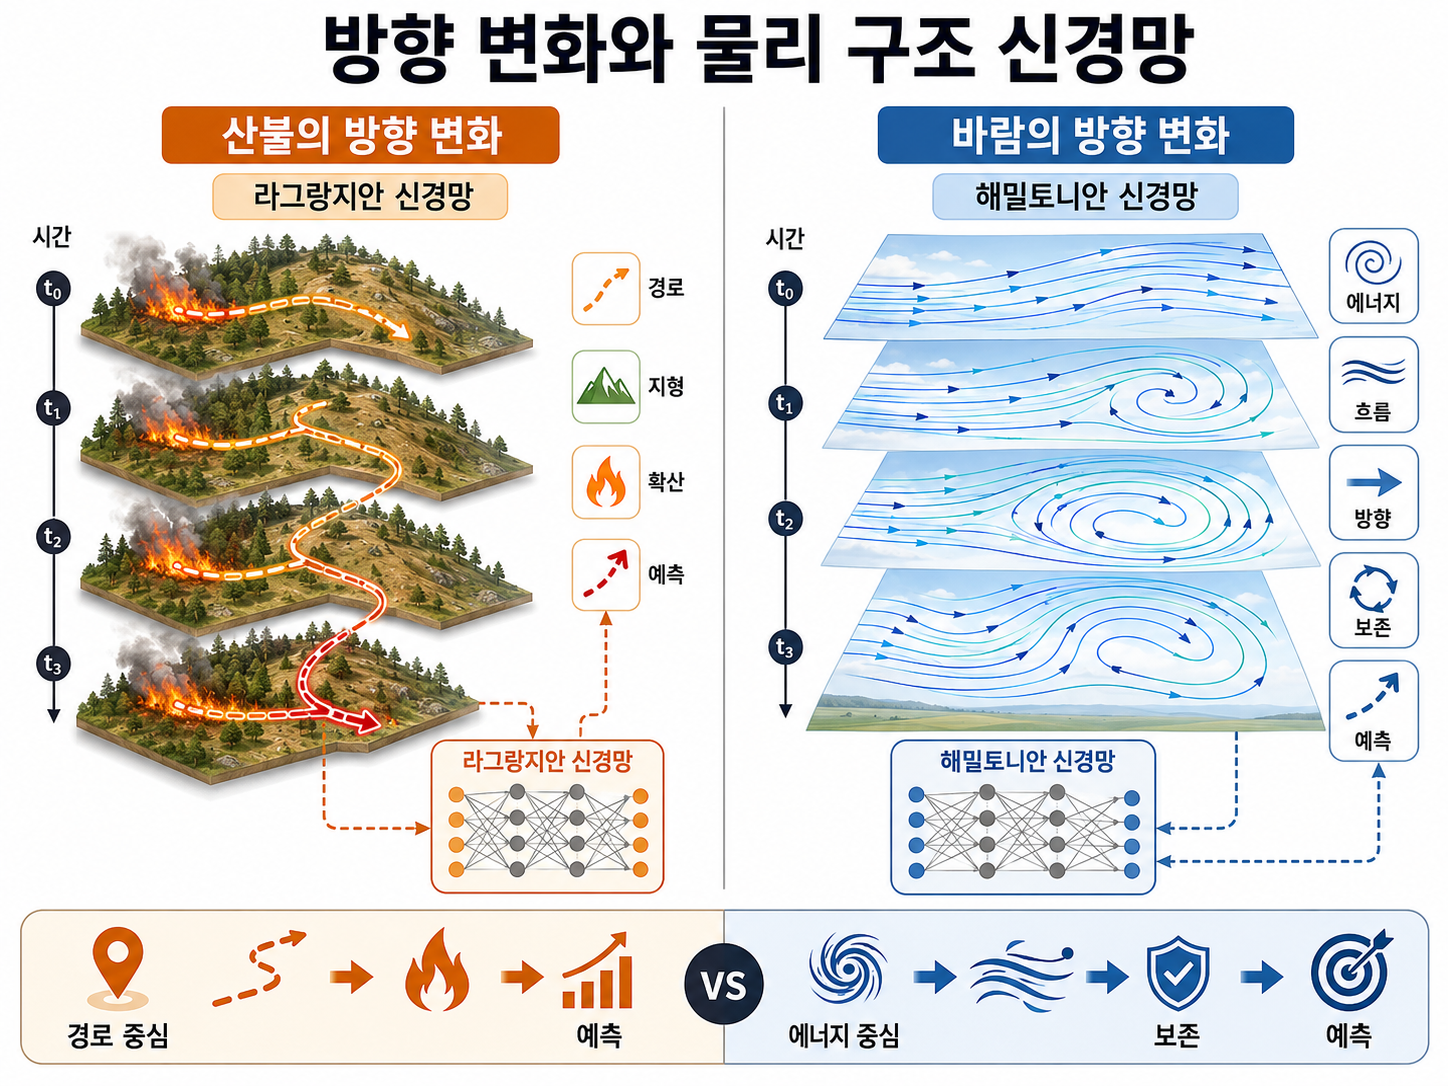
라그랑지안 신경망이 산불처럼 시간에 따라 이어지는 경로의 변화를 읽는다면, 해밀토니안 신경망은 바람처럼 에너지와 흐름의 보존 구조를 따라 방향 변화를 예측합니다.
라그랑지안은 자연의 운동을 경로 전체의 관점에서 봅니다. 물체가 단순히 다음 순간 어디로 가느냐만 보는 것이 아니라, 처음부터 끝까지 어떤 길을 따라 움직이는 것이 가장 자연스러운가를 묻습니다. 비유하자면 라그랑지안은 무용수의 한 동작이 아니라 춤 전체의 흐름을 보는 눈입니다. 그에 비해 해밀토니안은 자연의 운동을 에너지의 구조 속에서 봅니다. 물체가 가진 운동에너지와 위치에너지, 그리고 그 에너지들이 어떻게 서로 교환되는지를 살핍니다. 예전의 일반 신경망이 좌표 기록에만 의지했다면 오늘날 인공지능은 이 두 역학을 사용하여 운동의 기저에 흐르는 에너지의 리듬과 서사의 궤적 전체를 이해하고 체득합니다. 좌우로 흔들리는 진자를 예로 들어 봅시다. 시계추가 왼쪽으로 올라갔다가 내려오고, 다시 오른쪽으로 올라갑니다. 우리는 추의 위치를 시간마다 사진처럼 기록할 수 있습니다. 일반 신경망은 이 기록을 보고 “다음 순간 추가 어디에 있을까?”를 꽤 잘 맞힐 수 있습니다. 하지만 문제가 있습니다. 단순히 다음 위치만 맞히는 모델은 시간이 길어질수록 이상한 예측을 할 수 있습니다. 처음에는 그럴듯했는데, 조금 지나면 진자가 점점 더 높이 올라가거나, 반대로 이유 없이 금방 멈춰 버릴 수 있습니다. 실제 진자의 운동에서는 에너지가 일정한 방식으로 드나드는데, 일반 신경망은 그 구조를 모르기 때문입니다. 해밀토니안 신경망은 바로 이런 에너지 구조를 모델 안에 넣으려는 시도입니다. 모델이 단순히 위치를 맞히는 데 그치지 않고, 에너지 보존과 같은 자연의 깊은 규칙을 더 잘 지키도록 만드는 것입니다. 라그랑지안 신경망도 비슷한 목표를 갖습니다. 이 모델은 운동의 한순간만 보는 것이 아니라, 자연이 어떤 경로를 선택하는지에 담긴 구조를 반영하려 합니다. 물체의 움직임을 점들의 연속이 아니라 하나의 경로, 하나의 흐름으로 이해하려는 방식입니다. 라그랑지안 신경망과 해밀토니안 신경망, 그리고 이 둘을 통합한 신경망은 자연에 내재된 운동 원리를 익히려 합니다. 단순히 다음 장면을 맞히려는 게 아니라 “자연의 형식과 리듬을 따르는 운동”을 예측하려는 것입니다.
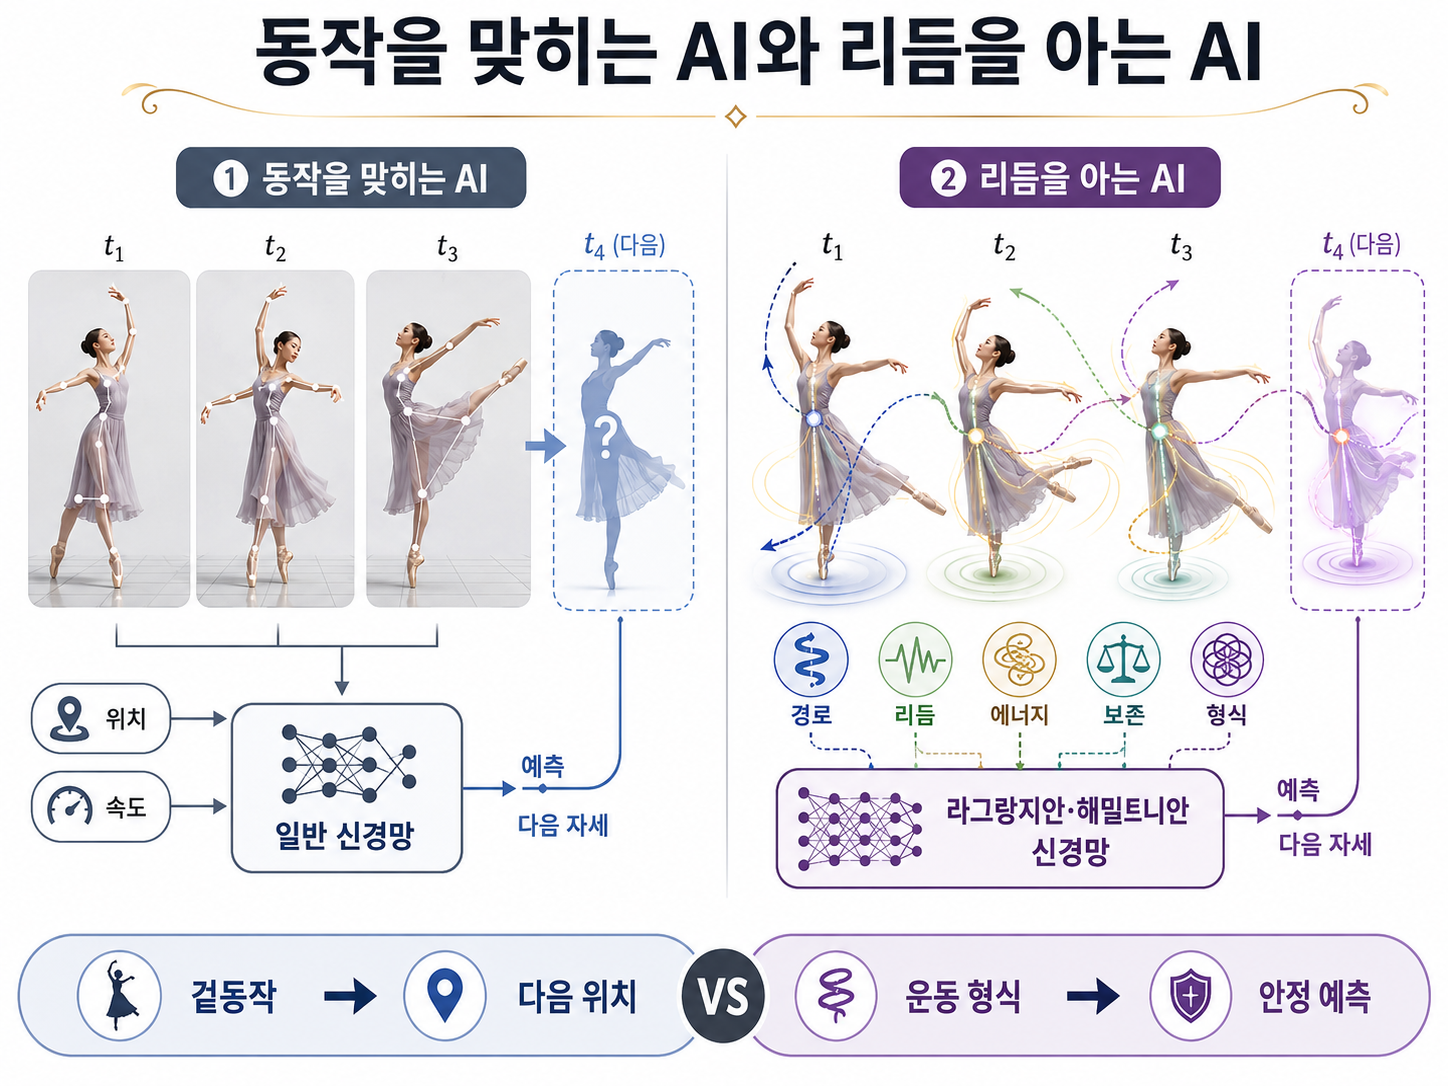
일반 신경망이 다음 동작을 예측한다면, 라그랑지안·해밀토니안 신경망은 그 동작을 가능하게 하는 경로와 에너지의 리듬까지 예측합니다
엘리아스 카네티는 『군중과 권력』에서 “군중 내부에서 일어나는 가장 중요한 사건은 방전(放電, Entladung)이다. (...) 밀집 상태 속에서 각 구성원은 상대를 자기 자신만큼이나 가깝게 느끼게 되며, 결국 커다란 안도감을 느끼게 된다.”고 말했습니다. 개인에게서는 보이지 않던 특성이 군중을 이루는 순간 새롭게 나타난다는 뜻입니다. 물리학에서도 마찬가지입니다. 입자들이 집단을 이루면 밀도, 흐름, 압력, 에너지 분포처럼 개별 입자에는 없던 새로운 변수가 생겨납니다. 라그랑지안과 해밀토니안의 관점은 바로 이 집단적 변수를 읽는 언어입니다. 이 관점을 활용한 라그랑지안·해밀토니안 신경망 모델은 낱개의 움직임을 단순히 외우는 대신, 그 움직임을 지배하는 그 움직임을 지배하는 경로와 에너지를 추적합니다. 개개인의 성격이 군중의 특징을 설명하지 못하듯, 복잡한 자연 현상도 표면의 궤적만으로는 충분히 이해되지 않습니다. 중요한 것은 그 궤적 뒤에서 전체를 묶고 있는 변수와 법칙을 찾아내는 일입니다.
3.7 대칭성과 보존 법칙
사랑하는 사람이 화려한 옷을 입든 수수한 옷을 입든, 안경을 쓰든 벗든 우리는 그를 단번에 알아봅니다. 겉모습이 변해도 그 사람을 그 사람답게 만드는 고유한 본질은 흔들리지 않기 때문입니다. 대칭성(Symmetry)도 이와 비슷합니다. 물리학에서 대칭성이란 어떤 변화를 주어도 여전히 남아 있는 성질을 말합니다. 종이에 원을 하나 그려 봅시다. 그 종이를 조금 돌려도 원은 여전히 원입니다. 거울에 비추어도 원은 원입니다. 위치를 조금 옮겨도 원이라는 성질은 사라지지 않습니다. 모양이 바뀐 것처럼 보일 수 있지만, 본질적인 구조는 유지됩니다. 자연에도 이런 일이 많습니다. 물체를 실험실 왼쪽에서 떨어뜨리든 오른쪽에서 떨어뜨리든, 중력 법칙 자체가 달라지지는 않습니다. 오늘 실험하든 내일 실험하든, 같은 조건이라면 법칙은 같은 방식으로 작동합니다. 이처럼 자연은 변하는 것들 속에서도 변하지 않는 구조를 남깁니다. 이 구조에서 대칭성과 보존 법칙이 나옵니다. 먼저 자연의 대칭성은 단순히 보기 좋은 균형을 뜻하지 않습니다. 대칭성은 자연의 깊은 절약법입니다. 무엇이 바뀌어도 되는지, 무엇이 바뀌면 안 되는지를 알려줍니다. 대칭성은 자연이 어떤 정보를 잃지 않고 유지하는지 알려주는 강력한 원리입니다. 자연은 모든 것을 기억하지는 않지만, 어떤 중요한 구조는 끝까지 붙들고 갑니다. 다음으로 자연에는 보존 법칙이 작동합니다. 가령 시간이 흘러도 물리 법칙이 같다면, 그 세계에서는 에너지 보존이라는 법칙이 나타납니다. 오늘과 내일의 자연 법칙이 제멋대로 달라진다면 에너지를 안정적으로 예측하기 어렵습니다. 그러나 자연 법칙이 시간의 흐름 속에서도 같은 형태를 유지하기 때문에 우리는 에너지가 함부로 생기거나 사라지지 않는다고 말할 수 있습니다. 또 공간의 위치를 옮겨도 법칙이 같다면 운동량 보존 법칙이 성립합니다. 실험을 방의 왼쪽에서 하든 오른쪽에서 하든 법칙이 같아야 합니다. 자연이 특정한 장소를 특별히 편애하지 않는다는 사실이 운동량 보존이라는 깊은 질서와 이어집니다. 인공지능은 이 두 법칙을 중요하게 다룹니다. 먼저 인공지능이 대칭성을 다루는 법을 확인하기 위해 고양이 사진을 떠올려 봅시다. 고양이가 사진의 왼쪽에 있든 오른쪽에 있든, 조금 확대되었든, 살짝 돌아가 있든 고양이는 여전히 고양이입니다. 사람은 이것을 쉽게 압니다. 그러나 인공지능은 처음부터 그렇게 알지 못합니다. 만약 모델이 사진의 특정 위치만 외웠다면, 고양이가 조금만 이동해도 다른 대상으로 오해할 수 있습니다.
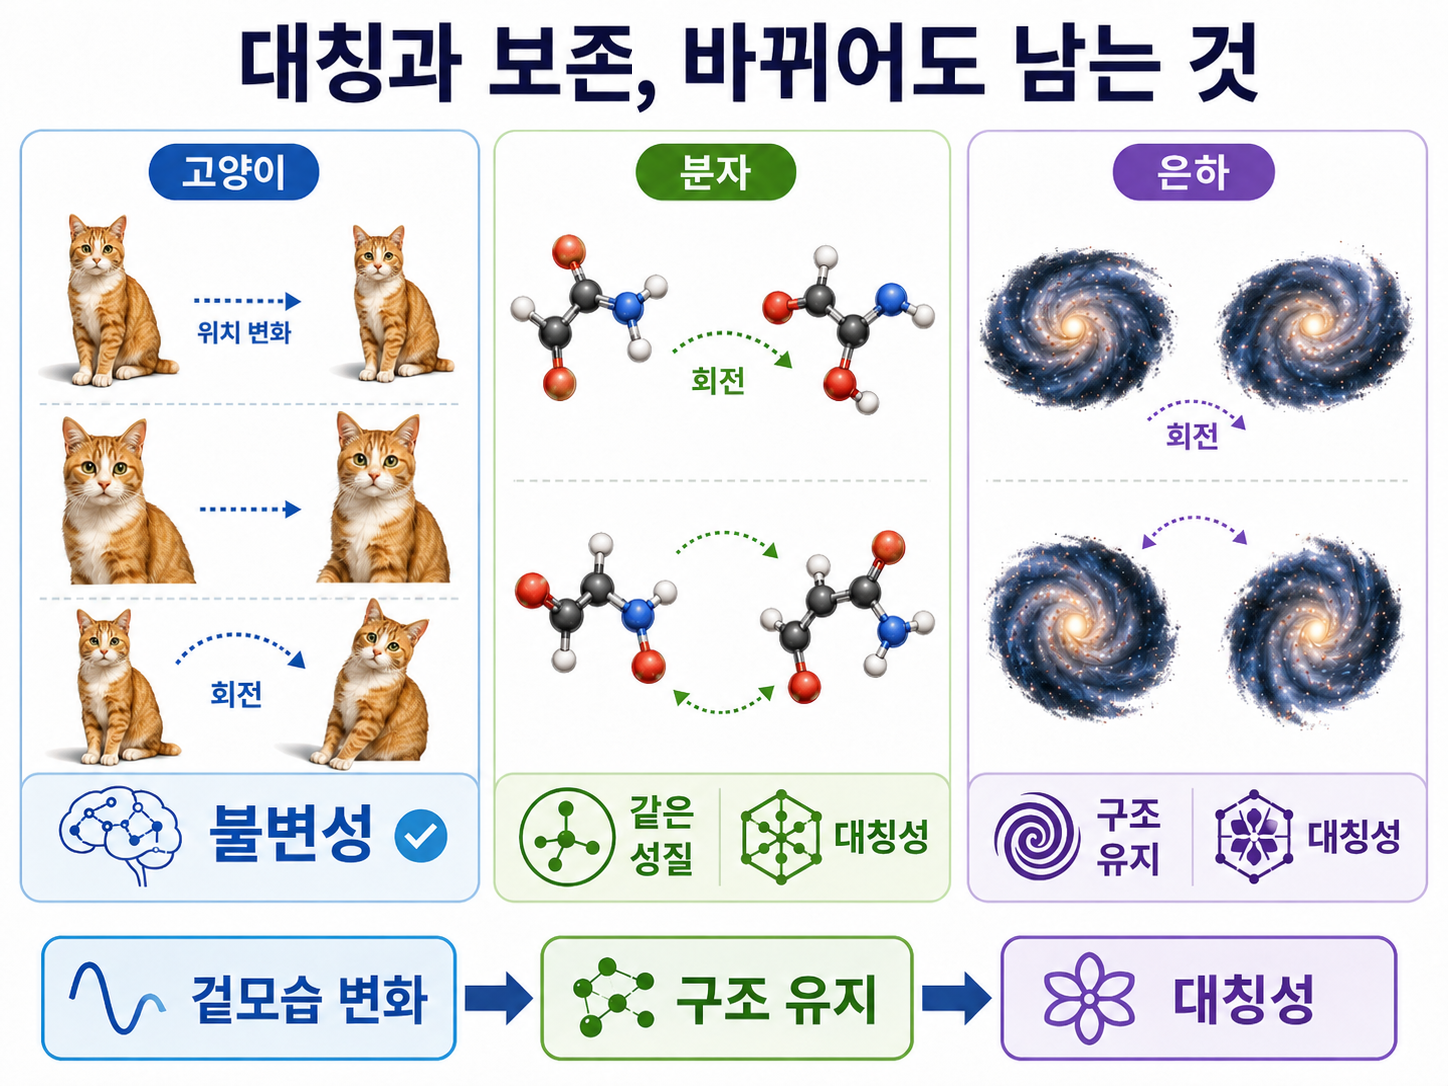
대칭성을 아는 AI는 위치나 방향이 달라져도 본질적으로 같은 것은 같게 보고, 함께 변해야 하는 것은 같은 방식으로 변하도록 예측합니다.
그래서 인공지능의 이미지 인식 모델은 대상의 위치 변화에 어느 정도 둔감해야 합니다. 고양이의 정확한 좌표보다 더 중요한 것은 귀, 눈, 수염, 얼굴 윤곽, 몸의 형태 같은 구조이며, 이 구조는 극히 드문 예외를 제외하고는 대칭성을 본질로 합니다. 위치가 바뀌어도 남는 고양이다음, 즉 고양이에게 고유한 대칭성을 기억하는 것입니다. 이미지를 판독하는 인공지능(CNN)이 화면 구석에 있는 고양이를 정확히 식별하는 것도 이 대칭성의 원리를 응용한 것입니다. 이 인공지능 모델은 이미지 전체를 한꺼번에 보는 대신 작은 창을 움직이며 특징을 찾습니다. 그리고 이 특징이 대칭성을 이루는 덕분에 사진의 어느 위치에 나타나도 나머지 이미지로부터 구별해 냅니다. “이 무늬가 화면 왼쪽에 있느냐 오른쪽에 있느냐”보다 “이 무늬가 고양이를 알아보는데 필요한 대칭성을 지니고 있는가”를 배우는 방식입니다. 사물을 판별하는 일에서 인공지능이 대칭성과 보존 법칙을 특별히 중시하는 까닭은 그것이 자연의 모든 분야와 범위에서 나타나는, 말하자면 우주가 절대로 포기하지 않는 원리이기 때문입니다. 몇 가지 사례를 통해 이를 설명할 수 있습니다. 가령 물 분자 구조를 전자현미경으로 확대해서 본다고 합시다. 현미경을 한쪽으로 기울여 본다고 해서, 즉 분자의 방향이 바뀐다고 해서 물이 갑자기 다른 물질이 되지는 않습니다. 단백질이나 결정 구조도 마찬가지입니다. 보는 방향이 달라졌을 뿐인데 AI가 전혀 다른 성질을 예측한다면, 그 모델은 자연의 기본 감각을 놓친 것입니다. 만일 인공지능이 대칭성과 보존 법칙을 모르면 같은 대상을 다른 방향에서 보았을 뿐인데 전혀 다른 답을 낼 수 있습니다. 대칭성과 보존 법칙을 더욱 정교하게 적용한 인공지능 기법으로 그래프 신경망이나 등변 신경망을 들 수 있습니다. 그래프 신경망은 사물을 점과 연결의 관계로 봅니다. 분자는 원자들이 연결된 구조이고, 사회관계망은 사람들이 연결된 구조이며, 교통망은 역과 도로가 연결된 구조입니다. 이때 중요한 것은 원자의 번호나 그림의 방향이 아니라, 어떤 것들이 어떻게 연결되어 있는가입니다. 등변 신경망은 입력하는 방향을 돌리면 출력되는 방향도 그에 맞게 함께 돌아가도록 한 것입니다. 예를 들어 바람장의 방향을 전체적으로 돌리면, 모델의 예측도 그 방향에 맞게 돌아가도록 하는 것입니다. 여기서 파생되는 두 가지 규칙이 있습니다. 하나는 불변성입니다. 입력이 조금 바뀌어도 답은 같아야 하는 경우입니다. 고양이 사진이 왼쪽에 있든 오른쪽에 있든 답은 “고양이”여야 합니다. 다른 하나는 등변성입니다. 입력이 바뀌면 출력도 같은 방식으로 함께 바뀌어야 하는 경우입니다. 바람의 방향을 돌리면 예측된 흐름도 함께 돌아가야 합니다. 사물을 정확히 판별해야 하는 인공지능에게 이 차이는 매우 중요합니다. 어떤 문제에서는 입력이 변해도 답이 같아야 하고, 어떤 문제에서는 입력이 변한 만큼 답도 질서 있게 변해야 합니다. 철학 용어로 말하면 대칭성과 보존 법칙은 본질과 우연을 구분하는 감각입니다. 사람의 옷차림은 바뀔 수 있지만, 그 사람을 알아보게 하는 특징은 남습니다. 소설 속 사건의 장소는 달라질 수 있지만, 갈등의 구조는 남을 수 있습니다. 시의 단어는 번역되면서 바뀌지만, 리듬과 정서와 중심 이미지는 남을 수 있습니다. 과학의 세계에서 보자면 자연을 이해한다는 것은 모든 표면을 그대로 외우는 일이 아닙니다. 위치가 바뀌고, 방향이 바뀌고, 시간이 흘러도 남는 구조를 찾는 일입니다. 인공지능도 마찬가지라서 대칭성과 보존 법칙은 AI가 자연을 더 제대로 읽기 위해 배워야 하는 기본 감각입니다. 바뀌어도 남는 것을 알아보는 능력, 변할 때 함께 변해야 하는 것을 질서 있게 따라가는 능력, 그리고 그 속에서 보존되는 구조를 놓치지 않는 능력. 이것이 인공지능의 사물 변별력을 갈수록 뛰어나게 만들어주고 있습니다. 그리고 이 능력은 머지 않아 로봇과 같은 피지컬 AI의 폭발적 성장을 예고하는 하나의 이유가 되기도 합니다.
3.8 해석 가능성과 블랙박스 문제
아들이 깊은 산속에서 캐낸 약초 뿌리를 달여먹고 어머니의 병이 나았다고 해봅시다. 경험적으로는 효험이 입증된 셈입니다. 하지만 현대 과학은 효험 그 자체에 멈추지 않고 묻습니다. "어떤 성분이 관여했는가? 부작용은 없는가? 체질이 다른 이에게는 치명적이지 않은가?" 이 질문을 통과하지 못한 지식은 결국 미신이나 맹신으로 전락할 위험을 품고 있습니다. 인공지능의 영역에서도 이와 같은 문제가 생길 수 있습니다. 어떤 AI 모델은 놀라울 만큼 정확한 답을 냅니다. 의료 영상을 보고 병변을 찾아내고, 기상 데이터를 보고 폭우 가능성을 예측하고, 재료 데이터를 보고 새로운 물질 후보를 추천합니다. 겉으로 보면 대단히 유능합니다. 하지만 우리는 곧 묻게 됩니다.
왜 그런 답을 냈는가? 어떤 근거를 중요하게 보았는가? 어떤 조건에서 틀릴 수 있는가? 그 판단은 자연의 법칙과 맞는가?
모델이 정확한 답을 냈더라도 그 이유를 알기 어렵다면, 우리는 그 모델을 블랙박스(Black Box)라고 부릅니다. 블랙박스란 입력과 출력은 보이지만, 그 안에서 어떤 판단 과정이 일어나는지 잘 보이지 않는 장치를 뜻합니다. 일상적인 서비스에서는 블랙박스가 별 문제되지 않습니다. 음악 앱이 내가 좋아할 만한 노래를 추천했는데 왜 그 노래를 골랐는지 정확히 설명할 필요는 없습니다. 쇼핑몰이 상품을 추천할 때도 마찬가지입니다. 그러나 과학, 의료, 기후, 안전 문제라면 이야기가 달라집니다. 의료 AI가 “이 환자는 위험하다”고 말한다면 의사는 그 이유를 알고 싶어 합니다. 기후 AI가 “이 지역에 홍수 위험이 크다”고 말한다면 행정가는 어떤 조건 때문에 그런 예측이 나왔는지 알아야 합니다. 항공기나 원자로, 교량과 관련된 AI가 어떤 경고를 낸다면, 그 경고가 단순한 우연한 패턴인지 물리적으로 타당한 판단인지 확인해야 합니다. 이 질문들에 답하지 못하는 인공지능 모델은 답답함을 넘어 위험한 블랙박스라고 부를 수도 있습니다. 이때 물리 법칙을 넣은 인공지능 즉 물리정보 신경망(PINN)은 이 시커먼 블랙박스에 작은 창을 내 문제를 줄여 줄 수 있습니다. 기계의 뇌 속을 100% 투명하게 들여다볼 수는 없어도, 적어도 기계가 내린 진단이 "에너지 보존의 룰을 심각하게 위반하지 않았는지", "열역학적 방향성을 잃지 않았는지" 정도는 명확하게 검증할 수 있기 때문입니다. 가령 AI 모델이 어떤 방의 온도 분포를 예측했는데, 열이 아무 이유 없이 차가운 곳에서 뜨거운 곳으로 저절로 몰려가는 모양을 보여준다면 의심해야 합니다. 이때 물리정보 신경망이 개입해 열의 흐름, 경계조건, 에너지 출입을 함께 확인하면 모델의 예측을 더 신중하게 평가할 수 있습니다. 이것은 해당 AI 모델 내부를 완전히 들여다볼 수 있다는 뜻은 아닙니다. 하지만 최소한 “이 모델은 에너지 보존을 심하게 어기지 않는지” 여부를 검사할 수 있습니다. 이때 물리학은 AI의 답을 검사하는 언어가 됩니다. 모델이 어떤 숫자를 내놓았는지만 보는 것이 아니라, 그 숫자가 자연의 규칙을 반영하여 나온 것인지 묻는 것입니다.
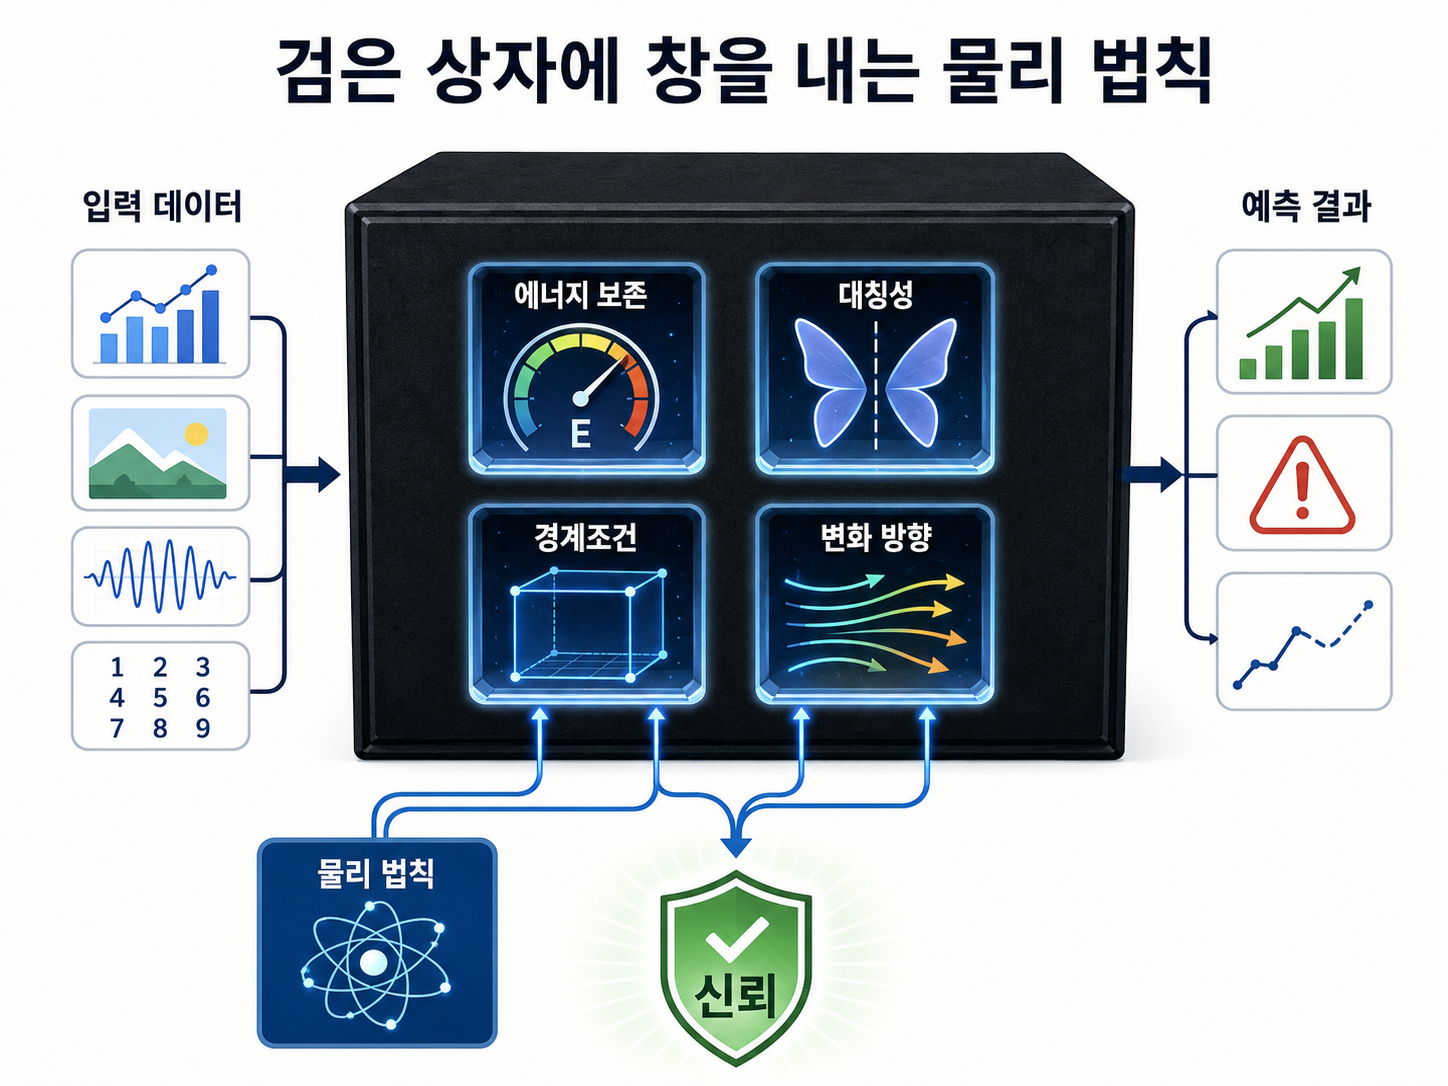
물리 법칙은 AI의 닫힌 상자에 창을 내어, 우리가 AI의 답을 조금 더 안심하고 판단하게 해 줍니다.
특정 AI 모델의 블랙박스에 제대로 된 창을 낸 인공지능, 즉 물리정보 신경망은 다음 네 가지를 검토합니다.
첫째, 정확도입니다. 모델이 실제 데이터와 얼마나 잘 맞는가를 봅니다. 둘째, 해석 가능성입니다. 모델이 왜 그런 답을 냈는지 어느 정도 설명할 수 있는가를 봅니다. 셋째, 물리 일관성입니다. 모델의 답이 에너지 보존, 대칭성, 경계조건, 변화의 방향 같은 자연의 기본 질서를 크게 어기지 않는가를 봅니다. 넷째, 계산 효율입니다. 아무리 좋은 모델이라도 계산 비용이 지나치게 크거나 실제 현장에서 쓸 수 없다면 한계가 있습니다.
이 네 가지는 항상 함께 가야 합니다. 정확하지만 설명할 수 없는 모델은 불안합니다. 설명은 그럴듯하지만 정확하지 않은 모델은 쓸모가 약합니다. 물리 법칙은 지키지만 실제 데이터와 맞지 않는 모델도 곤란합니다. 계산은 훌륭하지만 너무 느려서 재난 현장에 쓸 수 없다면 실용성이 떨어집니다. ‘맞는 말’과 ‘근거를 갖춘 말’이 다르고, 좋은 비평가가 작품의 문장과 구조를 근거로 해석하듯, 좋은 AI 모델은 결과뿐 아니라 그 결과가 성립하는 원리와 조건을 반영할 수 있어야 합니다. 그렇지 않은 AI 모델에 대해서는 불가피하게 블랙박스의 창을 내는 물리정보 신경망의 개입이 필요합니다.
3.9 물리정보 신경망의 실패 양상
베토벤의 위대한 악보가 주어졌다고 해서 누구나 훌륭한 교향곡을 연주해 낼 수 있는 것은 아닙니다. 음표가 빠르게 바뀌고, 악기들이 서로 다른 박자를 타고, 공연장의 울림까지 복잡하면 아무리 훌륭한 연주자라도 흔들릴 수 있습니다. 악보가 있다는 사실과 그 악보를 실제 무대에서 잘 연주하는 일이 다르듯, 물리 정보 신경망을 갖춘 인공지능이라고 해서 항상 훌륭한 답을 내놓는 것은 아닙니다. 그 이유를 다음과 같이 나누어 볼 수 있습니다.
첫째 강직한 문제(Stiff problem)입니다. 잔잔하던 강물이 협곡에서 요동치듯, 물리계가 갑작스럽게 폭주하거나 스케일이 급변할 때 신경망은 종종 그 속도를 따라가지 못하고 붕괴합니다. 말 그대로 지나치게 많은 변수를 동반하는 뻣뻣한 문제입니다. 조금만 잘못 움직여도 해가 크게 흔들리고, 어떤 부분은 아주 작은 시간 간격으로 조심스럽게 계산해야 합니다. 인공지능이 평평한 길을 걷다가 갑자기 얼음판과 급경사가 번갈아 나오는 길을 만난 것과 같습니다. 규칙은 알고 있지만 발걸음을 맞추기가 어려운 것입니다.
둘째 복잡한 경계조건입니다. 경계조건이란 “여기서는 이렇게 되어야 한다”는 가장자리의 규칙입니다. 방 안의 온도를 예측한다면 벽, 창문, 문틈, 히터의 위치가 모두 경계조건이 됩니다. 강물의 흐름을 예측한다면 강둑, 바닥의 모양, 유입되는 물과 빠져나가는 물의 조건이 경계조건입니다. 교과서에 나오는 문제는 경계가 깔끔합니다. 막대의 양끝 온도가 정해져 있다거나, 상자가 반듯하다거나, 물체의 표면이 단순합니다. 그러나 실제 세계는 그렇지 않습니다. 벽은 울퉁불퉁하고, 재료는 균일하지 않으며, 바람은 옆에서 불고, 물은 틈으로 새고, 온도는 시간에 따라 바뀝니다. 경계가 복잡하면 법칙을 넣으려 해도 그 법칙이 어디에서 어떤 조건으로 적용되는지 정하기 어려워집니다.
세 번째는 스케일 차이입니다. 현실의 물리 세계에는 크고 작은 변화가 뒤섞여 있습니다. 기후를 떠올려 봅시다. 대륙 규모의 바람도 중요하지만, 도시의 열섬이나 산비탈의 국지적 바람도 중요할 수 있습니다. 생명과학에서는 단백질 하나의 원자 배열도 중요하지만, 세포 전체의 환경도 중요합니다. 큰 흐름과 작은 변화가 동시에 얽혀 있습니다. 이것은 합창단에서 아주 큰 북소리와 아주 작은 피콜로 소리를 동시에 듣는 일과 비슷합니다. 북소리만 들으면 작은 선율을 놓치고, 작은 선율만 들으려 하면 전체 리듬을 잃을 수 있습니다. 이처럼 여러 물리량이 극단적인 격차를 보일 때 인공지능은 그 사이에서 균형을 잡기 어려워 집니다.
네 번째는 손실함수의 딜레마입니다. 데이터(현실의 흔적)와 물리 법칙(이상적 질서) 사이에서 누구의 손을 더 들어줄 것인가? 잡음 낀 현실과 너무 깨끗한 이데아 사이에서 갈팡질팡하다 모델이 길을 잃기도 합니다.
인공지능은 보통 데이터와 물리 법칙 사이에서 균형을 잡으려 합니다. 그런데 이 둘 사이의 균형이 쉽지 않습니다. 데이터에 너무 강하게 맞추면 모델은 실제 관측값은 잘 따라가지만 물리 법칙을 어길 수 있습니다. 반대로 물리 법칙을 너무 강하게 따르게 하면 방정식에는 그럴듯하게 맞지만 실제 관측 데이터와 멀어질 수 있습니다. 교사가 학생들의 답안지를 받아 채점하는 경우를 생각해 봅시다. 어떤 학생은 답은 맞혔지만 풀이 과정이 엉망입니다. 또 다른 학생은 풀이 원리는 매우 정갈하지만 마지막 답이 실제 문제와 맞지 않습니다. 좋은 답안은 결과와 풀이가 함께 맞아야 합니다. 인공지능도 마찬가지입니다. 데이터와 법칙 사이에서 어느 한쪽으로 기울면 좋은 모델이 되기 어렵습니다.
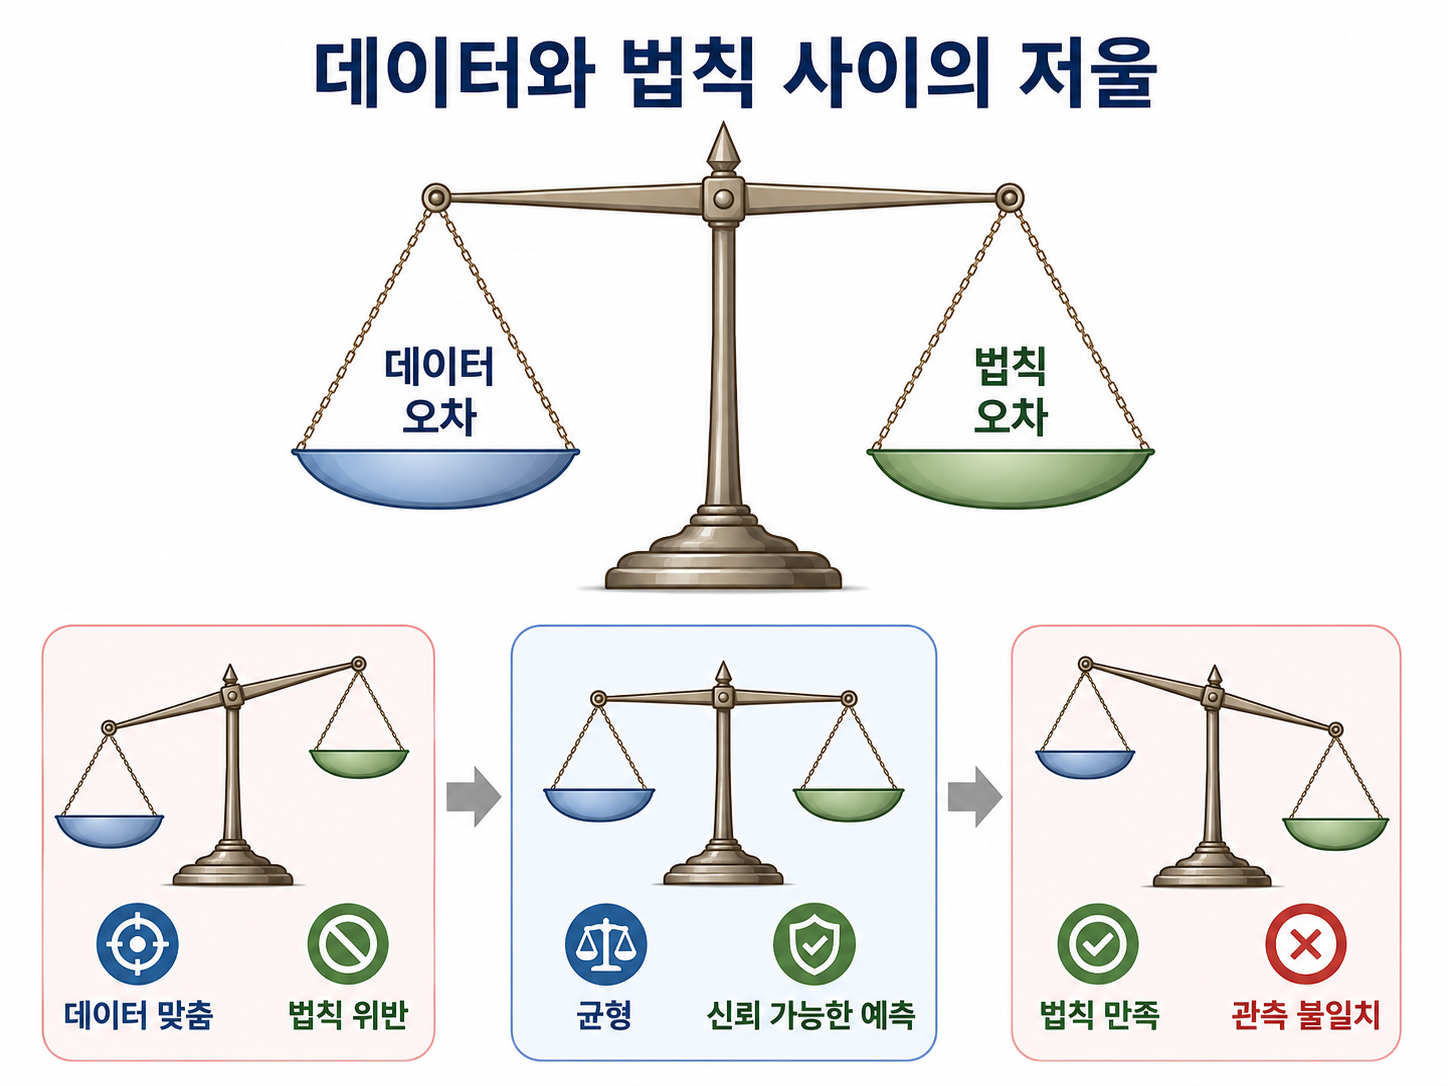
PINN은 교과서 문제보다 훨씬 복잡한 실제 세계를 다루므로, 관측 데이터에 잘 맞는 것과 물리 법칙을 잘 지키는 것 사이의 균형을 맞춤으로써 믿을 만한 예측에 도달합니다.
이들 균형 문제는 생각보다 심각할 수 있습니다. 실제 세계의 데이터에는 잡음이 있습니다. 측정 장비의 오차가 있고, 실험 환경의 흔들림이 있으며, 우리가 모르는 외부 요인이 들어올 수 있습니다. 반면 물리 법칙은 이상화된 형태로 주어질 때가 많습니다. 마찰이 없다고 가정하거나, 재료가 균일하다고 가정하거나, 경계가 단순하다고 가정합니다. 현실의 데이터는 지저분하고, 법칙은 깨끗합니다. 이는 자연을 모델 삼아 물리정보 신경망을 만드는 일이 얼마나 어려운지를 보여줍니다. 데이터도 완전하지 않고, 법칙도 현실 전체를 그대로 담지는 못합니다. 모델은 그 사이에서 계속 균형을 찾아야 합니다. 여기서 우리는 중요한 시사점을 얻습니다. 어떤 인공지능 모델도 실패할 수 있으며, 그럴 경우 자신의 실패를 숨기지 않아야 합니다. 오히려 어디서 잘 작동하고, 어디서 흔들리며, 어떤 조건에서 믿기 어려운지를 분명히 말해야 합니다. 무조건 정답만을 내놓는 척하는 모델보다, "이 경계에서는 확신할 수 없다", "여기서부터는 물리적 일관성이 무너지고 있다"고 자신의 한계를 명확히 선언하는 모델이 인간에게 훨씬 더 안전하고 믿을 만한 도구가 됩니다. 게다가 실패 양상을 분석하면 모델이 놓친 것과 데이터·법칙의 조율 방법을 배울 수 있습니다. 실패를 정직하게 드러내는 일이 인공지능 자신을 더 성숙하게 만듭니다.
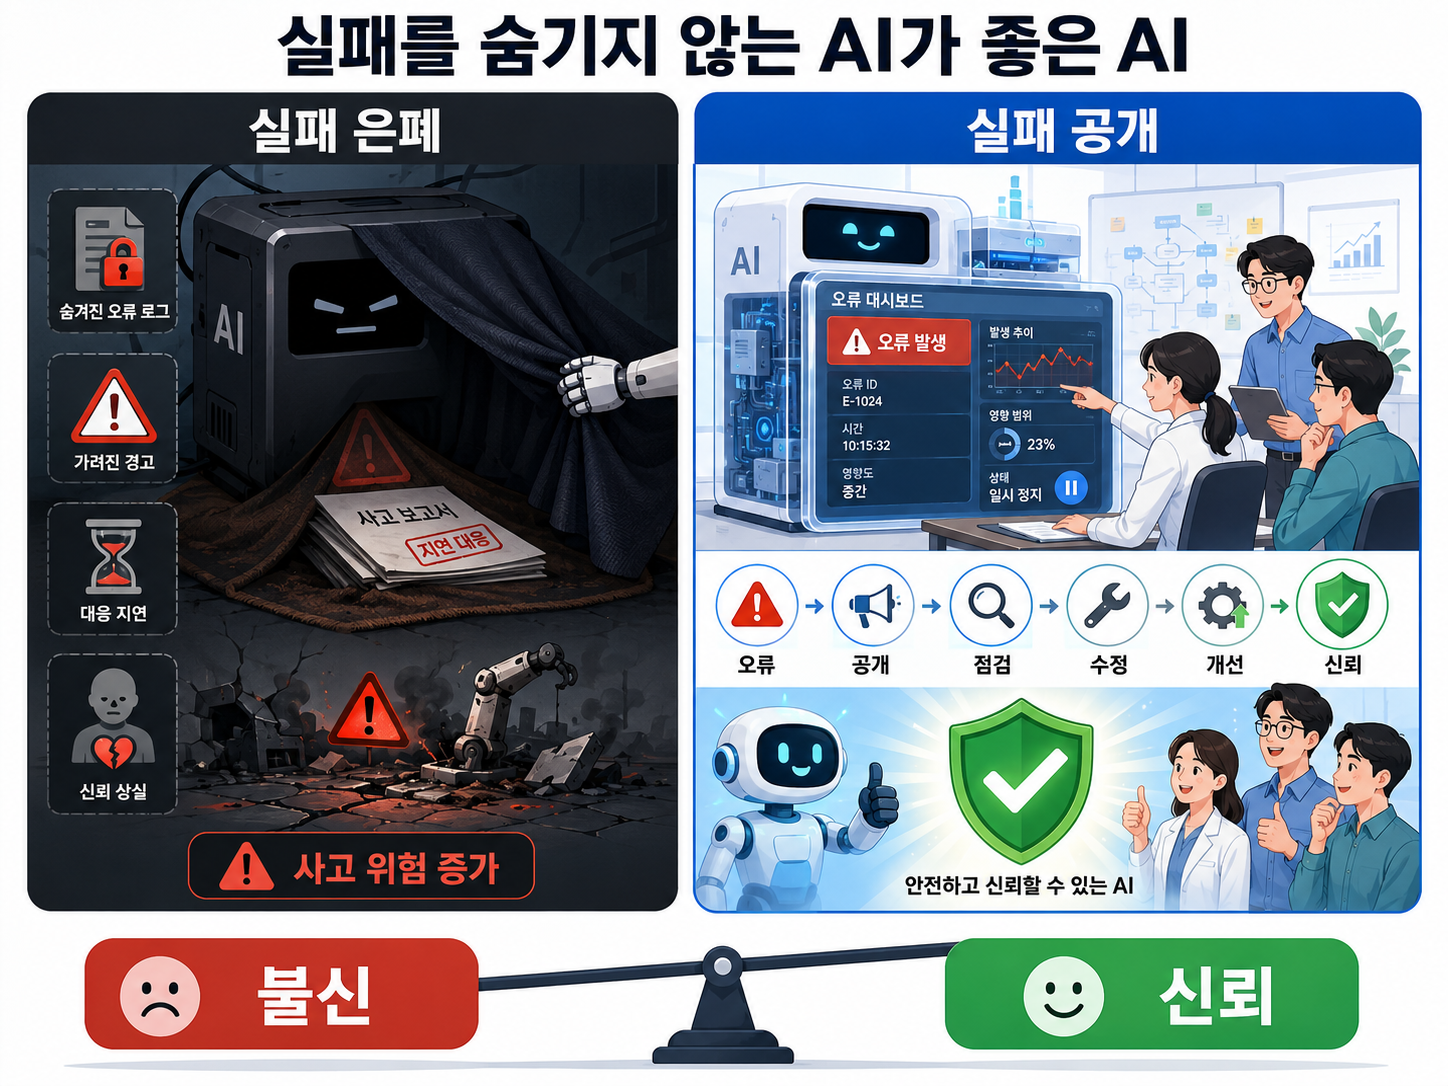
좋은 AI는 실패하지 않는 척하는 시스템이 아니라, 실패를 감지하고 드러내며 인간이 원인을 고쳐 더 안전하게 만들 수 있게 하는 시스템입니다.
과학은 오랫동안 이론, 실험과 관측, 시뮬레이션이라는 세 가지 방법을 함께 사용해 왔습니다. 이론은 자연현상의 관계를 방정식으로 정리하고, 실험과 관측은 그것이 실제 세계에서 성립하는지 확인하며, 시뮬레이션은 직접 보기 어려운 조건을 계산으로 탐색합니다. 물리정보 신경망은 이 세 가지 방법을 AI 안에서 함께 활용하려는 시도입니다. 관측 자료에서 패턴을 읽되, 물리 법칙을 담은 방정식을 학습 과정의 제약으로 넣고, 그 결과를 실험 자료나 시뮬레이션과 비교해 예측을 조정합니다. 따라서 물리정보 신경망은 이론을 대신하는 기술이 아니라, 이론·관측·계산을 하나의 학습 과정으로 연결해 과학의 탐색 속도와 범위를 넓히는 도구라고 할 수 있습니다.
3.10 인문학적 해석: 예측과 이해, 경험과 법칙
평생 바다를 일궈온 노련한 어부가 젖은 바람 냄새만으로 폭풍우를 예감합니다. 이 '법칙 없는 직관적 예측'은 결코 가벼운 것이 아닙니다. 수십 년의 빅데이터가 직관의 형태로 뭉축된 숭고한 경험입니다. 하지만 바다의 지형이 갑자기 뒤틀리거나 이상 기후가 덮치면, 경험이라는 과거의 닻은 가장 먼저 끊어지고 맙니다. 이 3강이 여러분에게 전하고자 하는 핵심은 바로 예측과 이해, 경험과 법칙의 차이입니다. 인공지능이 과거의 데이터만으로 뱉어내는 예측은 어부의 직관과 같습니다. 익숙한 바다에서는 유능하지만 낯선 세계 앞에서는 속수무책입니다. 반면, 물리 법칙을 체득한 인공지능은 "바람의 방향과 수온의 차이가 이런 에너지의 흐름을 만들어내기 때문에 폭풍우가 올 수밖에 없다"고 설명할 줄 압니다. 기계의 속도에 자연의 느릿하지만 단단한 문법인 물리 법칙을 결합하는 일. 그것은 단순히 모델의 숫자를 소수점 아래로 몇 자리 더 맞히기 위한 기술적 고집이 아닙니다. 그것은 미지의 세계 앞에서도 결코 흔들리지 않을 '설명 가능한 지능'을 구축하기 위한, 보다 인간적인 인공지능을 향한 노력의 일환입니다.
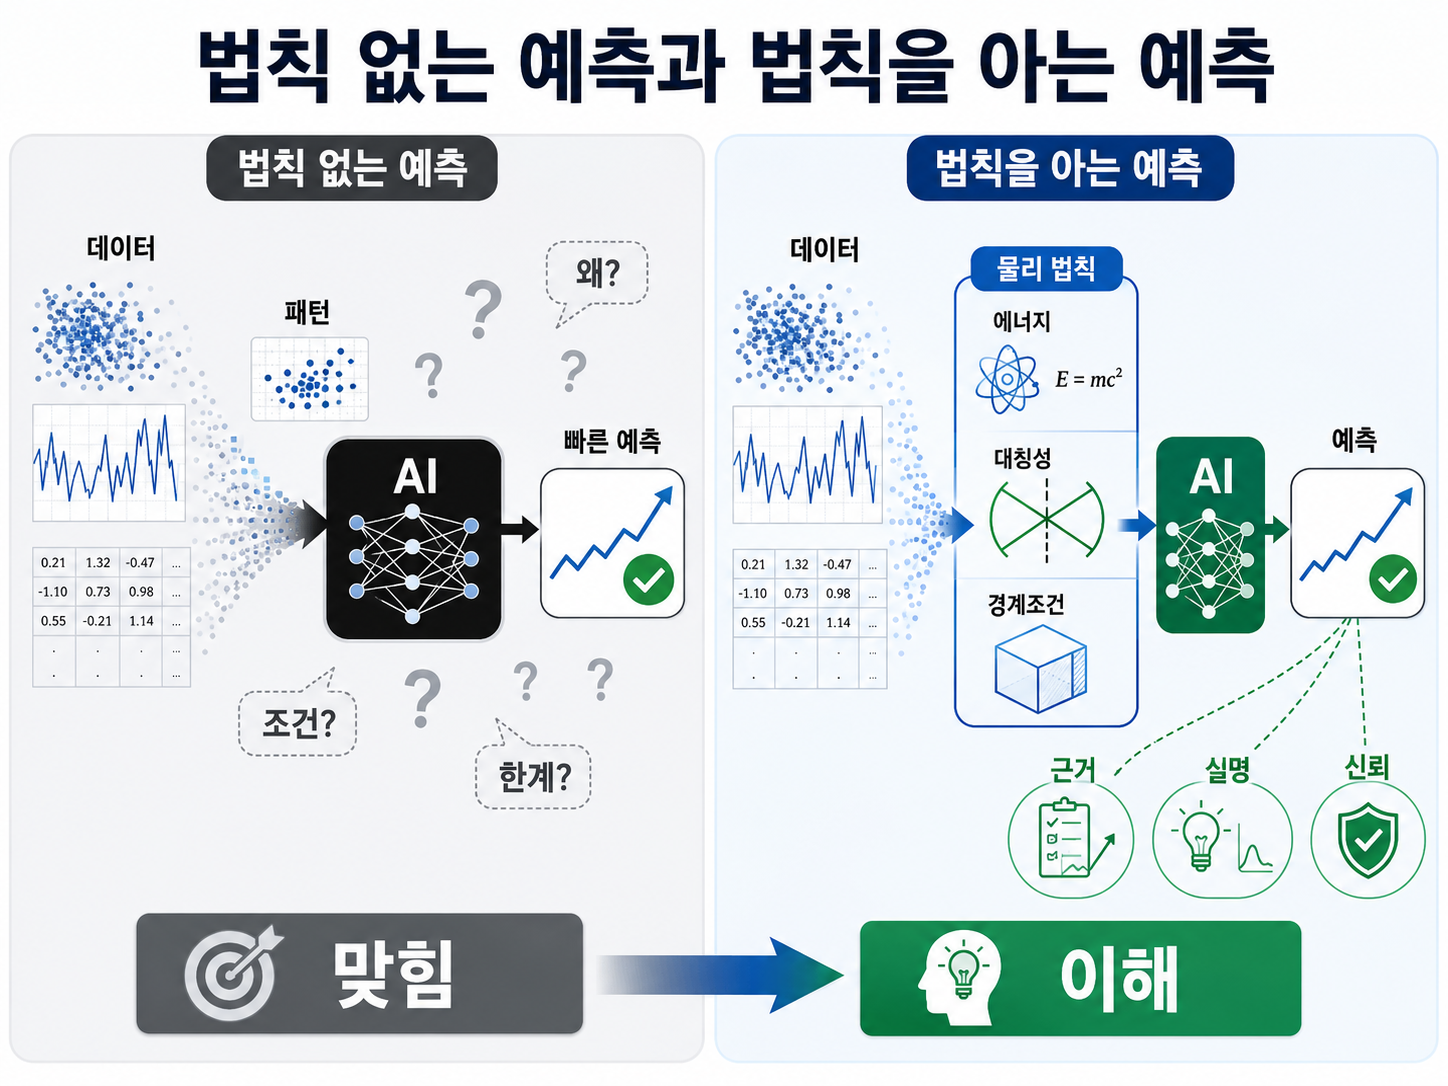
AI가 신뢰를 얻으려면 정확한 예측에서 멈추지 않고, 법칙과 검증을 통해 이해 가능한 설명으로 건너가야 합니다.
제4강. 생명 설계를 향한 ‘접힘’
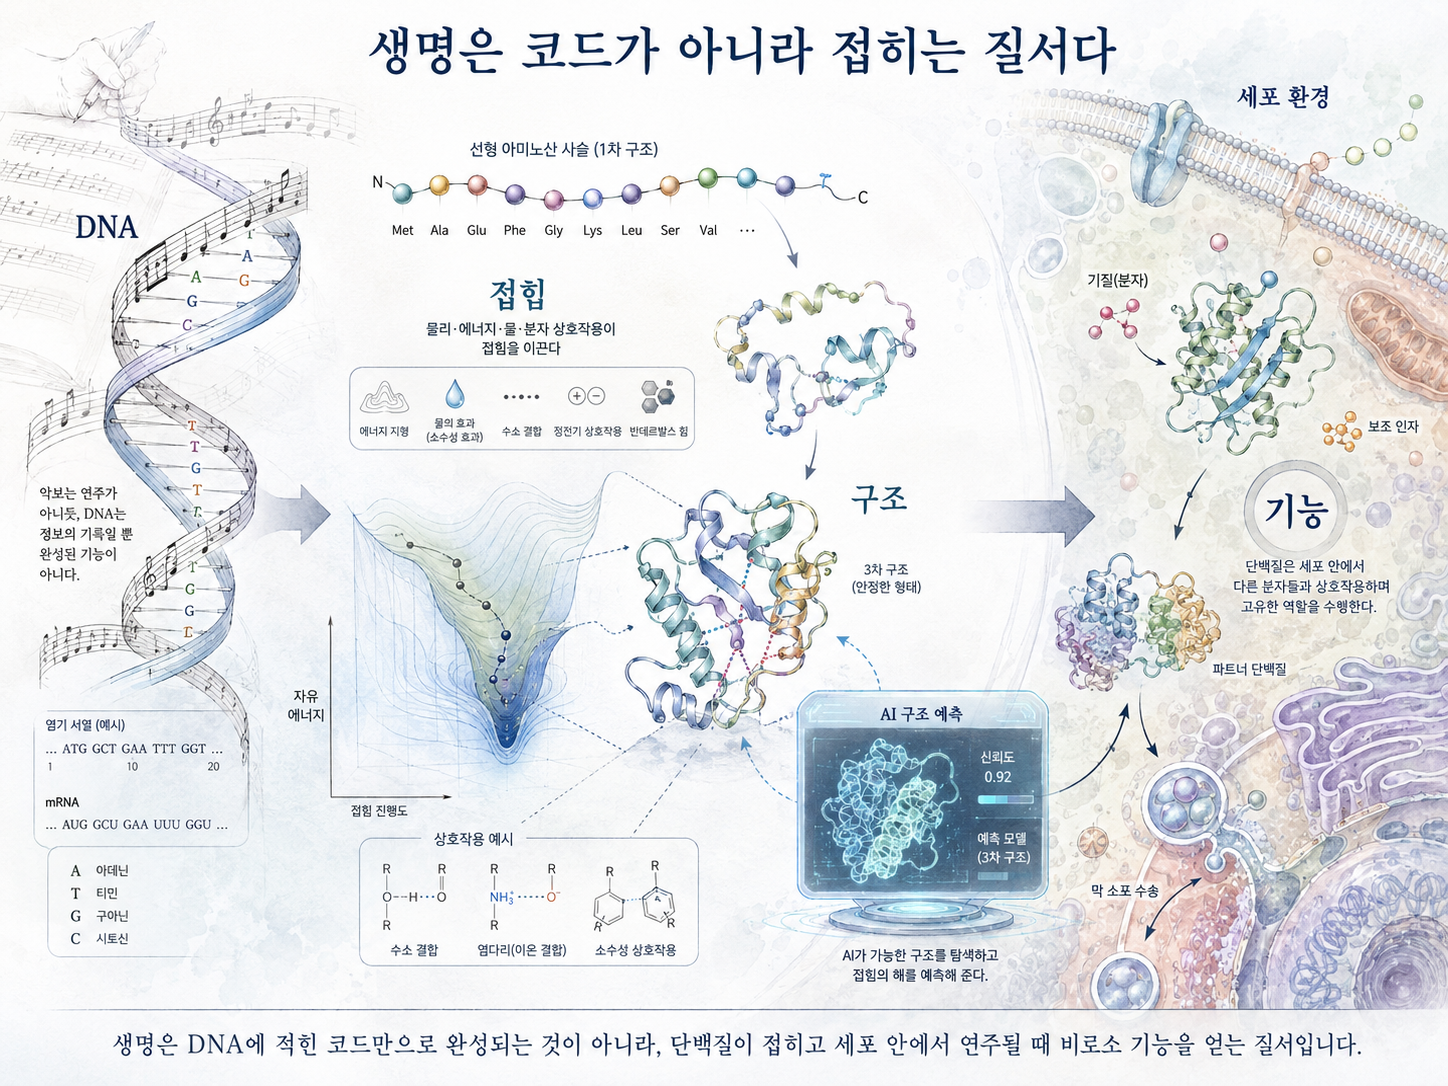
한 장의 천은 어떻게 접고 묶느냐에 따라 보자기가 되기도 하고 옷이 되기도 합니다. 종이 한 장도 접는 순서와 방향에 따라 학이나 배처럼 전혀 다른 형태를 얻습니다. 완성된 모양은 한순간에 나타난 것처럼 보이지만, 실제로는 앞선 접힘 하나하나가 다음 가능성을 좁혀 온 결과입니다. 단백질도 이와 비슷합니다. 단백질은 아미노산이 길게 연결된 사슬로 만들어지지만, 사슬 상태로는 대부분의 기능을 수행할 수 없습니다. 물속에서 여러 물리적 힘의 영향을 받아 특정한 입체 구조를 이루어야 효소와 항체, 수용체와 운반체로 작동할 수 있습니다. 단백질은 흔히 생명의 나노 기계라고 불립니다. 그러나 금속 부품을 깎아 조립한 기계와는 다릅니다. 아미노산의 배열에 담긴 가능성이 물과 이온, 온도와 산성도, 주변 분자와의 상호작용 속에서 하나의 구조로 구현됩니다. 생명의 정보가 물질의 형태를 얻는 순간입니다.
단백질 접힘은 생물학과 물리학이 만나는 오래된 난제였습니다. 아미노산 서열만 보고 완성된 입체 구조를 예측하기가 매우 어려웠기 때문입니다. 알파폴드의 등장은 이 문제에서 커다란 진전을 이루며, 인공지능이 생명과학의 탐구 방식을 어떻게 바꿀 수 있는지를 보여 주었습니다. 그러나 구조를 예측했다는 말이 생명을 모두 해독했다는 뜻은 아닙니다. 단백질은 몸속에서 끊임없이 흔들리고 다른 분자와 만나며, 세포의 장소와 시간에 따라 서로 다른 기능을 수행합니다. 생명은 고정된 DNA 설계도를 완성하는 일이 아니라 유전 정보가 물질과 환경 속에서 계속 실행되는 과정입니다.
4.1 생명은 정보인가, 물질인가
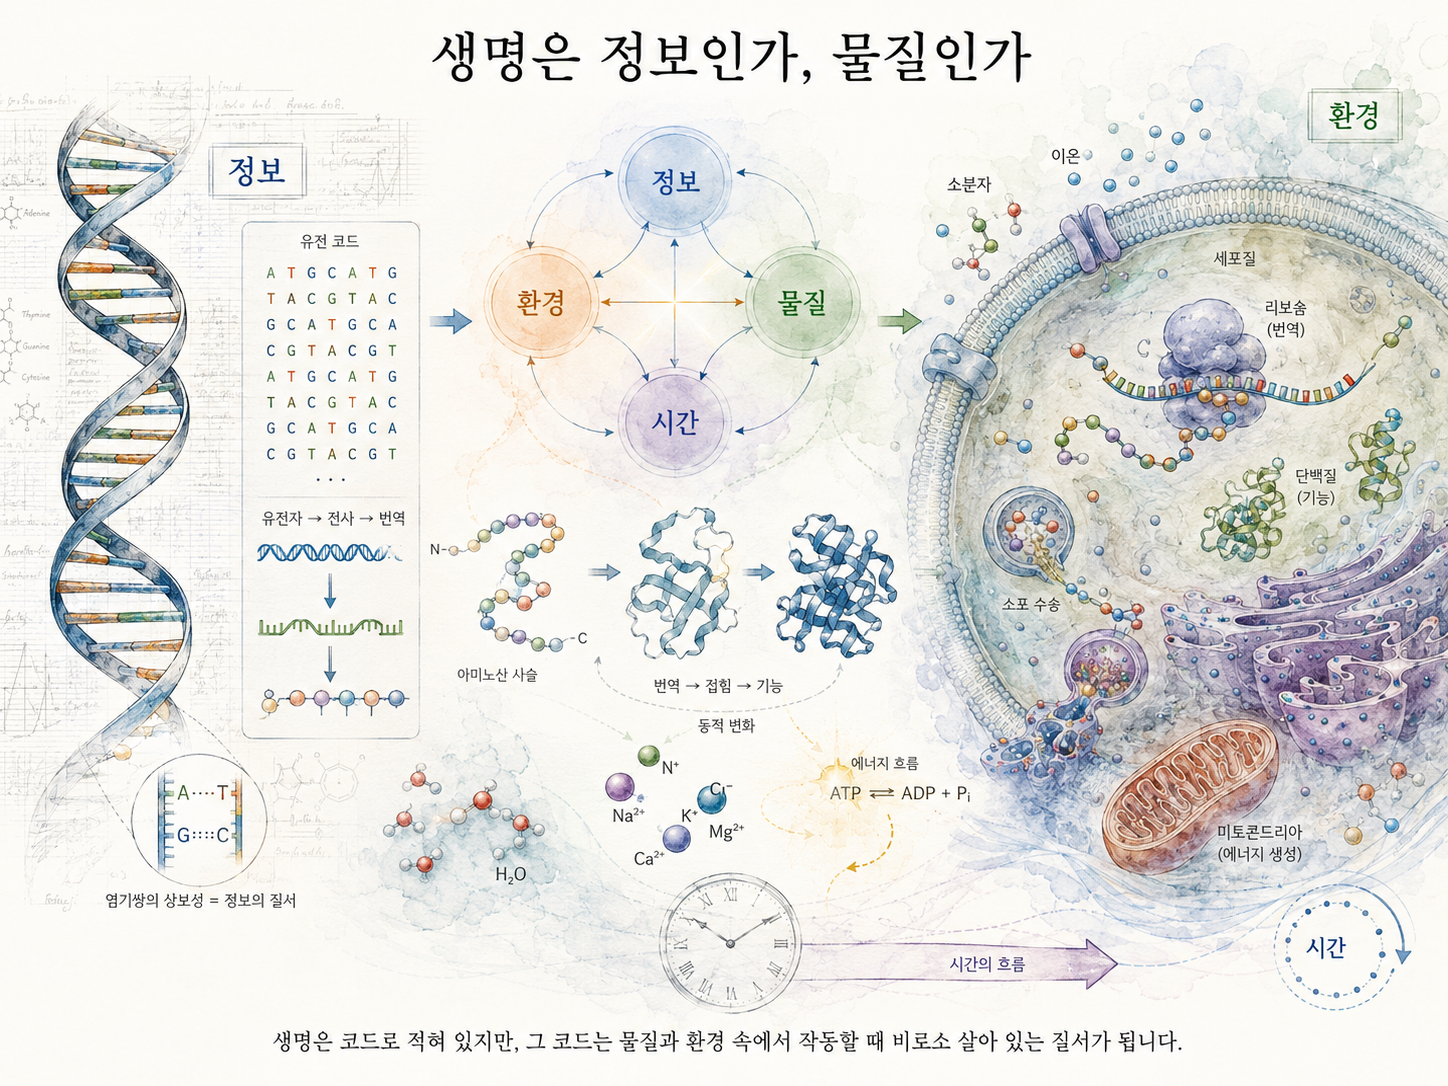
교향곡의 악보에는 음의 높이와 길이, 연주의 순서가 기록되어 있습니다. 그러나 악보 자체에서는 음악이 울리지 않습니다. 연주자의 움직임과 악기의 떨림, 공연장의 공명이 만나야 비로소 음악이라는 사건이 일어납니다. 생명도 이와 비슷합니다. 세포 생명체는 DNA에 유전정보를 저장하지만, DNA만으로 살아 움직이지는 않습니다. 세포 안에는 물과 이온, 막과 단백질, 당과 지질을 비롯한 수많은 물질이 있으며, 에너지와 물질이 끊임없이 드나듭니다. 온도와 산성도, 산소 농도와 주변 분자의 상태도 생명 활동에 영향을 줍니다. DNA를 생명의 설계도라고 부르기도 하지만, 설계도가 곧 건물은 아닙니다. 건물을 세우려면 재료와 에너지, 작업 순서와 현장 조건이 필요합니다. 세포는 유전정보가 실제 구조와 기능으로 구현되는 현장입니다. DNA의 정보는 RNA로 옮겨지고, 리보솜에서 아미노산 사슬로 번역됩니다. 새로 만들어진 단백질은 접히고 이동하며, 필요한 경우 화학적 변형을 거친 뒤 다른 분자들과 상호작용합니다. 이 여러 단계가 맞물려야 하나의 생물학적 기능이 나타납니다.
이러한 특성 때문에 생명은 AI가 다루기 좋은 대상이면서도 어려운 대상입니다. DNA는 A·T·G·C 네 염기의 배열로, 단백질은 스무 종류 아미노산의 배열로 표현할 수 있습니다. 서열은 문자처럼 기록되므로 컴퓨터가 저장하고 비교하기에 알맞습니다. 생명 AI가 빠르게 발전한 까닭도 여기에 있습니다. AI는 방대한 유전체와 단백질 서열을 비교해 사람이 놓치기 쉬운 규칙과 연관성을 찾아냅니다. 어떤 서열이 비슷한 기능을 갖는지, 어떤 변이가 질병과 관련되는지, 아미노산 배열이 어떤 구조로 이어질 가능성이 큰지 예측할 수 있습니다. 그러나 생명은 문자에서 멈추지 않습니다. 같은 단백질도 온도와 산성도, 세포 안의 위치와 주변 분자에 따라 안정성과 기능이 달라질 수 있습니다. 단백질은 접히고 흔들리며, 다른 분자와 결합했다가 떨어집니다. 만들어지는 속도와 분해되는 시점 역시 기능의 일부입니다.
AI가 학습하는 것은 데이터에 기록된 생명입니다. 실제 몸속에서 순간마다 일어나는 변화와 개인의 생활환경, 면역 상태와 질병의 역사까지 모두 담겨 있는 것은 아닙니다. 데이터는 생명을 비추는 강력한 창이지만 생명 전체와 같지는 않습니다. 한 사람을 주민등록번호나 유전자 정보만으로 설명할 수 없듯이, 생명도 코드만으로 설명할 수 없습니다. 정보는 생명의 방향을 제시하지만, 살아 있음은 그 정보가 물질과 에너지, 환경과 시간 속에서 실행되는 과정입니다. 따라서 생명은 정보와 물질 가운데 하나를 선택해야 하는 대상이 아닙니다. 생명은 정보가 물질을 만나 구조와 기능으로 구현되는 과정입니다. 단백질 접힘은 그 만남을 가장 선명하게 보여 주는 장면입니다.
4.2 단백질은 왜 접히는가
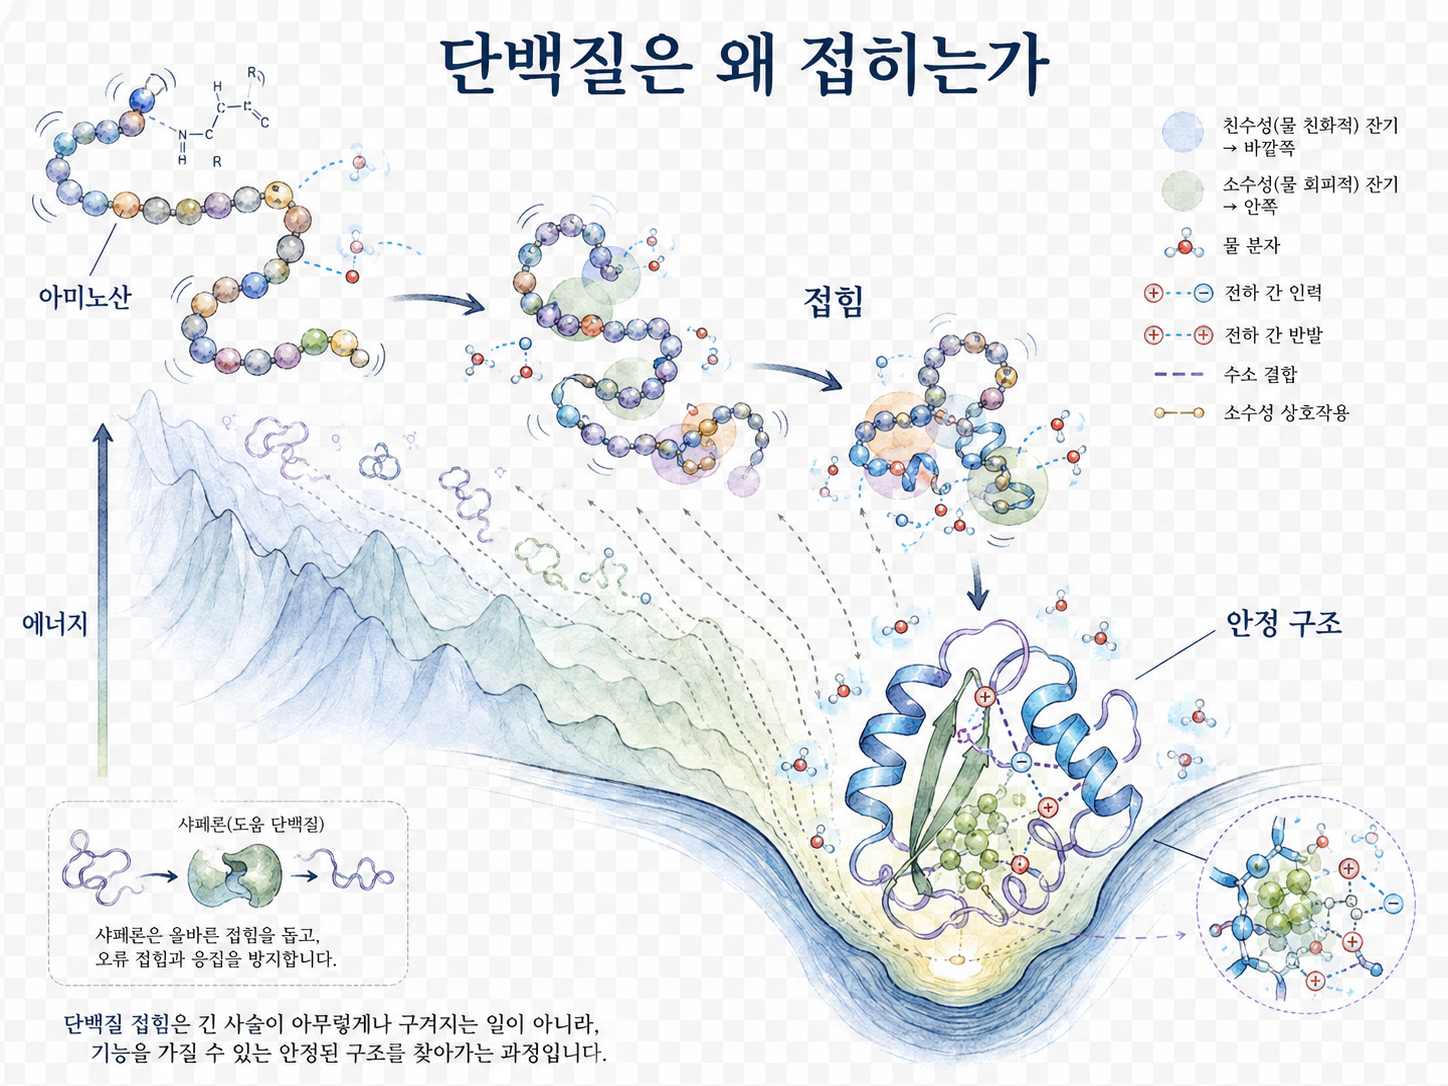
단백질은 아미노산이 줄지어 연결된 사슬에서 시작합니다. 그러나 이 사슬은 물속에서 가만히 떠 있지 않습니다. 아미노산의 서로 다른 화학적 성질 때문에 끌리고 밀리며, 휘어지고 회전해 특정한 입체 구조를 형성합니다. 이 과정이 단백질 접힘입니다. 많은 수용성 단백질에서는 물을 피하려는 부분이 안쪽으로 모이고, 물과 잘 어울리는 부분이 바깥쪽을 향하는 경향이 있습니다. 전하를 띤 부분은 서로 끌어당기거나 밀어내며, 수소결합과 반데르발스 힘도 구조를 안정시키는 데 기여합니다. 결합각과 원자 사이의 거리에도 제약이 있으므로 모든 모양이 똑같이 가능한 것은 아닙니다. 단백질은 이러한 상호작용이 함께 작용하는 가운데, 주어진 환경에서 자유에너지가 비교적 낮은 구조를 향해 나아갑니다. 다만 하나의 길만을 따라 접히는 것은 아닙니다. 여러 중간 상태와 경로를 거쳐 비슷한 최종 구조에 도달할 수 있습니다. 이 과정은 에너지 지형에 놓인 공으로 비유할 수 있습니다. 공은 산과 골짜기가 뒤섞인 지형에서 경사를 따라 낮은 쪽으로 움직입니다. 중간의 작은 웅덩이에 잠시 머물기도 하지만, 조건이 맞으면 더 깊고 안정된 골짜기에 도달합니다. 단백질이 취할 수 있는 수많은 형태는 이처럼 높낮이가 다른 에너지 지형을 이룹니다.
가능한 구조를 하나씩 무작정 시험한다면 단백질은 생명 활동에 필요한 시간 안에 접힐 수 없습니다. 실제 단백질은 모든 경우를 동등하게 탐색하지 않습니다. 아미노산 사이의 물리적 상호작용이 가능한 경로를 크게 제한하기 때문에 비교적 빠르게 특정한 구조에 도달할 수 있습니다. 세포 안의 접힘은 시험관보다 더 복잡합니다. 새로 만들어진 단백질은 주변 분자와 충돌하고, 접히는 도중 다른 사슬과 엉겨 붙을 수도 있습니다. 이때 분자 샤페론이라 불리는 단백질들이 잘못된 상호작용과 응집을 줄이고, 접힘이 진행될 수 있는 환경을 마련합니다. 일부 샤페론은 에너지를 사용해 잘못 접힌 단백질이 다시 접힐 기회를 주기도 합니다. 아미노산 서열과 구조의 관계를 밝히는 데 중요한 역할을 한 과학자는 크리스천 B. 안핀센입니다. 그는 리보뉴클레이스 A라는 단백질을 변성시켰다가 적절한 조건으로 되돌렸을 때, 원래 구조와 기능이 회복될 수 있음을 보였습니다. 이 결과는 작은 단백질의 고유한 구조를 이루는 데 필요한 핵심 정보가 아미노산 서열에 들어 있다는 생각을 뒷받침했습니다.
그러나 이 원리를 모든 단백질에 단순하게 적용할 수는 없습니다. 세포 안의 접힘은 합성 속도와 주변 분자, 막과 샤페론, 화학적 변형의 영향을 받습니다. 어떤 단백질은 단독으로 안정된 구조를 갖지만, 다른 분자와 결합할 때 비로소 구조가 정돈되는 단백질도 있습니다. 일정한 한 가지 구조에 고정되지 않고 유연한 상태로 기능하는 단백질도 존재합니다. 단백질의 기능에는 안정성과 움직임이 모두 필요합니다. 지나치게 불안정하면 필요한 형태를 유지하지 못하지만, 너무 굳어 있으면 결합 상대를 받아들이거나 환경 변화에 반응하기 어렵습니다. 효소의 일부가 열리고 닫히고, 수용체가 신호를 받으며 형태를 바꾸는 것도 이러한 움직임 덕분입니다. 생명의 구조는 완성된 조각상보다 흔들림 속에서 형태를 유지하는 질서에 가깝습니다. 이 점은 알파폴드를 이해할 때 특히 중요합니다. 알파폴드는 아미노산 서열과 알려진 단백질 자료에서 관계를 학습해, 단백질이 취할 가능성이 큰 입체 구조를 예측합니다. 그러나 단백질이 실제로 어떤 경로를 지나 접히는지, 세포 안에서 시간에 따라 어떻게 움직이는지를 그대로 재현하는 것은 아닙니다.
알파폴드의 예측은 대체로 안정된 구조의 유력한 모습을 보여 주는 정지 화면에 가깝습니다. 생명은 그 정지 화면이 움직이고 변형되며 다른 분자와 만나는 영상입니다. 단백질 접힘은 물리학과 생물학이 만나는 자리입니다. 물리학은 어떤 상호작용이 구조를 안정시키는지 묻고, 생물학은 그 구조가 어떤 기능을 수행하며 생존과 진화에 어떤 영향을 주는지 살핍니다. AI는 두 분야에 축적된 방대한 서열과 구조의 관계를 학습해 가능한 형태를 빠르게 제안합니다. 접힘은 단순한 모양 만들기가 아닙니다. 유전정보가 물질의 구조를 거쳐 생명의 기능으로 바뀌는 과정입니다.
4.3 “구조가 기능을 만든다”
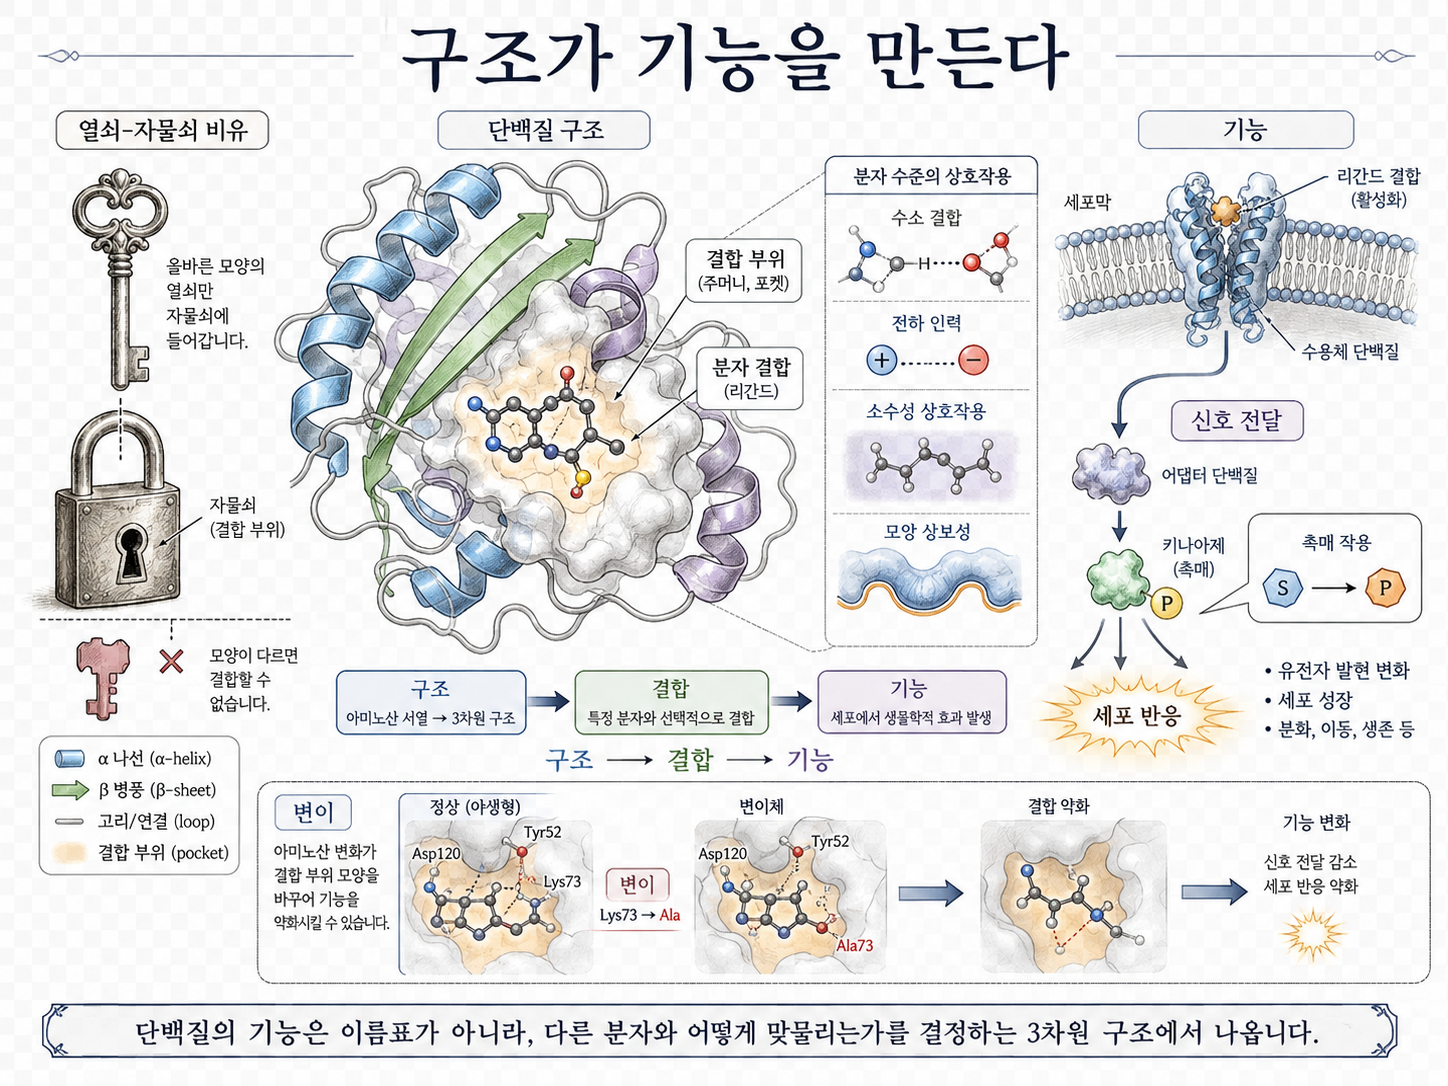
열쇠는 금속으로 만들어지지만 아무 금속 조각이나 문을 열 수는 없습니다. 홈과 돌기의 모양이 자물쇠의 내부 구조와 맞아야 합니다. 단백질 역시 어떤 아미노산으로 이루어졌는지만큼, 그 아미노산들이 어떤 입체 구조와 표면을 만드는지가 중요합니다. 효소는 특정 분자를 붙잡아 화학반응의 장벽을 낮추고, 항체는 외부 물질의 특징을 알아봅니다. 수송 단백질은 물질을 세포 안팎으로 옮기며, 이온 통로는 특정 이온이 지나갈 수 있는 길을 만듭니다. 이러한 기능은 단백질 표면의 홈과 돌기, 전하의 분포와 유연한 움직임에서 나옵니다. 다만 단백질의 결합을 단단한 열쇠와 자물쇠의 관계로만 보면 부족합니다. 많은 단백질은 상대 분자를 만날 때 형태를 조금 바꾸며 더 잘 맞는 구조를 이룹니다. 구조는 고정된 틀이 아니라, 결합과 반응에 따라 조정되는 동적인 형태입니다.
따라서 단백질의 구조를 밝히는 일은 단순히 분자의 외형을 그리는 작업이 아닙니다. 어떤 분자가 어느 부위에 결합할 수 있는지, 특정 아미노산의 변화가 기능을 어떻게 바꿀지, 약물이 어느 지점을 겨냥할 수 있는지 묻는 출발점입니다. 구조와 기능의 관계는 유전 변이에서 특히 선명하게 드러납니다. 문장의 글자 하나가 바뀌어도 뜻이 거의 달라지지 않을 때가 있지만, 때로는 한 글자가 전체 의미를 뒤집습니다. 단백질에서도 아미노산 하나의 변화가 아무 영향 없이 지나갈 수 있는 반면, 구조의 안정성이나 결합 표면을 크게 바꾸기도 합니다. 대표적인 사례가 겸상적혈구병입니다. 헤모글로빈의 아미노산 하나가 바뀌면 단백질 표면의 성질이 달라지고, 산소가 부족한 조건에서 헤모글로빈 분자들이 서로 달라붙기 쉬워집니다. 그 결과 적혈구가 낫처럼 변형되어 혈류를 방해할 수 있습니다. 서열의 작은 변화가 분자 구조와 세포의 형태, 환자의 증상으로 이어지는 것입니다. 질병 연구는 이러한 연결을 추적합니다. 특정 변이가 단백질을 불안정하게 만드는지, 약물이 결합할 자리를 바꾸는지, 다른 분자와의 상호작용을 방해하는지를 살핍니다. 구조를 알면 수많은 변이 가운데 실제 실험으로 먼저 확인할 대상을 더 정밀하게 고를 수 있습니다. AI는 이 탐색의 범위를 크게 넓혔습니다. 실험 구조가 알려지지 않은 단백질에도 가능한 입체 형태를 제시하고, 결합 부위나 기능적으로 중요한 영역을 추정할 수 있습니다. 연구자는 이를 바탕으로 약물 후보와 돌연변이 실험의 우선순위를 정할 수 있습니다.
그러나 AI가 예측한 구조만으로 기능이 확정되는 것은 아닙니다. 단백질은 세포 안의 위치와 농도, 결합 상대와 화학적 변형, 만들어지고 분해되는 시점에 따라 다른 역할을 할 수 있습니다. 예측의 신뢰도가 낮은 영역이나 유연한 부분은 실제로 하나의 고정된 구조를 갖지 않을 수도 있습니다. 서열과 구조, 기능의 관계는 단순한 일방통행이 아닙니다. 아미노산 서열은 구조의 가능성을 정하지만, 환경은 실제 구조와 움직임을 바꿉니다. 구조는 결합과 반응의 범위를 열어 주지만, 기능은 특정한 장소와 시간, 다른 분자와의 관계 속에서 나타납니다. 알파폴드는 이 흐름 가운데 서열에서 구조로 가는 구간을 밝힌 강력한 도구입니다. 그러나 구조에서 기능으로 가는 길에는 여전히 실험과 동역학, 세포 생물학과 의학의 해석이 필요합니다. “구조가 기능을 만든다”는 말은 하나의 고정된 모양이 기능을 완전히 결정한다는 뜻이 아닙니다. 더 정확히 말하면, 구조와 움직임은 단백질이 수행할 수 있는 기능의 범위를 만들고, 실제 기능은 환경과 상호작용 속에서 완성됩니다.
4.4 알파폴드2가 바꾼 것
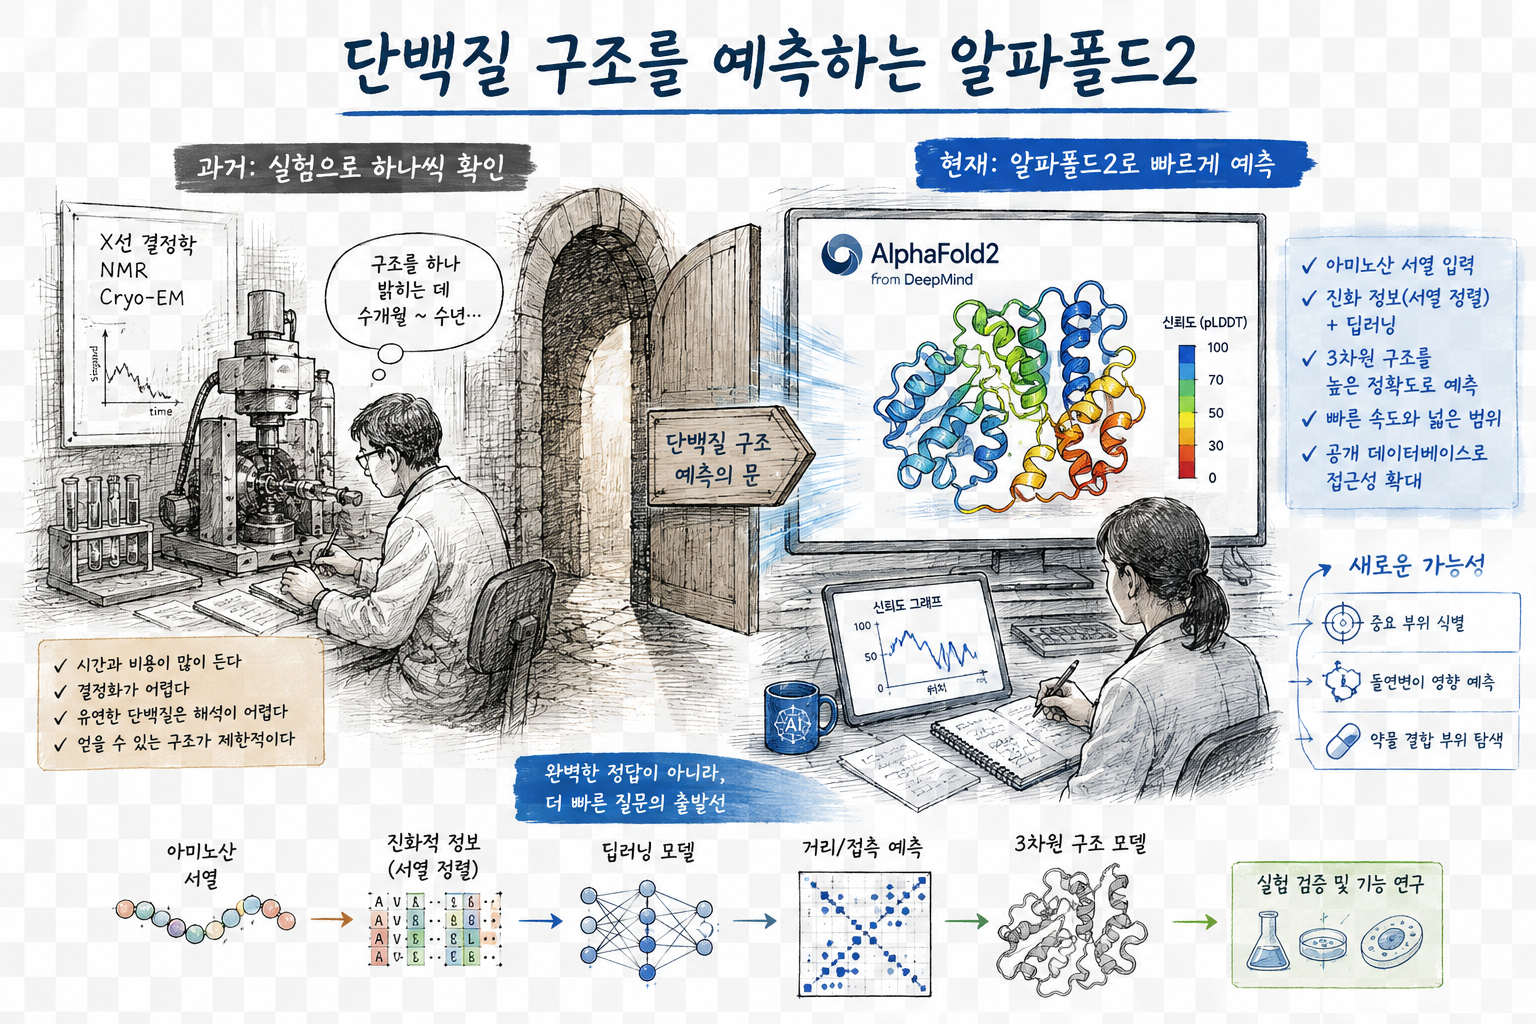
오랫동안 단백질 구조를 밝히는 일은 미지의 산악 지도를 만드는 작업과 같았습니다. X선 결정학, 핵자기공명, 극저온 전자현미경은 단백질의 원자 배열을 정밀하게 밝히는 강력한 기술이지만, 시료 준비부터 측정과 해석까지 많은 시간과 전문성이 필요합니다. 결정이 잘 만들어지지 않거나 지나치게 유연한 단백질은 구조를 얻기 어려운 경우도 있습니다. 이 지형을 크게 바꾼 것이 딥마인드의 알파폴드2(AlphaFold 2)입니다. 알파폴드2는 아미노산 서열을 바탕으로 단백질이 취할 가능성이 큰 3차원 구조를 높은 정확도로 예측하며, 오랫동안 난제로 남아 있던 ‘서열에서 구조로’의 문제에 중요한 돌파구를 열었습니다. 알파폴드2는 알려진 구조를 단순히 찾아 복사하는 시스템이 아닙니다. 진화적으로 관련된 단백질의 서열을 비교하고, 어떤 아미노산 위치들이 함께 변해 왔는지를 분석합니다. 서열에서는 멀리 떨어진 두 위치가 진화 과정에서 연관되어 변했다면, 실제 구조에서는 서로 가까이 놓여 상호작용했을 가능성이 있습니다. 여러 판본의 고문서를 비교해 떨어진 문장 사이의 숨은 대응 관계를 찾아내는 것과 비슷합니다.
알파폴드2는 이러한 진화 정보와 이미 밝혀진 단백질 구조의 규칙을 딥러닝으로 통합합니다. 아미노산 사이의 공간적 관계를 반복해서 갱신하며 전체 구조를 만들고, 예측 결과와 함께 각 부분의 신뢰도도 제시합니다. 연구자는 구조를 하나의 완성된 정답으로 받아들이는 대신, 어느 영역이 비교적 확실하고 어느 부분이 불안정한지 구분할 수 있습니다. 알파폴드2가 바꾼 것은 정확도만이 아니라 연구의 순서였습니다. 과거에는 실험 구조가 밝혀진 뒤에야 기능과 결합 부위를 구체적으로 논의할 수 있는 단백질이 많았습니다. 이제는 예측 구조를 먼저 살펴보고, 중요한 부위와 변이, 결합 가능성을 추정한 뒤 실험의 우선순위를 정할 수 있습니다. 아무런 단서 없이 어두운 방을 더듬던 연구자가 대략적인 지도를 들고 들어가게 된 셈입니다. 지도는 모든 돌과 나뭇가지를 표시하지 않지만, 절벽과 골짜기의 위치를 알려 줍니다. 예측 구조도 단백질의 모든 상태와 움직임을 보여 주지는 않지만, 무엇을 먼저 바꾸고 측정할지 판단하게 합니다.
알파폴드를 설명하는 데미스 허사비스
알파폴드 단백질 구조 데이터베이스의 공개는 연구의 접근성도 넓혔습니다. 대형 장비와 구조생물학 전문 인력이 부족한 연구실도 예측 구조를 출발점으로 기능과 변이, 질병 관련성에 관한 질문을 던질 수 있게 되었습니다. 구조 정보가 제한된 전문가 집단의 자원에서 더 넓은 과학 공동체의 연구 기반으로 이동한 것입니다. 그러나 접근성이 높아질수록 해석의 책임도 커집니다. 예측 구조의 모든 부분이 똑같이 확실한 것은 아닙니다. 유연한 영역이나 특정 결합 상대와 환경에 따라 형태가 달라지는 부분은 신뢰도가 낮을 수 있습니다. 낮은 신뢰도가 반드시 모델의 단순한 실패를 뜻하는 것도 아닙니다. 실제 단백질이 하나의 안정된 구조를 갖지 않는 영역일 가능성도 있습니다. 알파폴드2는 단백질이 실제로 어떤 경로를 거쳐 접히는지, 세포 안에서 구조가 시간에 따라 어떻게 변하는지까지 재현하지 않습니다. 예측된 구조는 단백질의 유력한 상태를 보여 주는 정지 화면에 가깝습니다. 실제 생명 활동은 그 구조가 움직이고, 결합하고, 변형되는 영상입니다. 따라서 알파폴드2의 의미는 실험을 없앤 데 있지 않습니다. 실험이 더 중요한 질문에 집중하도록 만든 데 있습니다. AI가 가능한 구조와 탐색 방향을 제시하면, 실험은 그 구조가 실제 조건에서 존재하는지, 어떻게 움직이며 어떤 기능을 수행하는지 확인합니다. 알파폴드2는 생명과학자의 손을 대신한 기계라기보다, 이전에는 보이지 않던 지형을 먼저 드러낸 새로운 지도입니다.
4.5 알파폴드3와 분자 상호작용
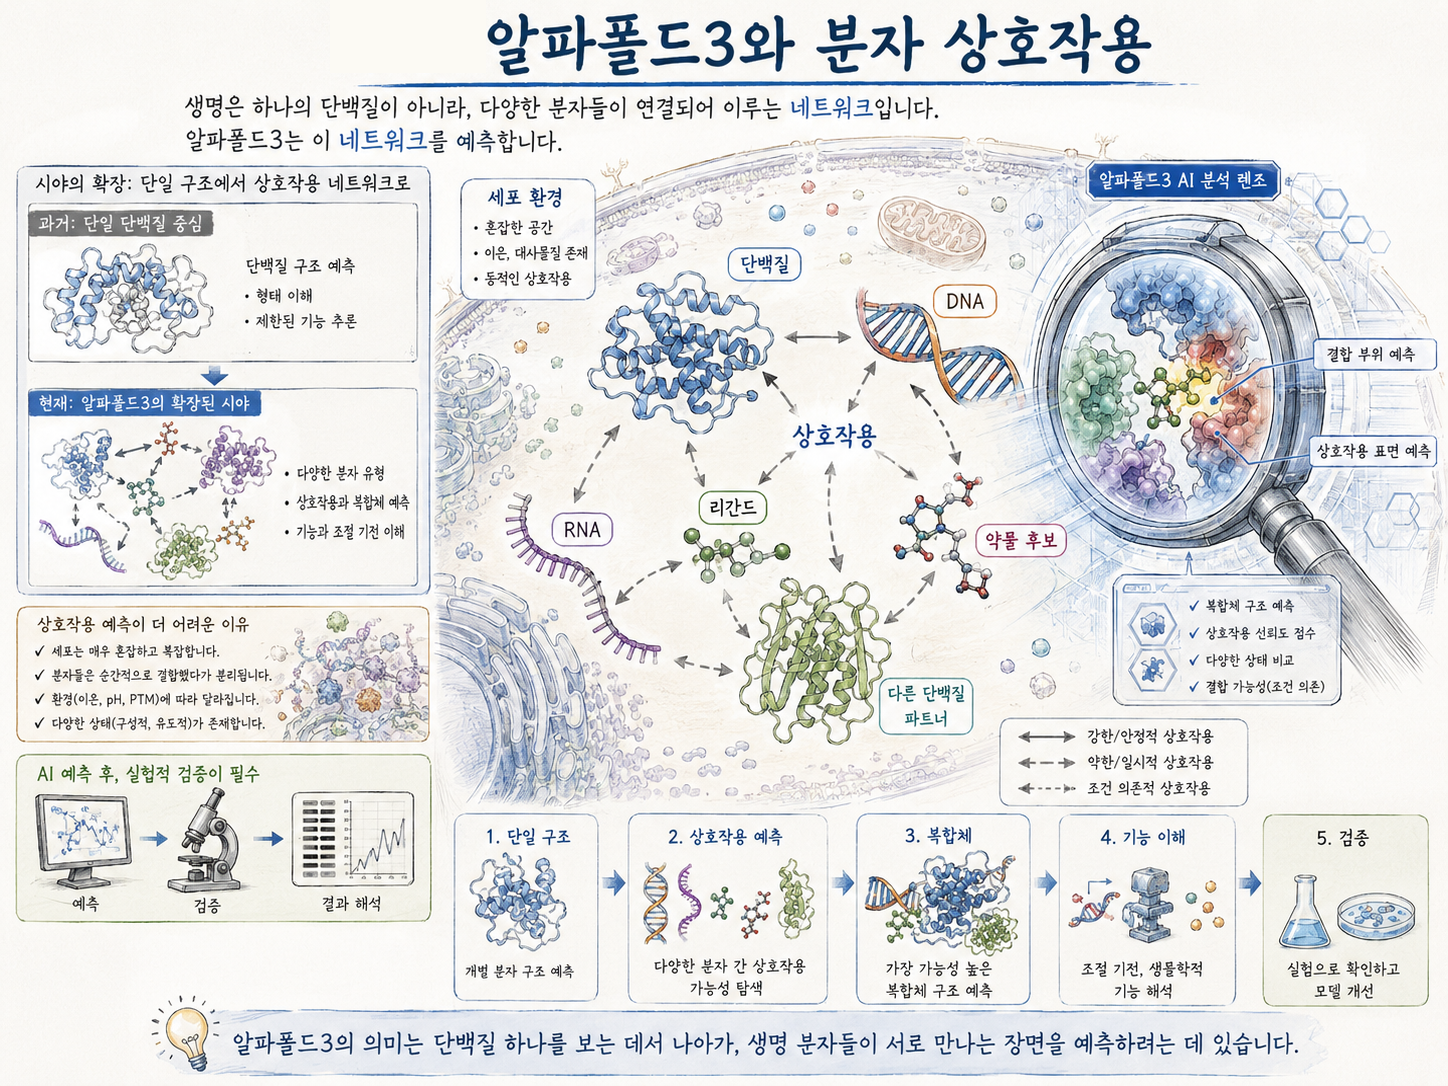
세포 안에서 단백질은 홀로 일하지 않습니다. 다른 단백질과 결합하고, DNA와 RNA를 붙잡으며, 이온과 작은 분자를 받아들이거나 밀어냅니다. 단백질 하나의 구조를 밝히는 일이 배우의 모습을 확인하는 것이라면, 분자 상호작용을 연구하는 일은 여러 배우가 함께 만드는 장면을 해석하는 일입니다. 2024년 구글 딥마인드와 아이소모픽 랩스가 공개한 알파폴드3(AlphaFold 3)는 이러한 관계의 장면으로 예측 범위를 넓혔습니다. 알파폴드2가 단백질 구조 예측에서 큰 도약을 이루었다면, 알파폴드3는 단백질과 단백질, 단백질과 핵산, 단백질과 작은 분자 등이 이루는 복합체의 구조를 폭넓게 다루려 합니다. 분자 상호작용은 생명 활동의 중심에 있습니다. 효소는 반응할 분자를 붙잡고, 조절 단백질은 DNA에 결합해 유전자의 발현을 바꿉니다. 세포 표면의 수용체는 신호 분자를 인식하며, 약물은 특정 단백질에 결합해 그 기능을 억제하거나 조절합니다. 분자들이 어느 표면에서 어떤 형태로 만나는지 알면 생명 현상의 작동 원리를 더 구체적으로 탐구할 수 있습니다.
그러나 상호작용 예측은 단일 단백질 구조 예측보다 더 복잡합니다. 세포 안에서는 수많은 분자가 움직이고 경쟁하며, 결합과 해리가 끊임없이 반복됩니다. 상호작용의 여부와 강도는 농도와 온도, 산성도, 세포 내 위치, 주변 분자와 화학적 변형에 따라 달라집니다. 구조적으로 잘 맞아 보이는 두 분자가 실제 세포 안에서 반드시 결합하는 것은 아닙니다. 약물 결합도 같은 한계를 갖습니다. 후보 물질이 표적 단백질의 홈에 들어맞는 구조로 예측되더라도 그것이 곧 치료 효과를 뜻하지는 않습니다. 약물은 몸속에서 지나치게 빨리 분해되지 않아야 하고, 필요한 조직과 세포에 도달해야 하며, 표적이 아닌 단백질과의 결합도 피해야 합니다. 결합 구조는 신약 개발의 중요한 출발점이지만, 약효와 안전성은 흡수·분포·대사·배설과 독성을 포함한 몸 전체의 과정에서 결정됩니다. 알파폴드3는 이 넓은 탐색 공간에서 실험할 후보를 좁히는 데 도움을 줄 수 있습니다. 약물이 결합할 가능성이 있는 부위, 단백질과 핵산이 만나는 표면, 여러 분자가 이루는 복합체의 형태를 미리 살펴볼 수 있기 때문입니다. 이는 막연했던 질문을 구체적인 실험 문제로 바꾸어 줍니다.
그러나 예측된 복합 구조가 실제 상호작용의 존재와 강도, 생물학적 효과를 모두 증명하는 것은 아닙니다. AI가 두 분자가 ‘만날 수 있는 모양’을 제시하는 것과 실제 세포에서 ‘의미 있게 만난다’는 것은 다른 주장입니다. 결합 친화도와 지속 시간, 기능적 결과는 별도의 계산과 실험으로 확인해야 합니다. 알파폴드3의 중요한 의미는 생명을 개별 분자의 목록에서 관계의 체계로 옮겨 보게 했다는 데 있습니다. 단일 구조에서 복합체로, 복합체에서 시간에 따라 변하는 세포의 상호작용망으로 연구의 시야가 확장되고 있습니다. 생명 분자의 기능은 고립된 상태에서 완성되지 않습니다. 누구와 만나고, 어느 장소에서, 얼마나 오래 결합하는지에 따라 역할이 달라집니다. 알파폴드3는 이 관계의 한 장면을 예측하는 중요한 진전이지만, 살아 있는 세포의 전체 대화를 읽기 위한 출발점이기도 합니다.
4.6 DNA는 악보이고 세포는 연주다
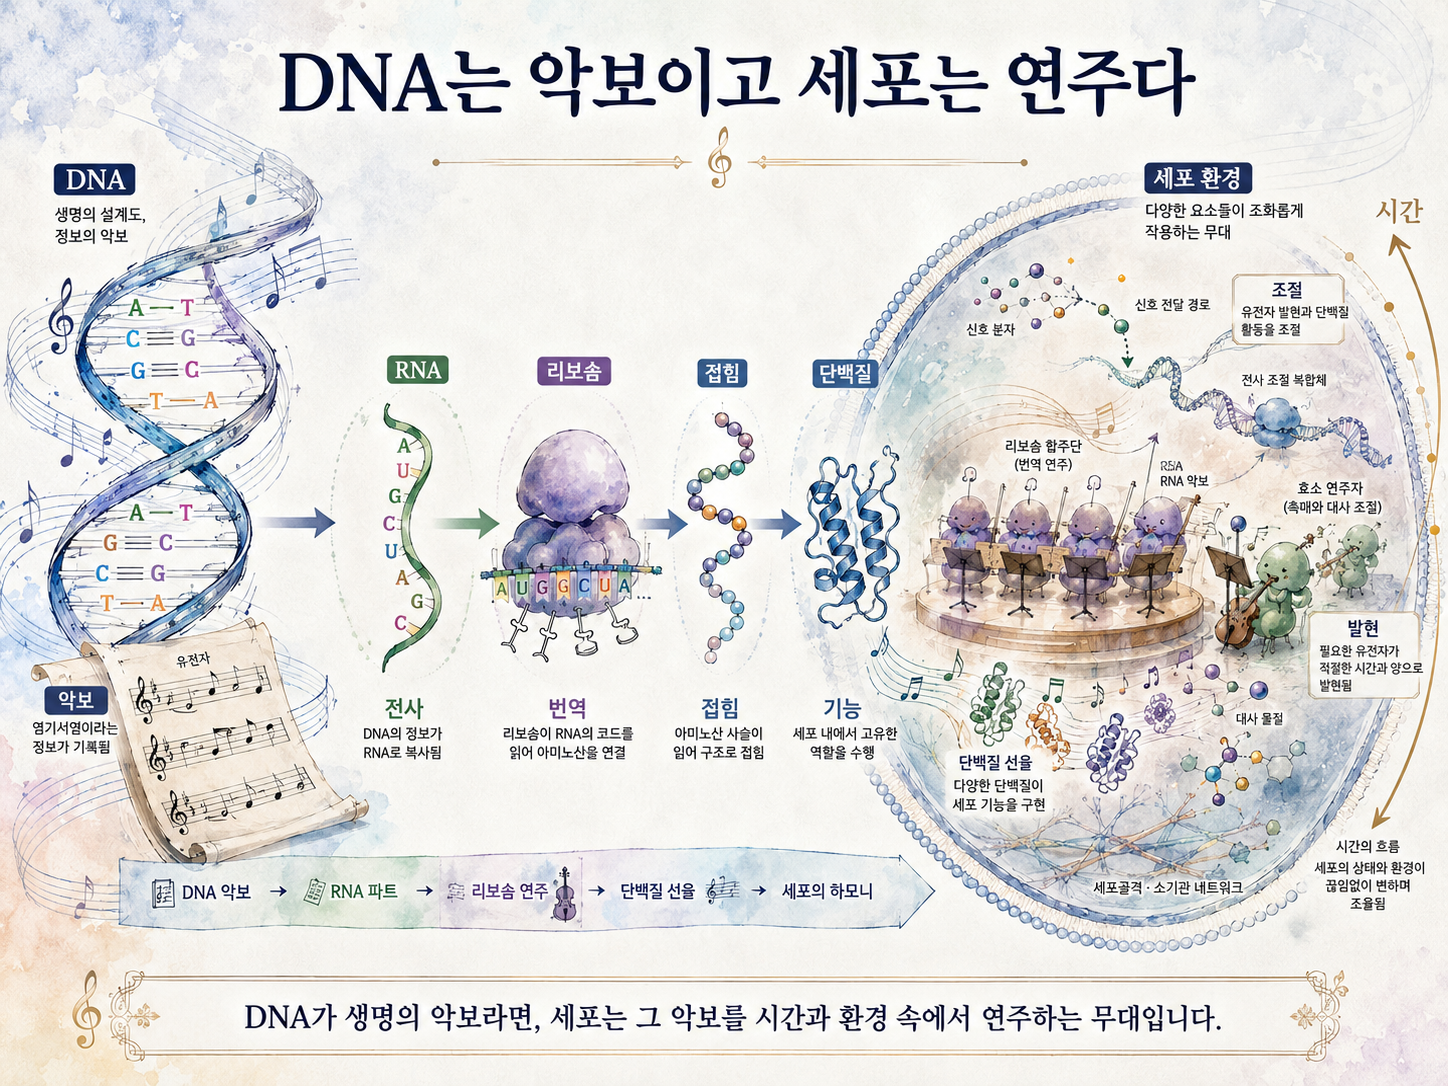
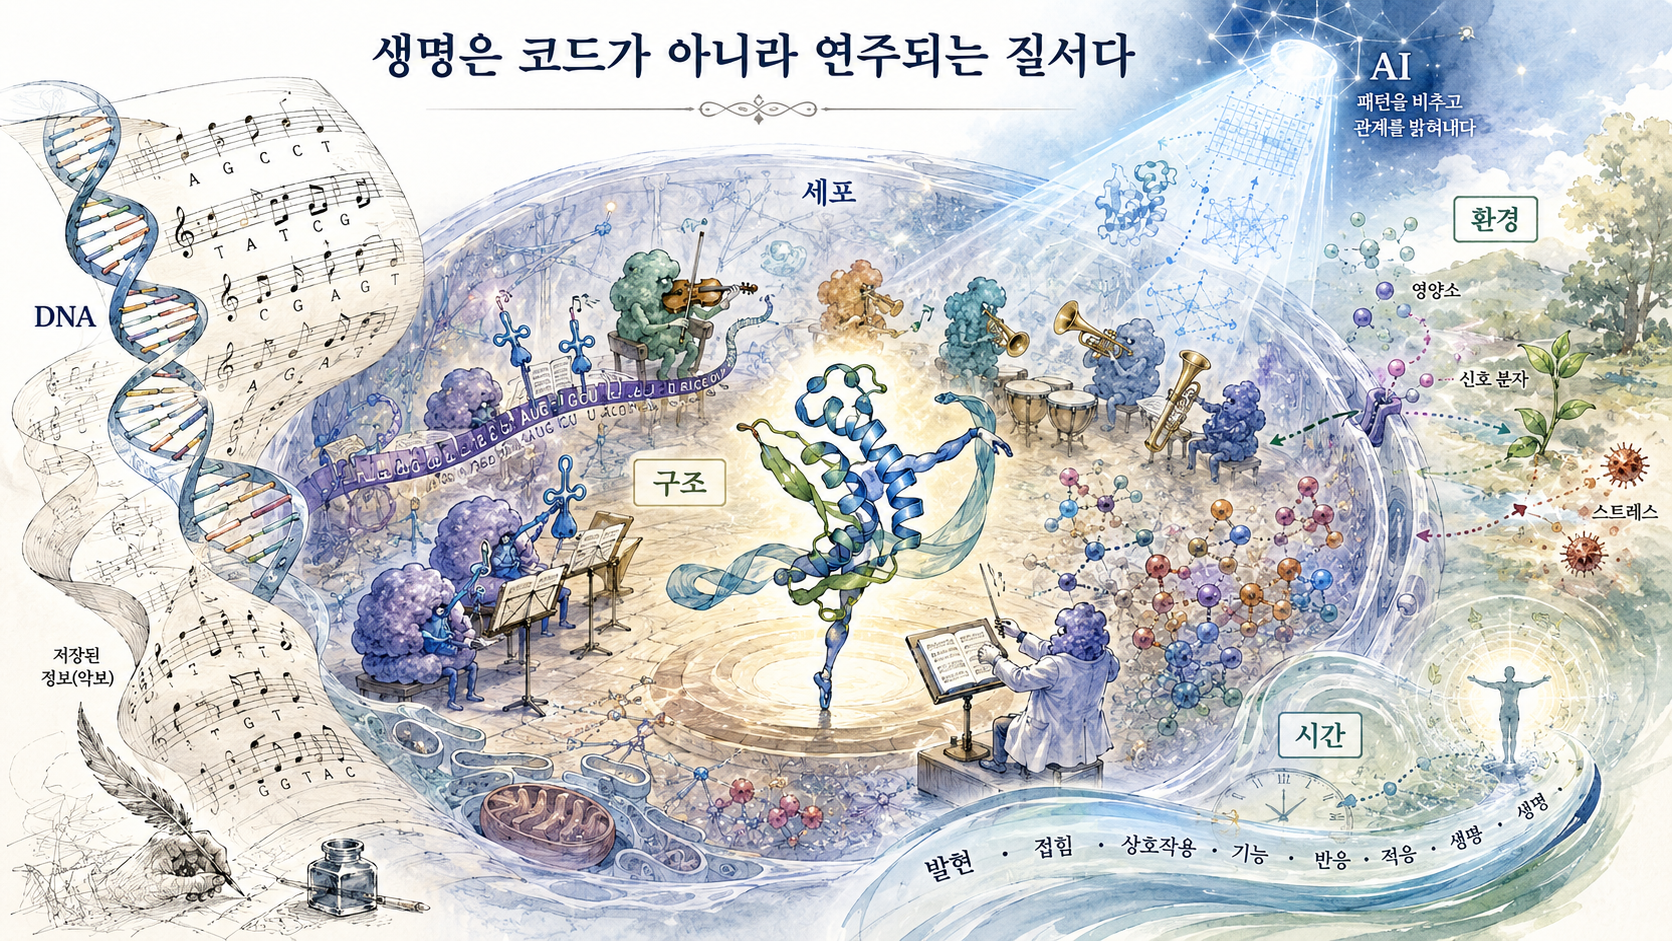
같은 악보도 연주자와 악기, 속도와 공연장에 따라 서로 다른 음악이 됩니다. 악보에는 곡의 기본 정보가 담겨 있지만, 음악은 그 정보가 실제 악기와 공간 속에서 실행될 때 비로소 생겨납니다. DNA와 생명의 관계도 이와 비슷합니다. DNA 서열은 생명 활동에 필요한 정보를 저장하지만, 모든 유전자가 언제나 같은 세기로 작동하는 것은 아닙니다. 어떤 유전자가 어느 세포에서 언제 읽히는지, 만들어진 단백질이 어디로 이동해 누구와 만나는지가 중요합니다. 세포는 정보를 쌓아 두는 창고가 아니라, 환경에 따라 선택하고 실행하는 동적인 체계입니다. 세포를 오케스트라에 비유하면 DNA는 전체 악보에 가깝습니다. 전령 RNA는 연주에 필요한 부분을 옮겨 적은 파트보이며, 리보솜은 그 정보를 읽어 아미노산 사슬을 만드는 연주 장치입니다. 만들어진 단백질은 화학반응을 촉진하고, 신호를 전달하며, 다른 유전자의 발현을 조절합니다. 그 결과는 다시 세포의 상태와 유전자 발현에 영향을 줍니다. 생명은 악보를 처음부터 끝까지 한 번 연주하고 멈추는 음악이 아닙니다. 상황에 따라 악절을 선택하고, 연주의 세기를 바꾸며, 계속 조율되는 합주입니다.
이 비유는 후성유전학을 이해하는 데에도 도움이 됩니다. DNA의 염기서열이 바뀌지 않아도, DNA와 그 주변 단백질에 붙는 화학적 표지와 염색질의 상태에 따라 특정 유전자가 더 쉽게 읽히거나 억제될 수 있습니다. 악보의 음표는 그대로지만 어떤 악절을 크게 연주하고 어느 부분을 쉬어 갈지가 달라지는 셈입니다. 신경세포와 근육세포는 대체로 같은 유전정보를 지니지만 서로 다른 유전자 집합을 사용합니다. 그 결과 하나는 전기 신호를 전달하고, 다른 하나는 수축해 힘을 만듭니다. 세포의 정체성은 보유한 DNA만이 아니라 그중 어떤 정보를 언제 사용하는지에 의해 형성됩니다. 따라서 생명은 부품 목록이 아니라 시간표와 장소표를 가진 과정입니다. 같은 단백질도 발생 과정과 성체 조직에서 다른 의미를 가질 수 있고, 세포의 위치와 주변 신호에 따라 서로 다른 역할을 수행할 수 있습니다. 생명 AI도 이러한 여러 층을 연결하는 방향으로 발전하고 있습니다. DNA 서열과 RNA 발현량, 단백질 구조와 상호작용, 세포 이미지와 조직의 공간 정보를 함께 분석해 생명 현상을 더 입체적으로 이해하려는 것입니다. 단백질 구조 예측이 한 분자의 모습을 선명하게 했다면, 다음 단계의 AI는 여러 분자가 언제 어디서 함께 작동하는지를 읽어야 합니다.
이러한 접근은 질병을 바라보는 방식도 바꿉니다. 같은 유전 변이를 지녔다고 모든 사람에게 같은 증상이 나타나는 것은 아닙니다. 다른 유전자와의 관계, 나이와 면역 상태, 생활환경과 장내 미생물, 치료 이력이 함께 영향을 줍니다. 하나의 병명 아래에도 서로 다른 분자적 경로가 존재할 수 있으며, 같은 약물에도 환자마다 반응이 달라질 수 있습니다. AI는 유전체와 분자 데이터, 영상과 임상 기록을 연결해 이러한 차이를 찾는 데 도움을 줄 수 있습니다. 그러나 환자는 여러 데이터 층을 합한 계산 결과가 아닙니다. 질병으로 고통받고, 치료의 위험과 가능성을 이해하며, 자신의 삶에 관한 결정을 내려야 하는 사람입니다. 정밀한 예측이 좋은 의료가 되려면 결과가 이해할 수 있는 언어로 설명되어야 하고, 실제 임상 조건에서 검증되어야 하며, 환자의 가치와 선택을 존중하는 돌봄으로 이어져야 합니다. 앞으로의 생명 AI는 단백질의 정지된 구조를 넘어 세포의 시간표를 읽으려 할 것입니다. 어느 유전자가 언제 켜지고 꺼지는지, 단백질이 어디로 이동해 어떤 분자와 만나는지, 질병이 진행되며 세포의 조율이 어떻게 어긋나는지를 추적하는 것입니다. 이는 단순히 더 많은 데이터를 모으는 일이 아닙니다. 흩어진 생명정보를 시간과 공간, 관계의 과정으로 다시 구성하는 일입니다. 『장자』는 존재를 고정된 이름과 형태보다 끊임없이 변화하는 관계와 흐름 속에서 바라보았습니다. 생명을 코드로 읽는 일은 강력하지만, 코드만으로 살아 있음을 모두 설명할 수는 없습니다. 악보는 연주의 가능성을 담지만 음악은 아닙니다. DNA 역시 생명의 가능성을 기록하지만, 살아 있음은 그 정보가 물질과 에너지, 세포와 환경 속에서 실행될 때 나타납니다. 생명은 저장된 문장이 아니라 계속 읽히고 수정되며 연주되는 질서입니다. AI가 생명을 더 깊이 이해하려면 코드의 정확성뿐 아니라 그 코드가 울리는 시간과 장소, 관계의 변화를 함께 읽어야 합니다.
4.7 병과 치료를 보는 새로운 방식
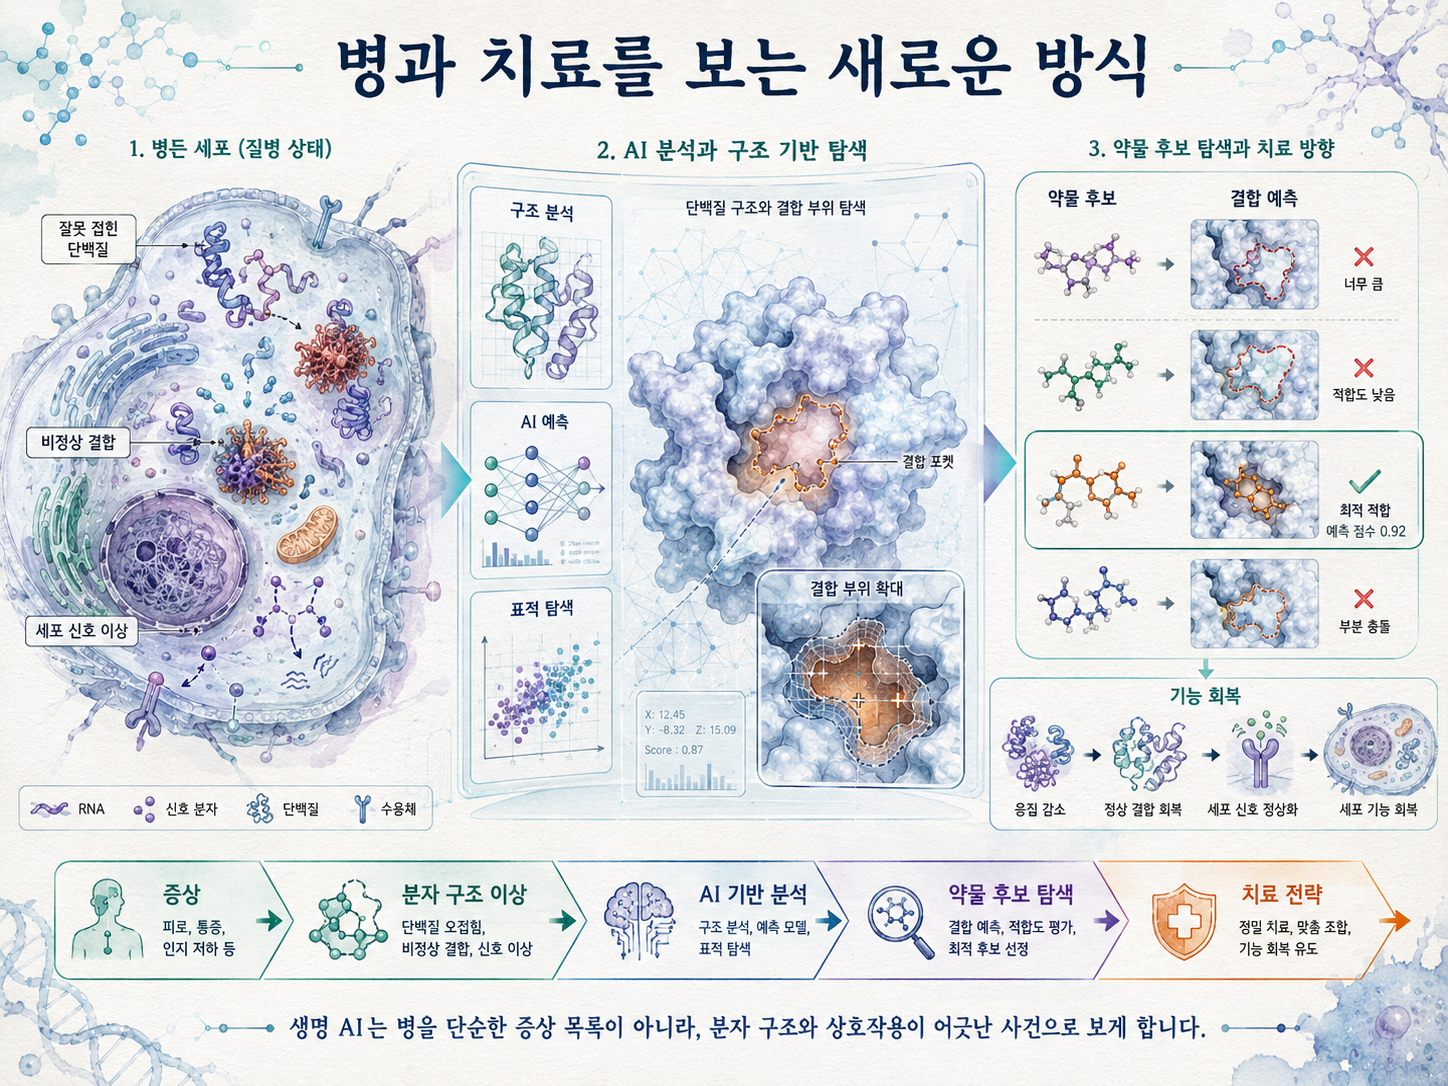
시계가 멈췄을 때 바늘만 들여다보아서는 원인을 알기 어렵습니다. 톱니가 닳았는지, 축이 휘었는지, 동력을 전달하는 장치가 끊어졌는지 내부를 살펴야 합니다. 질병도 마찬가지입니다. 증상은 겉으로 드러난 결과이며, 그 배후에는 단백질의 구조 변화와 분자 결합의 이상, 세포 신호의 교란이 놓여 있을 수 있습니다. 단백질이 알맞게 접히지 못하거나 필요한 분자와 결합하지 못하면 정상적인 기능이 흔들립니다. 반대로 결합해서는 안 되는 분자들이 달라붙거나, 세포 신호가 지나치게 강하거나 약해져도 질병이 생길 수 있습니다. 생명 AI는 이러한 분자 수준의 변화를 분석해 질병의 원인을 좁히고, 치료가 개입할 지점을 찾는 데 활용됩니다. 알츠하이머병과 파킨슨병에서는 특정 단백질의 비정상적인 접힘과 응집이 질병 과정의 중요한 일부를 이룹니다. 단백질이 본래의 기능을 잃고 덩어리를 형성하면 세포의 물질 운반과 에너지 대사, 신호 전달이 방해받을 수 있습니다. 물론 이 질환들은 단백질 응집 하나로 모두 설명되지 않습니다. 염증과 유전적 요인, 노화와 세포 환경이 함께 작용합니다. 그럼에도 접힘의 이상이 기억과 운동, 환자와 가족의 삶에 직접 연결된다는 점은 분명합니다. 구조 정보는 치료 전략도 바꿉니다. 질병 관련 단백질의 어느 부위에 약물이 결합할 수 있는지, 특정 변이가 구조와 기능을 어떻게 바꾸는지를 구체적으로 살필 수 있기 때문입니다. 어떤 약물은 효소의 활성 부위를 막아 과도한 반응을 억제하고, 어떤 약물은 불안정한 단백질의 구조나 기능을 보완합니다. 암 면역치료는 면역세포와 암세포 사이의 신호를 조절해 면역 반응이 다시 작동하도록 돕습니다.
낭성섬유증 치료는 정밀의학의 한 사례입니다. 같은 병명이라도 CFTR 단백질에 생긴 변이의 종류에 따라 단백질이 세포막에 도달하지 못하거나, 도달하더라도 이온 통로로서 제대로 열리지 않을 수 있습니다. 일부 치료제는 이러한 서로 다른 결함에 맞추어 단백질의 이동이나 기능을 보완합니다. 질병의 이름보다 분자적 원인을 더 세밀하게 보는 접근입니다. AI는 수많은 변이와 화합물 가운데 우선적으로 실험할 대상을 고르는 데 유용합니다. 결합 가능성과 구조적 특징, 기존 실험 자료를 종합해 유망한 후보를 제안할 수 있습니다. 이는 시행착오를 없애는 일이 아니라, 제한된 시간과 자원을 더 많은 정보를 얻을 수 있는 실험에 집중하는 일입니다. 이러한 분석은 환자 맞춤 치료로 이어질 수 있습니다. 같은 병으로 진단받은 환자도 질병을 일으킨 분자 경로와 약물 반응이 다를 수 있습니다. AI는 유전정보와 단백질 특성, 의료영상과 임상 기록을 함께 분석해 치료 가능성을 비교할 수 있습니다. 그러나 분자 수준의 정밀함이 치료의 성공을 보장하지는 않습니다. 약물이 몸속에서 얼마나 흡수되고 분해되는지, 목표 조직에 도달하는지, 다른 장기에 어떤 영향을 미치는지는 별도로 검증해야 합니다. 후보 물질은 세포와 동물모델, 임상시험을 거쳐 효과와 독성을 확인해야 하며, 실제 환자가 치료에 접근할 수 있는지도 중요합니다. 구조 예측에서 치료까지의 길에는 긴 번역 과정이 있습니다.
분자적 가능성 → 실험적 효과 → 임상적 안전성 → 환자에게 도달하는 치료
의료에서 필요한 것은 높은 정확도만이 아닙니다. 환자는 왜 특정 치료가 제안되었는지, 기대 효과와 위험은 무엇인지, 다른 선택지는 없는지 이해할 수 있어야 합니다. AI가 분석을 복잡하게 만들수록 결과를 사람의 언어로 설명하고 책임 있게 사용하는 일이 중요해집니다. 생명 AI가 의료에 가져올 변화는 병을 더 정밀하게 분류하는 데 그치지 않습니다. 그 지식을 환자에게 더 적절하고 안전하며 이해 가능한 치료로 연결하는 데 있습니다. 환자는 유전자와 단백질, 영상과 임상 수치를 합친 데이터 묶음이 아니라, 질병을 겪고 치료를 선택하며 삶을 이어 가는 사람입니다.
4.8 생명 설계의 가능성과 위험
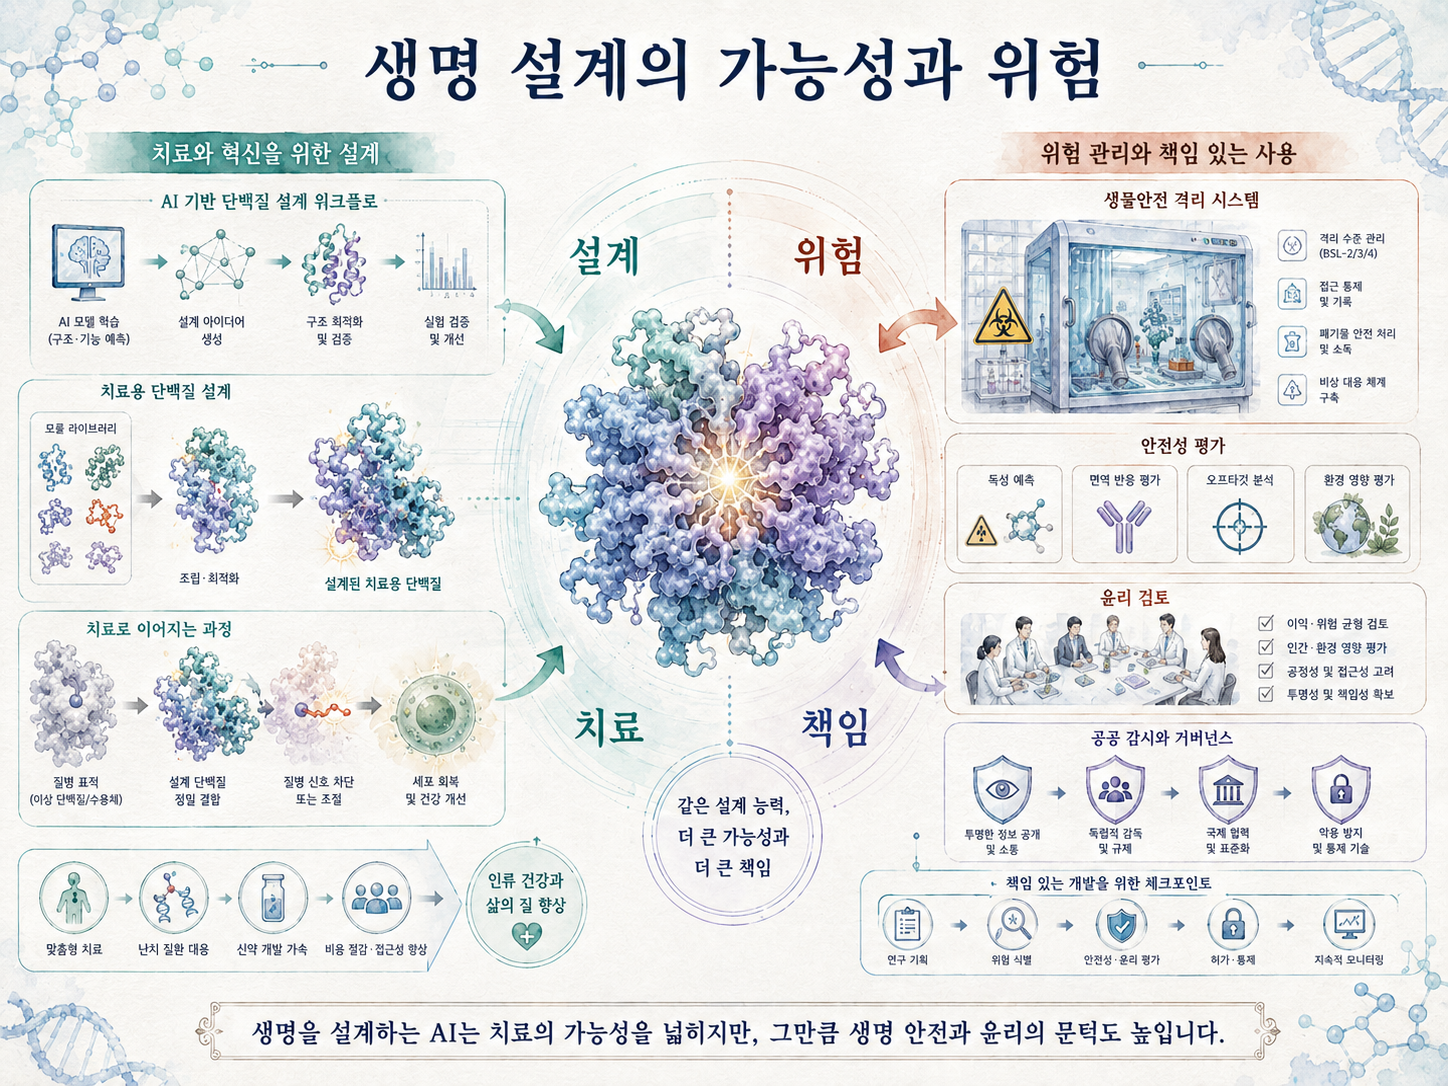
<p>AI는 자연에 존재하는 단백질과 생물학적 기능을 학습해, 기존에 없던 효소와 치료 분자, 생물학적 회로를 제안할 수 있습니다. 오염 물질을 분해하는 효소, 특정 세포를 선택적으로 인식하는 단백질, 의약품을 더 효율적으로 생산하는 생물학적 공정은 이미 중요한 연구 대상이 되고 있습니다. 이때 AI는 무에서 생명을 창조하는 것이 아니라, 자연이 오랜 진화 속에서 축적해 온 구조와 기능의 관계를 학습한 뒤, 원하는 기능에 맞는 새로운 서열과 구조를 거꾸로 찾아냅니다. 말하자면 자연의 문법을 이용해 아직 쓰이지 않은 문장을 만들어보는 일에 가깝습니다. 이 가능성은 생명공학의 지평을 크게 넓힙니다. 인간이 일일이 시험하기 어려운 수많은 후보를 AI가 먼저 탐색하고, 기능이 있을 법한 설계를 빠르게 좁혀줄 수 있기 때문입니다. 생명 설계는 더 이상 자연에 이미 존재하는 분자를 찾는 일에만 머물지 않고, 필요한 기능을 먼저 정한 뒤 그 기능을 수행할 수 있는 생물학적 구조를 제안하는 방향으로 나아가고 있습니다.<br> 그러나 바로 이 지점에서 위험도 커집니다. 설계된 생명 시스템은 일반 공산품과 다릅니다. 잘못 만든 의자는 버리면 되지만, 생물학적 기능은 인체와 생태계 안에서 다른 분자, 세포, 미생물과 상호작용할 수 있습니다. 일부는 증식하거나 변형될 수 있고, 실험실에서 예상대로 작동한 시스템이 실제 환경에서는 다른 결과를 낳을 수도 있습니다. 생명은 외부와 분리된 기계가 아니라 물질과 정보, 에너지를 끊임없이 교환하는 열린 체계이기 때문입니다. 따라서 생명 설계의 평가는 성능만으로 끝날 수 없습니다. 원하는 기능을 얼마나 잘 수행하는가뿐 아니라 독성, 안정성, 생태계 영향, 회수 가능성, 오용 가능성, 비용과 접근성까지 함께 따져야 합니다. AI는 좁게 설정된 목표를 매우 잘 달성할 수 있지만, 그 목표 밖에서 발생하는 피해까지 스스로 판단하지는 않습니다. 유익한 기술이 해로운 목적으로 전용될 가능성, 치료와 생명 데이터에 대한 접근이 일부 국가와 계층에 집중될 가능성도 함께 고려해야 합니다.<br> 그러므로 생명 설계에서 윤리는 연구가 끝난 뒤 덧붙이는 검토 항목이 아니라 설계의 초기 조건이어야 합니다. 무엇을 만들 것인가를 묻는 순간, 동시에 물어야 합니다. 누구를 위한 설계인가, 실패하면 누구와 무엇이 영향을 받는가, 실험실 밖으로 퍼질 가능성은 없는가, 작동을 멈추거나 회수할 방법은 있는가, 누가 검증하고 중단을 결정할 것인가.<br> 안전 기준은 기술의 상상력을 억누르는 장애물이 아닙니다. 다리에 하중 기준을 적용하는 이유가 다리를 포기하기 위해서가 아니듯, 생명 설계의 안전 기준은 유익한 기술을 오래, 넓게, 책임 있게 사용하기 위한 조건입니다. 생명 AI의 핵심 질문은 “어디까지 만들 수 있는가”에 머물지 않습니다. <strong>어떤 목적을 위해, 어떤 경계 안에서, 누구의 책임으로 만들 것인가</strong>까지 물을 때 생명 설계는 과학적 가능성에서 사회적 기술로 나아갑니다.
생명 설계를 둘러싼 상상과 경계
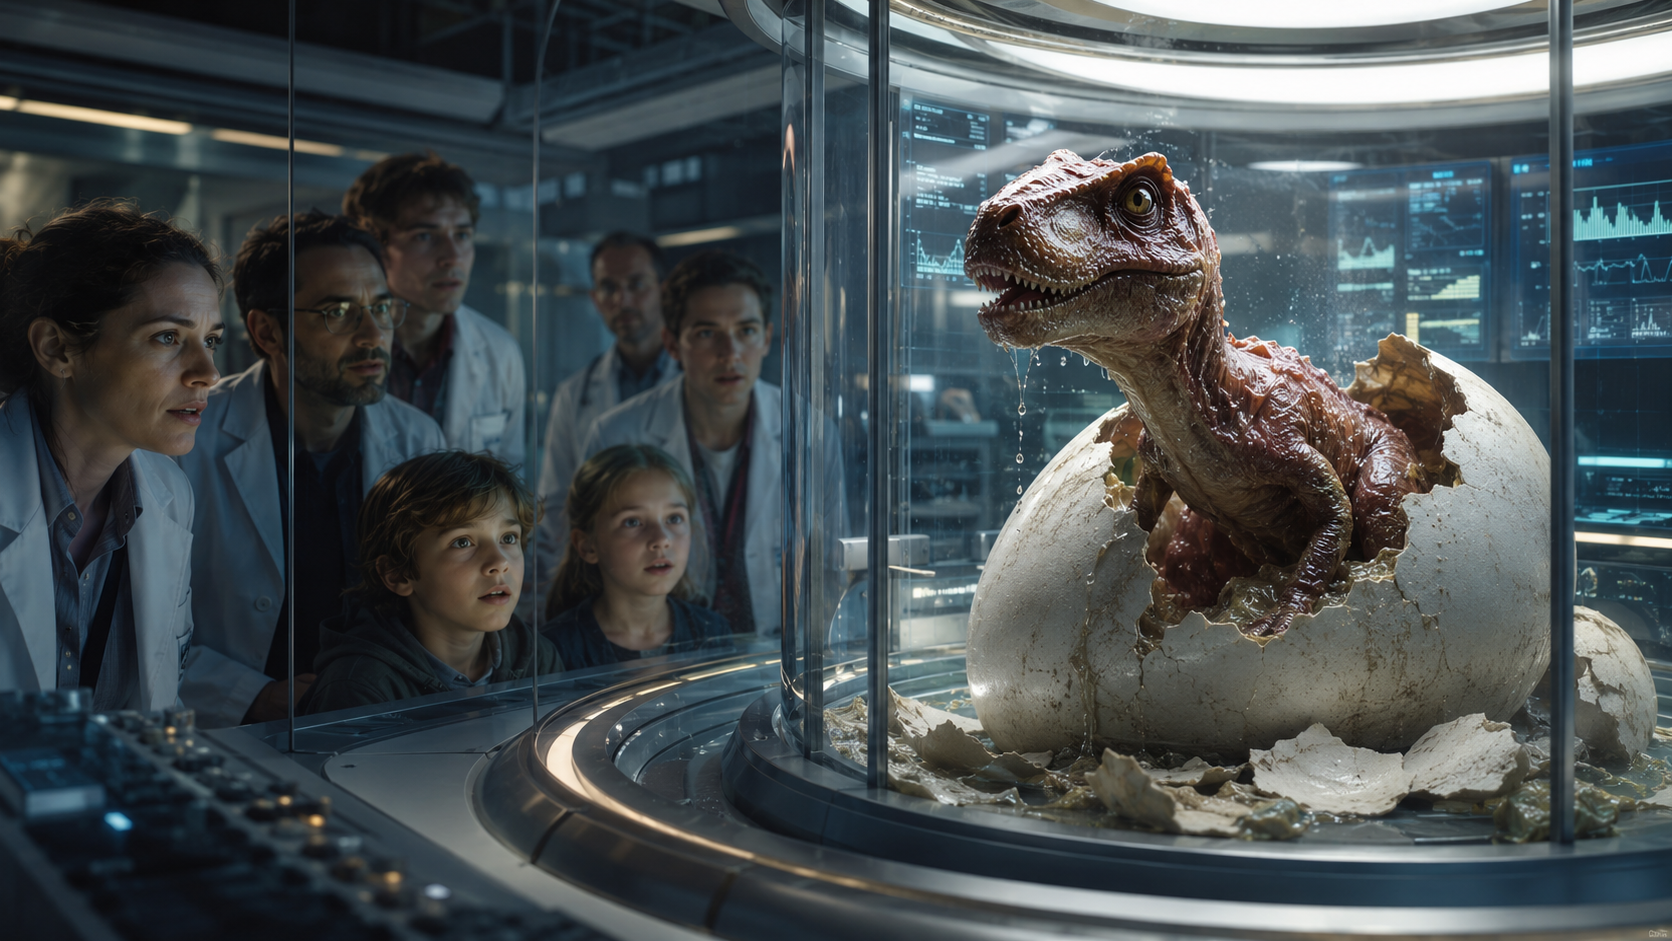
이 그림은 실제 기술로 복원된 공룡이 아니라 생명 설계에 투사된 인간의 욕망과 두려움을 표현한 상상도입니다. 현재의 생명공학은 멸종한 공룡을 완전한 생명체로 되살릴 수 있는 단계에 있지 않습니다.
4.9 생명 AI의 한계: 몸·환경·시간 그리고 ‘비유’
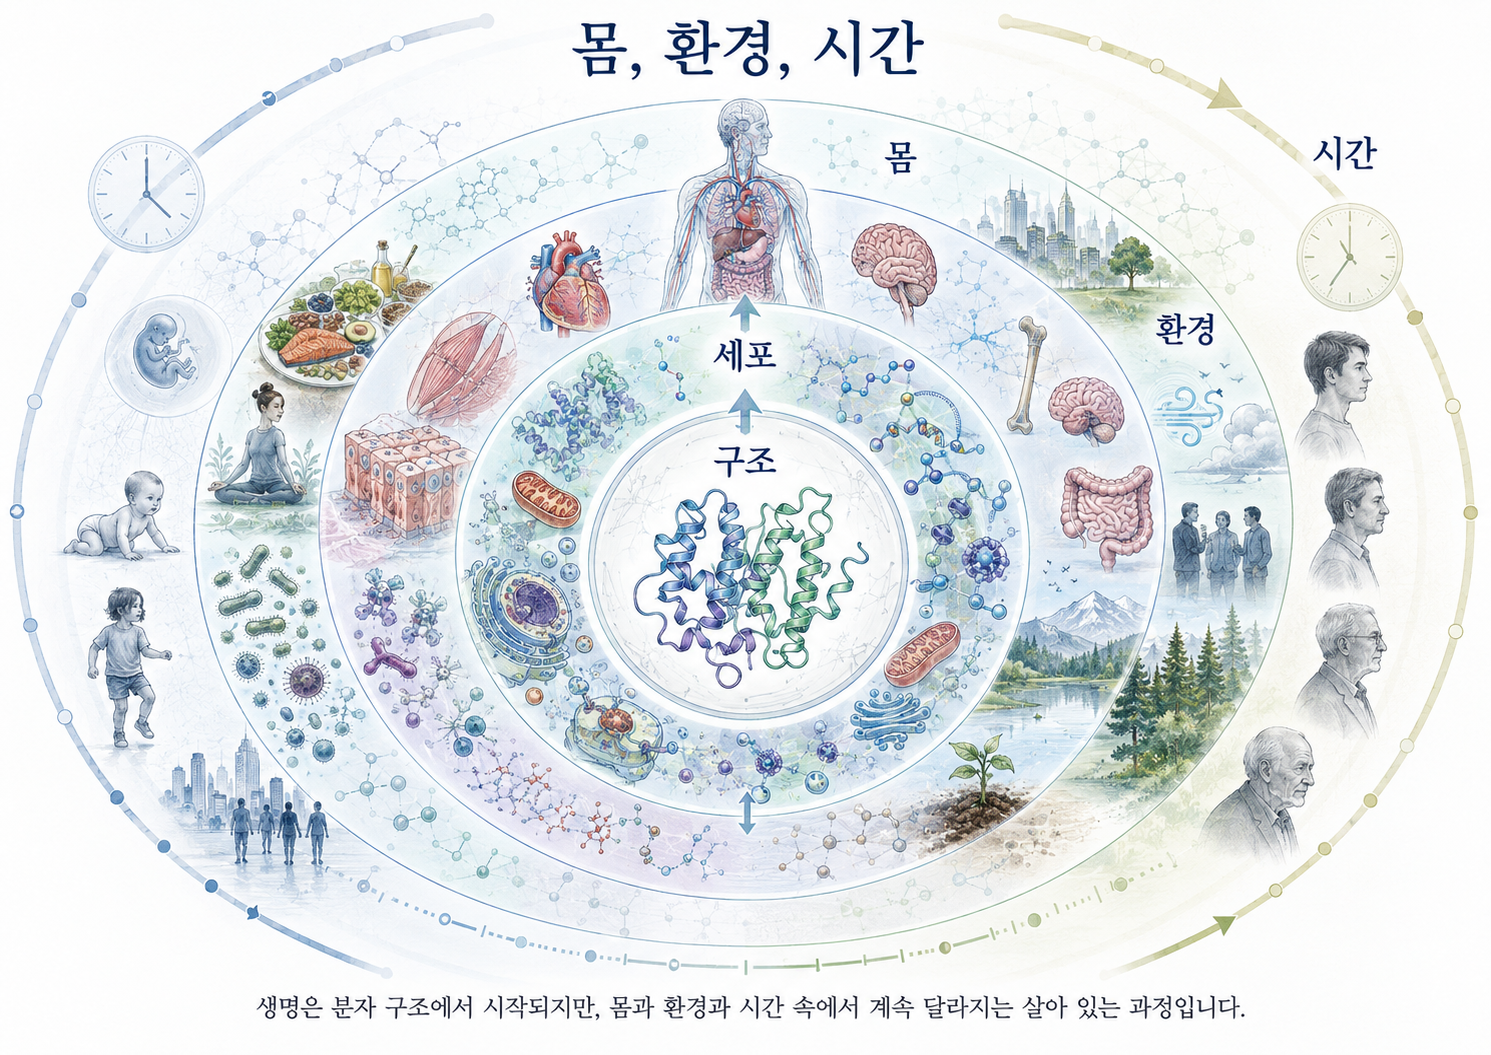
한 사람의 목소리는 녹음 파일만으로 온전히 설명되지 않습니다. 몸의 상태와 감정, 말하는 상대와 공간의 울림에 따라 같은 목소리도 다르게 들립니다. 생명 역시 유전자 하나나 단백질 구조 하나로 충분히 설명할 수 없습니다. 몸과 환경, 시간이 함께 만드는 과정이기 때문입니다. AI는 방대한 생명 데이터에서 사람이 놓치기 쉬운 패턴을 찾아냅니다. 그러나 데이터가 많아져도 살아 있는 몸과 삶의 모든 조건이 기록되는 것은 아닙니다. 생명 AI를 제대로 사용하려면 무엇을 잘 예측하는지만큼 무엇을 보지 못하는지도 알아야 합니다. 첫 번째 한계는 몸입니다. 모델은 유전자와 단백질, 세포의 특징을 각각의 데이터로 학습하지만 실제 몸에서는 혈류와 면역계, 대사와 호르몬, 신경계와 여러 장기가 동시에 작동합니다. 분자 하나의 변화가 몸 전체에 미치는 영향은 여러 단계의 조절과 되먹임을 거쳐 나타납니다. 단백질 구조를 정확히 예측해도 그 변화가 개체 전체에서 어떤 결과를 낳을지는 별도의 문제입니다.
두 번째 한계는 환경입니다. 같은 유전적 특징을 가진 사람도 영양 상태와 감염, 스트레스와 생활 습관, 의료와 돌봄의 조건에 따라 서로 다른 결과를 보일 수 있습니다. 질병은 분자 수준의 생물학적 사건인 동시에 한 사람의 생활과 사회적 조건 속에서 벌어지는 사건입니다. 세 번째 한계는 시간입니다. 생명은 한 장의 사진이 아니라 이어지는 영상입니다. 단백질은 흔들리고 결합 상대에 따라 형태를 바꾸며, 세포는 성장하고 분열하고 죽습니다. 몸은 발달하고 노화하며, 질병도 진행과 회복의 시간을 갖습니다. 어느 순간의 구조와 수치만으로 이러한 변화를 모두 설명할 수 없습니다. 생명 AI가 다루어야 할 세계는 여러 규모로 겹쳐 있습니다.
서열 → 분자 → 세포 → 조직 → 장기 → 개체 → 생활환경
아래 단계의 정밀한 정보가 위 단계를 자동으로 설명해 주지는 않습니다. 분자 수준의 예측을 세포와 몸, 생활의 맥락으로 연결하는 다층적 모델과 실험이 필요합니다. 데이터 자체에도 한계가 있습니다. 특정 연령과 지역, 인구집단의 자료가 많고 다른 집단의 자료가 부족하면 AI는 누구에게는 잘 맞고 누구에게는 부정확할 수 있습니다. 실험실에서 얻은 자료가 실제 몸속의 복잡한 조건을 충분히 반영하지 못할 수도 있습니다. 정밀한 기술이 데이터의 편향을 그대로 학습하면 기존의 의료 격차를 확대할 위험이 있습니다. 앞으로의 생명 AI는 구조 데이터뿐 아니라 단일세포 분석과 조직 영상, 유전자 발현, 임상 기록, 시간에 따른 변화를 연결하려 할 것입니다. 그러나 데이터가 깊고 촘촘해질수록 개인정보 침해와 감시, 보험과 고용에서의 차별 가능성도 커집니다. 과학적 정밀성과 정보 보호는 함께 발전해야 합니다. 또 하나의 한계는 생명을 설명하는 비유에 있습니다. 우리는 DNA를 코드와 설계도에, 세포를 기계와 공장에, 단백질을 자물쇠와 열쇠에 비유합니다. 이러한 표현은 복잡한 현상의 한 측면을 선명하게 보여 주지만, 다른 측면을 가릴 수 있습니다.
DNA를 코드라고 부르면 정보의 중요성은 잘 드러나지만, 정보가 세포와 환경에 따라 다르게 실행되는 과정은 희미해집니다. 몸을 기계라고 부르면 부품의 기능은 잘 보이지만, 성장과 회복, 발달과 노화 같은 생명의 특징은 충분히 설명하기 어렵습니다. 열쇠와 자물쇠의 비유는 분자 결합을 보여 주지만, 결합하며 구조가 변하는 단백질의 유연성은 놓칠 수 있습니다. 따라서 생명을 이해하려면 여러 비유를 겹쳐 사용해야 합니다. DNA는 코드이면서 악보이고, 세포는 공장이면서 무대입니다. 단백질은 구조물이면서 움직이는 과정이고, 치료는 고장 난 기능을 조절하는 일이면서 환자의 삶을 돌보는 일이기도 합니다. 비유는 이해를 돕는 지도이지 현실 자체가 아닙니다. 좋은 설명은 비유가 무엇을 보여 주고 무엇을 감추는지 함께 밝힙니다.
탁월한 비유로 세계를 노래한 시인 이백
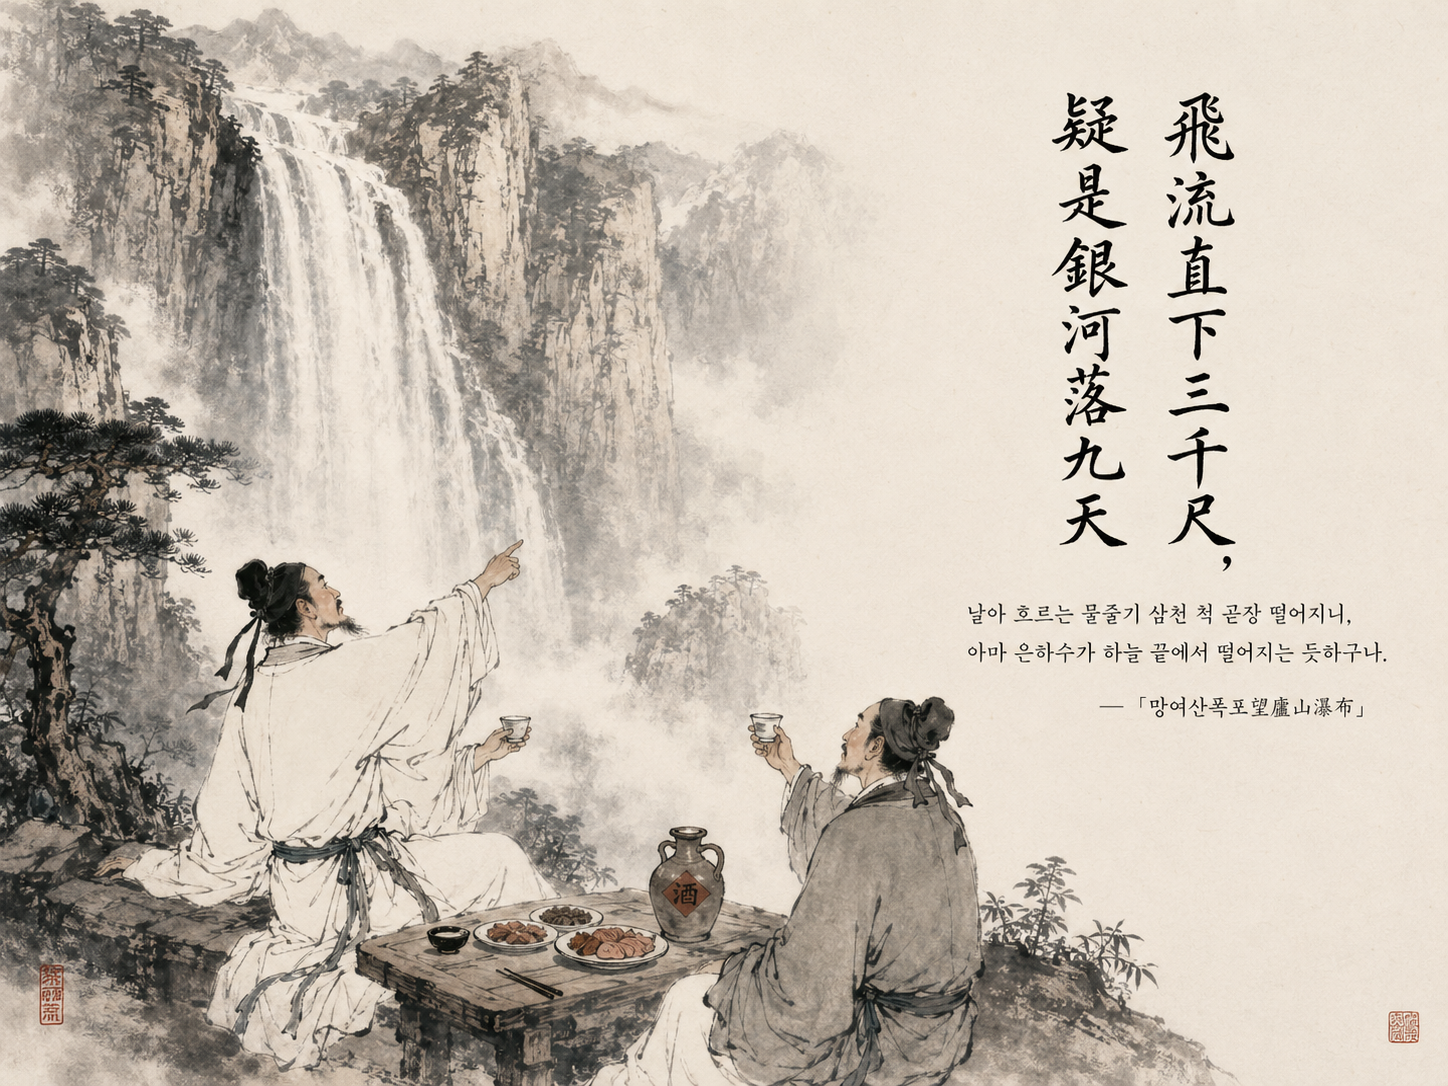
시인은 달을 술잔과 벗에 비유하지만, 달이 실제 술잔이나 사람이 되는 것은 아닙니다. 비유는 대상을 대신하지 않으면서도 이전에 보이지 않던 관계를 드러냅니다. 과학의 비유도 이와 같습니다. 생명을 코드나 연주에 비유하는 목적은 생명을 한 단어에 가두는 데 있지 않고, 복잡한 한 측면을 이해할 발판을 마련하는 데 있습니다. 생명 AI의 한계는 단순한 기술적 실패 목록이 아닙니다. 앞으로의 연구가 향해야 할 방향을 보여 주는 경계입니다. 분자의 정밀함을 몸 전체의 작용과 연결하고, 환경과 시간의 변화를 함께 읽으며, 그 결과를 환자의 삶 속에서 해석하는 것. 그것이 생명 AI가 넘어야 할 다음 지형입니다.
4.10 에필로그: 코드를 넘어 연주로 나아가다
알파폴드는 생명과학의 오래된 질문에 새로운 길을 열었습니다. 아미노산 서열에서 입체 구조를 예측하고, 여러 분자가 만나는 모습을 그려 냄으로써 생명 연구의 속도와 출발점을 바꾸었습니다. 구조가 밝혀질 때까지 기다리던 연구자는 이제 예측 구조를 바탕으로 더 구체적인 실험을 설계할 수 있습니다. 그러나 이 성취가 생명을 하나의 완성된 데이터로 바꾸어 놓은 것은 아닙니다. 단백질 구조는 생명의 중요한 장면이지만 전체 서사는 아닙니다. 단백질은 물속에서 흔들리고 다른 분자와 결합하며, 세포의 장소와 시간에 따라 서로 다른 기능을 수행합니다. 단백질 구조는 기능의 가능성을 열지만, 생명 활동은 그 가능성이 몸과 환경 속에서 실행되는 과정입니다.
이 장에서 우리는 생명을 세 층으로 읽었습니다. 즉 서열은 가능성을 기록하고, 접힘은 가능성에 형태를 주며, 상호작용은 그 형태를 기능으로 바꿉니다.
AI는 이 관계를 이전보다 빠르고 넓게 탐색합니다. 질병의 분자적 원인을 좁히고, 치료 후보와 새로운 단백질을 제안하며, 실험이 먼저 향할 곳을 알려 줍니다. 동시에 AI가 보는 생명은 데이터에 기록된 생명이라는 한계도 남습니다. 몸 전체의 반응과 시간의 변화, 환자의 경험과 생태계의 관계는 구조 예측 하나에 담기지 않습니다. 메리 셸리의 《프랑켄슈타인》이 남긴 질문은 생명을 만들 수 있는가보다, 만들어진 생명과 어떤 관계를 맺을 것인가에 가까웠습니다. 생명 설계의 힘이 커질수록 이 질문은 더욱 현실적이 됩니다. 창조의 능력은 곧 결과를 돌보고 책임질 의무를 동반합니다. 생명은 차가운 코드만도, 신비로운 힘만도 아닙니다. 수십억 년의 진화가 남긴 정보가 물과 열, 세포와 환경 속에서 끊임없이 접히고 펼쳐지는 물질적 질서입니다. DNA가 악보라면 단백질은 연주되는 음이며, 세포는 그 음들이 만나 서로를 바꾸는 무대입니다. AI는 이제 그 악보와 음의 관계를 읽는 새로운 눈을 제공했습니다. 그러나 음악의 의미는 악보의 정확성만으로 완성되지 않습니다. 생명 AI가 향해야 할 다음 단계는 코드를 더 많이 읽는 데서 더 나아가 코드가 언제, 어디서, 누구와 만나 하나의 삶으로 연주되는지를 이해하는 데 있습니다.
제5강. 물질을 설계하는 AI
대장간의 쇠는 불과 망치, 냉각 과정을 거치며 새로운 성질을 얻습니다. 같은 금속이라도 어떻게 달구고 두드리고 식히느냐에 따라 단단함과 질김이 달라집니다. 물질의 성질은 구성 원소만으로 정해지는 것이 아니라, 원자들이 배열된 방식과 그것을 가공한 조건에 따라 달라집니다. 오늘날 AI는 이 복잡한 물질의 세계를 탐색하는 새로운 도구가 되고 있습니다. 방대한 후보 가운데 원하는 성질을 지닐 가능성이 큰 물질을 찾아내고, 아직 만들어지지 않은 구조와 조합을 제안합니다. 이번 강에서는 AI가 물질을 어떻게 이해하고 탐색하며, 새로운 재료의 설계에 어떻게 활용되는지 살펴보겠습니다.
5.1 현대 문명은 물질 위에 세워져 있다
스마트폰을 손에 쥐면 우리는 먼저 화면과 앱을 봅니다. 그러나 그 얇은 기계 안에는 강화유리, 반도체, 배터리, 자석, 접착제, 방열 소재가 빽빽하게 들어 있습니다. 말하자면 스마트폰은 손바닥 위의 작은 문명이자, 재료과학의 종합선물세트입니다. 도시의 엘리베이터도 마찬가지입니다. 버튼 하나로 수십 층을 오르내리는 일상은 강철 케이블, 모터, 브레이크, 센서, 전력 장치가 충분한 하중과 반복 사용을 견딜 때에만 가능합니다. 현대 문명의 편리함은 생각보다 훨씬 물질적입니다. 기후위기와 에너지 전환도 결국 재료의 문제와 맞닿아 있습니다. 전기차는 더 많은 에너지를 저장하고 더 빨리 충전되며, 오래 써도 성능이 떨어지지 않는 배터리를 필요로 합니다. 태양전지, 반도체, 수소 생산 촉매, 탄소 포집 장치 역시 더 효율적이고 오래가며 환경 부담이 낮은 물질을 요구합니다. 좋은 구호만으로는 전기가 흐르지 않습니다. 친환경 기술도 결국 안전하고 값싸고 오래가는 재료를 만나야 현실이 됩니다. AI가 재료과학에 들어오는 이유가 바로 여기에 있습니다. 새로운 물질을 찾는 일은 가능한 조합이 너무 많습니다. 어떤 원소를 섞을지, 비율을 어떻게 할지, 원자를 어떤 구조로 배열할지, 어떤 온도와 압력에서 만들지에 따라 전혀 다른 물질이 나옵니다. 이 모든 후보를 사람이 하나씩 만들고 시험한다면 연구실은 금세 거대한 요리 경연장이 될 것입니다. 문제는 심사위원보다 재료 조합이 훨씬 많다는 데 있습니다. AI는 이 넓은 가능성의 바다에서 먼저 지도를 그립니다. 이미 축적된 계산 결과와 실험 데이터를 학습해, 구조와 성질 사이의 관계를 찾아냅니다. 그런 다음 전기를 잘 통할 물질, 열에 강한 물질, 에너지를 효율적으로 저장할 물질처럼 원하는 조건에 가까운 후보를 먼저 제안합니다. 연구자는 모든 가능성을 무작정 뒤지는 대신, 성공 가능성이 높은 영역부터 계산하고 합성하고 검증할 수 있습니다. AI는 재료과학에서 ‘찍기’의 시대를 끝내고, ‘유망한 곳부터 파기’의 시대를 열고 있는 셈입니다.
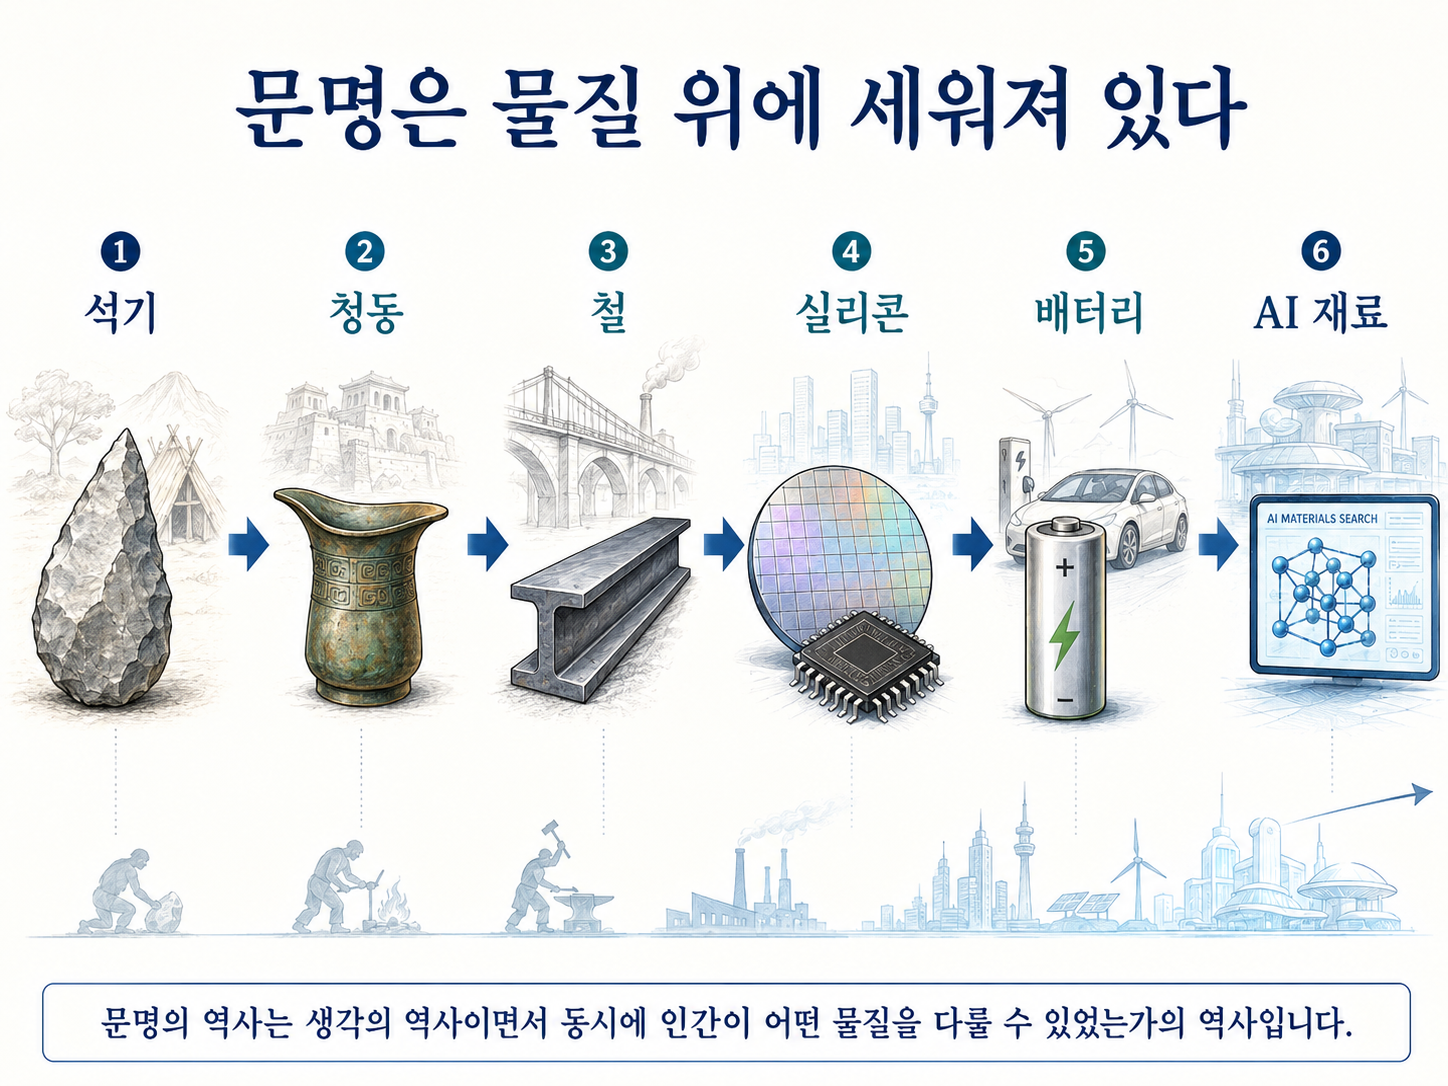
물론 AI가 제안했다고 곧바로 쓸 수 있는 재료가 되는 것은 아닙니다. 계산상 안정적인 구조라도 실제로 합성하기 어려울 수 있고, 실험실에서는 뛰어나도 공장에서 대량 생산하기 힘들 수 있습니다. 성능이 좋아도 원료가 희귀하거나 비싸고, 독성이 크거나 재활용하기 어렵다면 좋은 재료라고 말하기 어렵습니다. 현실의 재료는 성능표 하나로 평가되지 않습니다. 안전성, 내구성, 생산 비용, 자원 공급, 환경 영향까지 함께 견뎌야 합니다. 디지털 기술도 이 물질적 기반에서 벗어나지 않습니다. 클라우드는 이름은 구름이지만, 실제로는 데이터센터의 반도체와 저장 장치, 전력망과 냉각 설비 위에 떠 있습니다. 인공지능 역시 고성능 칩, 통신망, 전기, 물을 필요로 합니다. 화면 속에서 가볍게 움직이는 디지털 세계 뒤에는 언제나 무겁고 뜨거운 물질과 에너지의 세계가 놓여 있습니다. 인류의 역사는 어떤 물질을 발견하고 다룰 수 있었는가에 따라 달라져 왔습니다. 돌, 청동, 철, 석탄, 석유, 실리콘은 단순한 자원이 아니라 각 시대의 생활 방식과 산업 구조를 바꾼 기반이었습니다. 이제 재료과학은 자연에 이미 있는 물질을 찾아 쓰는 단계를 넘어, 원하는 성질을 지닌 물질을 원자 수준에서 탐색하고 설계하는 방향으로 나아가고 있습니다. AI는 이 과정에서 우연한 발견을 대신하는 것이 아니라, 방대한 가능성 속에서 더 빨리, 더 넓게, 더 똑똑하게 길을 찾도록 돕습니다. 따라서 재료 AI는 일부 연구자만의 전문 기술이 아닙니다. 그것은 어떤 배터리를 쓸 것인지, 어떤 반도체를 만들 것인지, 어떤 에너지 체계로 전환할 것인지, 한정된 자원과 환경 비용을 어떻게 나눌 것인지와 연결됩니다. 새로운 물질을 찾는 일은 문명의 기술적 선택지를 넓히는 일이며, 동시에 우리가 어떤 사회를 만들 것인가를 결정하는 일이기도 합니다.
5.2 원자, 결합, 결정: 물질의 문법
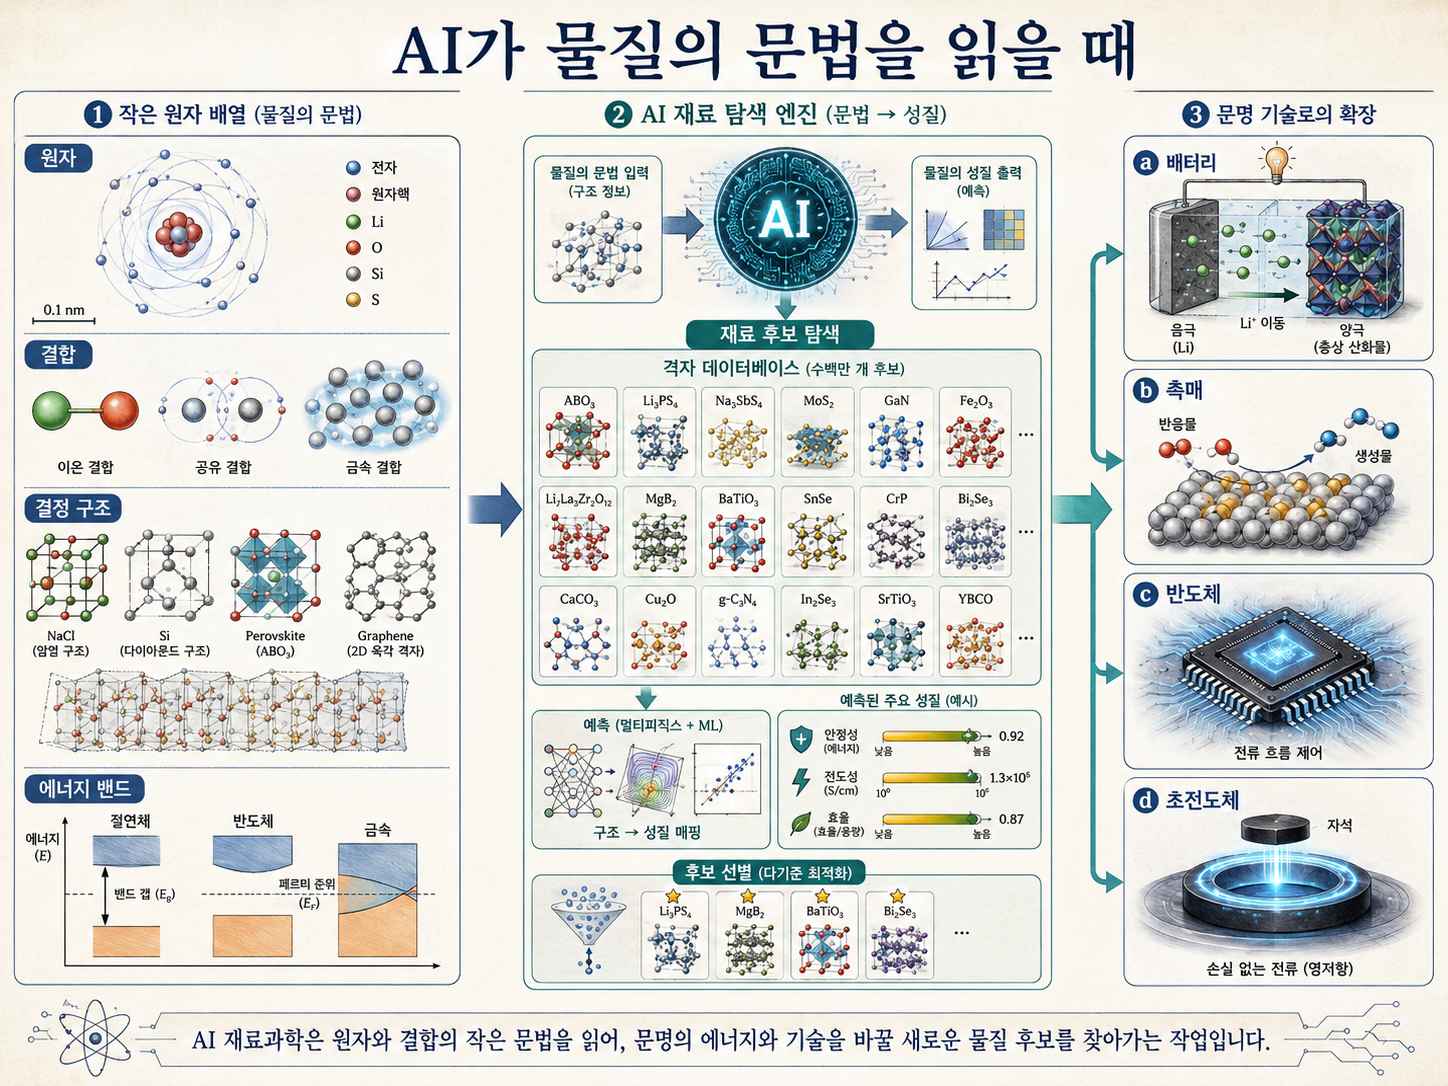
글자는 같아도 배열이 달라지면 전혀 다른 문장이 됩니다. 물질도 마찬가지입니다. 어떤 원자들이 모였는가뿐 아니라, 그 원자들이 어떻게 결합하고 어떤 구조로 배열되었는가에 따라 성질이 달라집니다. 탄소 원자로 이루어졌다는 점은 같아도, 원자의 배열에 따라 단단하고 투명한 다이아몬드가 되기도 하고, 부드럽고 전기가 통하는 흑연이 되기도 합니다. 원자는 물질의 글자이고, 결합은 글자를 잇는 문법이며, 결정 구조는 그 문법으로 완성된 문장이라고 할 수 있습니다. 재료과학에서 중요한 일은 바로 이 문법을 읽는 것입니다. 원자 사이의 거리, 결합의 방향, 반복되는 결정 구조가 조금만 달라져도 강도, 전기 전도성, 열전도율, 투명도, 자성 같은 성질이 크게 바뀝니다. 공유 결합은 원자들이 전자를 함께 쓰며 강하고 방향성 있는 구조를 만들고, 이온 결합은 양전하와 음전하의 끌림으로 형성되며, 금속 결합에서는 전자들이 여러 원자 사이를 비교적 자유롭게 움직입니다. 물질의 성질은 개별 원자의 특징만으로 정해지지 않고, 원자와 결합과 배열이 함께 만든 전체 구조에서 나타납니다.
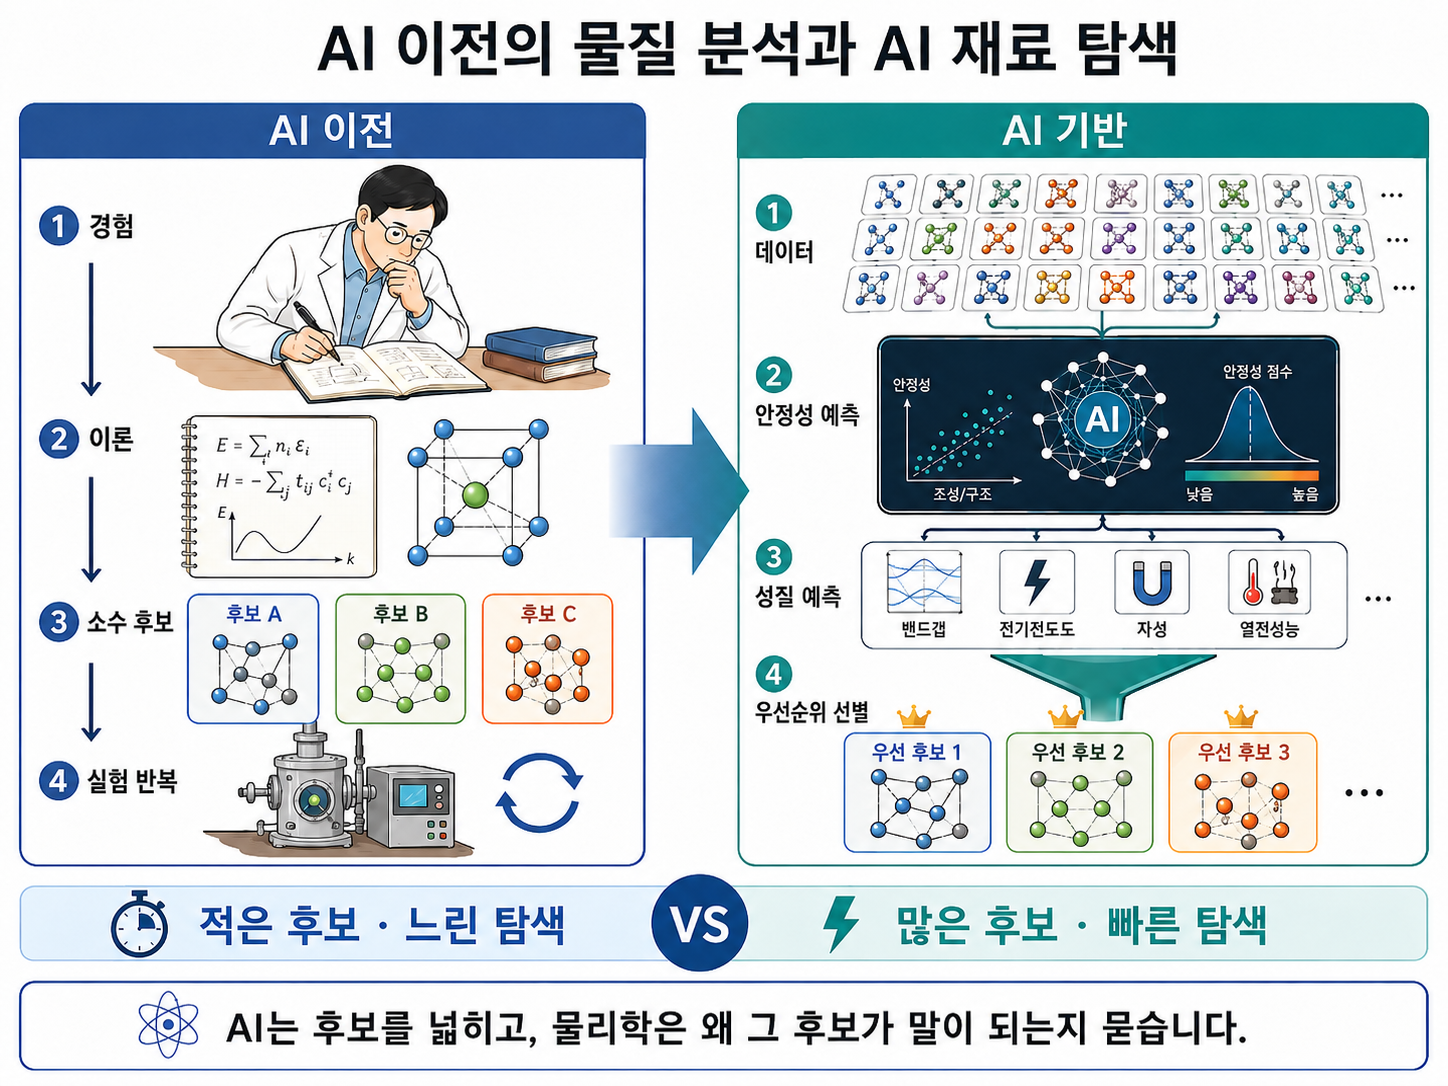
AI는 이 복잡한 물질의 문법을 배우는 데 쓰입니다. 이미 축적된 실험 자료와 계산 결과를 학습해, 어떤 원소 조합이 안정한 구조를 이룰 가능성이 큰지, 어떤 결정 배열이 전기나 열을 잘 전달할지, 원하는 성질을 얻으려면 어떤 구성을 먼저 살펴보아야 할지를 예측합니다. 사람이 모든 조합을 하나씩 만들어 시험한다면 연구실은 곧 원자들의 끝없는 조립식 장난감 창고가 될 것입니다. AI는 그 창고 전체를 뒤지는 대신, 먼저 열어볼 만한 상자부터 골라주는 역할을 합니다. 물론 AI가 제안한 물질이 곧바로 쓸 수 있는 재료가 되는 것은 아닙니다. 물질의 문법은 아무 조합이나 허용하지 않습니다. 어떤 원자 배열은 에너지가 너무 높아 안정적으로 존재하기 어렵고, 어떤 구조는 계산상 가능해도 실제 조건에서는 합성되지 않을 수 있습니다. 뛰어난 성질을 보이더라도 지나치게 높은 압력이나 온도에서만 만들어진다면 실용적인 재료가 되기 어렵습니다. 재료 설계는 가능한 구조를 찾는 일인 동시에, 현실에서 만들고 오래 유지할 수 있는 구조를 찾는 일입니다. AI의 예측에도 한계가 있습니다. 학습 자료가 풍부한 물질과 원소 조합은 비교적 잘 예측할 수 있지만, 거의 연구되지 않은 영역에서는 신뢰도가 낮아질 수 있습니다. 모델은 주어진 데이터에서 규칙을 배우기 때문에 기존 자료의 편향과 빈틈도 함께 물려받습니다. 또한 실제 물질은 교과서 속 그림처럼 완벽한 결정만으로 이루어지지 않습니다. 원자가 빠진 자리, 다른 원자가 끼어든 자리, 배열이 어긋난 경계와 미세한 균열 같은 결함이 존재합니다. 이런 결함은 성능을 떨어뜨리기도 하지만, 때로는 전기 전도성이나 촉매 기능처럼 유용한 성질을 만들어내기도 합니다.
따라서 AI는 재료과학자의 직관과 실험을 대신하기보다, 탐색의 범위를 넓히는 도구입니다. AI가 유망한 후보를 제안하면 연구자는 그 구조가 왜 안정한지, 전자들이 어떻게 움직이는지, 결함과 온도가 성질에 어떤 영향을 주는지 해석해야 합니다. 이어 실제 물질을 합성하고 측정해 예측이 현실에서도 성립하는지 확인해야 합니다. 결국 AI는 물질의 문법을 읽고, 아직 쓰이지 않은 문장을 제안하는 새로운 조력자입니다. 그러나 좋은 문장이 문법만으로 완성되지 않듯, 좋은 재료도 예측만으로 완성되지 않습니다. 무엇을 위해 사용할 것인지, 실제로 만들 수 있는지, 안전하고 지속 가능하게 쓸 수 있는지까지 검증될 때, AI가 제안한 물질의 문법은 비로소 문명의 언어가 됩니다.
5.3 에너지 밴드와 반도체
어두운 극장의 좌석을 떠올려 보겠습니다. 좌석이 꽉 차 있으면 관객이 움직이기 어렵지만, 빈자리가 가까이 있으면 자리를 옮길 수 있습니다. 물질 속 전자도 이와 비슷합니다. 전자는 아무 곳에나 머물거나 아무 에너지로나 움직일 수 없습니다. 머물 수 있는 에너지의 범위가 정해져 있고, 그 사이에는 전자가 머물 수 없는 빈 구간도 있습니다. 전자가 머물 수 있는 에너지의 범위를 에너지 밴드, 그 사이의 빈 구간을 밴드갭이라고 부릅니다.
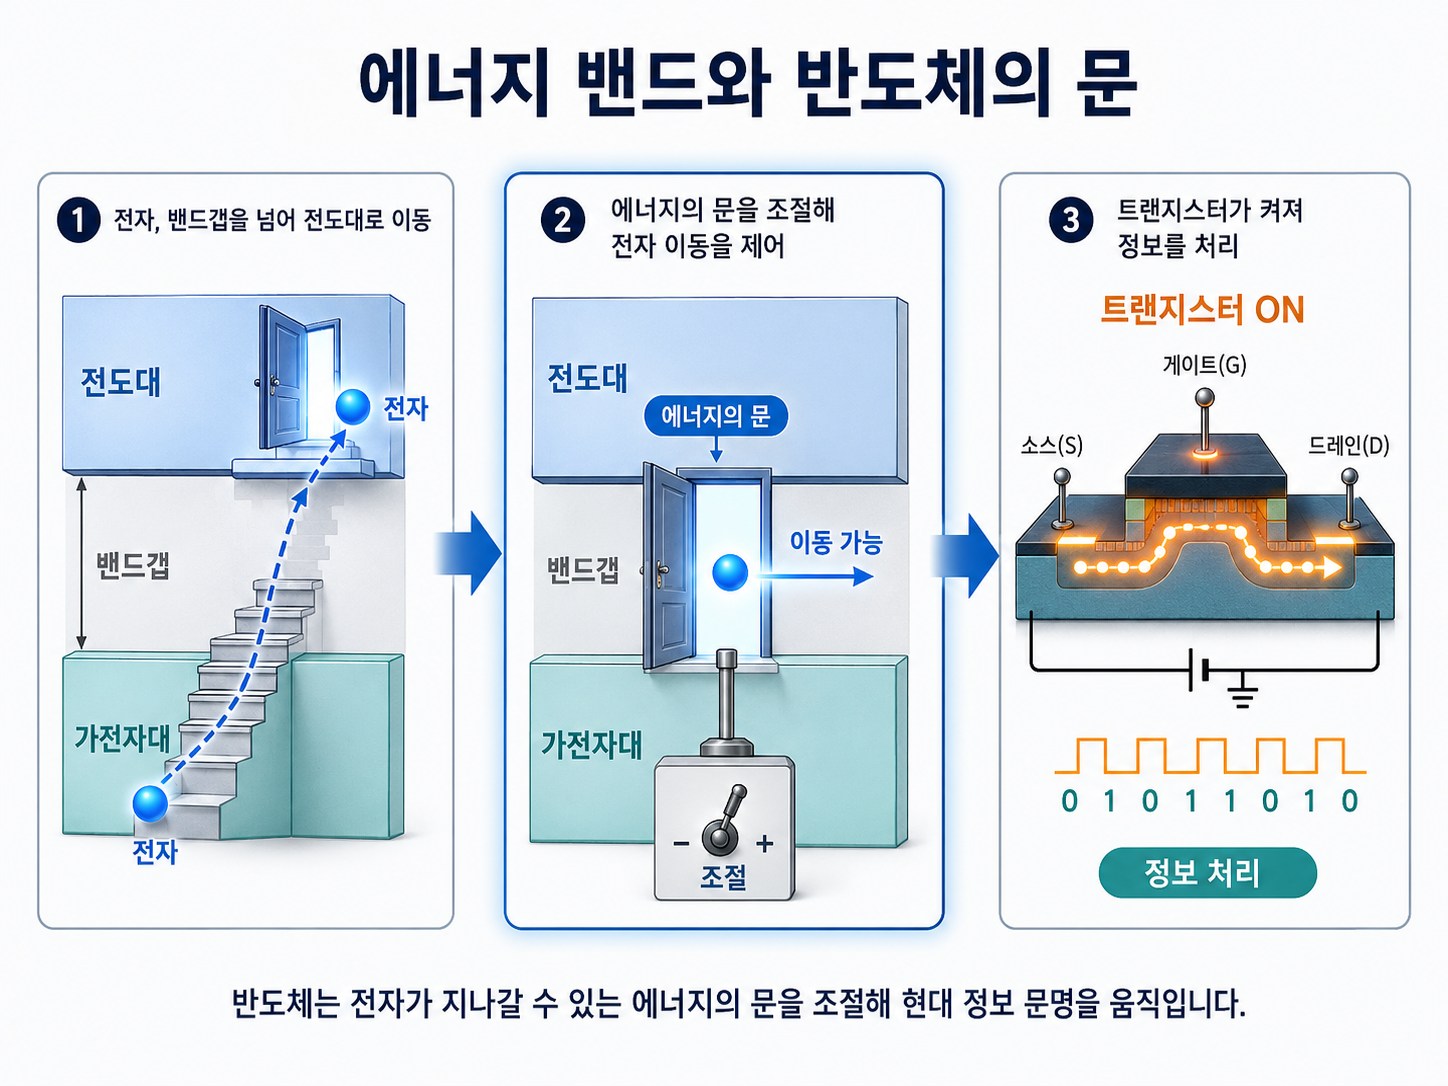
금속과 절연체, 반도체의 차이는 이 ‘전자 좌석표’가 어떻게 짜여 있는가에서 생깁니다. 금속은 전자가 옮겨 갈 수 있는 자리가 가까이 있어 전기가 잘 흐릅니다. 절연체는 전자가 움직이려면 큰 에너지가 필요하기 때문에 전류가 거의 흐르지 않습니다. 반도체는 그 중간에 있습니다. 평소에는 전기가 잘 흐르지 않지만, 열이나 빛을 받거나 아주 적은 양의 다른 원소를 넣으면 전자의 이동을 조절할 수 있습니다. 반도체의 핵심은 바로 이 조절 가능성입니다. 전자의 흐름을 켜고 끌 수 있기 때문에 반도체는 정보를 처리하는 미세한 스위치가 됩니다. 이 성질을 조절하는 대표적 방법이 도핑입니다. 순수한 실리콘에 아주 적은 양의 다른 원소를 넣으면 움직일 수 있는 전자가 늘어나거나, 전자가 비어 있는 자리인 정공이 생깁니다. 극장 비유로 말하면, 움직일 관객을 더 넣거나 관객이 옮겨 갈 빈자리를 만드는 셈입니다. 전자와 정공의 흐름을 정교하게 조절하면 전류의 방향과 크기를 다룰 수 있고, 이 원리가 스마트폰과 컴퓨터의 연산 장치, 메모리, 통신 장비를 움직입니다.
반도체는 전기를 제어하는 데만 쓰이지 않습니다. 전자가 낮은 에너지 자리에서 높은 자리로 올라가거나 다시 내려올 때 빛을 흡수하거나 내보낼 수 있습니다. 이 때문에 반도체는 태양전지, 발광다이오드, 레이저, 광센서에도 쓰입니다. 어떤 물질이 어떤 빛을 잘 흡수하고 방출하는지는 밴드갭의 크기와 전자의 움직임에 따라 달라집니다. 결국 반도체는 전기와 빛 사이의 번역기이기도 합니다. AI가 반도체 재료 연구에 중요한 이유는 여기에 있습니다. 반도체 후보 물질은 너무 많습니다. 원소 조합, 원자 배열, 결정 구조, 불순물의 종류와 양이 조금만 달라져도 전자의 움직임은 달라집니다. 사람이 이 모든 조합을 하나씩 만들고 시험한다면, 연구실은 전자들의 끝없는 좌석 배치표를 밤새 넘기는 곳이 될 것입니다. AI는 이미 축적된 실험 자료와 계산 결과를 학습해, 어떤 구조가 원하는 전기적·광학적 성질을 가질 가능성이 큰지 먼저 가려냅니다.
따라서 AI는 더 적은 전력으로 작동하는 물질, 높은 온도와 전압을 견디는 물질, 특정한 빛을 잘 흡수하거나 방출하는 물질을 방대한 후보 가운데서 빠르게 제안할 수 있습니다. 연구자는 모든 가능성을 무작정 시험하는 대신, AI가 좁혀준 유망한 후보를 계산하고 합성하고 검증할 수 있습니다. AI는 반도체 연구에서 정답을 대신 내리는 심판이 아니라, 넓은 가능성의 숲에서 먼저 길을 비춰주는 탐색등에 가깝습니다. 그러나 좋은 밴드 구조를 가졌다는 이유만으로 곧바로 좋은 반도체가 되는 것은 아닙니다. 계산상으로는 훌륭해 보여도 실제로 합성하기 어렵거나, 얇고 균일한 막으로 만들기 힘들 수 있습니다. 결정 속의 작은 결함과 불순물은 전자의 흐름을 방해하기도 하지만, 때로는 필요한 전기적 성질을 만들어내기도 합니다. 열, 습기, 반복 작동도 재료의 성능을 떨어뜨릴 수 있습니다. 반도체는 칠판 위의 공식이 아니라 공장 안에서 수없이 반복되어야 하는 물질입니다.
그래서 AI가 반도체를 설계한다는 말은 원하는 밴드갭을 가진 물질을 찾는 데서 끝나지 않습니다. 실제로 만들 수 있는지, 기존 제조 공정에 적용할 수 있는지, 오래 안정적으로 작동하는지, 원료를 충분히 확보할 수 있는지까지 함께 보아야 합니다. 반도체 기술은 양자역학의 법칙, 공장의 생산 조건, 자원과 비용이 한자리에서 만나는 분야입니다. 반도체를 이해하는 일은 AI 자체의 물질적 기반을 이해하는 일이기도 합니다. 오늘날의 AI는 거대한 계산을 수행하고, 그 계산은 모두 반도체 칩 위에서 이루어집니다. 칩의 속도와 에너지 효율이 개선되지 않으면 AI도 전력, 발열, 비용이라는 물리적 한계에 부딪힙니다. 흥미롭게도 AI는 반도체 위에서 작동하면서, 다시 더 좋은 반도체 재료를 찾는 데 쓰입니다. AI가 자기 발밑의 바닥재를 더 튼튼하게 고르는 셈입니다.
하지만 이 순환에는 책임도 따릅니다. 더 많은 계산은 더 많은 칩과 전력을 요구하고, 반도체 생산에는 고순도 원료, 물, 에너지, 복잡한 화학 공정이 필요합니다. 일부 재료는 공급 지역이 제한되어 있고, 채굴과 폐기 과정에서 환경 부담을 낳을 수도 있습니다. 그러므로 차세대 반도체의 목표는 단순히 더 빠른 성능에만 있을 수 없습니다. 더 적은 에너지와 자원으로 오래 사용할 수 있는 재료를 찾는 일도 함께 중요해집니다. 결국 반도체는 전자의 이동을 정교하게 설계한 물질입니다. 어느 에너지 자리를 허용하고, 전자가 얼마나 쉽게 움직이도록 할 것인지에 따라 정보 처리의 속도와 전력 소비가 달라집니다. AI는 이 복잡한 설계 가능성을 빠르게 비교하고 유망한 후보를 찾아줍니다. 작은 전자의 이동 경로를 어떻게 설계하느냐가 디지털 문명 전체의 성능과 에너지 사용을 좌우하는 시대가 된 것입니다.
5.4 배터리와 촉매: 에너지 전환의 핵심
좋은 배터리는 단순히 에너지를 많이 담는 장치가 아닙니다. 많이 저장해야 하고, 빠르게 충전되어야 하며, 오래 써도 성능이 쉽게 떨어지지 않아야 합니다. 무엇보다 안전해야 합니다. 많이 담기는 하지만 쉽게 과열되거나 불이 난다면 좋은 배터리라고 할 수 없습니다. 리튬이온 배터리에서는 충전과 방전 과정에서 리튬 이온이 두 전극 사이를 오갑니다. 이온이 잘 오가려면 길이 막히지 않아야 하고, 전극 재료는 그 움직임을 반복해서 견뎌야 합니다. 이온이 지나는 통로가 불안정하거나 전극 구조가 쉽게 무너지면 배터리의 성능과 수명은 떨어집니다. 그래서 배터리는 하나의 물질로 된 저장통이 아니라, 양극과 음극, 전해질(electrolyte), 분리막, 계면이 함께 작동하는 작은 화학 시스템입니다.
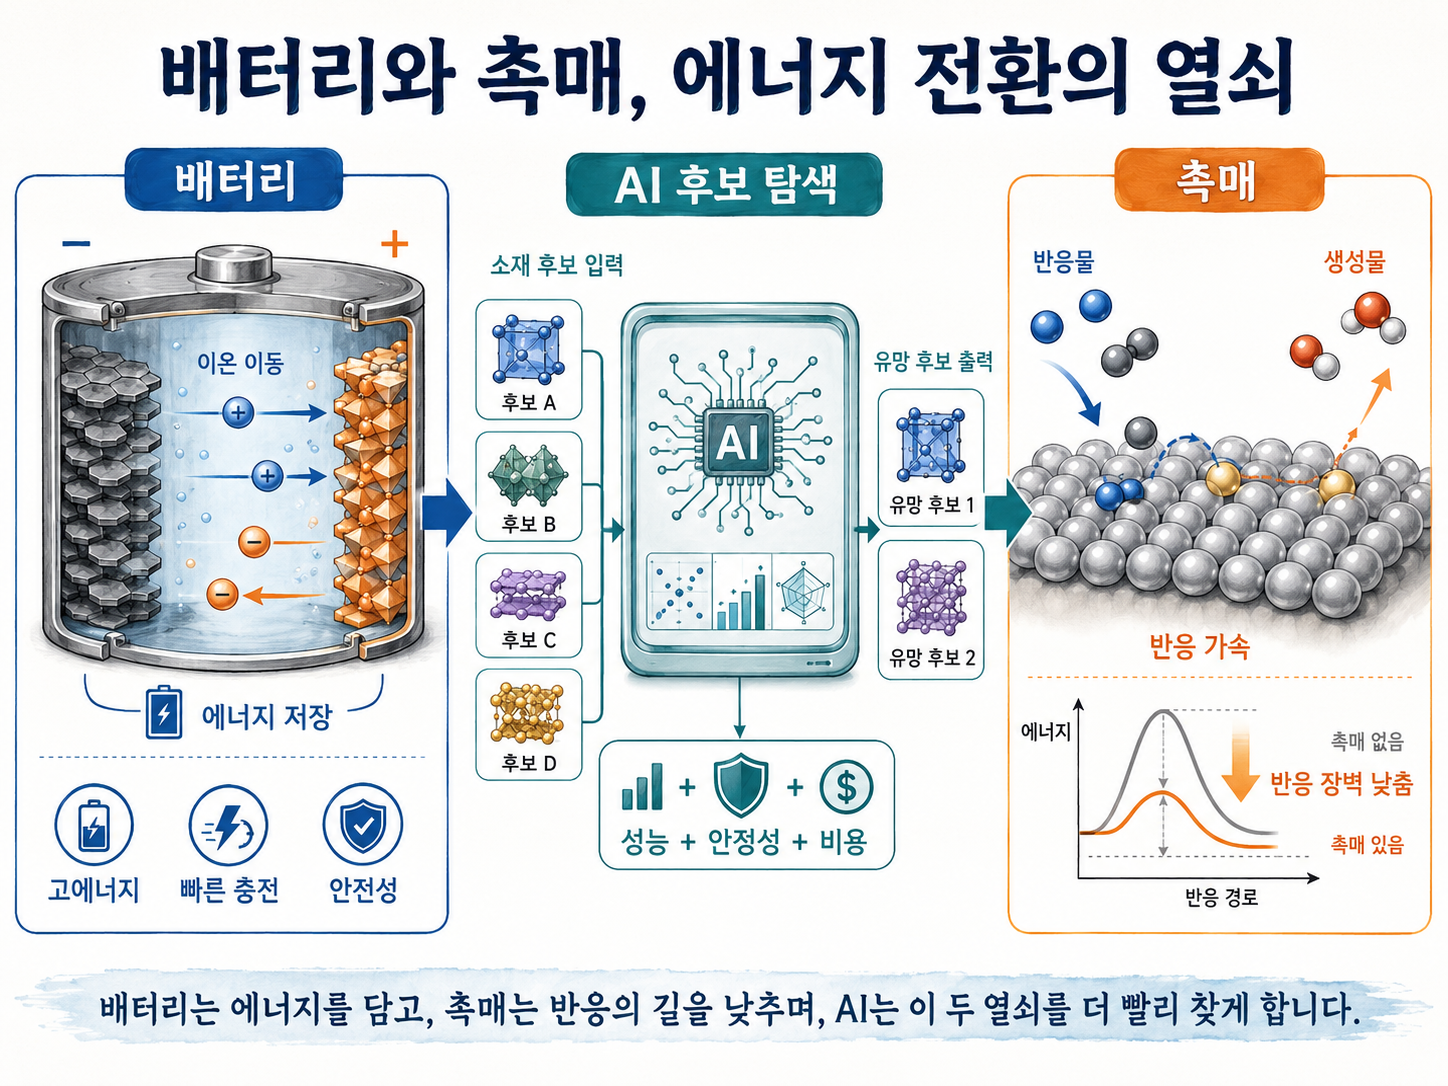
촉매(catalyst)는 에너지를 저장하는 장치는 아니지만, 에너지 전환에서 배터리만큼 중요합니다. 어떤 화학반응은 가능하더라도 그냥 두면 너무 느리게 일어납니다. 촉매는 그 반응이 더 쉽게 일어나도록 낮은 길을 열어 줍니다. 높은 산을 정면으로 넘는 대신 낮은 고갯길을 찾아주는 셈입니다. 물을 분해해 수소를 만들거나, 연료전지에서 전기를 생산하거나, 이산화탄소를 유용한 물질로 바꾸는 과정에서 촉매가 중요한 이유가 여기에 있습니다. 배터리와 촉매는 역할은 다르지만 공통점이 있습니다. 둘 다 에너지와 물질의 흐름을 다룹니다. 배터리는 이온과 전자의 이동을 조절해 에너지를 저장하고 꺼내 쓰며, 촉매는 화학반응이 지나가는 경로를 바꾸어 에너지 전환을 빠르게 합니다. 결국 핵심은 어디에서 흐름이 막히는지, 어디에서 에너지가 낭비되는지, 어떤 재료가 그 문제를 줄일 수 있는지 찾는 일입니다.
AI는 바로 이 탐색 과정에서 중요한 역할을 합니다. 좋은 배터리나 촉매 후보를 찾으려면 원소의 조합, 원자의 배열, 표면 구조, 결함, 합성 조건까지 수많은 가능성을 살펴야 합니다. 사람이 모든 후보를 하나씩 만들고 시험하기에는 시간과 비용이 너무 큽니다. AI는 축적된 실험 자료와 계산 결과를 학습해, 어떤 전극 구조가 이온 이동에 유리한지, 어떤 전해질이 안정한지, 어떤 촉매 표면이 반응의 에너지 장벽을 낮출 가능성이 큰지 먼저 예측합니다. 이때 AI는 실험을 대신하는 존재가 아닙니다. AI는 먼저 살펴볼 후보를 좁혀 주는 탐색 지도에 가깝습니다. 연구자는 AI가 제안한 후보를 실제로 합성하고, 충전 속도와 수명, 안전성, 반응 효율과 내구성을 측정합니다. 말하자면 AI는 정답을 확정하는 심판이 아니라, 제한된 시간과 비용 안에서 더 의미 있는 실험을 고르게 해주는 조력자입니다.
이러한 접근을 보여주는 대표적 사례가 구글 딥마인드(Google DeepMind)의 그놈 AI(GNoME AI)입니다. 그놈 AI는 이미 알려진 물질 자료와 계산 결과를 바탕으로, 안정적으로 존재할 가능성이 큰 새로운 결정 구조를 대규모로 예측한 사례입니다. 2023년 구글 딥마인드는 이 시스템을 통해 38만 개의 안정적인 재료 후보를 포함해 220만 개의 새로운 결정 구조를 예측했다고 밝혔습니다. 이 성과는 AI가 새 배터리나 새 촉매를 곧바로 완성했다는 뜻이 아닙니다. 더 중요한 의미는 방대한 가능성의 공간에서 어디부터 살펴볼지 알려주는 지도를 만들었다는 데 있습니다.
광활한 자연에서 최적의 후보를 찾다
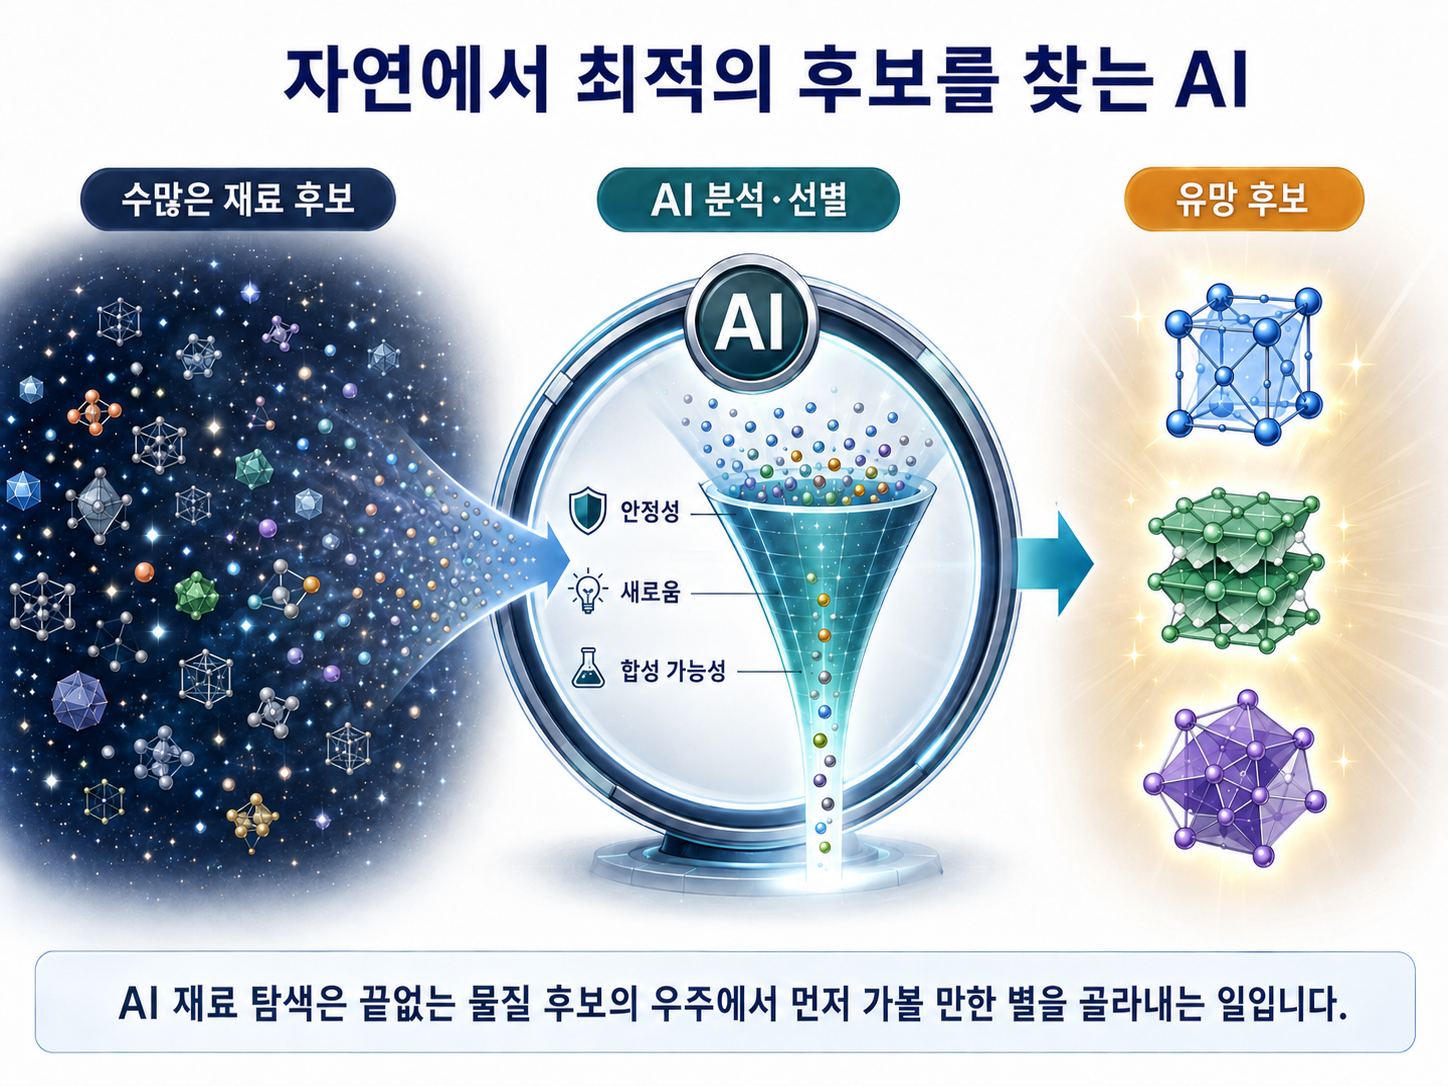
그러나 좋은 후보가 곧 좋은 재료가 되는 것은 아닙니다. 배터리는 에너지를 많이 저장하면서도 빠르게 충전되고, 오래가고, 안전해야 합니다. 촉매는 반응을 빠르게 하면서도 쉽게 변하지 않고, 값싸고 안정적으로 만들 수 있어야 합니다. 성능이 좋아도 원료가 희귀하거나 비싸고, 독성이 크거나 재활용이 어렵다면 널리 쓰기 어렵습니다. AI가 제안한 후보는 반드시 합성 가능성, 제조 비용, 내구성, 안전성, 공급망을 함께 통과해야 합니다. 따라서 배터리와 촉매 분야에서 AI의 핵심 역할은 만능 해결사가 되는 데 있지 않습니다. AI는 수많은 후보 가운데 가능성이 높은 방향을 먼저 보여주고, 실패할 가능성이 큰 조합을 줄이며, 실험의 우선순위를 정하는 데 도움을 줍니다. 에너지 전환의 속도는 새로운 재료를 얼마나 빠르고 정확하게 찾느냐에 달려 있습니다. AI는 바로 그 탐색의 속도와 범위를 넓히는 도구입니다.
5.5 에이랩과 자동화 실험실
좋은 빵을 만들려면 밀가루와 물의 비율, 반죽 온도, 발효 시간을 조금씩 바꾸어 보아야 합니다. 재료 실험도 비슷합니다. 어떤 원소를 섞을지뿐 아니라, 몇 도에서 얼마나 가열할지, 어떤 압력과 기체 조건을 줄지, 얼마나 빨리 식힐지에 따라 전혀 다른 물질이 만들어질 수 있습니다. 새로운 물질을 찾는 일은 재료의 목록을 고르는 일이면서, 동시에 그 물질을 만들어내는 ‘조리법’을 찾는 일입니다. 이 반복 과정을 AI와 로봇, 센서로 빠르게 수행하려는 시도가 자동화 실험실입니다. 대표적 사례가 에이랩(A-Lab)입니다. 에이랩은 AI가 기존 연구 자료와 실험 결과를 바탕으로 유망한 물질과 합성 조건을 제안하면, 로봇이 원료를 계량하고 섞고 가열한 뒤, 만들어진 시료의 구조와 성질을 측정하는 방식으로 작동합니다. 측정 결과는 다시 AI에 전달되고, AI는 그 결과를 반영해 다음 실험을 선택합니다.
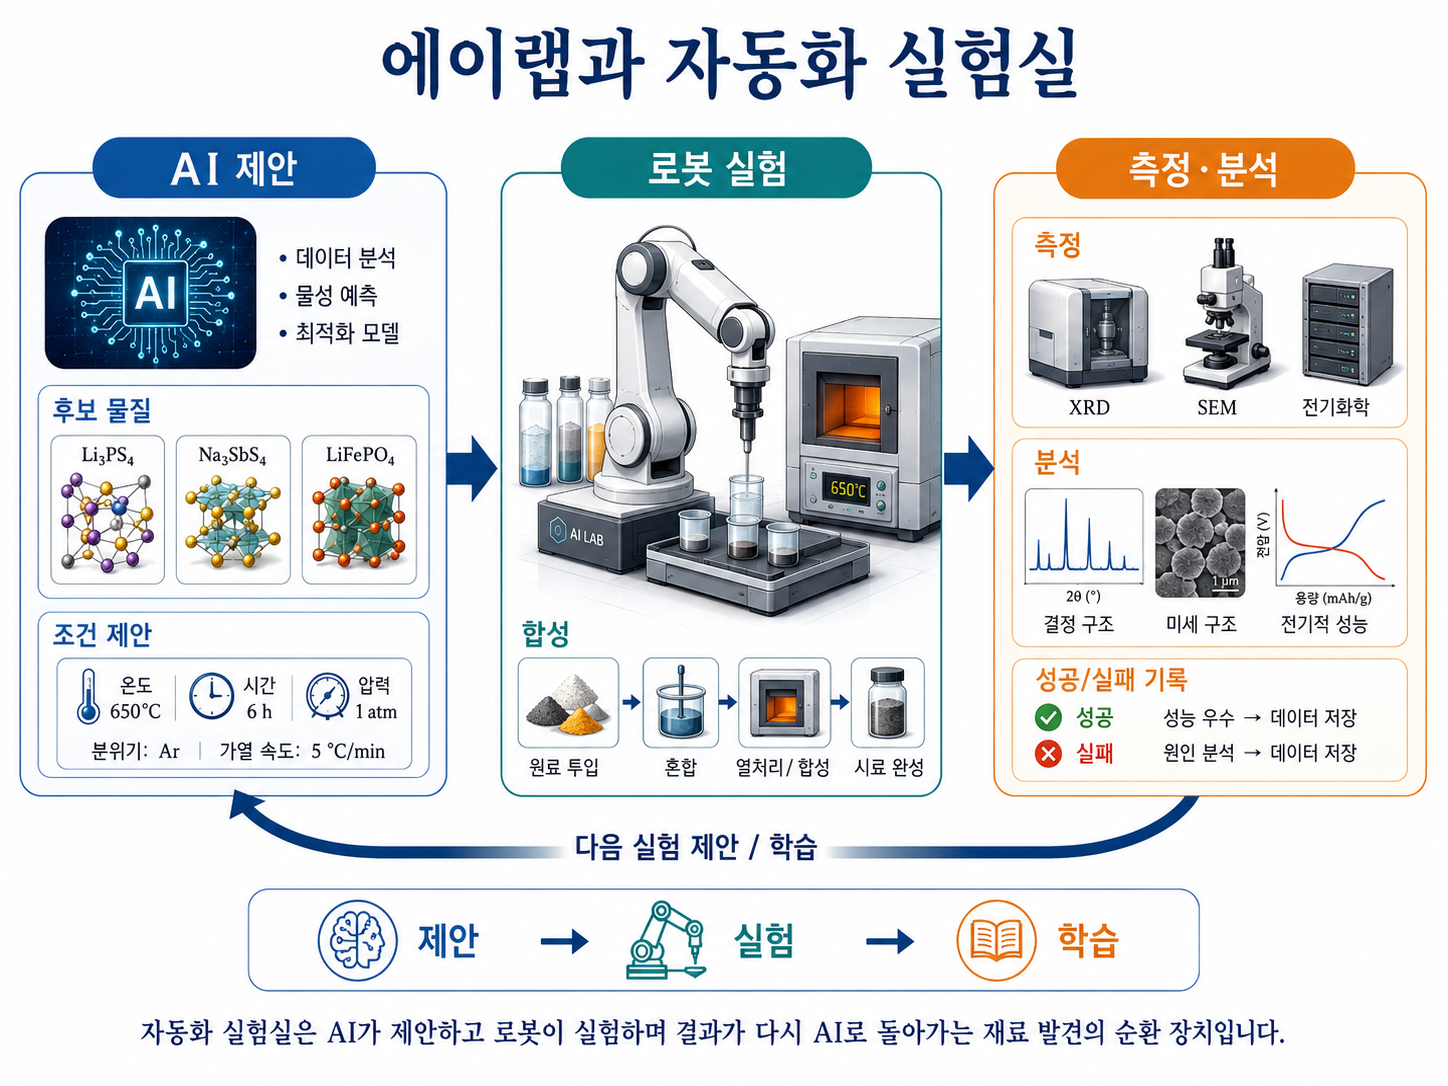
핵심은 단순한 자동 반복이 아닙니다. 자동화 실험실에서는 예측, 합성, 측정, 학습이 하나의 순환으로 이어집니다. 실험 결과가 기대와 다르면 AI는 그 차이를 배우고, 다음에는 온도나 조성, 합성 순서를 바꾸어 봅니다. 연구자가 모든 조합을 미리 정해 놓고 차례로 시험하는 것이 아니라, 결과에 따라 탐색 방향이 계속 조정되는 것입니다. 자동화의 장점은 속도만이 아닙니다. 사람이 감당하기 어려운 수많은 조건을 일정한 방식으로 반복하고, 작은 차이까지 정확하게 기록할 수 있습니다. 밤낮없이 실험을 이어갈 수도 있고, 같은 절차를 여러 번 반복해 결과의 신뢰성을 확인하기도 쉽습니다. 특히 재료 연구처럼 가능한 조합이 많은 분야에서는, 어떤 후보를 먼저 실험할지 정하는 일 자체가 중요한 과학적 판단이 됩니다.
하지만 AI와 로봇이 실험한다고 해서 과학자의 역할이 사라지는 것은 아닙니다. 오히려 무엇을 목표로 삼을 것인지가 더 중요해집니다. 가장 안정한 물질을 찾을 것인지, 전기가 잘 통하는 물질을 찾을 것인지, 값싸고 독성이 낮은 물질을 찾을 것인지에 따라 실험의 방향은 달라집니다. 목표를 좁게 잡으면 AI는 그 목표를 빠르게 추구하겠지만, 안전성이나 비용, 생산 가능성을 놓칠 수 있습니다. 실패한 실험을 기록하는 일도 중요합니다. 원하는 물질이 만들어지지 않았다는 결과는 단순한 낭비가 아닙니다. 특정 온도에서는 결정이 형성되지 않았고, 어떤 조합에서는 불순물이 생겼다는 사실은 다음 탐색에서 피해야 할 길을 알려 줍니다. 성공한 결과만 남기면 AI는 실제보다 좁고 편향된 세계를 배우게 됩니다. 자동화 실험실에서 실패는 버려지는 결과가 아니라, 가능성의 지도를 더 정밀하게 만드는 데이터입니다.
따라서 자동화 실험실의 성패는 장비의 속도만으로 결정되지 않습니다. 몇 도에서 몇 분 동안 가열했는지, 어떤 기체 속에서 반응시켰는지, 어느 속도로 냉각했는지처럼 실험 조건이 정확하게 기록되어야 합니다. 데이터 형식이 정리되어야 다른 실험실의 결과와도 비교할 수 있습니다. AI가 잘 배우려면 실험도 기계가 읽을 수 있는 언어로 남아야 합니다. 이 과정에서 과학자는 모든 실험을 손으로 반복하는 사람에서, 탐색의 목표와 범위를 설계하는 사람으로 역할이 바뀝니다. 어떤 결과를 신뢰할지, 예상 밖의 결과를 어떻게 해석할지, 어느 지점에서 실험을 멈추거나 방향을 바꿀지 판단해야 합니다. AI는 사람이 미처 생각하지 못한 후보를 제시할 수 있지만, 그 후보가 물리적으로 타당하고 실제로 쓸 만한지는 여전히 사람이 해석하고 검증해야 합니다.
결국 에이랩과 같은 자동화 실험실은 과학자의 손을 없애는 장치가 아닙니다. 반복 실험의 범위를 넓히고 기록의 정밀성을 높여, 연구자가 더 중요한 질문과 판단에 집중하도록 돕는 도구입니다. 앞으로의 재료 발견은 인간이 질문을 정하고, AI가 후보를 제안하며, 로봇이 실험하고, 그 결과를 다시 AI와 인간이 함께 해석하는 순환 속에서 이루어질 가능성이 큽니다.
5.6 매터젠과 생성적 재료 설계
AI가 재료 설계에 본격적으로 활용되기 전까지, 재료 연구는 주로 이미 알려진 물질을 만들거나 계산한 뒤 “이 물질은 어떤 성질을 가질까?”를 확인하는 방식으로 이루어졌습니다. 연구자는 기존 데이터와 이론, 경험을 바탕으로 후보를 고르고, 그 물질의 구조와 성질을 차례로 조사했습니다. 그러나 생성형 AI가 재료과학에 들어오면서 질문의 방향이 달라지고 있습니다. 이제는 “이런 성질을 얻으려면 어떤 물질이 필요할까?”라고 거꾸로 물을 수 있게 된 것입니다.
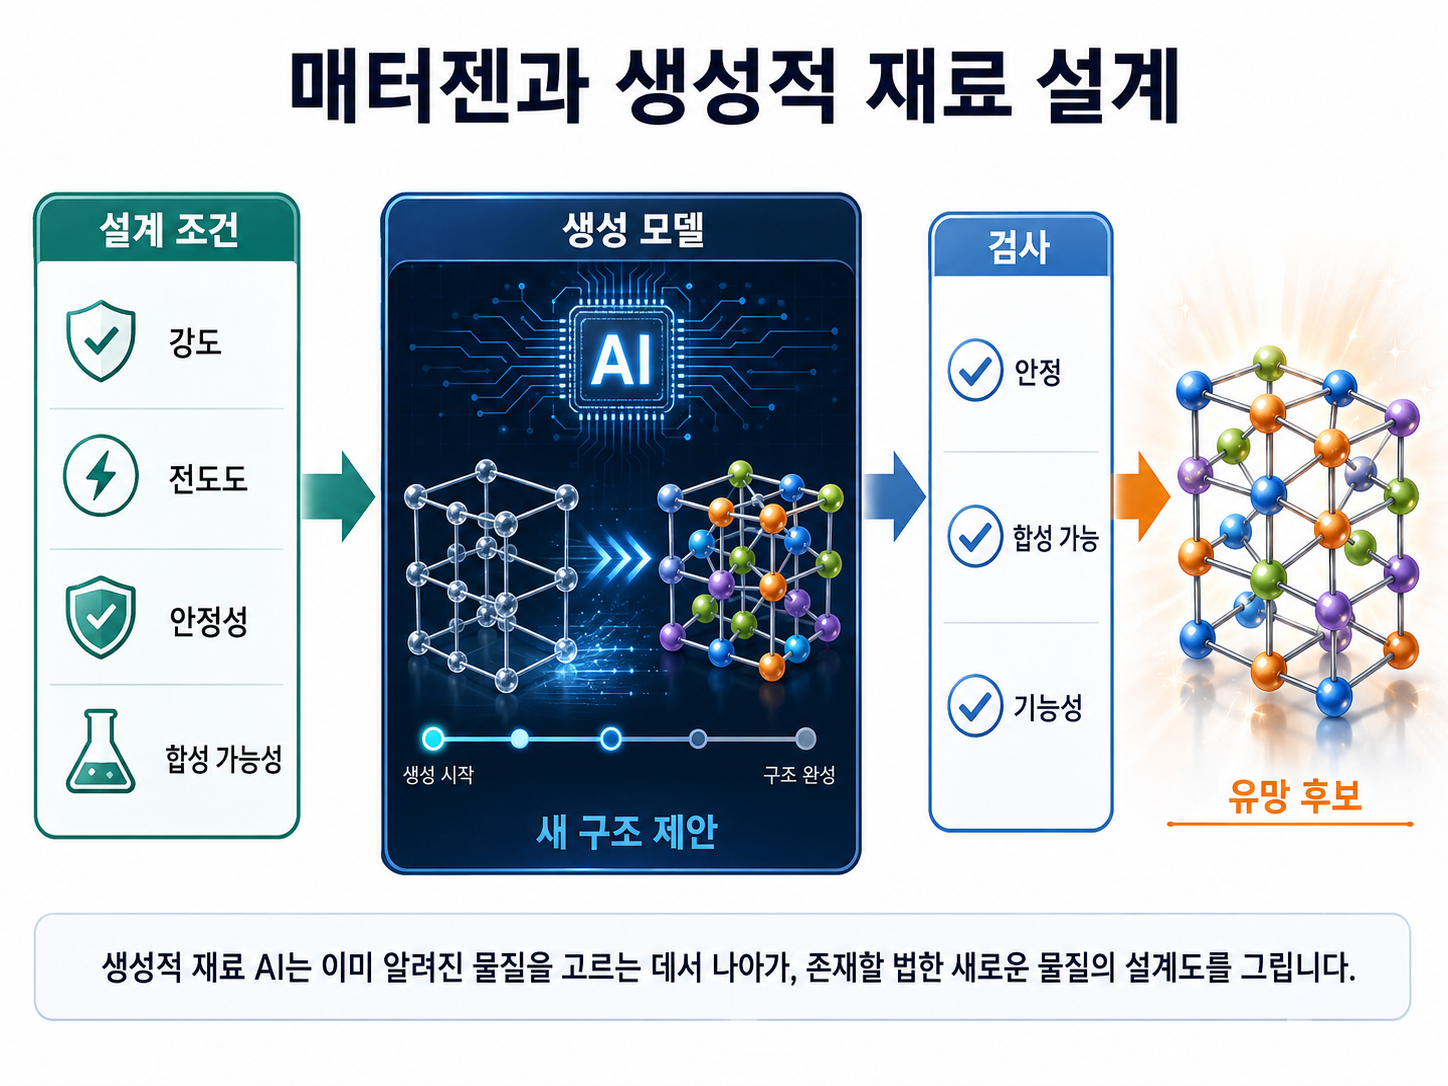
예를 들어 연구자가 높은 전도성과 열적 안정성을 함께 지닌 물질, 희귀 원소를 적게 쓰면서도 강한 자성을 보이는 물질, 특정한 빛을 잘 흡수하는 반도체를 원한다고 해보겠습니다. 전통적인 방식이라면 수많은 후보를 하나씩 계산하고 실험해야 합니다. 하지만 AI는 기존 물질 자료에서 원자 조합, 결합, 결정 구조와 성질 사이의 관계를 학습한 뒤, 그 조건에 맞을 가능성이 있는 새로운 후보를 먼저 제안할 수 있습니다. 이처럼 원하는 성질에서 출발해 가능한 물질 구조를 찾아가는 방식을 역설계(inverse design)라고 합니다. 일반적인 재료 연구가 구조에서 성질을 예측하는 방향이었다면, 역설계는 목표한 성질에서 출발해 그 성질을 낼 수 있는 구조를 거꾸로 찾습니다. 물질의 세계에서 정답지를 뒤지는 것이 아니라, 조건에 맞는 문제 자체를 새로 만들어보는 셈입니다.
이 접근을 더 적극적으로 밀고 나간 것이 생성적 재료 설계(generative materials design)입니다. 생성적 재료 설계는 기존 후보를 분류하고 고르는 데 그치지 않고, AI가 새로운 조성과 결정 구조를 직접 제안하는 방식입니다. 기존 물질을 복사하는 것이 아니라, 학습한 물질의 문법 안에서 아직 충분히 탐색되지 않은 조합을 만들어보는 것입니다. 대표적인 사례가 마이크로소프트(Microsoft)의 매터젠(MatterGen)입니다. 매터젠은 연구자가 원하는 조건을 제시하면, 그 조건에 맞을 가능성이 있는 새로운 무기 재료의 후보 구조를 생성하도록 설계된 AI 모델입니다. 여기서 조건은 화학적 안정성, 전기적 성질, 자기적 성질, 기계적 강도 같은 물성일 수 있습니다. AI는 이미 알려진 물질의 규칙을 바탕으로, 목표에 가까운 원자 조합과 배열을 제안합니다.
다만 AI가 제안한 구조가 곧바로 새로운 재료의 발견을 뜻하는 것은 아닙니다. 계산상 안정적으로 보이는 물질도 실제로는 합성되지 않을 수 있고, 매우 높은 압력이나 온도에서만 존재할 수도 있습니다. 공기나 습기에 약하거나, 작은 결함 때문에 예상한 성질이 나타나지 않을 수도 있습니다. 생성은 발견의 끝이 아니라 탐색의 시작입니다. 따라서 생성된 후보는 반드시 검증을 거쳐야 합니다. 먼저 계산을 통해 물리 법칙에 맞는 구조인지, 충분히 안정한지 살펴야 합니다. 그다음 실제 합성에 필요한 원료, 온도, 압력, 공정을 찾아야 합니다. 이어 만들어진 시료의 구조와 성질을 측정하고, 다른 연구실에서도 같은 결과를 재현할 수 있는지 확인해야 합니다. AI가 상상한 물질이 현실의 재료가 되려면 계산, 합성, 측정, 재현성이라는 문을 차례로 통과해야 합니다.
이 과정은 자동화 실험실과 결합될 때 더 강력해집니다. 생성모델이 새로운 후보와 합성 조건을 제안하면, 로봇 실험실이 이를 만들고 측정할 수 있습니다. 실험 결과는 다시 AI에 전달되어 다음 후보를 개선하는 자료가 됩니다. 이렇게 생성–계산–합성–측정–학습이 하나의 순환으로 이어지면 재료 탐색의 속도와 범위가 크게 넓어집니다. 하지만 중요한 것은 AI에 어떤 목표를 주느냐입니다. 전기 전도성만 강조하면 희귀하거나 독성이 큰 원소를 포함한 물질이 제안될 수 있습니다. 반대로 비용, 자원의 풍부함, 안전성, 재활용 가능성까지 조건에 넣으면 탐색의 방향은 달라집니다. AI는 스스로 좋은 미래를 선택하지 않습니다. 사람이 정한 목표를 따라 가능성을 넓힐 뿐입니다.
그러므로 생성적 재료 설계의 핵심은 AI가 재료를 자동으로 완성한다는 데 있지 않습니다. 핵심은 연구자가 원하는 성질을 먼저 제시하고, 그 목적에 맞는 물질의 가능성을 능동적으로 탐색할 수 있게 되었다는 데 있습니다. 매터젠과 같은 모델은 자연의 법칙을 마음대로 바꾸는 도구가 아니라, 자연이 허용하는 물질의 문법 안에서 아직 쓰이지 않은 문장을 제안하는 도구입니다. 재료과학은 이제 이미 발견된 물질의 성질을 조사하는 학문에서, 필요한 성질을 가진 물질을 상상하고 검증하는 학문으로 넓어지고 있습니다. AI는 이 변화의 중심에서 새로운 후보를 제안하고, 탐색의 우선순위를 정하며, 실험과 계산이 더 빠르게 만날 수 있도록 돕고 있습니다.
5.7 초전도체, 핵융합, 꿈의 재료
전선에 전류가 흐르면 일부 에너지는 열로 빠져나갑니다. 전자기기가 뜨거워지고, 송전 과정에서 전력 손실이 생기는 것도 이 때문입니다. 만약 전기가 거의 손실 없이 흐를 수 있다면 전력망, 의료 영상 장치, 자기부상 교통, 양자기술은 지금과 전혀 다른 모습이 될 수 있습니다. 이처럼 특정한 조건에서 전기저항이 사라지는 물질을 초전도체(superconductor)라고 합니다. 문제는 조건입니다. 현재 알려진 많은 초전도체는 극도로 낮은 온도나 매우 높은 압력에서만 작동합니다. 그래서 중요한 목표는 단순히 초전도 현상을 보이는 물질을 찾는 데 있지 않습니다. 더 현실적인 온도와 압력에서 안정적으로 작동하는 재료를 찾는 데 있습니다.
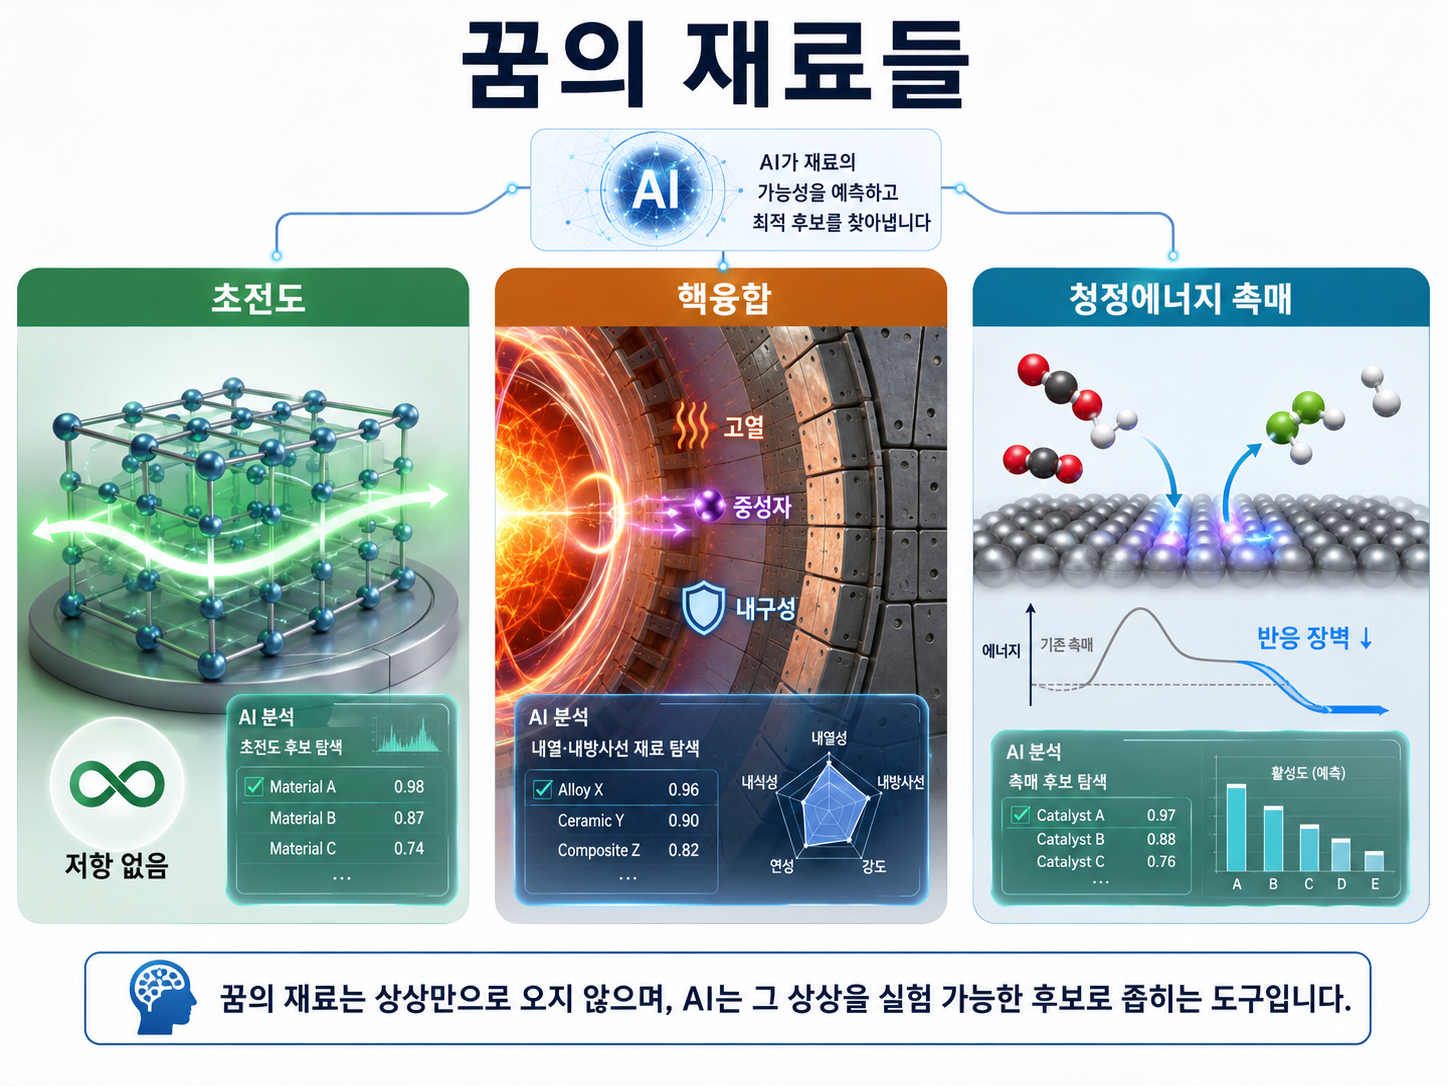
AI는 이 탐색에서 중요한 역할을 할 수 있습니다. 초전도체 후보를 찾으려면 원소 조합, 결정 구조, 전자 상태, 압력과 온도 조건을 함께 살펴야 합니다. 사람이 모든 조합을 직접 만들고 시험하기에는 가능성이 너무 많습니다. AI는 기존 실험 자료와 계산 결과를 학습해, 초전도성이 나타날 가능성이 큰 물질 영역을 먼저 가리킬 수 있습니다. 말하자면 AI는 꿈의 재료를 즉시 만들어내는 발명가가 아니라, 어디부터 파보아야 할지 알려주는 탐색 지도에 가깝습니다. 하지만 AI가 유망한 구조를 예측했다고 해서 곧바로 초전도체가 발견된 것은 아닙니다. 실제 시료를 합성하고, 전기저항이 정말 사라지는지, 자기적 성질이 초전도체의 특징과 맞는지 확인해야 합니다. 측정 장비의 오류나 불순물의 영향은 없는지, 다른 연구실에서도 같은 결과가 재현되는지도 검증해야 합니다. 초전도체는 기대가 큰 분야인 만큼, 과장된 발표와 실제 발견을 구분하는 절차가 특히 중요합니다.
핵융합도 재료의 한계와 깊이 연결되어 있습니다. 태양은 가벼운 원자핵들이 결합하면서 막대한 에너지를 냅니다. 이 반응을 지상에서 이용하려는 기술이 핵융합(fusion)입니다. 그러나 핵융합을 발전 기술로 쓰려면 1억 도에 가까운 뜨거운 플라즈마(plasma), 곧 전자와 원자핵이 분리된 고온의 물질 상태를 안정적으로 가두어야 합니다. 이 장치를 구성하는 재료는 극심한 열과 강한 중성자 충격을 오래 견뎌야 합니다. 핵융합로 내부에서는 재료가 단순히 뜨거워지는 데서 끝나지 않습니다. 고에너지 입자가 원자 배열을 흔들고, 표면을 깎아내며, 반복되는 온도 변화가 균열과 변형을 일으킬 수 있습니다. 재료가 부풀거나 약해지면 장치의 수명과 안전성도 흔들립니다. 따라서 핵융합의 현실성은 반응을 일으키는 기술만이 아니라, 그 반응을 오래 견딜 수 있는 재료를 찾는 일에 달려 있습니다.
AI는 이런 극한 환경용 재료를 찾는 데도 활용될 수 있습니다. 어떤 원소 조합과 미세구조가 열과 방사선 손상에 강한지, 어떤 재료가 강도와 내열성, 방사선 저항성을 함께 가질 수 있는지 예측할 수 있습니다. 실제 장치에서 오랜 시간 일어날 손상을 모두 실험으로 재현하기는 어렵기 때문에, AI는 계산과 데이터를 바탕으로 먼저 시험할 후보를 좁혀주는 역할을 합니다. 물론 핵융합 재료 역시 계산상 우수하다는 이유만으로 바로 사용할 수는 없습니다. 실제와 가까운 조건에서 얼마나 오래 버티는지, 반복되는 충격 뒤에도 강도를 유지하는지, 교체와 유지보수가 가능한지 확인해야 합니다. AI가 후보를 제안하면, 과학자는 그 후보를 합성하고 측정하며 실제 장치의 조건에서 검증해야 합니다.
초전도체와 핵융합 재료는 모두 ‘꿈의 재료’라고 불릴 만큼 잠재력이 큽니다. 그러나 꿈이 클수록 검증은 더 엄격해야 합니다. AI는 이전보다 훨씬 많은 구조와 조합을 빠르게 탐색하고, 인간이 미처 생각하지 못한 후보를 보여줄 수 있습니다. 그러나 후보를 많이 제안하는 능력과 참된 발견을 가려내는 능력은 다릅니다. 결국 AI의 역할은 꿈의 재료를 자동으로 완성하는 데 있지 않습니다. AI는 가능성이 높은 후보를 찾고, 실험의 우선순위를 정하며, 실패할 가능성이 큰 조합을 줄여줍니다. 그러나 그 후보가 실제 물질로 존재하는지, 안정적으로 작동하는지, 다른 연구자도 같은 결과를 얻을 수 있는지는 계산과 합성, 측정과 재현성 검증을 통해 확인되어야 합니다.
『묵자』는 "기술이란 그 화려함보다 실제로 사람들에게 어떤 이익을 주는가를 기준으로 보아야 한다"고 말합니다. 근대의 프랜시스 베이컨 역시 자연에 대한 지식이 인간의 삶을 개선하는 힘이 되어야 한다고 생각했습니다. 이러한 관점에서 꿈의 재료가 지닌 가치는 놀라운 성질 자체에만 있지 않습니다. 그것이 현실에서 안전하고 지속 가능하게 작동하며, 공동체에 실제 도움을 줄 수 있는지까지 물어야 합니다. 꿈은 새로운 연구를 시작하게 하지만, 검증은 그 꿈을 기술로 바꿉니다. AI는 가능한 미래를 더 빠르고 넓게 그려 줄 수 있습니다. 그러나 그중 무엇이 현실이 될 수 있는지를 결정하는 것은 여전히 계산과 합성, 측정과 재현이라는 과학의 절차입니다. 꿈의 재료가 문명의 재료가 되려면 속도와 신뢰가 함께 나아가야 합니다.
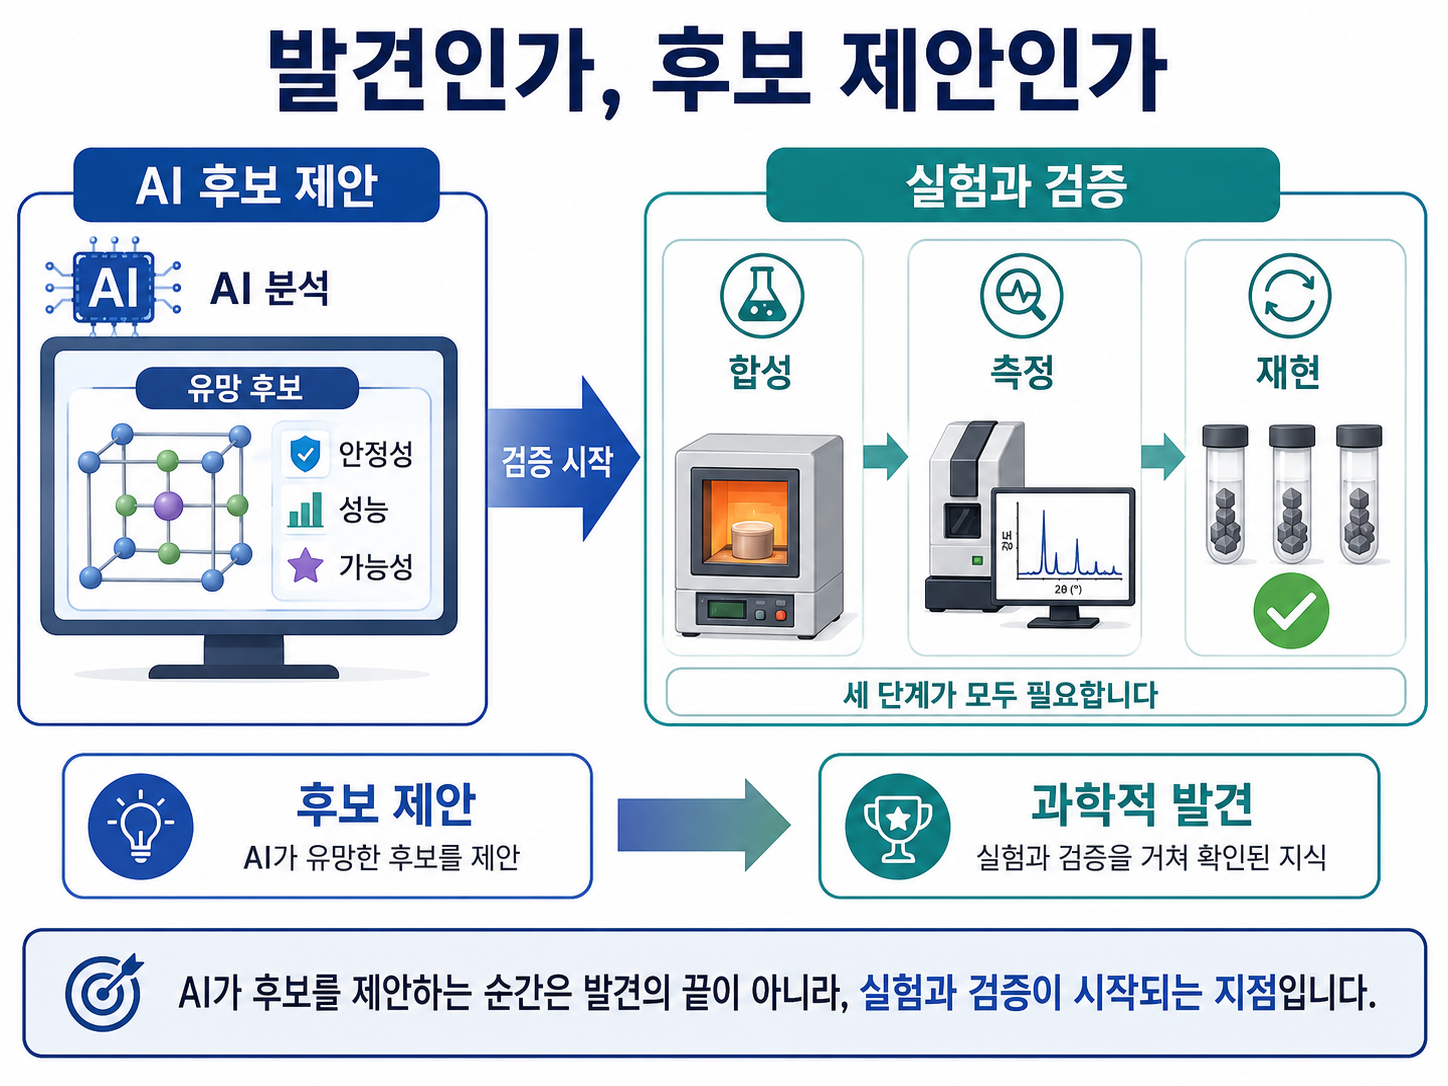
>물질의 미래를 상상한다는 것 > >새옹지마 고사로 유명한 기원전 중국 고서 『회남자』는 자연과 기술, 인간 생활을 하나의 질서 속에서 관조하는 이야기가 풍부하게 담겨 있습니다. “아는 것이 힘”이라는 말로 유명한 프랜시스 베이컨은 지식이 인간의 삶을 바꿀 힘을 가진다고 보았습니다. 그러나 새로운 능력이 커질수록 무엇을 위해, 어떤 방식으로 사용할 것인지에 대한 책임도 함께 커집니다. 전통의 장인들은 재료를 자신의 뜻에 억지로 굴복시키기보다 나무의 결, 흙의 성질, 금속이 열에 반응하는 방식을 살피며 도구를 만들었습니다. 좋은 장인은 재료가 할 수 있는 일과 할 수 없는 일을 구분했습니다. AI 재료과학에도 이러한 태도가 필요합니다. 더 많은 후보를 만들어 내는 능력만큼, 물질의 성질과 한계에 귀 기울이는 신중함이 중요합니다. AI는 인간에게 수많은 물질적 가능성을 보여 줄 수 있지만, 어느 가능성을 선택할 것인지는 스스로 결정하지 않습니다. AI는 가능성의 지도를 넓히고, 과학은 그 가능성을 검증하며, 사회는 그 가운데 어떤 길을 선택할지 판단합니다. 새로운 물질이 만들어 낼 세계가 더 안전하고 지속 가능한 방향으로 나아갈지는 결국 그 힘을 공존과 책임의 원칙 아래 사용할 수 있는 인간 공동체에 달려 있습니다. >
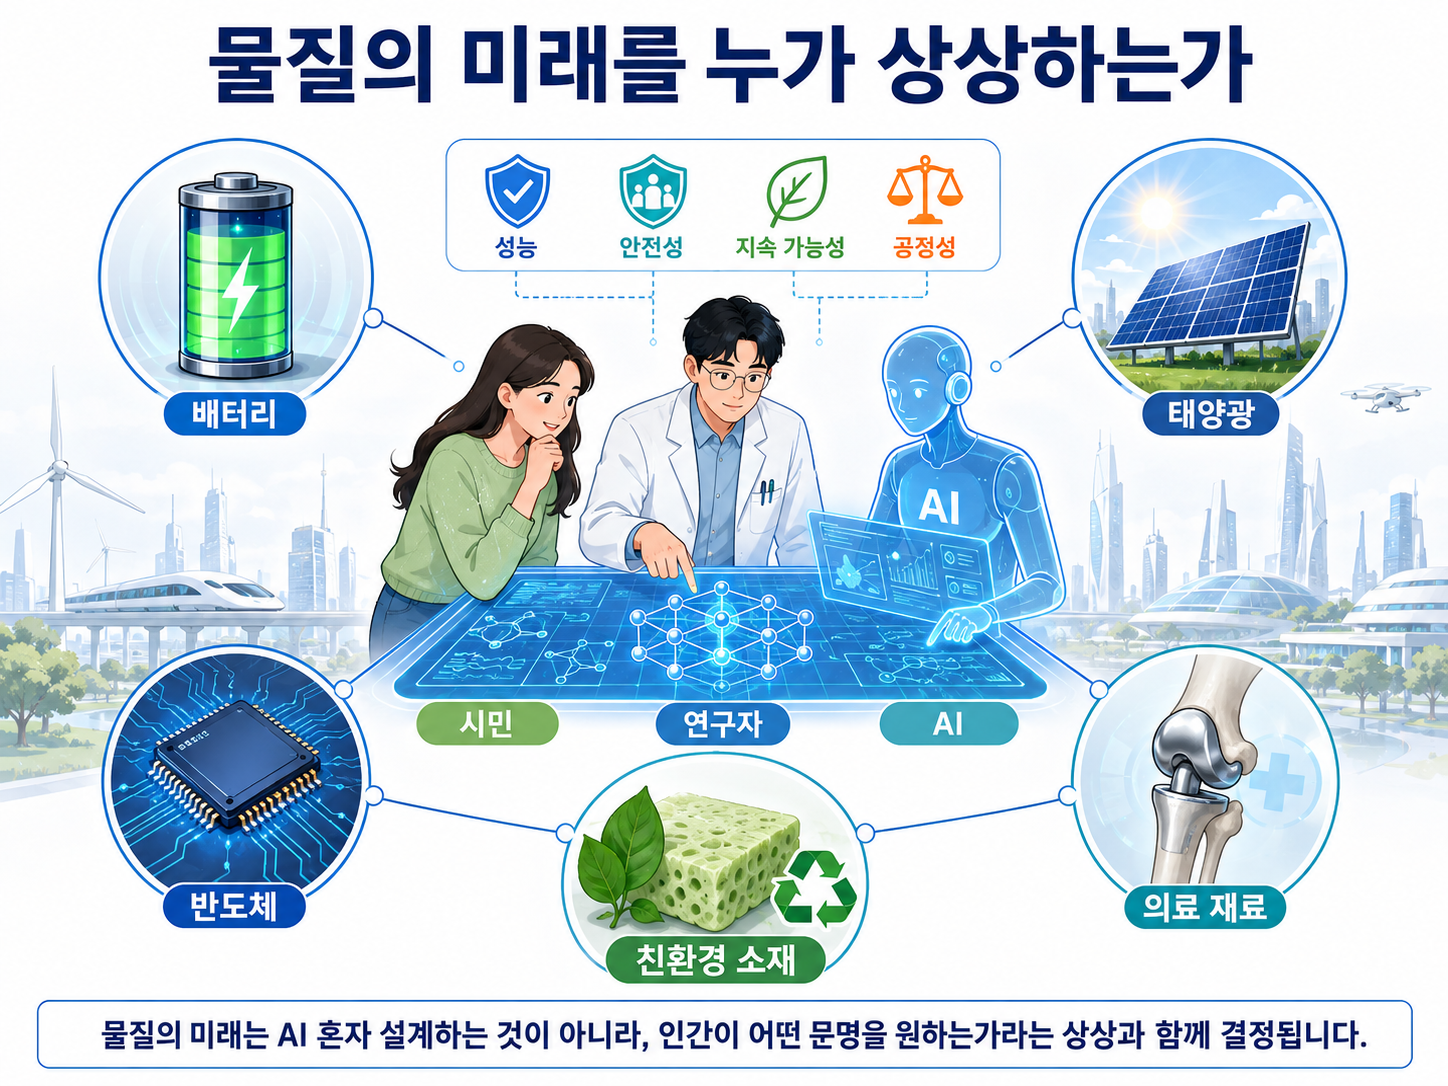
>
제6강. 기후와 지구 시스템
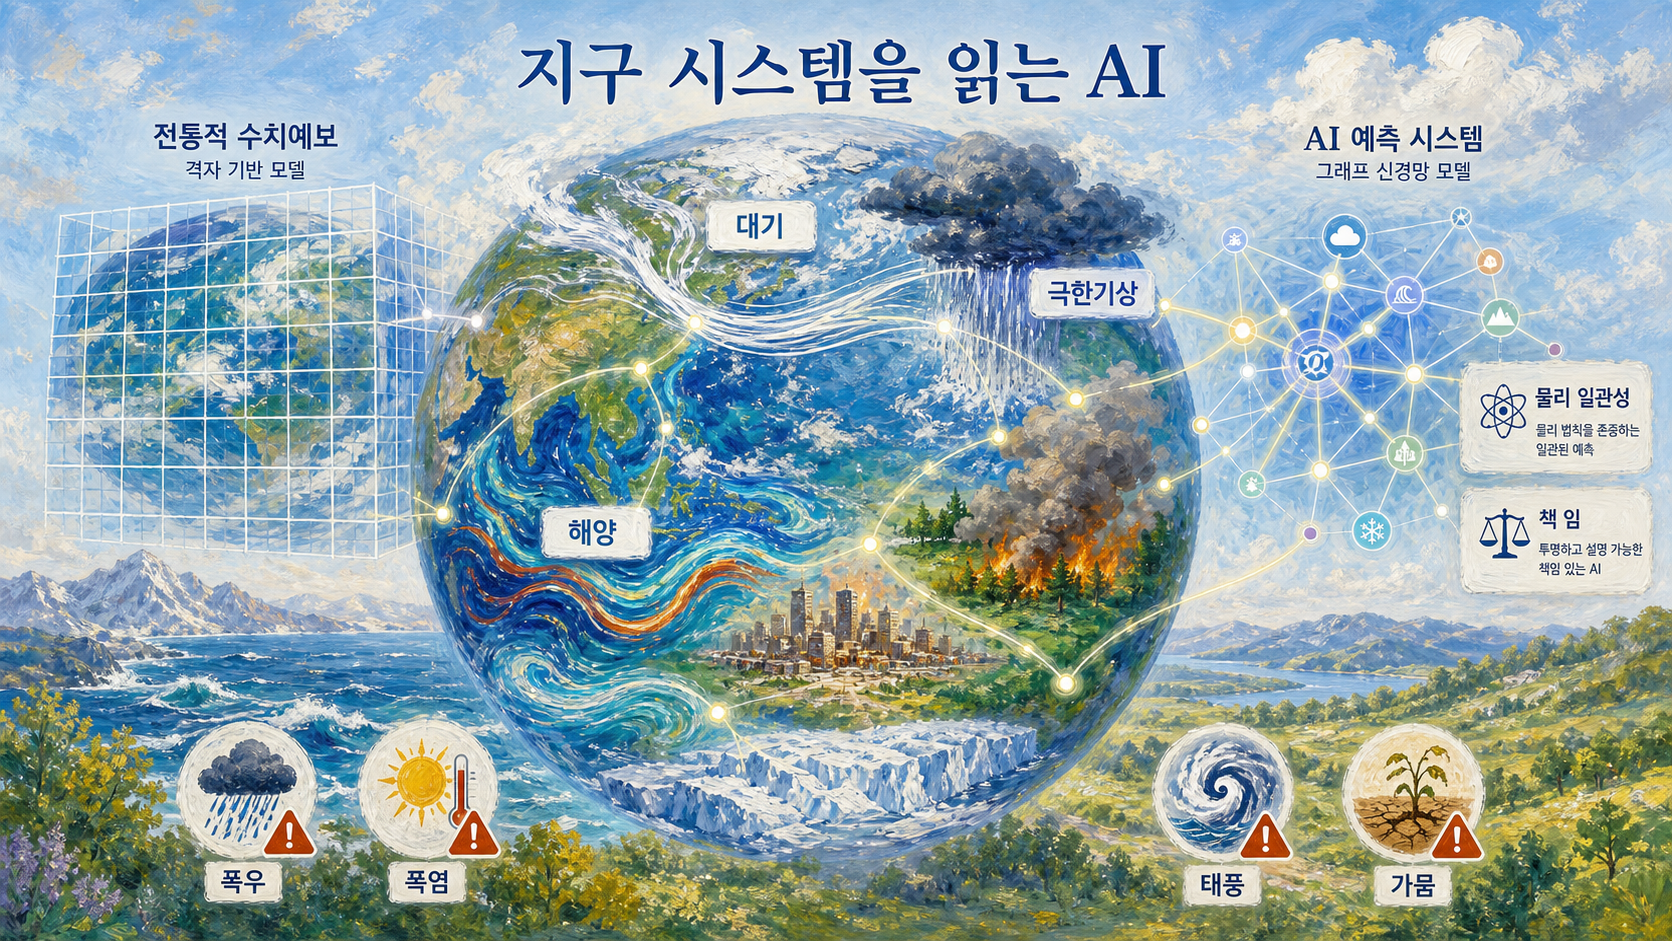
빨래를 널어 본 사람은 날씨가 온도계의 숫자 하나로 설명되지 않는다는 사실을 압니다. 햇빛이 강해도 습도가 높고 바람이 없으면 빨래는 잘 마르지 않습니다. 기온이 같아도 바람과 습도, 구름과 지면의 상태에 따라 우리가 느끼는 날씨는 달라집니다. 날씨는 하나의 변수로 정해지는 현상이 아니라, 대기와 바다, 땅과 얼음, 수증기와 햇빛이 서로 영향을 주며 만들어내는 복합적인 지구 시스템의 표정입니다. 그래서 날씨와 기후를 이해하는 일은 단순히 “내일 비가 올까”를 맞히는 문제에 머물지 않습니다. 농부는 씨를 뿌릴 시기를 정하고, 어민은 바다에 나갈지를 판단하며, 전력회사는 폭염과 한파에 대비해 공급 계획을 세웁니다. 도시는 집중호우와 산불, 태풍과 해수면 상승에 대비해야 합니다. 기상과 기후 정보는 일상의 편의뿐 아니라 생명, 산업, 에너지, 재난 대응과 직접 연결되어 있습니다.
오늘날 AI는 이 복잡한 지구 시스템을 이해하고 예측하는 새로운 도구로 활용되고 있습니다. AI는 방대한 관측 자료와 위성 이미지, 기상 모델의 계산 결과를 학습하여 대기의 변화를 빠르게 읽고, 폭염과 집중호우, 태풍과 산불 위험을 더 이른 시점에 감지하는 데 도움을 줄 수 있습니다. 나아가 기후변화의 장기적 흐름을 분석하고, 지역별 위험을 예측하며, 사회가 어디에 먼저 대비해야 하는지 판단하는 데에도 쓰일 수 있습니다. 이번 강의에서는 먼저 날씨가 왜 예측하기 어려운지 살펴보고, AI가 기존 기상 예측과 어떻게 만나고 있는지 알아보겠습니다. 이어 폭염, 집중호우, 태풍, 산불 같은 극한 기상과 재난 대응에서 AI가 어떤 도움을 줄 수 있는지 살펴봅니다. 마지막으로 짧은 시간의 날씨 예측을 넘어, 기후변화와 지구 시스템 전체를 이해하는 데 AI가 어떤 가능성과 한계를 지니는지 함께 생각해 보겠습니다.
6.1 날씨는 왜 어려운가
연못에 돌 하나를 던지면 둥근 물결이 퍼져 나갑니다. 그러나 여러 곳에서 동시에 돌을 던지고, 바람이 불고, 물고기와 수초까지 움직인다면 수면의 변화는 금세 복잡해집니다. 날씨도 이와 비슷합니다. 대기는 거대한 공기의 바다이고, 그 안에서는 온도와 습도, 기압과 바람, 구름과 지형이 끊임없이 서로 영향을 주고받습니다. 날씨가 어려운 첫 번째 이유는 출발점이 조금만 달라도 결과가 달라질 수 있기 때문입니다. 내일의 날씨를 계산하려면 지금 이 순간 지구 곳곳의 온도, 기압, 습도, 바람을 알아야 합니다. 그러나 지구의 모든 지점을 빈틈없이 관측할 수는 없습니다. 현재 상태를 아주 조금 다르게 파악하면, 처음에는 작았던 차이가 시간이 지나며 점점 커져 며칠 뒤에는 전혀 다른 예측으로 이어질 수 있습니다. 이렇게 미래 예측이 처음 상태에 민감하게 좌우되는 조건을 초기 조건(initial condition)이라고 합니다.
흔히 말하는 나비효과(butterfly effect)도 이 맥락에서 이해할 수 있습니다. 나비의 날갯짓이 곧바로 태풍을 만든다는 뜻은 아닙니다. 복잡한 시스템에서는 아주 작은 차이도 여러 과정을 거치며 커질 수 있다는 뜻입니다. 그래서 가까운 미래의 날씨는 비교적 정확하게 예측할 수 있지만, 시간이 멀어질수록 예측의 불확실성은 커집니다.
초기 조건과 날씨 변화
두 번째 이유는 날씨가 크고 작은 현상의 결합으로 이루어지기 때문입니다. 태풍과 대륙 규모의 기압 배치는 수백에서 수천 킬로미터에 걸쳐 움직입니다. 반면 구름방울, 작은 소용돌이, 지표면의 마찰은 훨씬 작은 규모에서 일어납니다. 그런데 이 작은 과정들이 구름의 생성, 강수량, 태풍의 세기에 영향을 줍니다. 큰 흐름만 봐도 부족하고, 작은 변화까지 모두 계산하려면 연산량이 너무 커집니다. 전통적인 기상 예측은 대기를 일정한 크기의 격자로 나누고, 물리 방정식을 이용해 공기와 열, 수증기의 변화를 계산합니다. 이 방식을 수치예보(numerical weather prediction)라고 합니다. 수치예보는 현대 기상학의 핵심 도구지만, 격자보다 작은 구름과 난류 같은 현상은 근사적으로 표현할 수밖에 없습니다. 관측의 빈틈과 근사의 한계가 예측의 불확실성을 만듭니다.
AI가 기상예측에 활용되는 이유가 여기에 있습니다. AI는 오랜 기간 축적된 관측 자료, 위성 이미지, 과거 예보와 실제 날씨의 차이를 학습합니다. 현재의 대기 상태가 주어졌을 때 몇 시간 뒤, 며칠 뒤 어떤 변화가 이어질 가능성이 큰지 빠르게 계산할 수 있습니다. 기존 수치예보가 물리 방정식을 단계적으로 풀어 미래를 계산한다면, AI 모델은 방대한 자료 속에서 현재와 미래 사이의 패턴을 찾아 예측 속도를 높입니다. 그러나 AI가 날씨의 어려움을 없애는 것은 아닙니다. 드물게 일어나는 극한 폭우나 이례적 폭염은 학습 자료가 충분하지 않을 수 있습니다. 기후변화로 과거와 다른 조건이 나타나면, 과거 자료에 익숙한 AI의 예측도 흔들릴 수 있습니다. 관측 자료에 오류나 빈틈이 있으면 AI 역시 그 한계를 물려받습니다. 빠른 예측이 언제나 정확한 예측을 뜻하지는 않습니다.
따라서 기상 AI의 역할은 미래를 완벽하게 맞히는 데 있지 않습니다. 더 많은 자료를 빠르게 읽고, 위험 가능성을 일찍 감지하며, 예측의 범위를 좁혀 사람들이 대비할 시간을 벌어주는 데 있습니다. 비가 올 가능성, 예상 강수량, 태풍의 이동 범위, 폭염과 한파의 위험 수준을 더 신속하게 알려주는 것이 핵심입니다. 날씨 예측은 정해진 운명을 선언하는 기술이 아닙니다. 불확실한 미래를 조금 더 일찍 보고, 그 불확실성 안에서 더 나은 선택을 하도록 돕는 기술입니다. AI는 이 과정에서 대기의 복잡한 변화를 빠르게 읽는 새로운 도구가 될 수 있습니다. 다만 그 예측은 언제나 관측, 물리 모델, 인간의 판단과 함께 해석되어야 합니다.
6.2 전통 수치예보는 어떻게 작동하는가
기존의 기상학자들은 지구를 거대한 바둑판처럼 수백만 개의 3차원 '격자(Grid)'로 잘게 나누었습니다. 그리고 각 칸마다 온도, 기압, 습도, 바람의 데이터를 넣고 물리 법칙(유체역학, 열역학) 방정식에 대입하여 다음 시간대의 변화를 계산했습니다. 이것이 전통 수치예보입니다. 그 바탕에는 물리 법칙이 있습니다. 공기의 움직임은 유체역학을 따르고, 열의 이동은 열역학과 에너지 보존 법칙을 따릅니다. 수증기가 증발하고 응결하는 과정은 구름과 비, 눈을 만듭니다. 기상 모델은 이러한 법칙을 컴퓨터가 계산할 수 있는 수식으로 바꾸고, 매우 짧은 시간 간격마다 대기의 다음 상태를 구합니다. 계산을 시작하려면 먼저 현재의 대기 상태를 최대한 정확하게 파악해야 합니다. 지상 관측소와 기상위성, 레이더와 해양 부표, 선박과 항공기에서 모은 자료를 결합해 하나의 일관된 출발 상태를 만듭니다. 관측값은 지역과 시간에 따라 불규칙하게 흩어져 있기 때문에, 이를 모델의 격자에 맞게 조정하는 과정이 필요합니다. 현재 상태를 얼마나 정확하게 구성하느냐가 이후 예측의 품질에 큰 영향을 줍니다.
슈퍼컴퓨터로 계산하는 전통 수치예보
날씨를 예측하려면 먼저 지구의 대기를 계산 가능한 형태로 바꾸어야 합니다. 실제 대기는 끊임없이 흐르는 공기의 바다이지만, 컴퓨터는 이 흐름을 그대로 통째로 계산할 수 없습니다. 그래서 기상학자들은 지구를 거대한 바둑판처럼 잘게 나눕니다. 가로, 세로뿐 아니라 높이 방향까지 나눈 3차원 칸을 만들고, 각 칸에 온도, 기압, 습도, 바람의 정보를 넣습니다. 이렇게 나눈 계산 단위를 격자(grid)라고 합니다. 전통 수치예보는 이 격자 위에서 작동합니다. 공기가 어디로 움직일지, 열이 어떻게 이동할지, 수증기가 언제 구름과 비로 바뀔지를 물리 법칙에 따라 계산합니다. 공기의 흐름은 유체역학, 열의 이동은 열역학, 물의 증발과 응결은 구름과 강수의 물리 과정으로 설명됩니다. 수치예보는 이러한 법칙을 컴퓨터가 풀 수 있는 방정식으로 바꾸어, 짧은 시간 간격마다 대기의 다음 상태를 계산합니다.
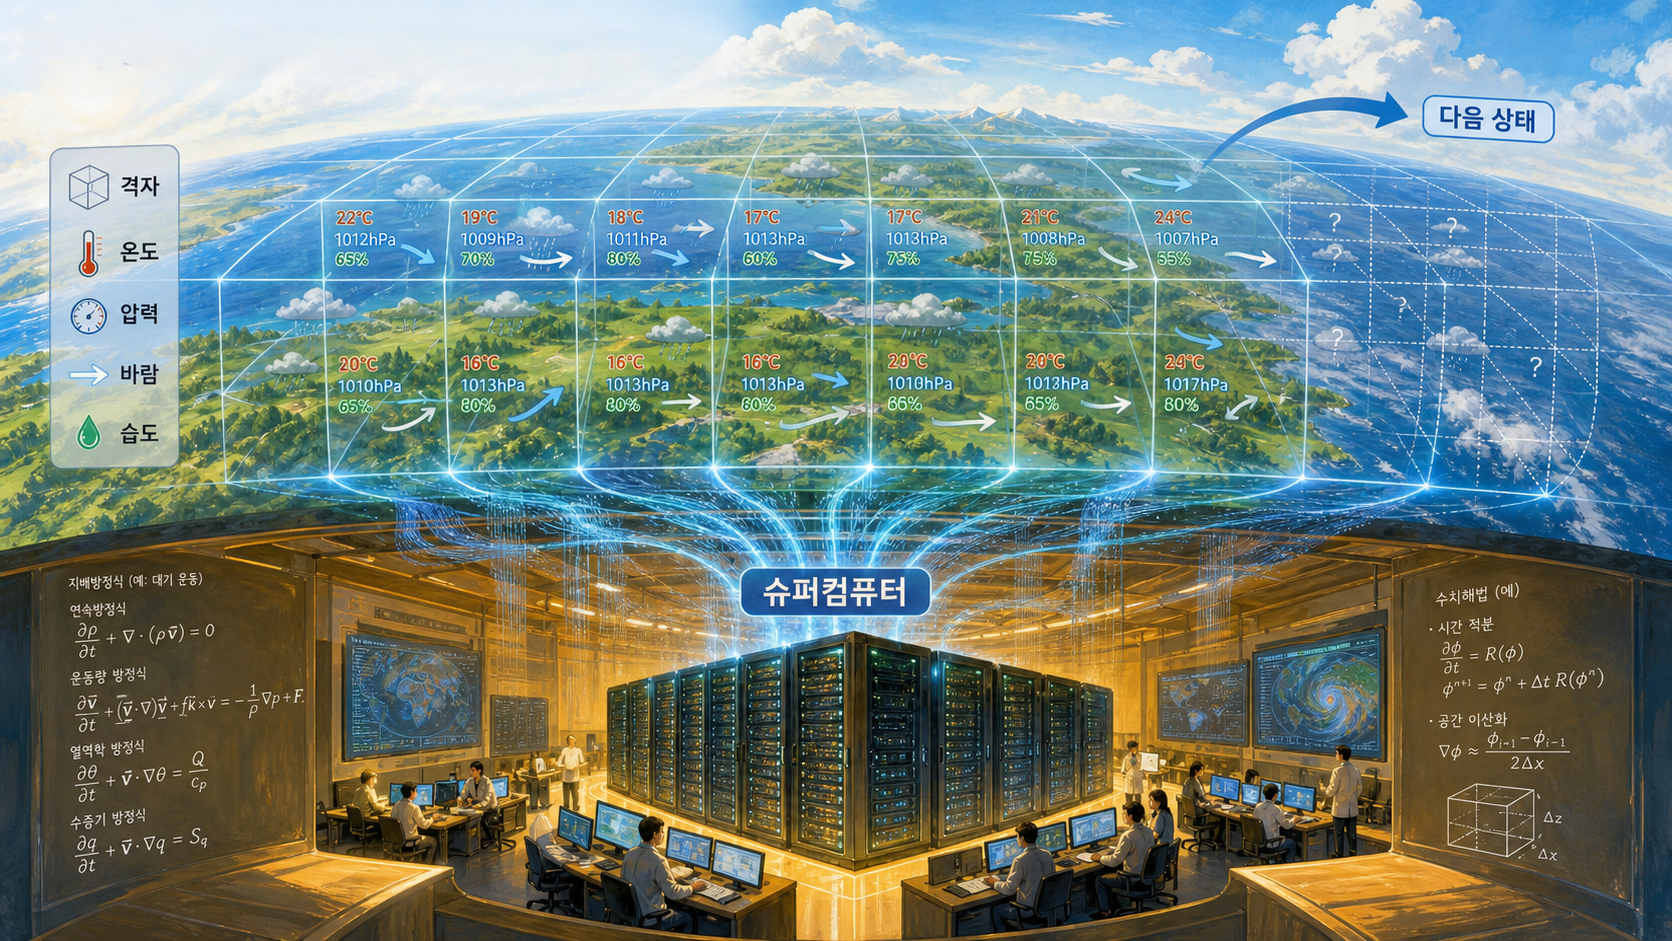
계산을 시작하려면 현재의 대기 상태를 최대한 정확하게 알아야 합니다. 지상 관측소, 기상위성, 레이더, 해양 부표, 선박과 항공기에서 모은 자료가 여기에 쓰입니다. 그러나 관측 자료는 지구 전체에 고르게 놓여 있지 않습니다. 어떤 지역은 촘촘하게 관측되지만, 바다나 산악 지역처럼 자료가 부족한 곳도 있습니다. 흩어진 관측값을 모델의 격자에 맞게 정리해 하나의 출발 상태로 만드는 과정이 필요합니다. 이 출발점이 조금만 달라져도 예측 결과는 달라질 수 있습니다. 수치예보는 현대 과학의 중요한 성과입니다. 일기예보는 더 이상 경험에 따른 짐작이 아니라, 관측된 지구의 현재 상태를 물리 법칙에 따라 미래로 밀고 가는 계산입니다. 우리가 휴대전화에서 보는 내일의 비 예보 뒤에는 전 지구적 관측망, 대기물리학, 수학, 슈퍼컴퓨터가 함께 작동하고 있습니다.
그러나 격자로 나눈다고 해서 대기의 모든 움직임을 다 계산할 수 있는 것은 아닙니다. 작은 구름, 국지성 소나기, 산골짜기의 바람, 도시의 열섬, 미세한 난류는 격자보다 훨씬 작은 규모에서 일어날 수 있습니다. 이런 작은 현상을 하나하나 직접 계산하기는 어렵습니다. 그래서 모델은 작은 과정이 큰 흐름에 미치는 평균적인 효과를 수식으로 대신 표현합니다. 이 방식을 매개변수화(parameterization)라고 합니다. 예를 들어 한 격자 안에서 구름이 정확히 어디에 생기고 비가 얼마나 내릴지 모두 계산하기 어렵다면, 온도와 습도 같은 조건을 이용해 그 효과를 근사하는 것입니다. 이 근사는 수치예보를 가능하게 하지만, 동시에 오차의 원인이 되기도 합니다. 격자를 더 작게 나누면 좁은 지역의 날씨를 더 자세히 표현할 수 있지만, 계산해야 할 칸의 수가 급격히 늘어납니다. 시간 간격을 더 짧게 하고, 해양과 지표면, 구름과 대기 화학 작용까지 정교하게 넣을수록 연산량은 더욱 커집니다. 기상예측에서는 정확성만큼 속도도 중요합니다. 내일 닥칠 폭우를 계산하는 데 모레까지 걸린다면 아무 소용이 없습니다. 그래서 전통 수치예보는 언제나 두 가지 요구 사이에서 균형을 찾습니다. 더 자세히 계산해야 하지만, 충분히 빨리 결과를 내야 합니다. 또한 하나의 예측만으로 미래를 단정하지 않습니다. 현재 상태를 조금씩 다르게 설정하거나 모델 조건을 바꾸어 여러 번 계산하면 서로 다른 예측 결과가 나옵니다. 이 결과들을 비교하면 가장 가능성 높은 경로뿐 아니라, 예측이 얼마나 흔들릴 수 있는지도 알 수 있습니다. 태풍의 예상 경로가 하나의 선이 아니라 일정한 범위로 제시되는 이유도 여기에 있습니다.
AI 기상예측은 바로 이 지점에서 등장합니다. AI는 오랜 기간 축적된 관측 자료와 수치예보 결과를 학습해, 현재의 대기 상태가 주어졌을 때 다음 상태가 어떻게 이어질 가능성이 큰지 빠르게 추정합니다. 물리 방정식을 매번 처음부터 차례로 푸는 대신, 과거의 날씨 변화 속에서 현재와 미래 사이의 관계를 학습해 예측합니다. 이런 의미에서 AI는 새로운 예측 모델(predictive model), 곧 미래 상태를 추정하는 계산 방식으로 활용됩니다. 그렇다고 AI 예보가 전통 수치예보와 완전히 분리된 것은 아닙니다. 많은 AI 모델은 기존 관측망과 수치예보 체계가 오랜 시간 쌓아 온 자료를 바탕으로 학습합니다. AI가 예측을 시작할 때 필요한 현재 대기 상태도 관측 자료와 기존 자료 처리 기술을 통해 만들어집니다. 전통 수치예보가 지구 대기의 물리적 토대를 계산해 왔기 때문에, AI 기상예측도 그 위에서 발전할 수 있었습니다.
앞으로의 기상예측은 전통 수치예보와 AI 가운데 하나를 고르는 방식이 아니라, 두 방식을 결합하는 방향으로 나아갈 가능성이 큽니다. 수치예보는 대기의 움직임을 물리 법칙으로 설명하고, AI는 그 계산과 관측 속에 쌓인 패턴을 빠르게 읽습니다. 결국 현대의 일기예보는 물리학과 관측, 슈퍼컴퓨터와 AI가 함께 미래의 대기를 해석하는 작업으로 바뀌고 있습니다.
6.3 그래프캐스트와 인공지능 기상예측
지하철 노선도를 떠올려 보겠습니다. 한 역에서 사고가 나면 그 영향은 주변 역과 연결 노선으로 퍼집니다. 날씨도 이와 비슷합니다. 한 지역의 기압과 바람이 달라지면 그 변화는 주변으로 번지고, 열과 수증기가 이동하면서 멀리 떨어진 지역의 날씨까지 바꿀 수 있습니다. 지구의 대기는 서로 연결된 거대한 흐름의 망입니다. AI 기상예측은 이 연결 관계를 빠르게 읽으려는 시도입니다. 전통 수치예보가 대기의 움직임을 물리 방정식으로 하나씩 계산한다면, AI 모델은 오랜 기간 축적된 관측 자료와 예보 자료에서 “현재의 대기 상태가 이후에 어떻게 변해 왔는가”를 학습합니다. 새로운 대기 상태가 주어지면, 학습한 관계를 바탕으로 몇 시간 뒤와 며칠 뒤의 변화를 빠르게 추정합니다.
이 흐름을 대표적으로 보여 준 사례가 구글 딥마인드(Google DeepMind)의 그래프캐스트(GraphCast)입니다. 여기서 그래프(graph)는 점과 선으로 이루어진 연결 구조를 뜻합니다. 지하철 노선도나 친구 관계망처럼, 여러 지점을 점으로 놓고 서로 영향을 주고받는 관계를 선으로 잇는 방식입니다. 그래프캐스트는 지구 대기를 이런 연결망으로 표현하고, 현재와 6시간 전의 대기 상태를 바탕으로 이후의 변화를 단계적으로 예측합니다. 그래프캐스트가 주목받은 이유는 빠른 속도와 높은 예측 성능 때문입니다. 학습을 마친 AI 모델은 복잡한 물리 방정식을 매번 처음부터 풀지 않고도, 과거 자료에서 배운 변화의 패턴을 이용해 전 지구 날씨를 빠르게 계산할 수 있습니다. 태풍, 폭우, 폭염처럼 신속한 대응이 중요한 상황에서는 예측 결과를 더 빨리 얻는 일이 큰 의미를 가집니다.
빠른 계산은 여러 가능한 미래를 함께 살펴보는 데도 도움이 됩니다. 날씨는 하나의 답으로만 움직이지 않습니다. 현재 상태를 조금 다르게 잡거나 조건을 바꾸면 미래 예측도 달라질 수 있습니다. 그래서 여러 번의 예측을 비교해 가능한 경로와 위험 범위를 살피는 방법이 쓰입니다. 이를 앙상블 예측(ensemble prediction)이라고 합니다. 태풍의 예상 경로를 하나의 선이 아니라 부채꼴 범위로 보여 주는 것도, 미래가 어느 정도 흔들릴 수 있는지를 함께 전달하기 위해서입니다. AI 모델은 이 앙상블 예측을 더 빠르고 넓게 수행할 가능성을 열어 줍니다. 하나의 예측만 제시하는 대신, 여러 가능한 미래를 빠르게 계산하면 기상청과 재난 대응 기관은 위험의 범위를 더 일찍 파악할 수 있습니다. 비가 올지 말지만 아는 것이 아니라, 어느 지역에 얼마나 강한 비가 올 수 있는지, 태풍 경로가 얼마나 흔들릴 수 있는지, 대비 수준을 어느 정도로 잡아야 하는지를 판단하는 데 도움이 됩니다.
그러나 AI 예측이 빠르다고 해서 언제나 충분히 믿을 수 있는 것은 아닙니다. AI는 과거 자료에서 반복된 패턴을 잘 찾아내지만, 학습 자료에 드물게 나타난 극한 폭우나 이례적 폭염, 또는 기후변화로 새롭게 나타나는 조건에서는 예측이 흔들릴 수 있습니다. 관측 자료에 빈틈이나 오류가 있으면 AI 역시 그 한계를 물려받습니다. 물리적 일관성도 중요합니다. AI가 제시한 온도, 바람, 습도, 강수량이 각각 그럴듯해 보여도, 전체적으로 에너지와 물질의 흐름에 어긋난다면 신뢰하기 어렵습니다. 데이터에서 배운 패턴은 물리 법칙과 관측 자료의 검사를 통과할 때 과학적 예측이 됩니다. 그래서 AI 기상예측은 전통 수치예보를 대체하기보다, 그 속도와 활용 범위를 넓히는 보완 도구로 이해하는 것이 적절합니다. 실제 예보 현장에서는 하나의 모델만 보지 않습니다. 전통 수치예보, AI 모델, 위성과 레이더의 최신 관측, 지역 지형에 대한 지식, 예보관의 경험을 함께 비교합니다. 각 모델은 서로 다른 강점과 약점을 가지므로, 여러 증거를 종합할 때 더 안정적인 판단을 내릴 수 있습니다. 예보는 하나의 정답을 고르는 일이 아니라, 다양한 가능성을 조율하는 과정입니다.
결국 그래프캐스트와 같은 AI 기상 모델은 날씨를 마법처럼 알아맞히는 기계가 아닙니다. 지구 대기의 연결 관계와 변화 패턴을 빠르게 읽는 새로운 도구입니다. AI는 예측의 속도를 높이고, 여러 가능한 미래를 더 폭넓게 보여 주며, 위험을 더 일찍 감지하는 데 기여할 수 있습니다. 다만 그 예측이 공공의 안전으로 이어지려면 물리적 검증, 불확실성의 표현, 현장 판단과 책임 있는 전달이 함께 이루어져야 합니다.
6.4 날씨는 유체역학과 열역학이 쓰는 일기장이다
뜨거운 커피에 차가운 우유를 떨어뜨리면 우유는 소용돌이치는 무늬를 그리며 퍼져 나갑니다. 온도 차이가 흐름을 만들고, 그 흐름이 다시 열을 옮기면서 두 액체는 서서히 섞입니다. 지구의 대기에서도 이와 비슷한 일이 훨씬 큰 규모로 일어납니다. 태양은 지표를 고르게 데우지 않고, 바다와 육지도 열을 품고 내놓는 방식이 다릅니다. 이 차이가 공기를 움직이고, 바람과 구름과 비를 만들어 냅니다. 이처럼 날씨는 움직이는 공기와 물, 그리고 이동하는 열의 이야기입니다. 공기와 물이 어떻게 흐르는지를 다루는 물리학을 유체역학(fluid dynamics)이라고 하고, 열과 에너지가 어떻게 이동하고 변하는지를 다루는 물리학을 열역학(thermodynamics)이라고 합니다. 바람과 해류는 유체의 흐름이고, 햇빛이 지표를 데우고 지표가 다시 대기를 데우는 과정은 에너지의 이동입니다. 날씨는 유체역학과 열역학이 함께 써 내려가는 지구의 일기장이라고 할 수 있습니다.
하늘의 일기장과 자연 순환
이 일기장에서 수증기는 특별히 중요한 등장인물입니다. 물은 증발할 때 주변의 열을 흡수하고, 수증기가 식어 구름방울로 바뀔 때 그 열을 다시 대기로 내놓습니다. 이때 숨어 있다가 다시 방출되는 열을 잠열(latent heat)이라고 합니다. 잠열은 태풍과 집중호우가 강해지는 데 중요한 에너지원입니다. 따뜻한 바다에서 많은 수증기가 올라오고, 그 수증기가 응결하면서 열을 내놓으면 대기의 상승 운동이 더 강해질 수 있습니다. 물은 단순히 비의 재료가 아니라, 열을 옮기는 운반자입니다. 그래서 강한 비와 바람을 이해하려면 결과만 보아서는 부족합니다. 많은 비가 내리려면 충분한 수증기가 공급되어야 하고, 습한 공기가 위로 올라가야 하며, 비구름이 한 지역에 오래 머무를 조건이 필요합니다. 강한 바람이 불려면 지역 사이의 기압 차이와 공기의 흐름이 뒷받침되어야 합니다. 날씨는 온도, 습도, 기압, 바람이라는 숫자들의 목록이 아니라, 서로 이어진 물리적 과정입니다.
AI 기상예측도 이 물리적 질서를 무시할 수 없습니다. AI가 많은 비를 예측했다면, 그 예측에는 그만한 수증기 공급과 상승 운동이 함께 설명되어야 합니다. 강한 바람을 예측했다면, 그 바람을 만들 기압 차이와 대기의 흐름이 자연스러워야 합니다. 개별 수치가 그럴듯해 보여도 전체 흐름이 물리 법칙과 어긋난다면 신뢰하기 어렵습니다. 기상 AI에는 예측 정확도뿐 아니라 물리적 일관성이 필요합니다. 그렇다고 물리 법칙만 알면 날씨를 쉽게 예측할 수 있는 것도 아닙니다. 대기에는 큰 흐름과 작은 소용돌이가 겹쳐 있고, 구름 생성과 난류처럼 작은 규모의 과정도 전체 날씨에 영향을 줍니다. 이 모든 변화를 지구 전체에 걸쳐 완벽하게 계산하기는 어렵습니다. AI는 오랜 관측 자료와 기존 기상 모델의 계산 결과를 학습해, 복잡한 패턴을 빠르게 찾아낼 수 있습니다. 물리학이 날씨 예측의 기본 문법을 제공한다면, AI는 방대한 일기장을 빠르게 읽어 반복되는 표현과 예외적인 징후를 찾아내는 역할을 합니다.
따라서 앞으로의 기상예측은 물리 모델과 AI가 서로를 보완하는 방향으로 나아갈 가능성이 큽니다. 물리 모델은 대기의 움직임이 따라야 할 법칙과 경계를 제공하고, AI는 관측과 계산 속에 축적된 패턴을 빠르게 읽어 예측의 속도와 범위를 넓힙니다. AI가 물리 법칙을 존중하고, 물리 모델이 데이터에서 새로운 보정을 얻을 때 예보는 더 빠르고 신뢰할 수 있는 정보에 가까워집니다. AI 예보가 공공의 도구가 되려면 설명의 언어도 중요합니다. 사람들은 단순히 “비가 온다”는 결과만이 아니라, 왜 특정 지역에 비가 집중되는지 알고 싶어 합니다. 습한 공기가 산맥을 만나 상승하는지, 정체전선이 한곳에 오래 머무는지, 따뜻한 바다가 많은 수증기를 공급하는지 알면 위험의 원인을 더 분명하게 이해할 수 있습니다. 예보관은 AI가 제시한 결과를 실제 대기의 흐름과 연결해 설명할 수 있어야 합니다.
결국 날씨는 자연이 매일 써 내려가는 물리학의 기록입니다. AI는 그 기록을 이전보다 빠르게 읽고, 위험의 징후를 일찍 포착하도록 도울 수 있습니다. 그러나 AI가 읽어낸 예측은 유체역학과 열역학의 문법 속에서 해석되어야 합니다. 날씨를 맞히는 일은 숫자를 내놓는 일이 아니라, 공기와 물과 열이 함께 움직이는 이야기를 이해하는 일입니다.
6.5 극한기상과 기후위기
작은 불씨도 강한 바람과 메마른 숲을 만나면 거대한 산불로 번질 수 있습니다. 날씨도 마찬가지입니다. 높은 기온, 많은 수증기, 불안정한 대기, 지형, 도시 시설의 취약성이 겹치면 평범한 비와 바람도 재난으로 바뀔 수 있습니다. 이렇게 일상적인 날씨가 위험한 수준까지 치우친 현상을 극한기상(extreme weather)이라고 합니다.
AI 예보는 극한기상을 실시간 경고한다
비는 자연스러운 물의 순환이지만, 짧은 시간에 도시의 배수 능력을 넘어설 만큼 쏟아지면 침수가 됩니다. 더위도 매년 찾아오지만, 높은 기온이 밤낮없이 오래 이어지면 노인과 어린이, 만성질환자와 야외 노동자의 생명을 위협합니다. 바람 역시 늘 불지만, 태풍의 강풍과 폭풍해일은 주택과 농경지, 항만과 전력망을 무너뜨릴 수 있습니다. 기후위기는 이런 극한기상이 나타나는 조건을 바꾸고 있습니다. 지구가 따뜻해지면 폭염이 더 자주, 더 오래 이어질 가능성이 커집니다. 따뜻한 공기는 더 많은 수증기를 머금을 수 있어, 비가 내릴 때 한꺼번에 더 많은 비가 쏟아질 조건도 만들어집니다. 해수면 상승은 폭풍해일과 해안 침수의 위험을 높입니다. 평균기온의 작은 변화가 극단적인 날씨의 가능성을 크게 흔들 수 있는 이유입니다.
AI는 이러한 위험을 더 일찍 감지하고 더 구체적으로 파악하는 데 활용됩니다. 위성 영상과 레이더 자료에서 빠르게 발달하는 폭풍, 산불 연기, 강수 구름을 찾아내고, 좁은 지역의 집중호우와 홍수 가능성을 예측할 수 있습니다. 폭염과 가뭄의 위험 지역을 표시해 전력 공급, 농작물 관리, 주민 보호 대책을 미리 준비하도록 도울 수도 있습니다. AI의 역할은 “비가 얼마나 올까”를 맞히는 데서 끝나지 않습니다. 같은 양의 비가 내려도 피해는 지역마다 다르게 나타납니다. 경사가 급한 지형인지, 하천과 배수 시설이 충분한지, 땅이 얼마나 포장되어 있는지에 따라 침수 위험은 달라집니다. 주택의 상태, 인구 구성, 도로와 병원의 위치도 재난 피해에 영향을 줍니다. AI는 기상 자료와 지형, 도시, 인구 정보를 함께 분석해 어느 지역에서 피해가 커질 가능성이 높은지 추정할 수 있습니다.
그러나 예측이 정확하다고 해서 자동으로 사람이 보호되는 것은 아닙니다. 폭우를 예측해도 경보가 늦게 전달되면 대피할 시간이 없습니다. 폭염 위험을 알아도 냉방 시설이나 쉴 공간을 이용할 수 없다면 피해를 피하기 어렵습니다. 산불 가능성을 예측해도 소방 인력과 대피로가 준비되어 있지 않으면 위험은 줄어들지 않습니다. AI 예측은 경보 체계, 재난 행정, 도시계획, 현장 대응과 연결될 때 비로소 생명을 지키는 정보가 됩니다. 따라서 기후 AI의 가치는 예측 정확도만으로 평가할 수 없습니다. 위험을 얼마나 일찍 알려주었는지, 사람들이 그 의미를 이해하고 행동할 수 있었는지, 실제 피해를 얼마나 줄였는지도 중요합니다. 좋은 예측은 미래를 잘 맞히는 데서 그치지 않고, 더 나은 결정을 가능하게 해야 합니다.
극한기상은 사회의 취약성도 드러냅니다. 같은 폭염이라도 냉방이 가능한 집에서 일하는 사람과 야외에서 일하는 사람이 받는 피해는 다릅니다. 같은 홍수도 안전한 아파트에 사는 사람과 반지하나 하천변 주택에 사는 사람에게 다르게 닥칩니다. 재난은 자연현상이지만, 피해의 크기는 주거, 소득, 건강, 노동 조건에 따라 달라집니다. 이 때문에 AI는 날씨의 위험뿐 아니라 지역의 취약성도 함께 살펴야 합니다. 독거노인이 많은 지역, 의료시설에서 먼 지역, 침수에 약한 주거지가 밀집한 지역을 파악하면 지원의 우선순위를 정하는 데 도움이 됩니다. 다만 이 과정에서는 개인정보와 민감한 사회 정보가 쓰일 수 있으므로, 필요한 자료를 안전하게 관리하고 분석 결과가 차별이나 낙인으로 이어지지 않도록 해야 합니다. 지역 주민의 경험도 중요합니다. 주민들은 어느 골목이 먼저 잠기는지, 어떤 바람이 불 때 파도가 높아지는지, 어느 산비탈이 폭우 뒤 위험해지는지를 알고 있습니다. AI의 넓은 분석 능력과 지역사회의 구체적인 기억이 만날 때 위험 판단은 더 정확하고 실용적인 정보가 됩니다.
기후위기 시대의 AI는 재난을 구경하기 위한 기술이 아닙니다. 다가오는 위험을 더 일찍 알아차리고, 피해가 커질 곳을 먼저 찾으며, 가장 취약한 사람부터 보호하기 위한 준비의 기술입니다. AI가 위험을 더 빠르고 세밀하게 읽을수록, 그 예측을 실제 행동과 공정한 보호 체계로 연결하려는 사회의 책임도 함께 커집니다.
6.6 지구 시스템은 하나의 연결망이다
숲의 나무 한 그루는 홀로 서 있는 것처럼 보이지만, 뿌리와 균류, 토양과 물길, 곤충과 새를 통해 주변 생태계와 연결되어 있습니다. 지구도 이와 비슷합니다. 대기와 바다, 얼음과 땅, 생명체와 인간 활동은 따로 움직이지 않습니다. 서로 영향을 주고받으며 하나의 거대한 연결망을 이룹니다. 이렇게 지구를 분리된 부품의 모음이 아니라 서로 얽힌 전체로 보는 관점을 지구 시스템(Earth system)이라고 합니다.
인간 활동과 지구 시스템
바다는 태양열을 저장하고 해류를 통해 옮깁니다. 대기는 열과 수증기를 여러 지역으로 나릅니다. 눈과 얼음은 햇빛을 반사해 지구의 온도 조절에 영향을 주고, 숲과 토양은 탄소와 물의 순환에 참여합니다. 도시와 산업은 온실가스를 배출하고 지표의 성질을 바꾸어 다시 대기와 생태계에 영향을 줍니다. 한 영역의 변화가 그 자리에만 머물지 않는 것이 지구 시스템의 특징입니다. 아파트의 수도관과 배수관을 떠올리면 이 연결을 이해하기 쉽습니다. 한 집의 누수가 아래층의 피해로 이어지고, 한 지점의 막힘이 여러 가구의 생활에 영향을 줄 수 있습니다. 지구에서도 바다의 온도 변화가 대기의 흐름을 바꾸고, 그 변화가 멀리 떨어진 지역의 비와 가뭄에 영향을 줄 수 있습니다. 기후 문제는 한 장소의 사건처럼 보이지만, 실제로는 여러 장소와 과정이 연결된 결과인 경우가 많습니다.
이 연결 속에서는 변화가 다시 자신에게 돌아와 영향을 주기도 합니다. 예를 들어 기온이 올라 얼음이 줄어들면 햇빛을 반사하는 흰 표면이 줄어듭니다. 그러면 바다와 땅이 더 많은 열을 흡수하고, 온난화가 더 강해질 수 있습니다. 이렇게 어떤 변화가 다시 원래의 변화를 키우거나 줄이는 작용을 되먹임(feedback)이라고 합니다. 되먹임은 지구 시스템을 이해할 때 매우 중요하지만, 그 결과가 언제나 단순하게 나타나는 것은 아닙니다. AI는 이런 복잡한 연결을 분석하는 데 도움을 줄 수 있습니다. 위성, 해양 부표, 지상 관측소, 기후 모델, 토지 이용 자료를 함께 분석하면 대기와 바다, 육지와 생태계가 어떻게 영향을 주고받는지 더 넓게 살펴볼 수 있습니다. 특히 한 지역의 바다 온도 변화가 멀리 떨어진 대륙의 강수량에 영향을 주는 것처럼, 사람이 직관만으로 파악하기 어려운 원거리 연결을 찾아내는 데 AI가 유용합니다.
AI는 산림 훼손, 빙하 감소, 해수면 상승, 가뭄 위험 같은 변화를 감시하고 지도화할 수 있습니다. 또 재생에너지 발전량이나 전력 수요처럼 기후와 사회가 만나는 영역도 예측할 수 있습니다. 중요한 점은 AI가 단순히 자료를 많이 처리한다는 데 있지 않습니다. 서로 다른 자료를 연결해 “어느 변화가 어디로 퍼질 수 있는가”, “어떤 지역이 더 취약한가”, “어떤 대응이 먼저 필요한가”를 가늠하도록 돕는 데 있습니다. 그러나 AI가 연결을 발견했다고 해서 곧바로 원인을 확정할 수 있는 것은 아닙니다. 두 현상이 함께 변한다고 해서 하나가 다른 하나를 직접 일으켰다고 단정할 수는 없습니다. 예를 들어 홍수 피해가 늘었다면 강수량 증가뿐 아니라 도시 개발, 산림 훼손, 배수 시설, 주거 조건이 함께 작용했을 수 있습니다. AI가 연관성을 보여 주더라도, 그 관계가 물리적으로 타당한지 확인하고 실제 원인을 구분하려면 과학적 해석과 현장 조사가 필요합니다.
따라서 지구 시스템을 다루는 AI의 역할은 결론을 대신 내려주는 데 있지 않습니다. AI는 넓은 연결망 속에서 위험의 신호를 찾고, 변화가 퍼질 가능성이 큰 경로를 보여 주며, 대응의 우선순위를 세우는 데 필요한 근거를 제공합니다. 하지만 어떤 위험을 먼저 줄일 것인지, 어떤 비용을 감수할 것인지, 누구를 우선적으로 보호할 것인지는 사회가 판단해야 할 문제입니다. 지구 시스템의 관점에서 보면, 좋은 해결책은 한 부분만 개선하는 데서 끝나지 않습니다. 재생에너지를 확대하더라도 전력망과 저장 장치가 함께 준비되어야 하고, 산림을 늘리는 정책도 지역의 물 사용과 생태계, 주민의 삶을 함께 고려해야 합니다. 한 부분의 개선이 다른 부분의 부담으로 돌아가지 않는지 살펴보아야 합니다. AI는 이러한 연결과 부작용을 미리 검토하는 데 도움을 줄 수 있습니다.
결국 지구 시스템 AI는 미래를 점치는 장치가 아닙니다. 지구의 여러 변화가 어떻게 이어지고 어디에서 위험이 커지는지를 더 선명하게 보여 주는 연결 지도입니다. 예측은 불확실한 미래를 현재의 판단으로 가져오는 언어입니다. AI가 그 지도를 더 빠르고 정밀하게 그릴수록, 우리는 그 정보를 책임 있는 선택과 행동으로 바꾸어야 합니다.
6.7 물리 일관성이라는 조건
잘 짜인 판타지 소설은 아무리 낯선 마법이 등장해도 자기 세계의 규칙을 지킵니다. 앞 장면에서 정한 조건이 뒤 장면에서 아무 이유 없이 바뀌고, 원인 없이 힘이 생겨난다면 이야기는 설득력을 잃습니다. 기상 AI의 예측도 마찬가지입니다. 결과가 그럴듯해 보여도 대기 속 물과 에너지의 흐름이 서로 맞지 않으면 신뢰하기 어렵습니다. 날씨에는 자연의 장부가 있습니다. 물은 아무 이유 없이 생기거나 사라지지 않고, 에너지는 한 형태에서 다른 형태로 바뀌며 이동합니다. 바람은 기압 차이와 지구의 자전, 지표면의 마찰에 영향을 받습니다. 비와 구름, 기온과 바람도 따로 움직이는 숫자가 아니라 하나의 물리적 과정으로 연결되어 있습니다. 예측 결과가 이러한 기본 법칙과 모순되지 않는 성질을 물리 일관성(physical consistency)이라고 합니다.
AI 예보와 물리 일관성
예를 들어 AI가 특정 지역에 기록적인 폭우를 예측했다면, 그 비를 만들 수증기가 어디에서 공급되었는지 설명할 수 있어야 합니다. 습한 공기가 어떤 바람을 타고 이동했는지, 어디에서 상승해 구름을 만들었는지, 응결하면서 내놓은 열이 대기 흐름과 어떻게 맞물렸는지도 함께 살펴야 합니다. 가계부에 출처를 알 수 없는 돈이 갑자기 나타나면 장부를 믿기 어렵듯이, 대기 예측에서도 물과 에너지의 출처가 맞아야 합니다. AI 모델은 과거 자료에서 날씨 변화의 패턴을 학습해 빠른 예측을 내놓을 수 있습니다. 그러나 과학적 예측에서는 몇몇 수치를 잘 맞히는 것만으로 충분하지 않습니다. 온도, 기압, 바람, 습도, 강수량이 서로 자연스럽게 연결되어야 합니다. 각 항목은 그럴듯하지만 전체적으로 물리 법칙과 어긋난다면 실제 대기의 상태를 올바르게 표현한 예측이라고 보기 어렵습니다.
물리 일관성은 낯선 조건을 예측할 때 더욱 중요합니다. AI는 학습 자료와 비슷한 상황에서는 익숙한 패턴을 잘 찾아냅니다. 그러나 기후변화로 해수면 온도와 대기 중 수증기량, 극한기상의 범위가 달라지면 과거에는 드물었던 조건이 더 자주 나타날 수 있습니다. 이런 상황에서는 과거 자료의 패턴만으로 부족합니다. 자연의 기본 법칙이 AI 예측을 점검하는 기준이 되어야 합니다. 이 점은 물리 법칙을 AI 학습에 반영하려는 접근과도 이어집니다. AI가 데이터를 학습할 때 질량 보존, 에너지 보존, 공기와 수증기의 흐름 같은 조건을 함께 고려하도록 만들 수 있습니다. 예측을 만든 뒤 물리적으로 가능한지 검사할 수도 있고, 처음부터 자연의 제약을 어기지 않도록 모델을 설계할 수도 있습니다. AI의 유연성과 물리학의 규율이 함께 필요합니다.
그렇다고 AI를 기존 물리 방정식 안에만 가두어야 한다는 뜻은 아닙니다. AI의 강점은 방대한 관측 자료와 계산 결과에서 복잡한 관계를 빠르게 찾아내는 데 있습니다. 기존 기상 모델이 충분히 표현하지 못한 작은 규모의 변화나 반복되는 오차를 보완하는 데도 도움이 될 수 있습니다. 물리학은 예측이 넘어서는 안 될 경계를 제공하고, AI는 그 경계 안에서 더 빠른 계산 경로와 새로운 패턴을 찾아냅니다. 물리 일관성은 학술적인 조건에만 머물지 않습니다. 폭우, 태풍, 폭염, 산불 예측은 행정기관의 대응과 시민의 행동으로 이어집니다. “AI가 폭우를 예측했다”는 말만으로는 충분하지 않습니다. 많은 수증기가 특정 지역으로 유입되고, 산맥이나 정체전선 때문에 공기가 강하게 상승하며, 이미 내린 비로 토양과 하천이 포화되어 있다는 설명이 함께 제시될 때 위험의 의미가 분명해집니다.
예보는 숫자를 내놓는 일에서 끝나지 않습니다. 그 숫자가 왜 가능한지 설명하고, 사람들이 제때 행동할 수 있도록 전달해야 합니다. 예보관과 재난 담당자는 AI의 결과가 최신 관측과 맞는지, 지역의 지형과 사회적 조건에 맞는지, 불확실성은 어느 정도인지 함께 판단해야 합니다. AI는 경보를 자동으로 누르는 버튼이 아니라, 인간의 판단을 돕는 분석 도구여야 합니다. 결국 좋은 기상 AI는 빠른 예측과 물리적 신뢰를 함께 갖추어야 합니다. AI는 미래의 날씨를 이전보다 빠르게 계산할 수 있지만, 그 결과가 자연의 장부와 맞는지 확인하는 일은 필수적입니다. 좋은 예보란 정확한 숫자만 제시하는 예보가 아니라, 그 숫자가 왜 가능한지 설명하고 사람들이 위험에 대비할 시간을 마련해 주는 예보입니다.
6.8 AI 예보의 한계와 책임
어촌의 어민에게 풍랑 예보는 생명의 문제이고, 농민에게 가뭄 예보는 수확의 문제이며, 야외 노동자에게 폭염 경보는 건강의 문제입니다. 같은 예보라도 사람의 직업과 주거 환경, 건강 상태에 따라 전혀 다른 의미를 가집니다. 예측은 하나의 숫자로 발표되지만, 위험은 모두에게 똑같이 찾아오지 않습니다.
AI 기후 예측과 대비 결정
AI는 폭우, 폭염, 태풍, 산불 위험을 더 빠르게 감지하고 지역별 위험도를 계산하는 데 도움을 줄 수 있습니다. 그러나 정확한 예측만으로 사람을 지킬 수는 없습니다. 폭염을 예측해도 노동을 멈출 제도나 쉴 수 있는 냉방 공간이 없다면 위험은 줄어들지 않습니다. 집중호우 경보가 있어도 대피 수단과 안전한 거처가 없다면 취약한 사람들은 여전히 위험 속에 남습니다. 좋은 예보는 계산의 문제가 아니라 전달과 행동의 문제이기도 합니다. 따라서 AI 예보는 시민이 이해하고 행동할 수 있는 언어로 전달되어야 합니다. “시간당 80밀리미터의 비”라는 수치만으로는 부족할 수 있습니다. 어느 도로와 지하차도가 침수될 수 있는지, 언제 이동을 피해야 하는지, 어디로 대피해야 하는지를 함께 알려야 합니다. 예측의 가치는 숫자를 맞히는 데서 끝나지 않고, 그 숫자가 생활 속에서 무엇을 뜻하는지 설명할 때 커집니다.
AI 예보에는 한계도 있습니다. AI는 주로 과거의 대기 상태와 그 뒤의 변화를 학습합니다. 그러나 기후변화는 더 따뜻한 바다, 달라진 토지 이용, 빠른 도시화처럼 과거와 다른 조건을 만들어냅니다. 과거 자료에 드물게 나타난 기록적 폭우나 이례적 폭염은 AI가 충분히 배우지 못했을 수 있습니다. 평범한 날씨를 잘 맞히는 모델도 사회적으로 가장 위험한 극한 현상을 놓칠 수 있습니다. 또한 AI가 내놓은 예측은 자연의 흐름과 맞는지 점검되어야 합니다. 폭우를 예측했다면 그만한 수증기 공급과 상승 기류가 설명되어야 하고, 태풍의 경로 변화도 주변 기압과 바람의 흐름 속에서 이해되어야 합니다. 이렇게 예측이 자연의 기본 법칙과 어긋나지 않는지를 살피는 조건을 물리 일관성(physical consistency)이라고 합니다. AI 예보는 빠를수록 좋지만, 빠른 예측일수록 관측 자료와 물리적 타당성의 검사를 함께 거쳐야 합니다.
책임 있는 예보는 불확실성도 숨기지 않습니다. 하나의 단정적인 결과만 제시하기보다 어느 지역과 시간대에서 위험이 커지는지, 가능한 범위가 어디까지인지, 예측의 신뢰도가 어느 정도인지를 함께 알려야 합니다. 불확실성을 밝히는 것은 자신감이 부족하다는 뜻이 아니라, 시민과 행정이 상황에 맞는 결정을 내리도록 돕는 과학적 정직성입니다.
AI는 지역별 위험과 취약성을 파악해 경보와 지원의 우선순위를 정하는 데에도 도움을 줄 수 있습니다. 하지만 이 과정에서 주거, 건강, 이동, 소득 같은 민감한 정보가 쓰일 수 있습니다. 필요한 정보만 안전하게 사용하고, 특정 지역이나 집단이 낙인찍히지 않도록 관리해야 합니다. 사람을 보호하기 위한 예측이 감시와 차별의 도구가 되어서는 안 됩니다. 결국 AI 예보는 틀리지 않는 기계를 만드는 일이 아닙니다. 불확실한 미래를 더 빨리 읽고, 그 한계를 정직하게 설명하며, 위험에 놓인 사람에게 필요한 정보를 제때 전달하는 체계를 만드는 일입니다. 좋은 예보의 기준은 정확도에만 있지 않습니다. 누구에게 정보가 도달했는지, 누가 실제로 행동할 수 있었는지, 그리고 피해를 얼마나 줄였는지가 함께 평가되어야 합니다.
>기후 AI는 미래의 공동 언어 > >동아시아의 농사력은 하늘의 변화를 삶의 리듬과 연결한 지혜였습니다. 언제 씨를 뿌릴지, 언제 물을 댈지, 언제 수확할지 아는 것은 생존의 문제였습니다. 하늘을 읽는 일은 단순한 관찰이 아니라 공동체의 삶을 조율하는 일이었습니다. 오늘날의 기후 AI는 수백 대의 위성과 거대한 신경망 알고리즘을 동원해, 이 오래되고 절박한 '하늘 읽기'를 현대의 언어로 다시 수행하고 있습니다. 기후 AI가 쏟아내는 위험의 수치들은 이제 정치인, 과학자, 기업가, 그리고 평범한 시민들이 함께 둘러앉아 미래를 논의하기 위한 '공동의 언어'가 되어야 합니다. 철학자 한스 요나스가 갈파했듯, 아직 태어나지 않은 미래 세대는 오늘 우리가 저지른 탄소 배출과 환경 파괴에 대해 시위를 벌이거나 투표할 권리가 없습니다. 그렇기에 기후 AI가 현재 우리 눈앞에 들이미는 파국적인 시뮬레이션 지도는, 미래 세대의 멱살을 잡은 우리가 마땅히 느껴야 할 뼈저린 '책임감'의 다른 이름입니다. >
>
제7강. 천문학과 우주 데이터
어두운 밤길을 걷다 저 멀리 작은 불빛 하나를 마주쳤다고 상상해 봅시다. 우리는 그 불빛의 크기, 깜빡임, 다가오는 속도를 가늠하며 그것이 누군가의 집인지, 달려오는 자동차인지, 먼 바다의 등대인지 끊임없이 '추정'합니다. 천문학은 바로 이 추정의 예술이자 과학입니다. 닫힌 방 밖에서 들리는 발소리만으로 누구인지 짐작해야 하는 상황과 같습니다. 우리는 우주의 방문을 열고 나가 별을 직접 만져볼 수 없고, 블랙홀의 중심을 들여다볼 수 없으며, 138억 년 전의 빅뱅을 다시 재생할 수도 없습니다. 우주 과학은 철저히 빛, 전파, 중력파라는 미세한 '흔적'에 기대어 보이지 않는 실체를 재구성하는 간접 증거의 학문입니다. 오늘날 인공지능은 인간이 평생을 바쳐도 다 읽지 못할 이 아득하고 희미한 흔적들의 바다를 순식간에 훑어내어, 미세한 신호와 이상한 후보들을 건져 올리고 있습니다. 하지만 명심해야 합니다. 많이 보게 되었다는 것은, 그만큼 오류와 착시에 더 쉽게 노출되었다는 뜻이기도 합니다.
미세한 신호를 읽는 우주 AI
7.1 우주는 왜 데이터의 문제가 되었는가
어두운 밤길에서 멀리 작은 불빛 하나를 보았다고 상상해 보겠습니다. 우리는 그 불빛의 크기와 깜빡임, 움직이는 속도를 보며 그것이 집의 창문인지, 다가오는 자동차인지, 먼 바다의 등대인지 추정합니다. 천문학도 이와 비슷합니다. 우리는 별을 직접 만져볼 수 없고, 블랙홀의 중심을 들여다볼 수 없으며, 138억 년 전 우주의 시작을 다시 재생할 수도 없습니다. 천문학은 빛, 전파, 중력파(gravitational wave)처럼 우주가 남긴 희미한 흔적을 읽어 보이지 않는 실체를 재구성하는 학문입니다.
스스로 신호를 분류하는 우주 AI
오늘날 이 흔적의 양은 폭발적으로 늘어나고 있습니다. 광학망원경은 눈에 보이는 별빛을 모으고, 전파망원경은 보이지 않는 파장의 신호를 포착합니다. 적외선, 자외선, 엑스선, 감마선 관측 장비는 각각 다른 얼굴의 우주를 보여 줍니다. 여기에 중력파 검출기는 빛으로는 볼 수 없는 블랙홀이나 중성자별의 충돌을 시공간의 미세한 흔들림으로 감지합니다. 우주는 더 이상 하나의 사진으로만 기록되지 않습니다. 여러 종류의 신호가 겹쳐진 거대한 데이터의 장으로 다가옵니다. 시간에 따라 우주를 반복해서 관찰하는 일도 중요해졌습니다. 같은 하늘을 여러 번 찍으면 별의 밝기가 변하거나, 갑작스러운 폭발이 일어나거나, 천체가 움직이거나, 행성이 별 앞을 지나며 빛을 잠시 가리는 장면을 발견할 수 있습니다. 이렇게 우주를 정지된 풍경이 아니라 시간에 따라 변하는 과정으로 보는 관점을 시간의 축(time axis)이라고 할 수 있습니다. 천문학은 이제 하늘의 한순간을 찍는 학문을 넘어, 우주가 어떻게 변하는지 추적하는 학문으로 확장되고 있습니다.
이 변화 속에서 AI는 강력한 도구가 됩니다. 천문 관측 자료는 이미 인간이 하나하나 살펴보기 어려울 만큼 방대합니다. AI는 수많은 은하 이미지를 형태에 따라 분류하고, 별빛의 스펙트럼(spectrum), 곧 빛을 파장별로 나눈 무늬에서 온도와 화학 성분을 추정하며, 시간에 따른 밝기 변화에서 초신성이나 외계행성 후보를 찾아낼 수 있습니다. 중력파와 전파 신호 속에서 의미 있는 패턴을 빠르게 골라내는 데에도 활용됩니다. 그러나 AI가 우주를 대신 이해해 주는 것은 아닙니다. AI는 거대한 천문 데이터베이스에서 먼저 살펴볼 대상을 좁혀 주는 탐색자에 가깝습니다. 비슷한 자료를 분류하고, 서로 떨어진 기록을 연결하며, 평범한 패턴과 다른 이상 신호를 표시합니다. 연구자는 그 후보가 실제 천체 현상인지, 장비의 잡음인지, 우연한 오류인지 다시 검토해야 합니다. 후보를 많이 찾는 능력과 참된 발견을 가려내는 능력은 다르기 때문입니다.
천문 데이터에는 언제나 장비의 한계와 관측의 편향이 들어 있습니다. 어떤 망원경은 밝은 천체를 잘 보지만 희미한 천체를 놓칠 수 있고, 특정 파장에서만 드러나는 현상도 있습니다. 우리가 보는 우주는 우주 전체가 아니라, 장비가 감지할 수 있는 우주의 일부입니다. AI 역시 이 한계를 물려받습니다. 학습 자료에 익숙한 천체는 잘 분류하지만, 전에 보지 못한 현상은 놓칠 수 있고, 영상의 잡음이나 장비의 흔적을 실제 우주 신호로 착각할 수도 있습니다. 그래서 천문학에서 AI의 역할은 발견을 완성하는 것이 아니라 발견의 가능성을 넓히는 데 있습니다. AI가 초신성 후보를 찾으면 다른 망원경으로 다시 관측해야 하고, 외계행성 후보는 반복되는 밝기 변화와 별 자체의 활동을 함께 비교해야 합니다. 중력파나 전파 신호도 여러 검출기와 관측 자료를 대조해야 과학적 증거가 됩니다. 우주 데이터의 시대에도 검증은 여전히 천문학의 핵심입니다.
결국 AI는 천문학자를 대체하는 눈이 아니라, 인간의 눈이 닿지 못하는 방대한 자료를 먼저 훑어 주는 새로운 관측 도구입니다. 천문학자는 하늘을 바라보는 사람에서, 하늘이 남긴 데이터의 문법을 읽는 사람으로 역할을 넓혀 가고 있습니다. 이번 강에서는 우주 데이터가 어떻게 만들어지고, AI가 그 속에서 어떤 신호를 찾아내며, 그 발견이 과학적 지식이 되기 위해 어떤 검증을 거쳐야 하는지 살펴보겠습니다.
7.2 빛은 우주의 편지다
밀봉된 향수병을 열지 않아도 새어 나오는 향기로 그 안의 성분을 어느 정도 짐작할 수 있습니다. 천문학자도 별과 은하를 직접 만질 수는 없지만, 수십억 년 동안 우주를 건너온 빛을 통해 그 성질을 알아냅니다. 빛은 먼 천체가 지구로 보내온 편지와 같습니다. 다만 그 편지는 글자가 아니라 밝기, 색, 파장, 시간에 따른 변화로 쓰여 있습니다.
별빛 스펙트럼을 읽는 우주 AI
별빛은 우주가 보낸 편지이고, 스펙트럼은 그 편지에 적힌 물질과 운동의 글자입니다.
별빛을 자세히 나누어 보면 그 안에 여러 단서가 숨어 있습니다. 프리즘을 통과한 햇빛이 여러 색으로 갈라지듯, 천체에서 온 빛도 파장별로 펼쳐 볼 수 있습니다. 이렇게 빛을 나누어 천체의 성질을 읽는 방법을 분광학(spectroscopy)이라고 하고, 파장별로 펼쳐진 빛의 무늬를 스펙트럼(spectrum)이라고 합니다. 스펙트럼에는 특정한 파장의 빛이 강해지거나 약해진 가느다란 선들이 나타납니다. 원소마다 빛을 흡수하고 내보내는 파장이 다르기 때문에, 이 선들은 물질의 지문처럼 작용합니다. 천문학자는 이 선들을 분석해 별과 은하가 어떤 원소로 이루어졌는지, 온도가 얼마나 높은지, 주변의 가스와 먼지가 빛에 어떤 영향을 주었는지 추정합니다.
스펙트럼은 천체의 움직임도 알려 줍니다. 구급차가 가까워질 때와 멀어질 때 사이렌 소리가 다르게 들리듯, 빛도 천체의 운동에 따라 파장이 조금 달라집니다. 빛이 더 긴 파장 쪽으로 밀리면 대체로 멀어지고 있다는 뜻이고, 짧은 파장 쪽으로 밀리면 가까워지고 있다는 단서가 됩니다. 우주가 팽창한다는 사실도 수많은 은하의 빛이 긴 파장 쪽으로 이동해 있다는 관측에서 밝혀졌습니다. 오늘날 관측 장비는 엄청난 양의 스펙트럼 자료를 만들어냅니다. 사람이 하나씩 들여다보기에는 너무 많고, 그 안의 차이는 때로 매우 작습니다. AI는 이 방대한 자료를 빠르게 비교해 비슷한 별과 은하를 분류하고, 천체의 성질과 움직임을 추정하며, 일반적인 유형과 다른 이상 신호를 찾아낼 수 있습니다. 말하자면 AI는 우주의 편지를 먼저 정리하고, 밑줄 칠 만한 문장을 표시해 주는 조력자입니다.
예를 들어 AI는 수많은 별빛 자료 가운데 희귀한 화학 성분을 지닌 별을 골라내거나, 먼 은하의 파장 이동을 추정하고, 기존 분류에 잘 맞지 않는 후보를 찾아낼 수 있습니다. AI가 “이 자료는 조금 다릅니다”라고 알려 주면, 연구자는 그 대상을 다시 관측하고 더 자세히 분석합니다. AI의 역할은 발견을 끝내는 것이 아니라, 연구자가 집중해서 살펴볼 대상을 좁혀 주는 데 있습니다. 그러나 망원경에 도착한 빛이 우주의 상태를 그대로 보여 주는 것은 아닙니다. 빛은 천체 주변의 가스와 먼지를 지나며 흡수되거나 흩어질 수 있고, 지상 망원경으로 관측할 때는 지구 대기의 영향도 받습니다. 망원경과 검출기의 특성, 자료 처리 과정 역시 데이터에 흔적을 남깁니다. 오래 여행한 편지에 얼룩이 묻고 일부 글자가 흐려지는 것과 비슷합니다.
별빛이 데이터가 되는 과정
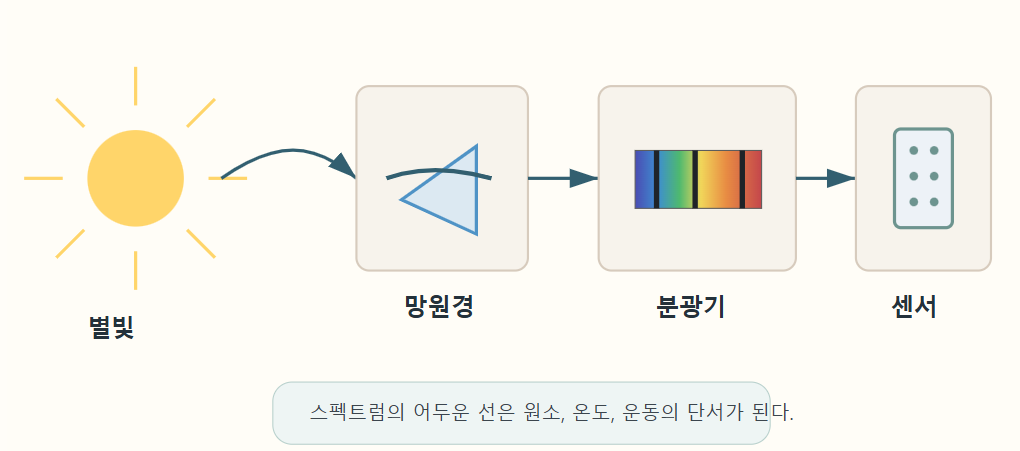
분광학은 별빛을 파장별로 펼쳐 원소와 온도, 운동의 단서를 읽게 해 주는 우주 번역 장치입니다.
따라서 천문 AI의 판단도 검증이 필요합니다. AI가 어떤 신호를 찾아냈다고 해서 그것이 곧 실제 천체 현상이라는 뜻은 아닙니다. 검출기의 잡음이나 장비의 흔적을 우주의 신호로 잘못 볼 수도 있고, 학습 자료에 익숙한 천체만 잘 알아보며 낯선 대상을 놓칠 수도 있습니다. AI가 높은 확률로 분류했다는 사실은 중요한 단서이지만, 과학적 결론은 아닙니다. 좋은 천문 AI는 빠른 분류 능력과 함께 신중한 해석을 필요로 합니다. AI가 제시한 후보는 관측 장비의 특성, 자료의 품질, 다른 물리적 설명의 가능성과 함께 검토되어야 합니다. 필요하다면 다른 망원경과 다른 파장으로 다시 확인해야 합니다. 우주의 편지는 한 번 읽고 끝나는 문서가 아니라, 여러 번 대조하고 해석해야 하는 오래된 기록입니다.
결국 빛은 우주가 남긴 정보이고, AI는 그 정보를 빠르게 정리하고 희미한 단서를 찾아내는 도구입니다. 그러나 빛이 장비를 거쳐 데이터가 되고, 데이터가 다시 해석으로 바뀌는 과정이 투명하게 검증될 때에야 우리는 우주의 편지를 제대로 읽었다고 말할 수 있습니다.
7.3 보이지 않는 신호와 잡음
주파수가 맞지 않는 라디오를 켜면 지직거리는 소리 사이로 희미한 목소리가 들려옵니다. 우주 관측도 이와 비슷합니다. 외계행성의 흔적, 중력파의 떨림, 먼 천체의 전파 신호는 또렷한 목소리처럼 나타나지 않습니다. 대부분은 수많은 잡음 속에 묻힌 아주 작은 변화로 드러납니다. 천문 데이터에는 여러 종류의 잡음이 섞입니다. 장비가 만드는 전기적 흔들림, 지구 대기의 영향, 우주 먼지와 주변 천체의 빛, 관측 환경의 변화가 신호를 흐립니다. 자료를 보정하고 합치는 과정에서도 오류가 생길 수 있습니다. 잡음은 신호를 가릴 뿐 아니라, 때로는 실제 신호와 비슷한 모양을 만들어내기도 합니다.
잡음 속 신호를 포착하는 우주 AI
AI는 이런 자료에서 희미한 패턴을 찾는 데 강점을 보입니다. 많은 관측 자료와 모의실험을 학습한 AI는 특정 천체 현상이 남기는 전형적인 흔적을 익히고, 방대한 데이터 속에서 그와 비슷한 후보를 빠르게 골라낼 수 있습니다. 사람이 하나씩 살피기 어려운 별빛의 미세한 변화, 전파 신호, 중력파의 작은 흔들림을 먼저 표시해 연구자의 주의를 집중시킵니다. 예를 들어 외계행성이 별 앞을 지나가면 별빛이 아주 조금 어두워집니다. 중력파는 검출기 길이에 극히 작은 변화를 남기고, 빠른 전파 폭발은 짧은 순간 강한 신호를 보냅니다. 이런 현상은 자료의 양이 많고 신호가 약할수록 사람의 눈만으로 찾기 어렵습니다. AI는 수많은 후보 가운데 추가 관측이 필요한 대상을 좁혀 주는 탐색 도구가 됩니다.
그러나 패턴을 잘 찾는 능력에는 위험도 따릅니다. 구름이나 바위에서 사람 얼굴을 보듯이, AI도 우연히 생긴 흔적을 의미 있는 신호로 착각할 수 있습니다. 실제로는 아닌데 신호라고 판단하는 일을 거짓 양성(false positive), 또는 오경보라고 합니다. 반대로 실제 신호가 있는데도 잡음으로 보고 지나치는 경우는 거짓 음성(false negative)이라고 합니다. 천문 AI는 이 두 위험 사이에서 균형을 잡아야 합니다. 의심스러운 후보를 너무 많이 표시하면 연구자가 검토해야 할 대상이 폭증합니다. 반대로 기준을 지나치게 엄격하게 잡으면 드문 발견을 놓칠 수 있습니다. 따라서 천문 AI의 성능은 단순히 얼마나 많은 후보를 찾았느냐가 아니라, 실제 신호와 잡음을 얼마나 믿을 만하게 구분했느냐로 평가해야 합니다.
AI가 찾아낸 후보가 과학적 증거가 되려면 검증이 필요합니다. 먼저 그 신호가 우연히 나타났을 가능성이 얼마나 되는지 통계적으로 살펴야 합니다. 이어 다른 시점, 다른 장비, 다른 관측 방법으로도 같은 현상이 확인되는지 보아야 합니다. 신호가 알려진 물리 법칙과 천체 현상으로 설명될 수 있는지도 따져야 합니다. 예를 들어 중력파 후보라면 서로 떨어진 여러 검출기가 비슷한 시간에 같은 형태의 흔들림을 포착했는지가 중요합니다. 외계행성 후보라면 별빛 감소가 일정한 간격으로 반복되는지, 별 자체의 활동이나 다른 천체의 영향으로 설명할 수는 없는지 확인해야 합니다. 하나의 희미한 신호가 아니라 여러 증거가 같은 방향을 가리킬 때 발견의 신뢰도는 높아집니다.
이 과정에서 AI의 역할은 결론을 내리는 것이 아니라 검증을 시작하게 하는 것입니다. AI는 후보를 찾고 우선순위를 정합니다. 그러나 최종 판단은 통계 분석, 추가 관측, 물리적 해석을 함께 거쳐야 합니다. 모델이 높은 확률을 제시했다고 해서 새로운 천체나 현상이 곧바로 확정되는 것은 아닙니다. 흥미로운 신호일수록 더 신중해야 합니다. 외계 생명이나 새로운 천체처럼 대중의 관심이 큰 주제에서는 검증되지 않은 발표가 과도한 기대와 혼란을 낳을 수 있습니다. 반대로 잡음을 두려워해 낯선 신호를 모두 버려서도 안 됩니다. 새로운 발견은 종종 기존 분류에 잘 들어맞지 않는 이상한 자료에서 시작되기 때문입니다.
결국 우주 AI는 잡음 속에서 희미한 신호를 더 빠르게 찾아내는 도구입니다. 그러나 신호를 발견하는 일과 그것을 과학적 사실로 인정하는 일은 다릅니다. AI가 표시한 후보는 발견의 끝이 아니라 시작입니다. 통계, 독립 관측, 물리적 해석, 반복 검증이 더해질 때 비로소 희미한 신호는 과학적 발견이 됩니다.
7.4 중력파와 간섭계
팽팽하게 당긴 긴 밧줄의 양끝을 두 사람이 잡고 있다고 생각해 보겠습니다. 한쪽 사람이 아주 작게 손을 움직이면, 다른 사람은 손끝에 전해지는 미세한 떨림으로 그 움직임을 알아차릴 수 있습니다. 우주에서도 이와 비슷한 일이 일어납니다. 블랙홀이나 중성자별처럼 무거운 천체들이 서로를 빠르게 돌거나 충돌하면, 그 사건은 시공간에 아주 작은 떨림을 남깁니다. 이 떨림을 중력파(gravitational wave)라고 합니다.
중력파는 시공간의 떨림
중력파가 지구를 지나가면 공간은 한 방향으로 아주 조금 늘어나고, 그와 직각인 방향으로는 아주 조금 줄어듭니다. 문제는 그 변화가 너무 작다는 데 있습니다. 일반 망원경이나 자로는 측정할 수 없습니다. 그래서 과학자들은 빛을 이용합니다. 레이저 빛을 둘로 나누어 서로 직각인 긴 통로로 보냈다가 다시 합치면, 두 빛이 지나온 길의 차이를 매우 민감하게 알아낼 수 있습니다. 이런 장치를 레이저 간섭계(laser interferometer)라고 합니다.
미국의 라이고(LIGO)는 대표적인 중력파 관측소입니다. 라이고는 서로 직각을 이루는 두 개의 긴 팔을 가진 거대한 레이저 간섭계입니다. 중력파가 지나가 두 팔의 길이가 아주 조금 달라지면, 다시 만난 레이저 빛의 무늬가 미세하게 변합니다. 과학자들은 이 변화를 분석해 시공간의 떨림을 포착합니다. 인류는 우주를 빛으로 보는 데서 나아가, 시공간의 떨림으로 듣기 시작한 셈입니다. 중력파 신호에는 충돌한 천체의 정보가 담겨 있습니다. 파동의 세기와 진동수가 어떻게 변하는지 살펴보면, 블랙홀이나 중성자별의 질량, 거리, 충돌 과정 등을 추정할 수 있습니다. 별빛의 스펙트럼이 별의 성질을 알려 주듯, 중력파의 파형은 보이지 않는 천체의 운동을 전하는 편지입니다.
하지만 이 편지는 매우 희미합니다. 검출기에는 지진, 바람, 차량의 움직임, 장비의 진동 같은 잡음도 함께 섞입니다. 중력파 신호는 이 잡음 속에 묻힌 아주 작은 흔들림으로 나타납니다. 따라서 중요한 일은 방대한 관측 자료 속에서 실제 우주의 신호일 가능성이 큰 부분을 빠르게 찾아내는 것입니다. AI는 바로 이 과정에서 도움을 줄 수 있습니다. 많은 모의 파형과 실제 관측 자료를 학습한 AI는 중력파 후보가 있을 만한 구간을 빠르게 표시하고, 그 신호가 블랙홀 충돌인지 중성자별 충돌인지 분류하는 데 활용될 수 있습니다. 또한 천체의 질량이나 거리 같은 정보를 신속하게 추정해, 연구자가 추가 분석할 대상을 좁히도록 도와줍니다.
LIGO가 중력파를 읽는 원리
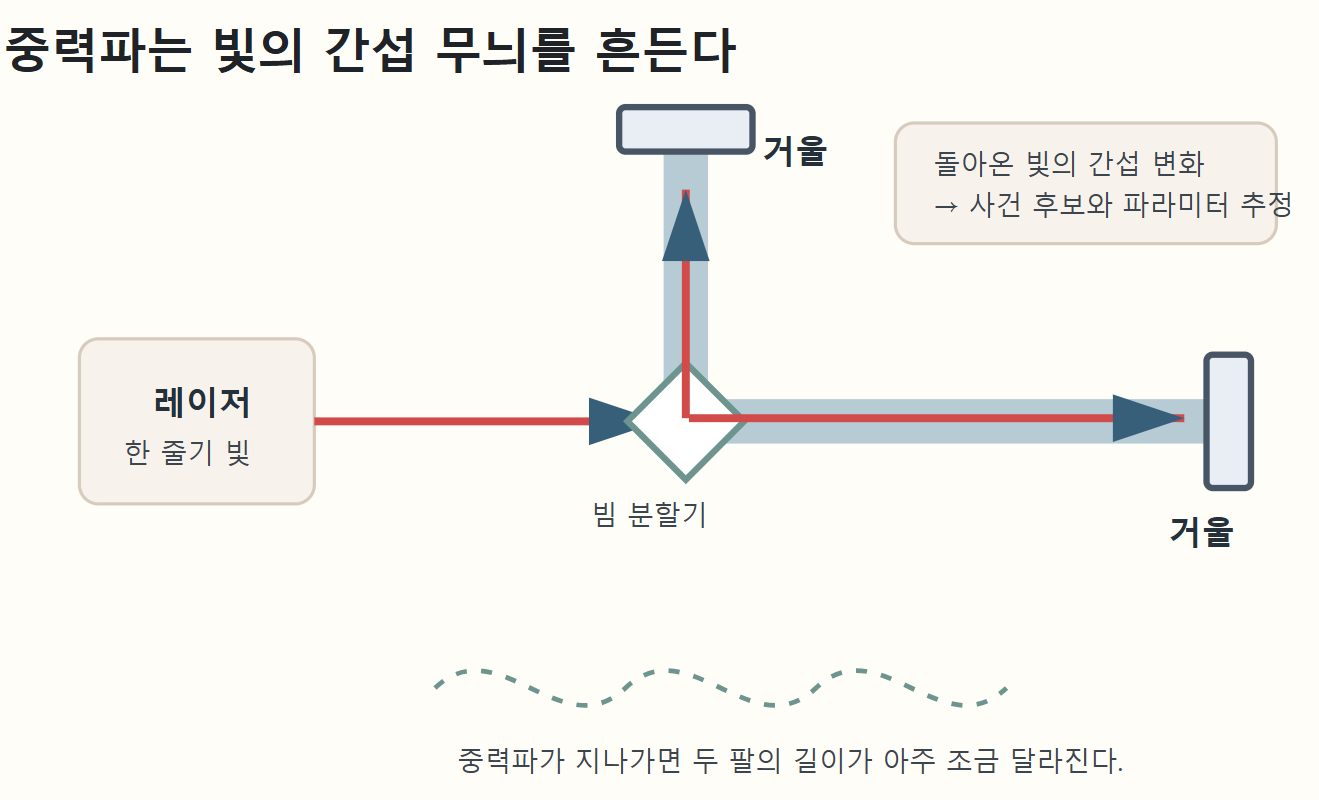
간섭계는 두 팔을 왕복한 레이저 빛의 위상 차이를 비교해 시공간의 극히 작은 흔들림을 신호로 바꿉니다.
빠른 분석은 다른 관측 장비와의 협력에도 중요합니다. 중성자별 충돌처럼 빛을 함께 낼 수 있는 사건이라면, 중력파 신호를 빠르게 찾은 뒤 여러 망원경이 곧바로 같은 방향을 관측할 수 있습니다. 하나의 우주 사건을 중력파, 빛, 전파, 중성미자 같은 여러 신호로 함께 연구하는 방식을 다중신호 천문학(multi-messenger astronomy)이라고 합니다. AI는 이 여러 신호를 더 빠르게 연결하도록 돕는 역할도 할 수 있습니다. 그러나 AI가 후보를 찾았다고 해서 곧바로 발견이 확정되는 것은 아닙니다. 장비의 일시적인 이상이나 주변 환경의 진동이 중력파처럼 보일 수도 있습니다. 따라서 서로 멀리 떨어진 여러 관측소에서 비슷한 시간에 같은 형태의 신호가 나타났는지 확인해야 합니다. 그 신호가 일반상대성이론이 예측하는 파형과 맞는지, 우연한 잡음일 가능성은 얼마나 낮은지도 통계적으로 검토해야 합니다.
결국 중력파 관측에서 AI의 역할은 발견을 대신 선언하는 것이 아니라, 희미한 후보를 빠르게 찾아내고 검증의 우선순위를 정하는 데 있습니다. AI는 우주가 남긴 아주 작은 떨림을 더 빨리 포착하도록 돕지만, 그 떨림이 정말 우주에서 온 것인지는 여러 검출기의 확인, 통계적 검증, 물리적 해석을 거쳐야 합니다. 중력파 천문학은 우리가 우주를 보는 방식이 얼마나 넓어졌는지 보여 줍니다. 우리는 이제 빛으로 보이지 않는 사건도 시공간의 흔들림으로 감지할 수 있습니다. AI는 그 희미한 흔적을 더 빠르게 찾는 도구입니다. 그러나 우주의 목소리를 제대로 듣기 위해서는 빠른 탐지와 함께 신중한 검증이 반드시 필요합니다.
7.5 외계행성과 작은 어두워짐
극장 스크린 앞을 사람이 지나가면 빛이 잠시 가려집니다. 천문학자도 이와 비슷한 원리로 태양계 밖의 행성을 찾습니다. 다른 별 주위를 도는 행성을 외계행성(exoplanet)이라고 하는데, 대부분은 별보다 훨씬 작고 어두워 직접 보기 어렵습니다. 그래서 과학자들은 행성 자체보다, 행성이 별빛에 남기는 아주 작은 흔적을 찾습니다. 행성의 궤도가 지구에서 바라보는 방향과 잘 맞으면, 행성은 주기적으로 별 앞을 지나갑니다. 이때 별빛은 아주 조금 어두워졌다가 다시 밝아집니다. 이렇게 행성이 별 앞을 지나가며 별빛을 가리는 현상을 이용하는 방법을 통과법(transit method)이라고 합니다. 같은 간격으로 비슷한 어두워짐이 반복되면, 그 별 주위를 도는 행성이 있을 가능성이 커집니다.
외계행성 통과법
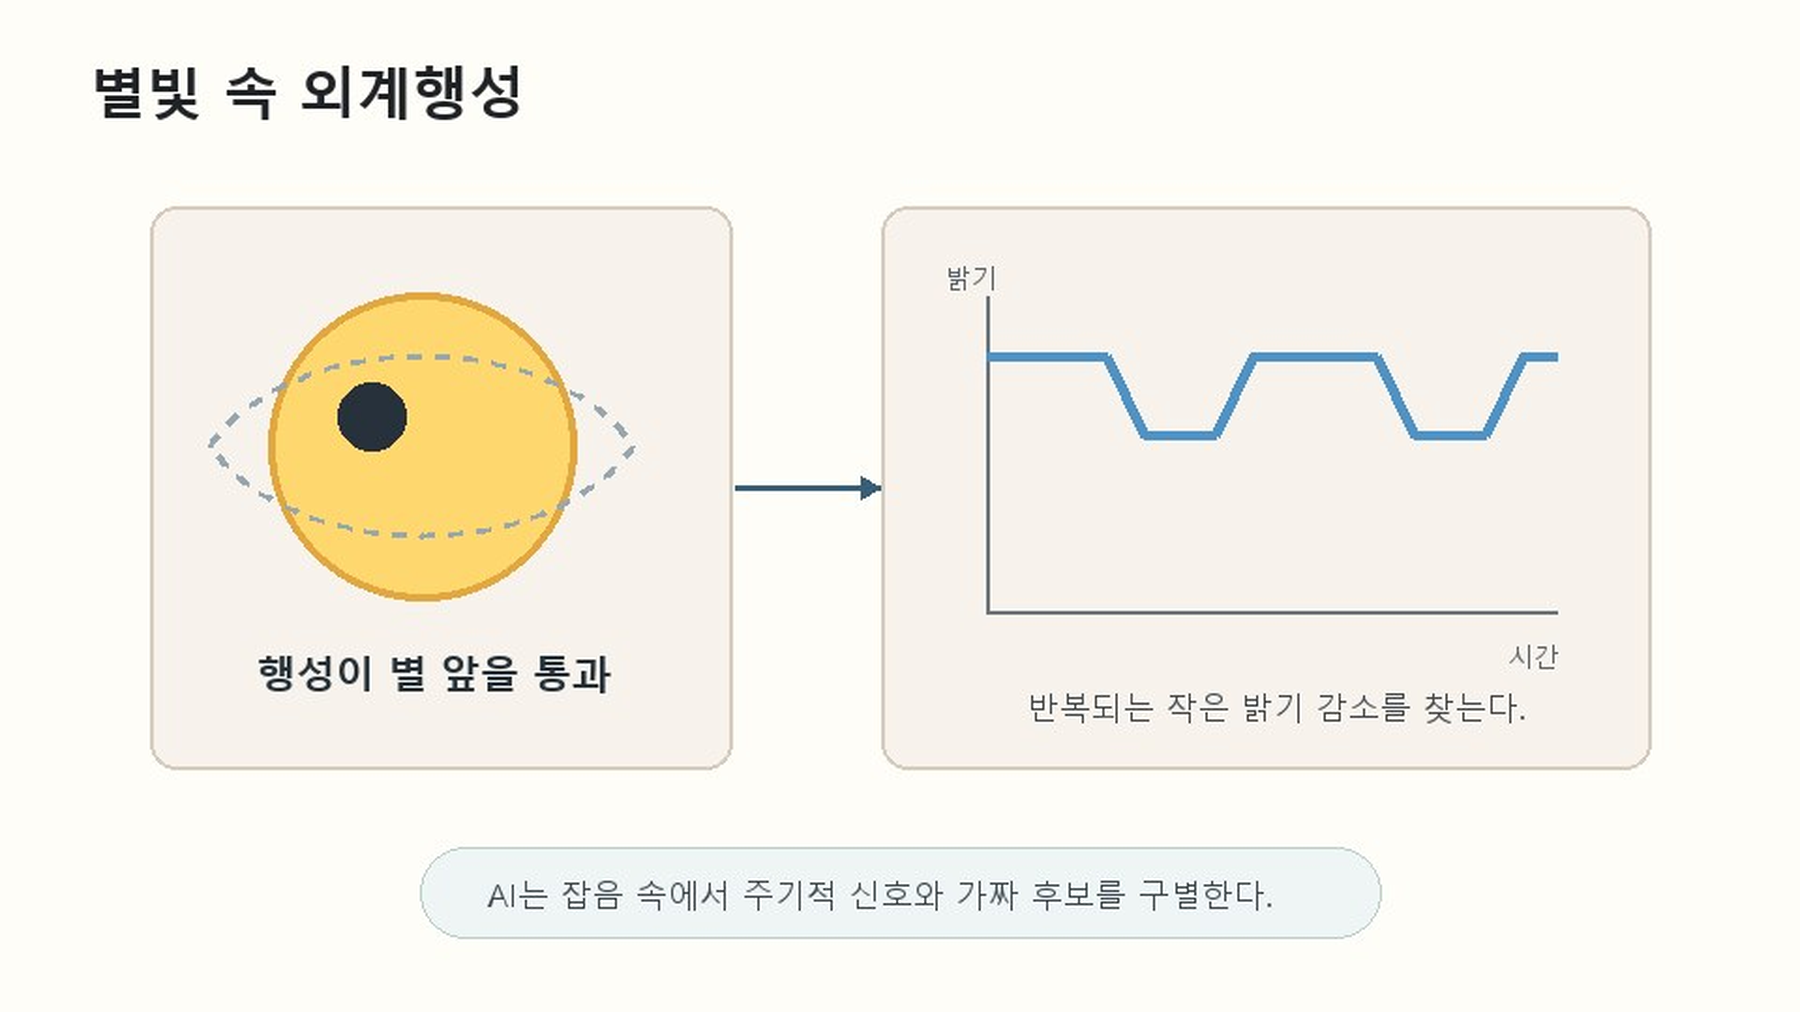
통과법은 별빛의 미세한 감소가 일정한 간격으로 반복되는지를 살펴, 보이지 않는 행성의 존재를 추론하는 방법입니다.
천문학자는 별빛의 밝기를 오랫동안 반복해서 측정합니다. 그리고 밝기가 시간에 따라 어떻게 변했는지를 그래프로 그립니다. 이 그래프를 빛의 곡선(light curve)이라고 합니다. 여기서 ‘곡선’은 빛이 휘어진다는 뜻이 아니라, 별빛의 밝기가 시간에 따라 오르내리는 모양을 선으로 나타냈다는 뜻입니다. 빛의 곡선을 보면 별빛이 얼마나 어두워졌는지, 얼마나 자주 어두워지는지, 어두워졌다가 회복되는 모양이 어떤지 알 수 있습니다. AI는 이 방대한 빛의 곡선 자료에서 행성 통과와 비슷한 패턴을 빠르게 찾아낼 수 있습니다. 우주망원경은 수많은 별의 밝기를 오랜 시간 기록하기 때문에, 사람이 모든 자료를 하나씩 살피기는 어렵습니다. AI는 반복되는 작은 어두워짐을 먼저 골라내고, 추가 분석이 필요한 외계행성 후보를 표시합니다. 특히 신호가 약하거나 잡음 속에 묻혀 있을 때, 또는 긴 시간에 걸쳐 여러 차례 반복되는 변화를 찾을 때 AI는 큰 도움이 됩니다.
그러나 별빛이 어두워졌다고 해서 반드시 행성이 지나간 것은 아닙니다. 별 표면의 흑점이나 폭발 활동도 밝기를 바꿀 수 있고, 서로 도는 두 별이 겹쳐 보이는 경우도 행성 통과와 비슷한 신호를 만들 수 있습니다. 망원경의 흔들림, 검출기의 오류, 주변 별빛의 섞임도 잘못된 후보를 만들어낼 수 있습니다. 따라서 AI가 찾은 신호는 곧바로 발견이 아니라, 검증이 필요한 후보입니다. 외계행성 후보를 확인하려면 어두워짐이 일정한 주기로 반복되는지, 빛의 곡선 모양이 행성 통과와 잘 맞는지, 별 자체의 활동으로 설명할 수는 없는지 살펴야 합니다. 다른 망원경으로 다시 관측하거나 별빛을 더 자세히 분석하는 과정도 필요합니다. AI는 후보를 빠르게 찾지만, 그 후보가 실제 행성인지 판단하려면 관측과 물리적 해석이 함께 따라야 합니다.
대표적인 검증 방법 가운데 하나는 별이 아주 조금 흔들리는지를 보는 것입니다. 행성과 별은 실제로는 별만 가만히 있고 행성만 도는 관계가 아닙니다. 둘은 서로의 공통 무게중심을 돌기 때문에, 행성은 별을 미세하게 앞뒤로 흔듭니다. 별빛의 파장이 주기적으로 조금씩 변하는지를 측정하면 이 움직임을 알 수 있습니다. 이 방법을 시선속도법(radial velocity method)이라고 합니다. 통과법으로 행성의 크기를 추정하고, 시선속도법으로 질량을 추정하면 그 행성이 암석형인지, 가스형인지도 더 잘 판단할 수 있습니다. AI는 외계행성 탐색의 속도와 범위를 크게 넓혀 줍니다. 더 많은 별을 살피고, 더 약한 밝기 변화를 찾아내며, 추가 관측이 필요한 후보의 우선순위를 정할 수 있습니다. 그러나 행성 후보가 많아진다고 해서 곧바로 생명 가능성이 입증되는 것은 아닙니다. 행성이 별에서 적당한 거리에 있다고 해도, 대기의 조성, 표면 온도, 물의 존재 가능성, 별의 활동, 행성이 지나온 역사까지 함께 살펴야 합니다.
외계행성 신호를 감지하는 우주 AI
따라서 외계행성 연구에서 AI의 역할은 “우주에 생명이 있다”는 결론을 내리는 것이 아닙니다. AI는 별빛 속의 작은 어두워짐을 더 빠르게 찾고, 연구자가 검증할 후보를 좁혀 주는 도구입니다. 작은 신호에서 행성 후보를 찾고, 추가 관측으로 실제 행성인지 확인하며, 그다음에야 환경과 생명 가능성을 조심스럽게 논의할 수 있습니다. 외계행성 탐색은 우주에 수많은 세계가 있을지 모른다는 질문에서 출발합니다. AI는 그 질문에 접근하는 속도를 높여 주지만, 가능성과 증거를 구분하는 일은 여전히 중요합니다. 별빛의 작은 어두워짐은 발견의 시작일 뿐입니다. 그것이 하나의 세계로 인정받기까지는 반복 관측, 검증, 그리고 신중한 해석이 필요합니다.
7.6 우주배경복사와 초기 우주의 흔적
오래된 벽난로에 남은 그을음은 그곳에서 한때 불이 타올랐음을 알려 줍니다. 우주에도 이와 비슷한 흔적이 남아 있습니다. 아주 오래전 우주가 뜨겁고 빽빽했던 시절의 빛이 지금도 희미하게 남아, 온 하늘에서 관측됩니다. 이 빛을 우주배경복사(cosmic microwave background, CMB)라고 합니다.
초기 우주의 지문, 우주배경복사
우주배경복사는 초기 우주가 남긴 희미한 지문이며, 그 작은 얼룩 속에 오늘날 우주 구조의 씨앗이 담겨 있습니다.
초기의 우주(early universe)는 매우 뜨겁고 밀도가 높아 빛이 멀리 나아가기 어려웠습니다. 전자와 원자핵이 따로 움직이며 빛과 계속 부딪혔기 때문입니다. 그러다 우주가 팽창하고 식으면서, 빅뱅 뒤 약 38만 년이 지났을 무렵 전자와 원자핵이 결합해 중성 원자가 만들어졌습니다. 그때부터 빛은 물질에 덜 방해받고 우주 공간을 자유롭게 이동할 수 있었습니다.
그때 풀려난 빛은 긴 시간 동안 우주의 팽창과 함께 파장이 늘어나, 오늘날에는 매우 차가운 마이크로파(microwave) 형태로 관측됩니다. 따라서 우주배경복사는 빅뱅 순간의 사진이라기보다, 우주가 처음으로 투명해졌을 때 남긴 오래된 사진에 가깝습니다. 종이 위의 사진은 아니지만, 온 하늘에 펼쳐진 빛의 지도라고 할 수 있습니다.
이 지도는 언뜻 보면 거의 균일해 보입니다. 그러나 아주 정밀하게 보면 방향에 따라 온도가 조금씩 다릅니다. 그 차이는 매우 작지만 중요합니다. 초기 우주의 물질이 완전히 고르게 퍼져 있지 않았다는 단서이기 때문입니다. 조금 더 밀도가 높았던 곳은 중력으로 주변 물질을 더 끌어당겼고, 긴 시간이 흐르며 은하와 은하단 같은 거대한 구조로 성장했습니다. 오늘날의 별과 은하는 우주배경복사에 남은 작은 얼룩의 씨앗에서 자라난 셈입니다.
AI는 이 희미한 무늬를 분석하는 데 도움을 줄 수 있습니다. 우주배경복사 지도는 방대한 관측 자료와 정교한 보정 과정을 필요로 합니다. AI는 여러 관측 자료와 우주 시뮬레이션(simulation)을 비교하면서, 실제 관측된 무늬가 어떤 우주 조건과 가장 잘 맞는지 빠르게 탐색할 수 있습니다. 우주의 나이, 물질의 분포, 암흑물질(dark matter)의 양, 초기 우주의 상태를 추정하는 과정에서도 AI는 계산의 속도와 범위를 넓혀 줍니다.
우주배경복사로 추정하는 우주 모형
우주배경복사 지도는 우주의 나이와 구성, 팽창의 역사를 설명하는 우주론 모형의 핵심 조건을 추정하는 출발점이 됩니다.
하지만 AI가 무늬를 잘 찾는다고 해서 곧바로 초기 우주의 진실이 확정되는 것은 아닙니다. 우주배경복사 신호는 지구에 도달하기까지 우리 은하의 먼지와 가스, 다른 천체의 전파 신호, 관측 장비의 잡음과 섞입니다. 오래된 사진 위에 얼룩과 흠집이 덧붙은 것과 비슷합니다. 과학자는 초기 우주에서 온 신호와 가까운 우주에서 생긴 방해 신호를 구분해야 합니다. AI도 이 과정에서 실수할 수 있습니다. 우리 은하의 먼지가 만든 무늬를 초기 우주의 흔적으로 잘못 해석하거나, 자료 처리 과정에서 생긴 흔적을 실제 신호처럼 배울 수 있습니다. 따라서 AI가 찾아낸 패턴은 다른 분석 방법, 다른 관측 자료, 물리학적 모형과 함께 검증되어야 합니다. AI의 출력은 결론이 아니라, 더 정밀하게 따져 보아야 할 해석의 후보입니다.
우주론에는 특별한 어려움도 있습니다. 우리는 초기 우주를 실험실에서 다시 만들 수 없고, 조건을 바꾸어 또 다른 우주를 관측할 수도 없습니다. 우리에게 주어진 것은 하나의 우주와 그 우주가 남긴 제한된 흔적입니다. 그래서 우주배경복사를 해석할 때는 관측, 이론, 시뮬레이션, 통계적 추론이 신중하게 결합되어야 합니다. AI는 이 결합을 빠르게 도와주는 도구입니다. 방대한 자료를 비교하고, 가능한 우주 모형들을 좁히며, 사람이 놓치기 쉬운 미세한 패턴을 찾아낼 수 있습니다. 그러나 어떤 우주론 모형을 전제로 삼았는지, 어떤 자료로 학습했는지, 장비의 오차와 관측 편향을 어떻게 보정했는지는 분명히 밝혀야 합니다. 정밀한 숫자가 나왔다고 해서 그 숫자를 만든 전제까지 자동으로 옳아지는 것은 아닙니다.
결국 우주배경복사를 연구하는 일은 가장 오래된 빛의 흔적으로 우주의 역사를 복원하는 작업입니다. AI는 그 희미한 빛의 지도를 더 빠르게 읽고, 여러 가능한 설명을 비교하도록 돕습니다. 그러나 우주의 시작에 관한 큰 질문일수록 작은 온도 차이와 측정 오차, 보정 과정과 통계적 가정을 더욱 정직하게 다루어야 합니다. AI는 우주의 정답을 한 번에 알려 주는 기계가 아니라, 오래된 우주의 사진을 더 세밀하게 읽도록 돕는 해석의 도구입니다.
7.7 망원경, 시뮬레이션, AI의 삼각형
현대 천문학은 세 가지 도구가 함께 움직입니다. 망원경은 실제 우주가 보내온 빛과 신호를 모읍니다. 컴퓨터 시뮬레이션(simulation)은 물리 법칙을 바탕으로 우주가 어떻게 만들어지고 변할 수 있는지 계산합니다. AI는 이 둘을 비교하고 연결하며, 그 안에서 의미 있는 관계를 빠르게 찾아냅니다.
21세기 천문학의 필수 동반자가 된 AI
망원경은 현실의 우주를 보는 가장 중요한 눈입니다. 그러나 아무리 뛰어난 망원경도 우주 전체를 완전하게 볼 수는 없습니다. 너무 멀거나 어두운 천체는 놓칠 수 있고, 장비마다 볼 수 있는 빛의 종류도 다릅니다. 지상 관측은 대기와 날씨의 영향을 받으며, 관측 시간과 위치에도 제한이 있습니다. 망원경이 보여 주는 것은 실제 우주이지만, 언제나 실제 우주의 일부입니다. 그래서 천문학자는 컴퓨터 안에 우주의 모형을 만들어 봅니다. 중력, 가스의 흐름, 빛의 이동, 암흑물질(dark matter), 별의 탄생과 폭발 같은 물리 법칙을 넣고 시간이 지나면 은하와 우주 구조가 어떻게 자랄지 계산합니다. 이렇게 계산으로 만들어 본 우주의 모습을 가능한 우주(possible universe)라고 부를 수 있습니다. 실제 우주를 복제한 것은 아니지만, “이 조건이라면 우주가 이렇게 보일 수 있다”는 가상 실험입니다.
AI는 이 지점에서 중요한 역할을 합니다. 실제 망원경으로 관측한 은하와 시뮬레이션으로 만든 가상 은하를 비교하고, 관측 자료만으로 직접 알기 어려운 질량, 거리, 형성 과정 같은 물리량을 추정할 수 있습니다. 또한 오래 걸리는 시뮬레이션 계산을 빠르게 근사하거나, 많은 조건 가운데 실제 관측과 가장 잘 맞는 모형을 찾는 데 도움을 줍니다. 예를 들어 여러 조건에서 은하가 어떻게 만들어지는지 시뮬레이션한 뒤, 그 결과를 AI가 학습하게 할 수 있습니다. 그러면 AI는 실제 관측된 은하의 모양과 밝기, 분포를 보고 그 은하가 어떤 형성 과정에 가까운지 추정합니다. 연구자는 AI가 좁혀 준 후보를 바탕으로 더 정밀한 계산과 관측을 이어 갈 수 있습니다. AI는 우주의 정답을 말해 주는 심판이 아니라, 관측과 모형 사이에서 가능성을 빠르게 추려 주는 조력자입니다.
하지만 시뮬레이션으로 학습한 AI에는 조심할 점이 있습니다. 시뮬레이션이 현실의 어떤 과정을 빠뜨리거나 단순화했다면, AI도 그 한계를 함께 배웁니다. 가상 운전 연습에서는 능숙해도 실제 빗길과 돌발 상황에서는 어려움을 겪을 수 있듯이, 가상 우주에서 잘 작동한 AI가 실제 우주에서도 항상 잘 작동한다고 보장할 수는 없습니다. 따라서 좋은 천문 AI는 관측과 모형의 경계를 분명히 드러내야 합니다. 어떤 정보가 망원경으로 직접 측정된 것인지, 어떤 부분이 시뮬레이션의 가정에서 나온 것인지, AI가 무엇을 근거로 추정했는지를 밝혀야 합니다. 관측된 사실과 계산으로 추정한 가능성이 뒤섞이면, 그럴듯한 결과가 실제 발견처럼 받아들여질 수 있습니다.
망원경, 시뮬레이션, AI는 각각 강점과 한계를 지닙니다. 망원경은 실제 우주의 흔적을 제공하지만 불완전합니다. 시뮬레이션은 보이지 않는 과정을 보여 주지만 가정에 의존합니다. AI는 둘 사이의 관계를 빠르게 찾지만, 학습 자료의 편향과 오류를 물려받을 수 있습니다. 그래서 어느 하나도 홀로 최종 기준이 될 수 없습니다. 현대 천문학의 힘은 이 세 도구가 서로를 보완하는 데 있습니다. 관측은 시뮬레이션이 실제 우주와 맞는지 확인하고, 시뮬레이션은 관측된 현상이 어떤 과정에서 생길 수 있는지 설명합니다. AI는 그 사이에서 가능한 관계를 빠르게 탐색하고, 더 살펴볼 모형과 관측 대상을 제안합니다. 우주의 이야기는 망원경이 본 현실, 시뮬레이션이 만든 가능성, AI가 찾아낸 연결이 함께 검증될 때 더 선명해집니다.
7.8 우주 데이터의 편향
박물관에 남은 화려한 금관만 보고 과거 사회의 모든 사람이 풍족하게 살았다고 판단할 수는 없습니다. 오래 보존될 만한 물건과 기록을 남길 수 있었던 사람들의 흔적이 더 많이 전해졌기 때문입니다. 천문 데이터도 마찬가지입니다. 우리가 관측한 우주는 우주 전체가 아니라, 망원경과 분석 방법이 포착할 수 있었던 우주의 일부입니다. 우주 데이터에는 여러 종류의 관측 편향이 존재합니다. 크고 밝은 천체는 쉽게 발견되지만, 작고 어두운 천체는 놓치기 쉽습니다. 가까운 은하는 자세히 보이지만, 먼 은하는 희미하고 흐릿하게 나타납니다. 같은 천체라도 가시광선, 적외선, 전파, 엑스선 가운데 어떤 빛으로 보느냐에 따라 전혀 다른 모습으로 드러납니다. 장비가 잘 보는 우주와 잘 보지 못하는 우주가 나뉘는 것입니다.
망원경이 보지 못한 영역을 찾는 AI
어두운 밤에 스마트폰으로 도시를 찍으면 밝은 간판은 선명하게 나오지만 골목과 작은 집은 잘 보이지 않습니다. 사진만 보면 도시가 환한 건물들로만 이루어진 것처럼 오해할 수 있습니다. 우주 데이터도 이와 비슷합니다. 망원경이 잘 포착한 대상은 많이 쌓이고, 희미하거나 드문 대상은 자료 속에서 부족하게 남습니다. AI는 바로 이 자료를 학습합니다. 밝고 전형적인 은하의 자료가 많고, 희미한 왜소은하나 드문 천체의 자료가 적다면 AI는 익숙한 대상은 잘 분류하지만 낯선 대상은 놓칠 수 있습니다. AI의 시야는 학습 데이터가 보여 준 세계의 범위를 크게 벗어나기 어렵습니다. 그래서 우주 AI를 사용할 때는 모델이 무엇을 잘 보고, 무엇을 잘 보지 못하는지 함께 살펴야 합니다.
편향은 망원경에서만 생기지 않습니다. 어떤 대상을 관측하기로 선택했는지, 잡음을 어떻게 제거했는지, 불완전한 자료를 어떤 기준으로 제외했는지에 따라서도 결과가 달라집니다. 시뮬레이션 자료를 학습에 사용한다면, 그 시뮬레이션에 들어간 가정도 AI의 판단에 영향을 줍니다. 컴퓨터 안에서 계산으로 만들어 본 가상의 우주, 곧 가능한 우주(possible universe)*는 실제 우주를 이해하는 데 도움을 주지만, 어디까지나 물리 법칙과 연구자의 가정으로 구성된 모형입니다. 그렇다고 데이터의 편향 때문에 AI를 불신해야 한다는 뜻은 아닙니다. 오히려 편향을 알아야 AI를 더 정확하게 쓸 수 있습니다. AI가 어떤 밝기와 거리의 천체를 잘 분류하는지, 어떤 파장 자료에 강한지, 어떤 종류의 드문 현상에서 성능이 떨어지는지 알면 결과를 더 신중하게 해석할 수 있습니다.
우주에서 “보이지 않는다”는 말도 조심해야 합니다. 실제로 존재하지 않는다는 뜻일 수도 있지만, 너무 어둡거나 멀어서 감지되지 않았다는 뜻일 수도 있습니다. 장비가 해당 파장을 보지 못했거나, 자료 처리 과정에서 제외되었거나, 애초에 그런 대상을 찾는 질문을 하지 않았기 때문일 수도 있습니다. 관측의 빈 곳은 곧 우주의 빈 곳이 아닙니다. 이 점에서 AI는 두 가지 역할을 할 수 있습니다. 하나는 이미 쌓인 자료 속에서 사람이 놓친 후보를 빠르게 찾아내는 일입니다. 다른 하나는 앞으로 무엇을 더 관측해야 하는지 제안하는 일입니다. 자료가 부족한 밝기, 거리, 파장, 천체 유형을 찾아내면 다음 관측은 지식의 빈틈을 메우는 방향으로 설계될 수 있습니다.
하지만 좋은 천문 AI의 목표는 모든 대상을 기존 분류표에 깔끔하게 넣는 데만 있지 않습니다. 과학의 중요한 발견은 때로 분류되지 않는 이상한 대상에서 시작됩니다. 예상 밖의 스펙트럼, 낯선 밝기 변화, 기존 유형에 맞지 않는 은하가 “이것은 무엇인가?”라는 새로운 질문을 만듭니다. AI는 익숙한 대상을 효율적으로 분류하는 동시에, 낯선 신호를 성급히 지워버리지 않아야 합니다. 결국 우주 데이터가 방대하다는 것과 완전하다는 것은 전혀 다른 말입니다. AI는 우리가 가진 자료를 더 빠르고 정교하게 읽을 수 있지만, 자료에 없는 우주까지 저절로 알 수는 없습니다. 우주 AI의 중요한 역할은 보이는 것을 분류하는 데서 끝나지 않습니다. 무엇이 보이지 않는지, 어디에 빈틈이 있는지, 어떤 낯섦을 더 살펴보아야 하는지 묻게 하는 데 있습니다.
7.9 인간의 눈, 기계의 눈
서예가는 한 획의 미세한 떨림에서 붓의 속도와 힘, 글쓴이의 긴장까지 읽어 냅니다. 숙련된 천문학자도 은하의 비대칭, 별빛의 이상한 흔들림, 스펙트럼의 낯선 선에서 보통과 다른 점을 알아차립니다. 인간의 눈은 단순한 모양을 보는 데 그치지 않고, 맥락과 의미를 함께 읽는 데 강합니다.
그러나 인간의 눈에는 한계도 있습니다. 수백만 장의 은하 이미지와 수많은 별빛 자료를 같은 기준으로 계속 살피기는 어렵습니다. 오래 보면 집중력이 떨어지고, 과거의 경험이 판단을 좁힐 수도 있습니다. 보고 싶은 것만 보거나, 낯선 신호를 익숙한 범주에 억지로 넣는 일도 생길 수 있습니다. AI는 다른 방식으로 봅니다. 방대한 이미지, 스펙트럼, 밝기 변화 자료를 빠르게 비교하고, 사람이 놓치기 쉬운 작은 차이를 일정한 기준으로 찾아냅니다. 은하의 형태를 분류하고, 드문 천체 후보를 골라내며, 별빛 속의 미세한 변화나 반복되는 신호를 표시할 수 있습니다. 아주 작은 영역에 숨어 있는 무늬나 차이, 곧 극소 패턴(micro-pattern)을 대량의 자료 속에서 찾아내는 데 AI는 특히 강합니다.
AI가 찾는 우주 극소 영역 패턴
공항 검색 장비를 떠올리면 이 점을 쉽게 이해할 수 있습니다. 검색 장비는 수많은 가방을 빠르게 검사해 수상한 부분을 표시합니다. 그러나 그것이 실제 위험 물질인지, 평범한 물건이 겹쳐 보인 것인지는 사람이 다시 판단해야 합니다. 천문학에서도 AI는 주목할 후보를 먼저 제안하고, 연구자는 그것이 실제 천체 현상인지 장비의 잡음인지, 물리적으로 의미 있는 신호인지 검증합니다. 따라서 AI는 천문학자를 대신하는 눈이라기보다, 인간의 시야를 넓혀 주는 두 번째 눈에 가깝습니다. AI는 넓고 빠르게 훑습니다. 인간은 그 결과가 왜 중요한지, 어떤 이론을 시험할 수 있는지, 추가 관측이 필요한지 판단합니다. AI가 가능성의 범위를 넓히면, 연구자는 그 가능성에 의미와 우선순위를 부여합니다.
물론 기계의 눈도 완전하지 않습니다. AI는 학습한 자료의 범위 안에서 판단합니다. 학습 데이터에 충분히 나타나지 않은 낯선 현상에는 약할 수 있고, 관측 장비의 흔적을 실제 우주 신호로 오해할 수도 있습니다. 익숙한 유형은 잘 알아보지만, 기존 분류에 들어맞지 않는 대상을 놓칠 가능성도 있습니다. 그래서 AI가 표시한 결과는 언제나 관측 조건, 장비의 특성, 물리적 해석과 함께 검토되어야 합니다. 현대 천문학의 발견은 이제 한 사람의 시선만으로 이루어지지 않습니다. 망원경과 검출기를 설계한 공학자, 관측 자료를 보정한 연구자, 알고리즘을 만든 개발자, 물리 이론을 세운 과학자, 후보를 다시 관측하고 해석한 천문학자가 함께 지식을 만듭니다. AI는 이 협업 속에 새로운 눈을 더하고, 서로 다른 자료를 연결하는 역할을 맡습니다.
그래서 중요한 질문은 “AI가 천문학자를 대신할 것인가”가 아닙니다. 더 적절한 질문은 “AI가 천문학자의 시야와 연구 방식을 어떻게 바꾸는가”입니다. AI는 반복적인 탐색을 맡아 더 넓은 우주를 빠르게 훑고, 인간은 그 후보의 의미를 해석하며 더 깊은 질문을 던집니다. 인간의 눈은 맥락을 읽고 질문을 만듭니다. 기계의 눈은 방대한 자료 속에서 미세한 차이를 찾아냅니다. 두 눈이 서로의 약점을 확인하고 강점을 보완할 때, 잡음 속에 묻힌 우주의 희미한 신호는 조금 더 선명해집니다.
>우주를 대하는 AI의 자세 > >『시경』과 고대 그리스의 천문 전통은 모두 하늘을 보며 인간의 삶을 생각했습니다. 하늘은 농사의 때를 알려 주었고, 항해의 길을 열었으며, 인간이 자신의 위치를 묻게 했습니다. 고대인들은 밤하늘의 별자리에서 신화의 영웅을 읽고, 파종과 수확의 타이밍을 가늠하며 삶의 나침반을 세웠습니다. 우주를 올려다보는 행위는 단순히 까마득한 허공을 응시하는 것이 아니라, 인간이 세계 속에서 자신의 좌표를 묻는 가장 근원적인 철학적 실천이었습니다. 빛의 스펙트럼과 중력파, 슈퍼컴퓨터의 알고리즘으로 무장한 현대 천문학의 껍데기는 화려해졌지만, 그 심연에 흐르는 질문은 고대의 밤하늘과 다르지 않습니다. "우리는 어디에서 왔는가? 이 아득한 우주에 우리뿐인가?" 우주 AI는 이 거대한 철학적 질문에 가장 최첨단의 데이터로 답을 구하려는 분투입니다. 하지만 138억 광년의 간극을 뚫고 도달한 빛은 너무나 희미하고, 데이터는 불완전하며, 시뮬레이션의 함정은 도처에 널려 있습니다. 그렇기에 우주 AI는 철저한 겸손의 자세을 익혀야 합니다. AI가 아무리 많은 가능성과 외계행성의 후보를 제안하더라도, 그것을 과학의 증거로 굳히는 과정은 혹독한 의심과 절제의 과정이어야 합니다. > >우주에 대한 질문은 인간의 기원에 대한 질문
>
제8강. 양자인공지능(QAI)
짙은 안개가 깔린 갈림길에 서 있다고 상상해 보십시오. 가까이 다가가기 전에는 길이 하나인지 여러 갈래인지조차 희미합니다. 우리는 발밑의 감각과 주변의 소리에 의지해 조심스레 발걸음을 내디디며 길의 형상을 확정해 나갑니다. 양자(Quantum)의 세계는 이 안개 속 갈림길과 같습니다. 이 불확실성은 우리의 지식이 부족해서가 아니라, 자연이 원래 그렇게 생겨먹었기 때문에 발생하는 본질적인 성질입니다. 양자인공지능(Quantum Artificial Intelligence, QAI)은 대단히 매혹적인 단어입니다. "양자컴퓨터가 곧 모든 AI를 대체할 것이다", "수만 년 걸릴 암호를 1초 만에 푼다"는 열광적인 선언들이 쏟아집니다. 그러나 우리는 이 달콤한 과장의 유혹을 경계해야 합니다. 반대로 "아직 먼 미래의 일이니 무시하자"는 냉소 역시 위험합니다. 이번 강의에서 우리는 이 낯선 양자의 문법이 현실의 험난한 장벽을 어떻게 통과해야만 진정한 지능의 도구로 거듭날 수 있는지 그 '정직한 가능성'을 추적해 볼 것입니다.
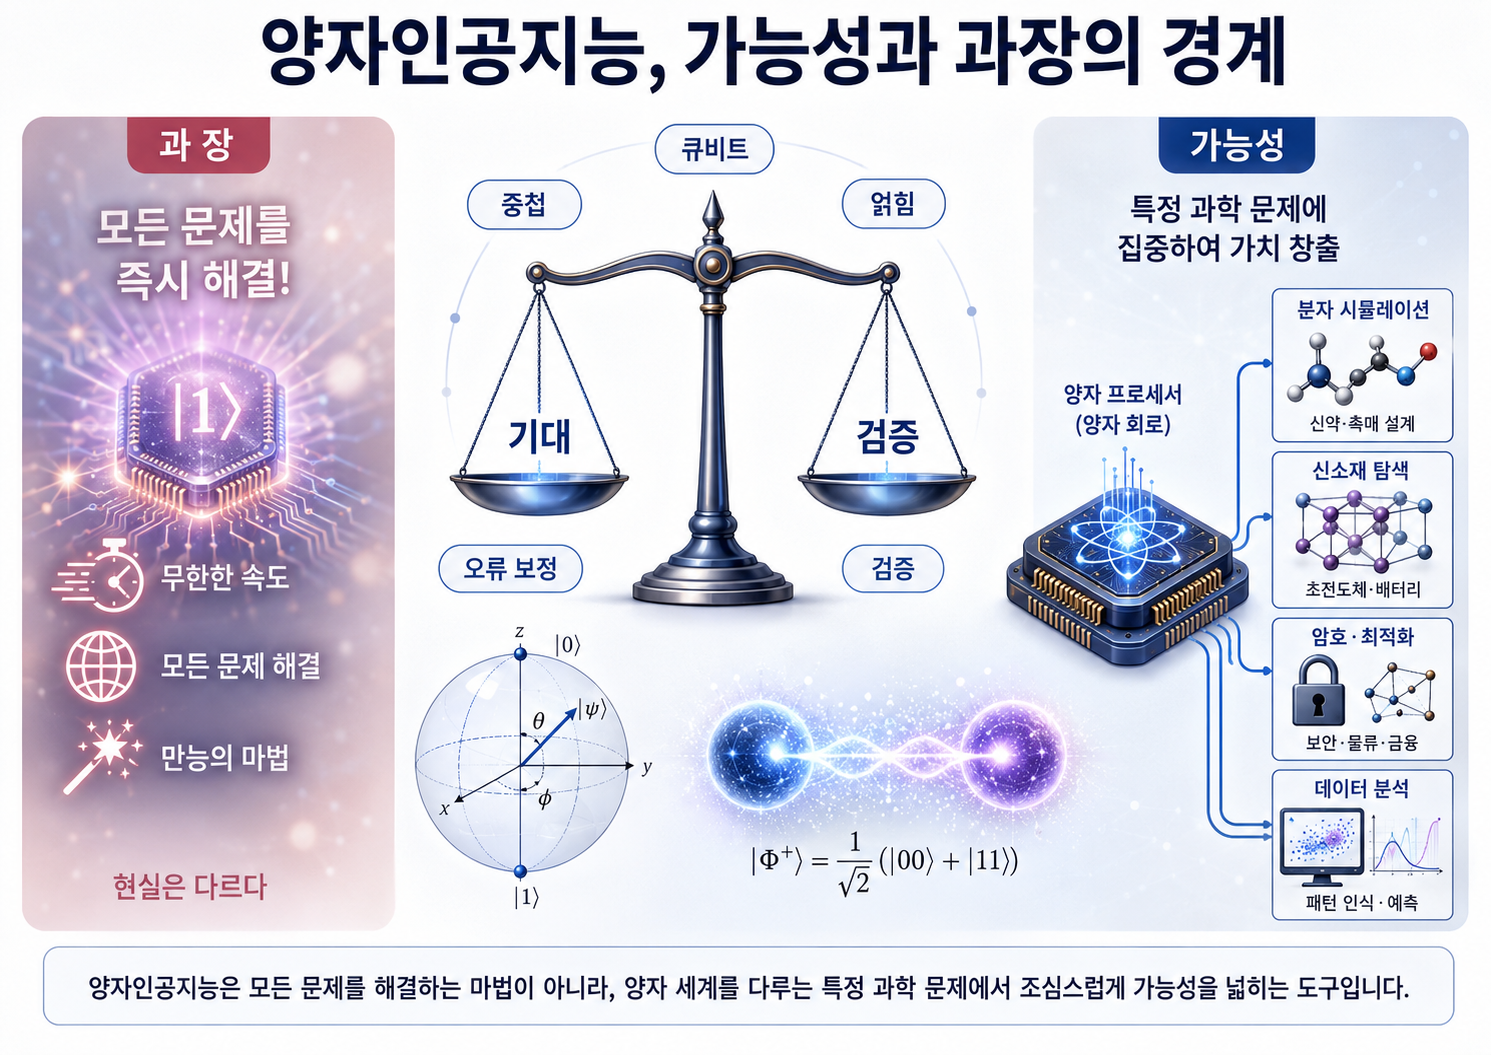
양자인공지능은 매혹적인 미래를 열지만, 어떤 양자 자원과 장치 조건에서 실제 의미가 있는지 정직하게 물어야 합니다.
8.1 양자역학은 왜 낯선가
동전을 던진 뒤 손바닥으로 덮었다고 생각해 보겠습니다. 우리가 아직 확인하지 않았더라도 동전은 이미 앞면이나 뒷면 가운데 하나를 향하고 있습니다. 결과는 정해져 있지만 우리가 모를 뿐입니다. 이것은 일상에서 흔히 만나는 불확실성입니다. 양자의 세계는 이와 다릅니다. 전자나 광자처럼 매우 작은 대상은 측정하기 전까지 단순히 “어느 쪽인지 모르는 상태”로만 설명되지 않습니다. 여러 가능한 결과가 하나의 상태 안에 함께 들어 있고, 각각의 가능성은 특정한 세기와 방향을 가진 수학적 값으로 표현됩니다. 이 값을 확률진폭(probability amplitude)이라고 합니다. 여러 가능성의 확률진폭이 함께 들어 있는 상태를 중첩(superposition)이라고 합니다.
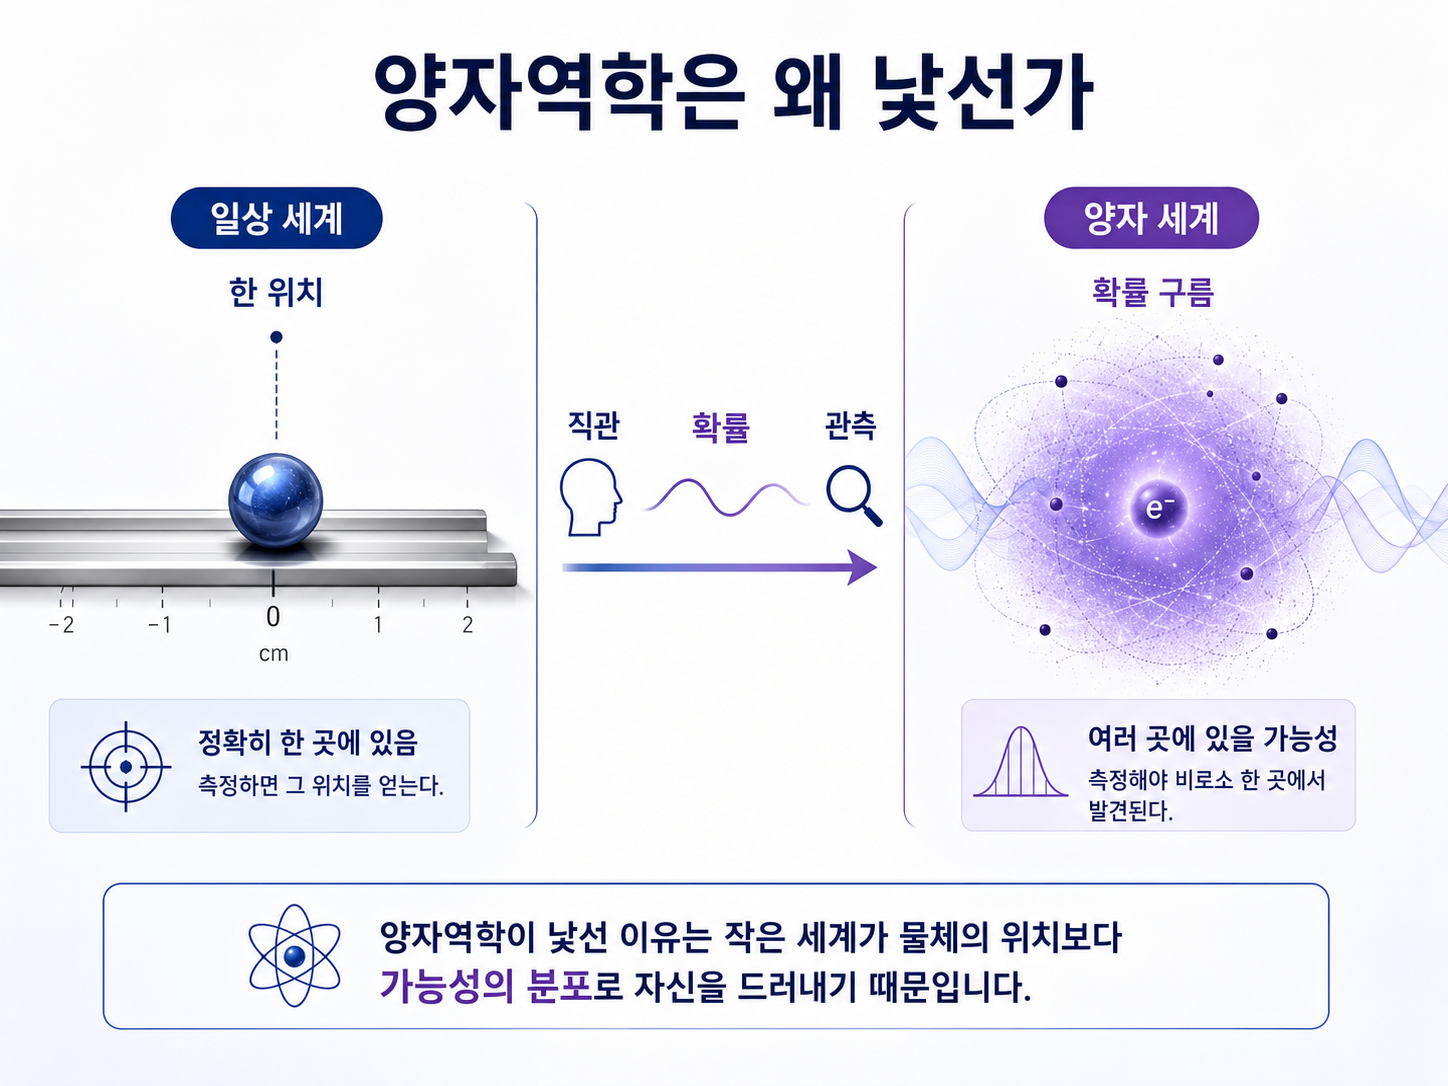
양자역학은 이상한 이야기가 아니라 작은 세계의 엄격한 문법이며, QAI를 이해하려면 그 문법을 먼저 존중해야 합니다.
중첩은 동전의 앞면과 뒷면을 우리가 몰라서 생기는 무지가 아닙니다. 여러 가능성이 서로 관계를 맺고 하나의 양자 상태를 이루는 물리적 현상입니다. 측정을 하면 그 가능성들 가운데 하나가 실제 결과로 나타납니다. 다만 어떤 결과가 나올지는 양자 상태가 정하는 확률에 따라 달라집니다. 양자역학이 낯설게 느껴지는 까닭은 우리가 주로 고전적인 세계에서 살아가기 때문입니다. 공은 어느 순간 대체로 한 위치에 있고, 문은 열려 있거나 닫혀 있으며, 자동차는 특정한 차선을 달립니다. 일상의 물체는 주변 환경과 끊임없이 부딪히고 상호작용하기 때문에 양자 상태의 미세한 관계가 금세 흐트러집니다. 그래서 우리는 중첩이나 얽힘을 직접 체감하기보다, 하나의 분명한 상태를 가진 세계를 경험합니다.
양자 세계의 낯섦은 전자를 하나씩 쏘는 실험에서도 드러납니다. 전자는 검출될 때 화면의 한 지점에 입자처럼 찍힙니다. 그런데 많은 전자를 하나씩 쌓아 보면, 전체 분포는 파동이 서로 겹쳐 만든 무늬처럼 나타납니다. 각각의 검출은 한 점이지만, 여러 결과가 모이면 파동의 간섭을 따릅니다. 양자 대상은 고전적인 입자나 파동 가운데 어느 하나로만 설명되지 않습니다.
위치와 운동량의 관계도 일상적 직관과 다릅니다. 작은 공이라면 위치와 속도를 동시에 더 정확히 알 수 있을 것처럼 생각하기 쉽습니다. 하지만 양자 상태에서는 어떤 대상을 매우 좁은 위치에 있도록 준비할수록 운동량의 가능한 범위가 넓어지고, 운동량을 정밀하게 정할수록 위치의 가능한 범위가 넓어집니다. 이렇게 서로 함께 임의로 정확하게 정할 수 없는 한계를 불확정성 원리(uncertainty principle)라고 합니다. 이것은 측정 장비가 부족해서 생기는 문제가 아니라, 양자 상태 자체의 구조에서 나오는 원리입니다. 그렇다고 양자역학이 모호하거나 자의적인 이론이라는 뜻은 아닙니다. 양자 상태는 수학적으로 정밀하게 표현되고, 측정 결과의 확률도 엄격한 규칙에 따라 계산됩니다. 원자 스펙트럼, 반도체, 레이저, 자기공명영상, 원자시계는 모두 양자역학의 예측이 실제 기술 속에서 정확하게 작동한다는 사실을 보여 줍니다.
전자 회절과 위치–운동량 불확정성
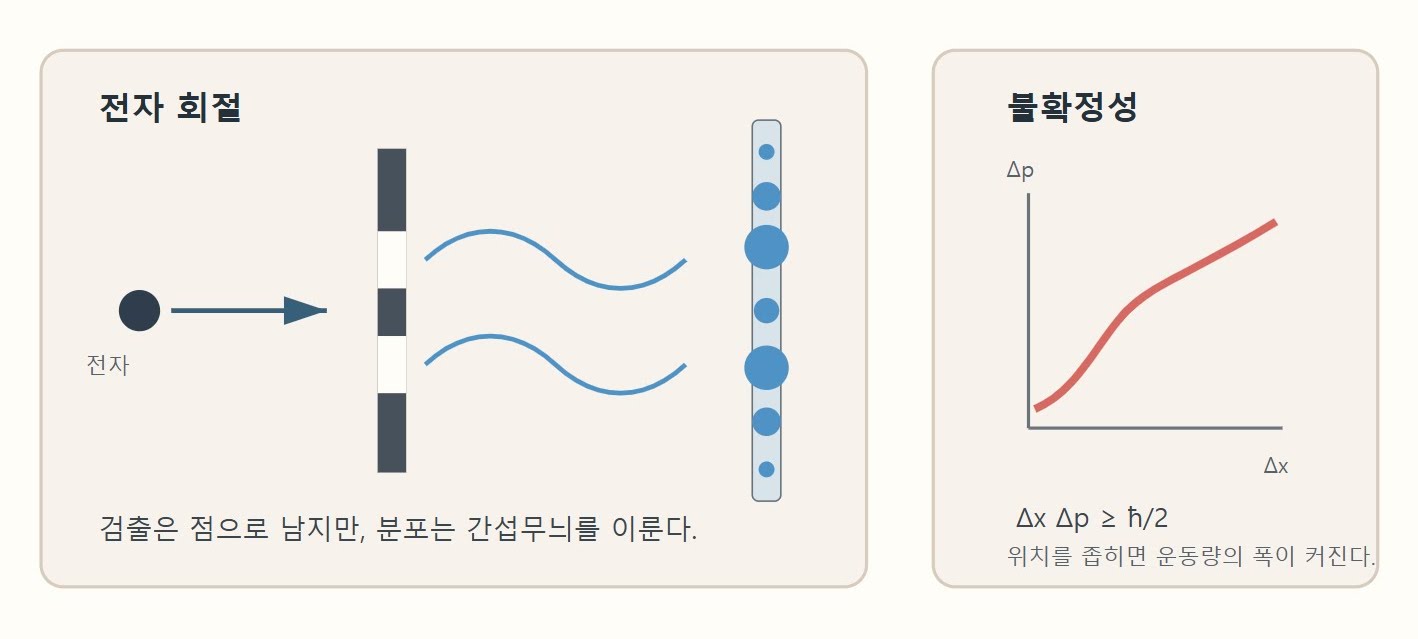
전자 회절은 입자가 파동과 같은 간섭 현상을 보일 수 있음을 보여 주며, 위치와 운동량의 불확정성은 양자 상태가 일상적인 측정 직관과 다르게 기술된다는 사실을 드러냅니다.
여기서 말하는 관측도 사람의 의식이 현실을 만들어 낸다는 뜻이 아닙니다. 측정 장치가 양자 대상과 물리적으로 상호작용하고, 그 결과가 기록으로 남는 과정을 가리킵니다. 양자 상태가 측정 결과와 어떤 관계를 갖는지에 대해서는 여러 해석이 있지만, 실험 결과를 계산하는 기본 규칙은 공통적으로 사용됩니다. 이 점은 양자인공지능을 이해할 때 특히 중요합니다. ‘양자’라는 말이 붙었다고 해서 계산이 자동으로 신비로워지거나 무한히 강력해지는 것은 아닙니다. 어떤 양자 상태를 준비하는지, 어떤 연산을 수행하는지, 측정에서 어떤 정보를 얻는지 구체적으로 따져야 합니다. 양자적 방법이 실제로 어떤 문제에서 기존 계산보다 이점을 주는지도 검증해야 합니다.
AI는 이 과정에서 중요한 조력자가 될 수 있습니다. 복잡한 양자 상태를 분석하고, 양자 장치의 오류를 찾고, 실험 조건을 조정하며, 어떤 양자 회로가 유용한 계산을 할 수 있는지 탐색하는 데 AI가 활용될 수 있습니다. 그러나 AI가 양자역학의 규칙을 무시하고 답을 만들어 내는 것은 아닙니다. 오히려 양자의 낯선 규칙을 더 정확히 다루고 제어하도록 돕는 도구에 가깝습니다. 결국 양자역학은 이상함을 허용하는 마법의 언어가 아닙니다. 작은 세계를 설명하는 엄격한 물리학입니다. 양자인공지능의 핵심 질문도 양자의 신비를 과장하는 데 있지 않습니다. 중첩과 간섭, 얽힘을 실제 장치와 알고리즘 속에서 어떻게 제어하고, 그것을 유용한 계산 자원으로 바꿀 수 있는지를 묻는 데 있습니다.
> 전자와 양자 > 전자와 양자는 서로 다른 종류의 물체가 아닙니다. 전자는 음의 전하와 일정한 질량을 가진 기본 입자이고, ‘양자’는 에너지와 같은 물리량이 특정 조건에서 불연속적인 단위로 나타나며 미시 세계가 양자역학의 법칙을 따른다는 사실을 가리키는 개념입니다. > 전자는 원자와 물질을 이루는 기본 구성 요소입니다. 고전물리학의 직관으로는 특정 위치에서 정해진 경로를 따라 움직이는 작은 공처럼 그릴 수 있지만, 이 그림은 원자 내부나 아주 작은 장치에서는 충분하지 않습니다. > 양자역학에서는 전자의 상태를 파동함수 \(\psi\)로 표현합니다. 파동함수 자체가 곧 확률은 아니며, 그 절댓값의 제곱 \(|\psi|^2\)이 특정 위치에서 전자를 발견할 확률밀도를 나타냅니다. > 원자에 묶인 전자의 에너지는 허용된 준위로 나타나지만, 자유 전자의 에너지와 운동량은 연속적인 값도 가질 수 있습니다. 위치와 운동량의 불확정성에는 \(\Delta x \Delta p \ge \hbar/2\)라는 관계가 있습니다. > 전자와 양자의 개념 차이
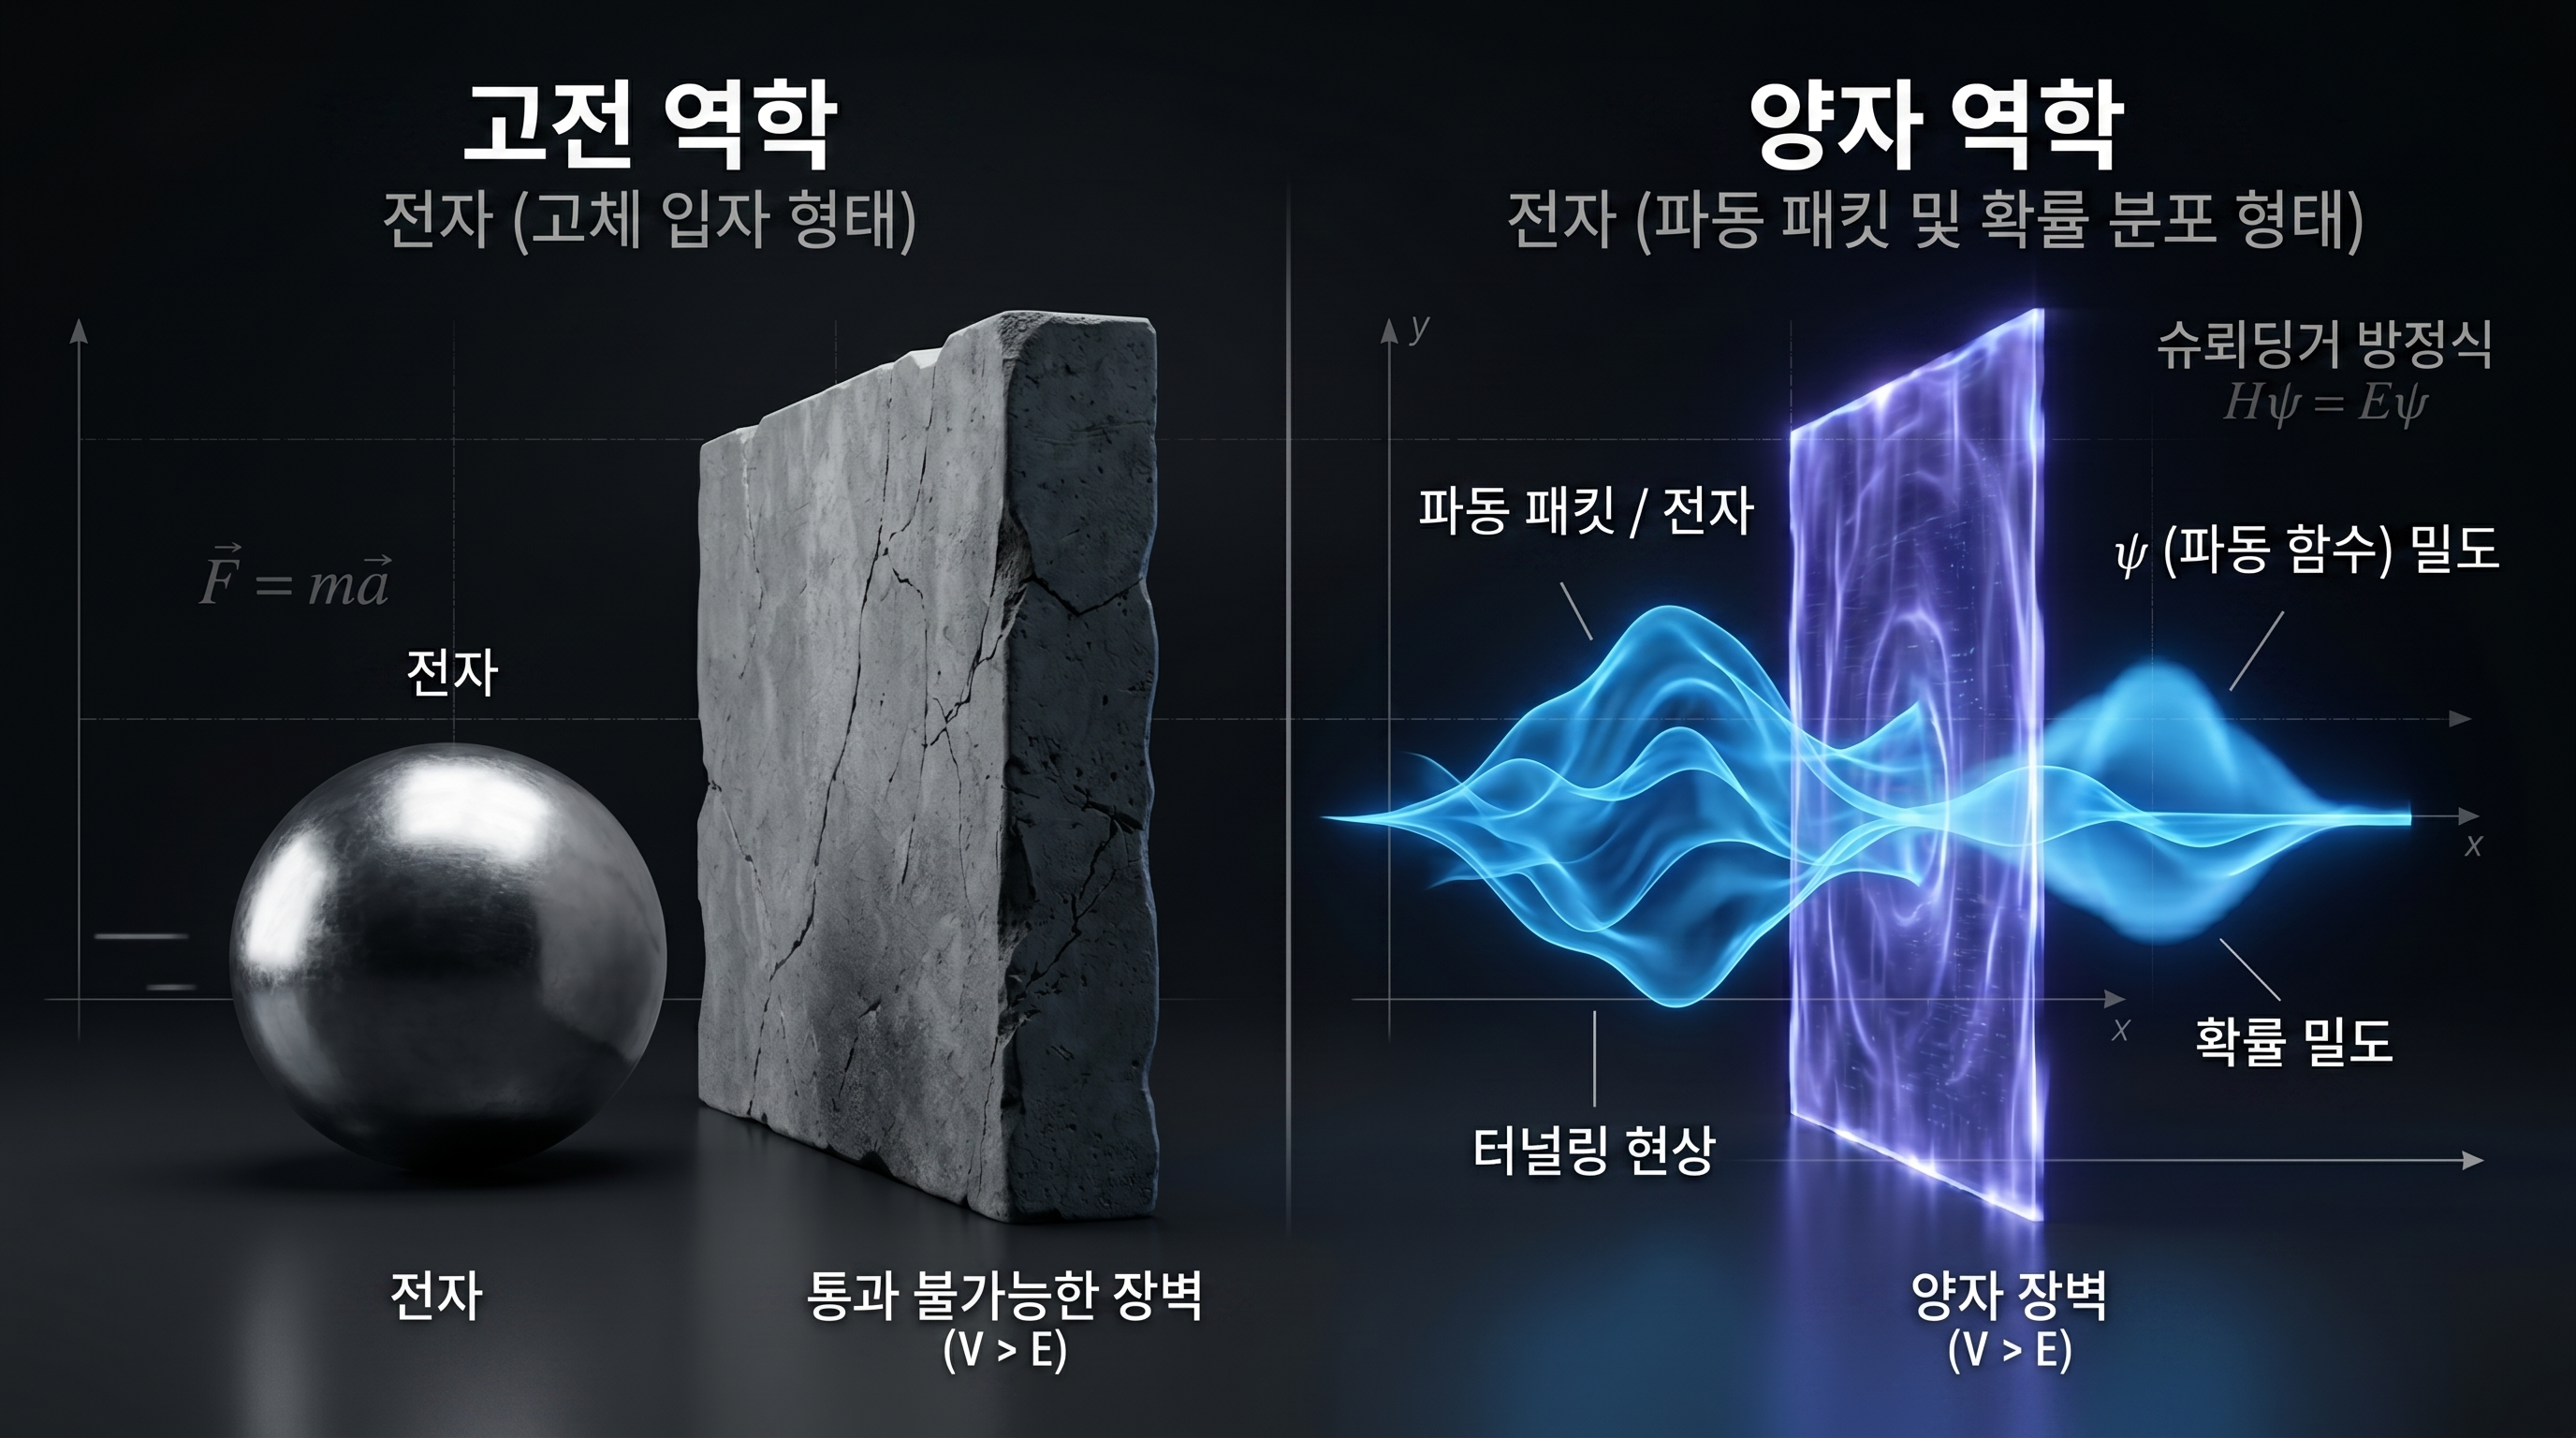
> 고전역학에서는 입자의 에너지가 장벽보다 낮으면 반대편으로 갈 수 없습니다. 그러나 양자역학에서 전자의 파동함수는 유한한 장벽 안으로 스며들 수 있어, 장벽이 충분히 얇다면 반대편에서 전자가 발견될 확률이 생깁니다. 이를 양자 터널링(quantum tunneling)이라고 합니다. > 고전적인 입자는 에너지가 부족하면 장벽을 넘지 못하지만, 양자역학의 전자는 파동함수의 성질 때문에 유한한 장벽의 반대편에서 발견될 수 있습니다.
8.2 큐비트와 중첩
일반 컴퓨터는 스위치처럼 정보를 다룹니다. 꺼짐과 켜짐, 낮은 전압과 높은 전압처럼 두 상태 가운데 하나를 0과 1로 표현합니다. 이 기본 정보 단위를 비트(bit)라고 합니다. 비트는 어느 순간 0이거나 1입니다. 양자컴퓨터의 기본 정보 단위는 조금 다릅니다. 전자나 광자 같은 양자 대상을 이용하면, 0에 해당하는 상태와 1에 해당하는 상태가 하나의 양자 상태 안에 함께 들어갈 수 있습니다. 이런 양자 정보 단위를 큐비트(qubit)라고 합니다. 큐비트는 측정하기 전까지 0과 1의 가능성을 함께 품고 있지만, 측정하면 결과는 0 또는 1 가운데 하나로만 나타납니다.
큐비트는 가능성의 상태다
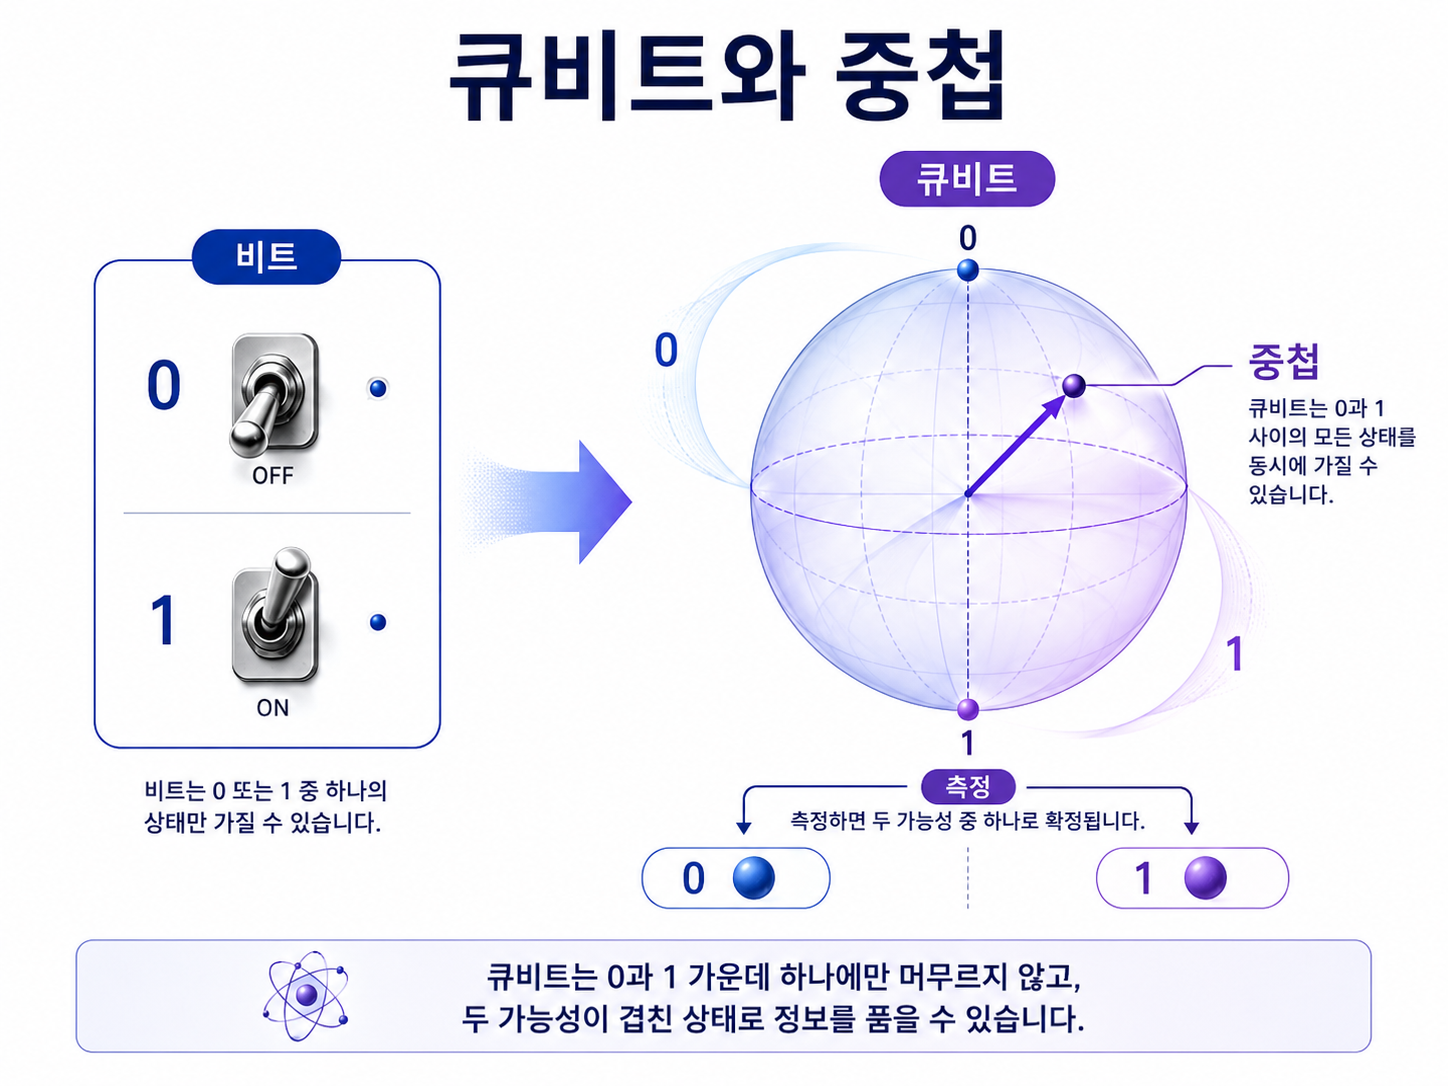
여기서 중요한 것은 “0과 1을 동시에 가진다”는 표현을 조심해야 한다는 점입니다. 큐비트는 두 답을 마음대로 꺼내 볼 수 있는 상자가 아닙니다. 0과 1에 해당하는 가능성에는 각각 크기와 방향을 가진 수학적 값이 붙어 있습니다. 이 값을 확률진폭(probability amplitude)이라고 합니다. 측정 결과의 확률은 이 진폭의 크기와 관계됩니다. 하지만 확률만으로는 큐비트를 충분히 설명할 수 없습니다. 파도 두 개가 만날 때 서로 더 커지기도 하고, 서로 지워지기도 하듯이, 양자 상태의 가능성들도 서로의 관계에 따라 결과를 바꿉니다. 이때 두 가능성 사이의 어긋남이나 맞물림을 상대적 위상(relative phase)이라고 합니다. 큐비트 계산에서 중요한 것은 단순히 가능성이 많다는 사실이 아니라, 이 진폭과 위상을 어떻게 조절하느냐입니다.
중첩도 물감을 섞는 것보다 파동이 겹치는 현상에 가깝습니다. 물감을 섞으면 원래 색을 되돌리기 어렵지만, 파동은 겹치는 방식에 따라 커지거나 약해질 수 있습니다. 양자 상태에서도 어떤 가능성은 서로 보강되고, 어떤 가능성은 서로 상쇄됩니다. 이런 현상을 양자 간섭(quantum interference)이라고 합니다.
양자컴퓨터의 계산은 큐비트를 중첩 상태로 만드는 데서 끝나지 않습니다. 양자 게이트(quantum gate)를 이용해 진폭과 위상을 정교하게 바꾸고, 원하는 결과의 진폭은 커지게 하며 원하지 않는 결과의 진폭은 작아지게 만들어야 합니다. 마지막에 측정했을 때 정답이 높은 확률로 나오도록 간섭을 설계하는 것이 양자 알고리즘의 핵심입니다. 큐비트가 여러 개가 되면 다룰 수 있는 가능성의 공간은 빠르게 커집니다. 큐비트 두 개는 00, 01, 10, 11에 해당하는 네 가지 상태의 진폭을 함께 다룰 수 있고, 큐비트 수가 늘어날수록 가능한 상태의 수는 매우 빠르게 증가합니다. 그러나 이것이 모든 답을 한 번에 읽을 수 있다는 뜻은 아닙니다. 측정에서 얻는 결과는 제한되어 있으므로, 유용한 정보가 드러나도록 계산 과정을 잘 설계해야 합니다.
비트와 큐비트의 연산 방식 차이
일반 비트가 0 또는 1의 값을 갖는다면, 큐비트는 측정 전 여러 결과의 가능성이 진폭과 위상으로 표현되는 상태라는 점에서 계산의 출발점이 다릅니다.
이 지점에서 AI와 양자컴퓨팅이 만납니다. QAI에서는 고전 데이터를 양자 상태에 넣고, 조절 가능한 양자 회로를 통과시킨 뒤, 측정 결과를 이용해 분류나 예측을 수행하려는 연구가 이루어지고 있습니다. AI는 어떤 방식으로 데이터를 양자 상태에 담을지, 어떤 회로 구조가 더 적합한지, 어떤 매개변수를 조정해야 원하는 결과가 잘 나오는지 탐색하는 데 활용될 수 있습니다. 하지만 고전 데이터를 양자 상태로 옮기는 일은 공짜가 아닙니다. 데이터가 크면 입력을 준비하는 데 많은 시간과 연산이 필요할 수 있습니다. 또 양자 회로의 출력은 한 번 측정해서 끝나는 것이 아니라, 통계적으로 안정된 값을 얻기 위해 같은 회로를 여러 번 실행해야 합니다. 표현 공간이 크다는 사실만으로 계산이 자동으로 빨라지는 것은 아닙니다.
현재의 양자 장치는 잡음과 오류에도 민감합니다. 큐비트가 주변 환경과 상호작용하면, 중첩을 유지하는 데 필요한 위상 관계가 흐트러집니다. 이렇게 양자 상태의 섬세한 관계가 무너지는 현상을 결어긋남(decoherence)이라고 합니다. 회로가 길고 복잡해질수록 오류가 쌓이기 쉬우므로, 이론적으로 가능한 계산을 실제 장치에서 안정적으로 구현하는 일은 여전히 큰 과제입니다. 따라서 큐비트는 무한한 답을 동시에 꺼내는 마술 상자가 아닙니다. 여러 가능성을 진폭과 위상으로 표현하고, 간섭을 통해 원하는 결과가 더 잘 나타나도록 조작할 수 있는 물리적 자원입니다. 이 자원이 실제 AI 계산의 이점으로 이어지려면 데이터 입력, 회로 설계, 측정 방법, 오류 제어, 그리고 해결하려는 문제의 구조가 서로 잘 맞아야 합니다.
8.3 얽힘은 무엇을 바꾸는가
두 사람이 멀리 떨어져 있어도 같은 악보를 보고 연주하면 서로 맞춘 듯한 결과가 나올 수 있습니다. 그러나 이 경우 두 사람은 각자 자기 악보와 규칙을 따르는 것입니다. 전체 결과가 비슷하더라도, 각자의 상태를 따로 설명할 수 있습니다. 양자의 세계에는 이보다 더 낯선 관계가 있습니다. 큐비트 여러 개를 함께 다룰 때, 각 큐비트를 따로 설명한 뒤 단순히 합치는 것만으로는 전체 상태를 설명할 수 없는 경우가 있습니다. 이렇게 여러 양자 대상이 하나의 공동 상태를 이루고, 부분들만 따로 떼어서는 충분히 설명되지 않는 관계를 양자 얽힘(quantum entanglement)이라고 합니다. 여기서 여러 입자나 큐비트처럼 함께 다루는 물리적 대상을 양자계(quantum system)라고 부릅니다.
얽힘은 두 계를 하나의 공동 상태로 묶는다
얽힌 두 큐비트를 측정하면 각각의 결과는 확률적으로 나타납니다. 그러나 두 결과를 나중에 비교해 보면, 고전적인 사전 약속만으로는 설명하기 어려운 강한 상관관계가 드러납니다. 실제 실험들은 이러한 상관관계가 단순한 숨은 정보 때문만은 아니라는 점을 보여 주었습니다. 얽힘은 철학적 상상이 아니라 반복된 실험으로 확인된 물리 현상입니다. 다만 얽힘으로 정보를 빛보다 빠르게 보낼 수 있는 것은 아닙니다. 한쪽에서 얻는 측정 결과를 마음대로 정할 수 없기 때문입니다. 두 장소의 결과를 나중에 일반적인 통신으로 비교해야 비로소 상관관계를 확인할 수 있습니다. 얽힘은 특별한 연결을 보여 주지만, 초광속 통신 장치는 아닙니다.
양자컴퓨팅에서 얽힘이 중요한 까닭은 여러 큐비트가 서로 독립된 비트처럼 움직이지 않고, 하나의 관계망처럼 정보를 표현할 수 있기 때문입니다. 각 큐비트를 따로 조작하는 것만으로는 만들 수 없는 공동 상태를 이용하면, 문제 속에 들어 있는 복잡한 관계를 양자 회로 안에 담을 수 있습니다. 얽힘은 양자 알고리즘, 양자 통신, 양자 오류 정정에서 중요한 자원으로 여겨집니다. QAI에서도 얽힘은 데이터 사이의 복잡한 관계를 표현할 수 있다는 점에서 주목받습니다. 그러나 데이터가 복잡하다고 해서 얽힘이 자동으로 유용해지는 것은 아닙니다. 문제의 구조가 양자 상태의 관계와 잘 맞고, 그 관계가 측정 가능한 결과로 이어질 때에만 실제 이점을 기대할 수 있습니다.
두 큐비트의 얽힘
얽힘은 두 큐비트를 각각 독립적으로 설명하는 대신, 둘의 관계 전체를 하나의 공동 양자 상태로 보아야 한다는 점을 드러냅니다.
이 가능성을 탐색하는 방법 가운데 하나는 데이터를 양자 상태로 옮긴 뒤, 두 데이터가 양자 상태 안에서 얼마나 비슷하게 나타나는지 비교하는 방식입니다. 이렇게 양자 상태 공간에서 계산한 유사도를 학습에 활용하는 방법을 양자 커널(quantum kernel)이라고 합니다. 핵심은 이 유사도가 고전적인 방법으로는 쉽게 얻기 어려운 구분 능력을 제공할 수 있는가에 있습니다. 또 다른 접근은 조절 가능한 손잡이가 달린 양자 회로를 사용하는 것입니다. 양자 장치가 회로를 실행해 측정값을 내놓으면, 고전 컴퓨터가 그 결과를 보고 손잡이의 값을 조금씩 바꿉니다. 이 과정을 반복하며 목표에 가까워지도록 학습하는 회로를 변분 양자 회로(variational quantum circuit)라고 합니다. 양자 장치와 고전 컴퓨터가 역할을 나누는 혼합형 학습 방식입니다.
이런 매개변수화된 양자 회로를 학습 모델로 사용하는 여러 접근을 넓게 양자 신경망(quantum neural network)이라 부르기도 합니다. 그러나 고전 신경망의 뉴런을 단순히 큐비트로 바꾼 것이라고 이해하면 곤란합니다. 양자 신경망은 정보 표현, 연산, 측정 방식이 고전 신경망과 다르게 구성될 수 있습니다. 문제는 얽힘을 만들고 유지하는 일이 매우 어렵다는 데 있습니다. 큐비트가 열, 전자기 잡음, 주변 입자와 상호작용하면 양자 상태의 섬세한 관계가 흐트러집니다. 회로가 길어지고 연산 단계가 많아질수록 오류도 쌓이기 쉽습니다. 따라서 실제 QAI 모델은 표현 능력뿐 아니라 회로의 깊이, 장치의 잡음, 필요한 측정 횟수까지 함께 고려해야 합니다.
얽힘이 많을수록 무조건 좋은 것도 아닙니다. 지나치게 복잡한 얽힘은 실제 장치에서 구현하기 어렵고, 학습 과정에서 매개변수를 바꾸어도 결과가 거의 달라지지 않는 문제를 만들 수 있습니다. 어떤 큐비트들을 어떤 방식으로 얽히게 할지는 데이터의 성격, 풀려는 문제, 사용할 장치의 구조에 따라 달라집니다. 결국 QAI에서 얽힘은 신비로운 만능 열쇠가 아닙니다. 여러 큐비트가 고전적으로 분리하기 어려운 공동 상태를 이루게 하는 강력한 물리적 자원이지만, 동시에 매우 섬세하고 제어하기 어려운 자원입니다. 중요한 것은 얽힘을 많이 만드는 일이 아니라, 필요한 관계를 필요한 만큼 만들고 그것을 실제 학습과 추론의 이점으로 바꾸는 일입니다.
> 큐비트 연산의 핵심, 중첩과 얽힘 > 큐비트는 양자적 상태를 이용해 정보를 표현하는 양자컴퓨터의 기본 정보 단위입니다. 일반 비트가 계산 과정에서 0 또는 1의 값을 갖는 것과 달리, 큐비트는 측정 전 \(|0\rangle\)과 \(|1\rangle\)의 확률진폭과 상대적 위상을 포함하는 중첩 상태를 가질 수 있습니다. 측정하면 0 또는 1 가운데 하나의 결과를 얻습니다. > 실제 큐비트는 초전도 회로, 이온, 원자, 전자 스핀, 광자처럼 제어 가능한 두 양자 상태로 구현됩니다. > 전자 에너지의 양자화와 큐비트 상태
> 원자에 묶인 전자의 에너지가 허용된 준위로 나타나듯, 실제 큐비트도 구별하고 제어할 수 있는 두 양자 상태를 \(|0\rangle\)과 \(|1\rangle\)의 기준으로 삼습니다. > 두 개 이상의 큐비트는 각각을 따로 설명할 수 없는 공동 상태인 얽힘을 형성할 수 있습니다. > > 양자 중첩과 양자 얽힘
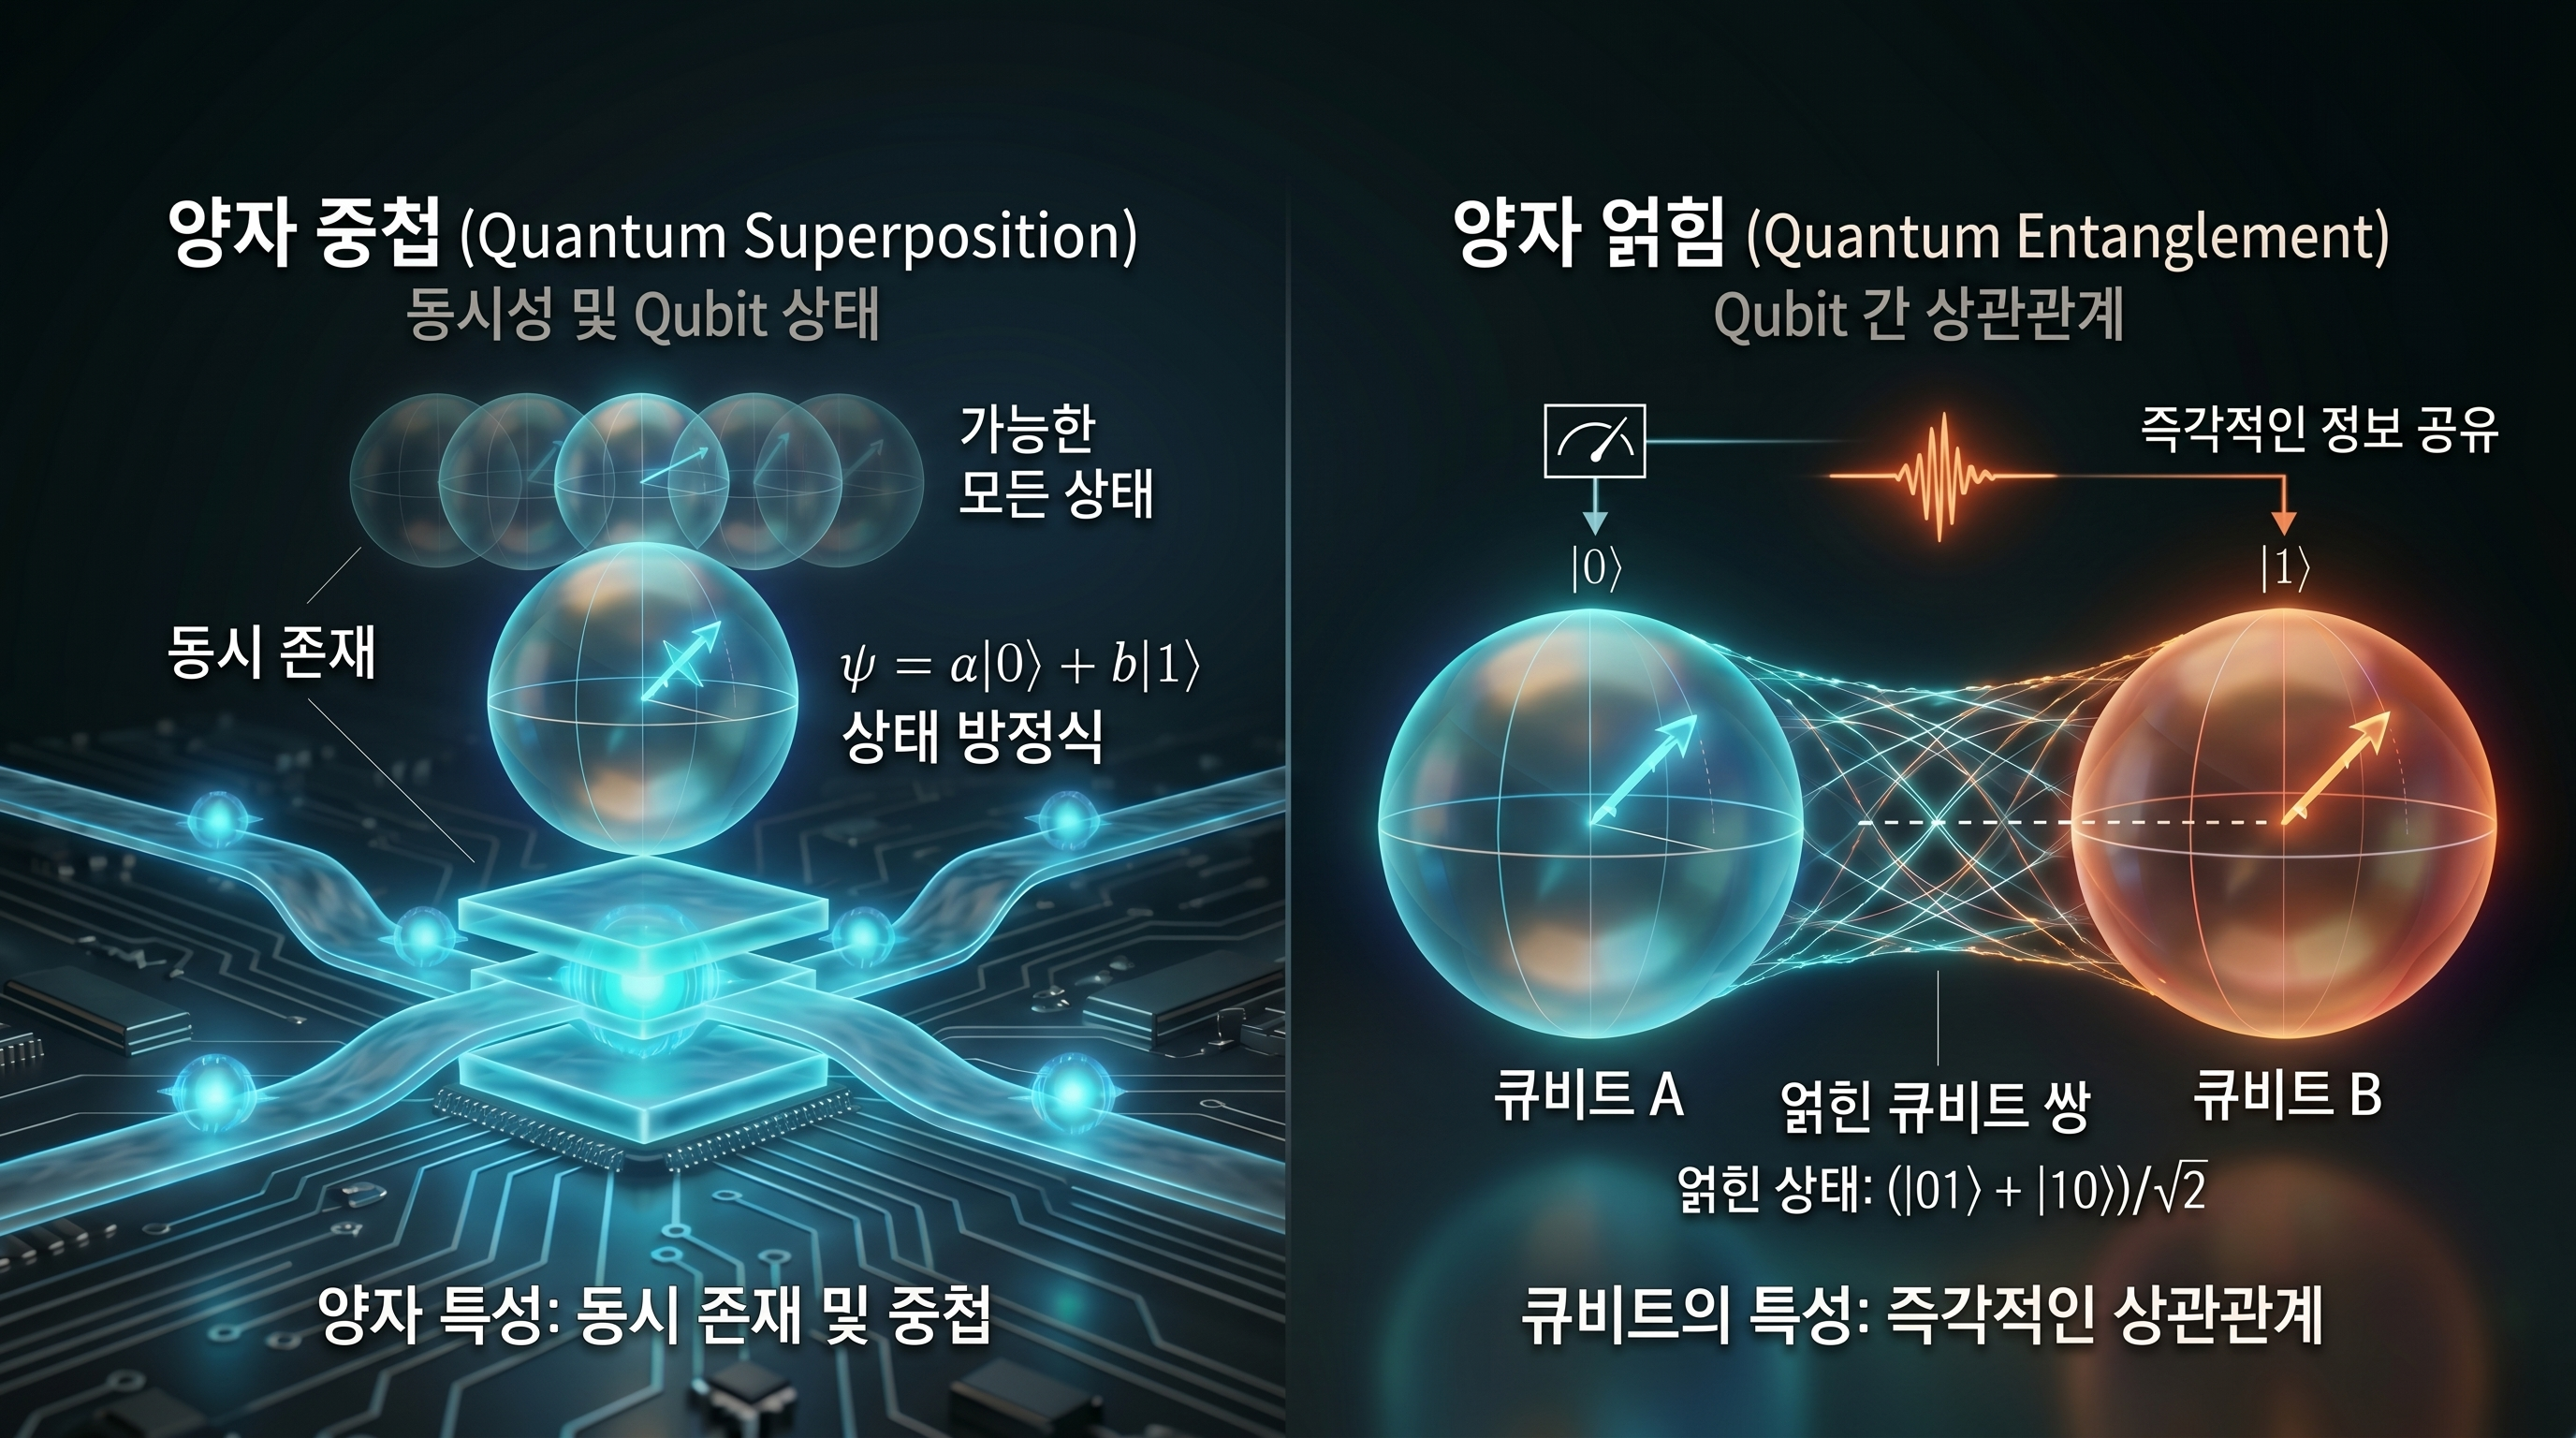
> 중첩은 하나의 큐비트가 여러 가능성의 진폭을 함께 가진 상태이고, 얽힘은 둘 이상의 큐비트를 하나의 공동 상태로 기술해야 하는 현상입니다. 양자컴퓨터는 중첩과 얽힘뿐 아니라 간섭을 제어해 원하는 답의 확률을 키우고 원하지 않는 답의 확률을 줄입니다. > 이러한 성질이 모든 계산을 자동으로 빠르게 만드는 것은 아닙니다. 특정 알고리즘과 문제 구조, 안정적인 장치와 오류 제어가 함께 갖추어질 때 계산상의 이점을 기대할 수 있습니다. > 결맞음과 결어긋남 > 큐비트의 중첩과 얽힘이 유지되려면 여러 양자 상태 사이의 위상 관계가 일정하게 보존되어야 합니다. 이처럼 양자 상태들이 서로 조화를 이루며 위상 관계를 유지하는 상태를 양자 결맞음(Coherence)이라고 합니다. 이와 달리 외부의 열이나 진동, 전자기 잡음으로 이 관계가 무너지면 중첩과 얽힘도 빠르게 약해지는데 이를 양자 결어긋남(Decoherence)이라 부릅니다.
8.4 양자컴퓨터는 모든 문제를 빠르게 푸는가
빠른 배가 있다고 해서 모든 여행이 짧아지는 것은 아닙니다. 바닷길이 있어야 하고, 출발지와 목적지에 맞는 항구가 있어야 하며, 실을 짐도 배에 알맞아야 합니다. 양자컴퓨터도 마찬가지입니다. 모든 문제를 고전 컴퓨터보다 빠르게 푸는 만능 계산기가 아닙니다.
중요한 질문은 “양자라서 빠른가”가 아닙니다. 어떤 문제의 구조가 양자컴퓨터의 작동 방식과 잘 맞는가입니다. 고전 컴퓨터는 비트와 논리 연산으로 계산하지만, 양자컴퓨터는 큐비트의 중첩, 간섭, 얽힘을 이용해 상태를 바꿉니다. 이 차이는 특정 문제에서는 새로운 계산 경로를 열 수 있지만, 대부분의 일상적 계산을 자동으로 빠르게 만들어 주지는 않습니다. 산악자전거와 자동차를 떠올려 볼 수 있습니다. 산악자전거는 거친 산길에서 강하지만, 고속도로에서 자동차를 대신하지는 못합니다. 잠수정은 바닷속 탐사에 뛰어나지만, 도시의 출퇴근 수단으로는 맞지 않습니다. 계산 도구의 힘도 절대적인 속도보다, 풀려는 문제와 얼마나 잘 맞는지에 따라 달라집니다.
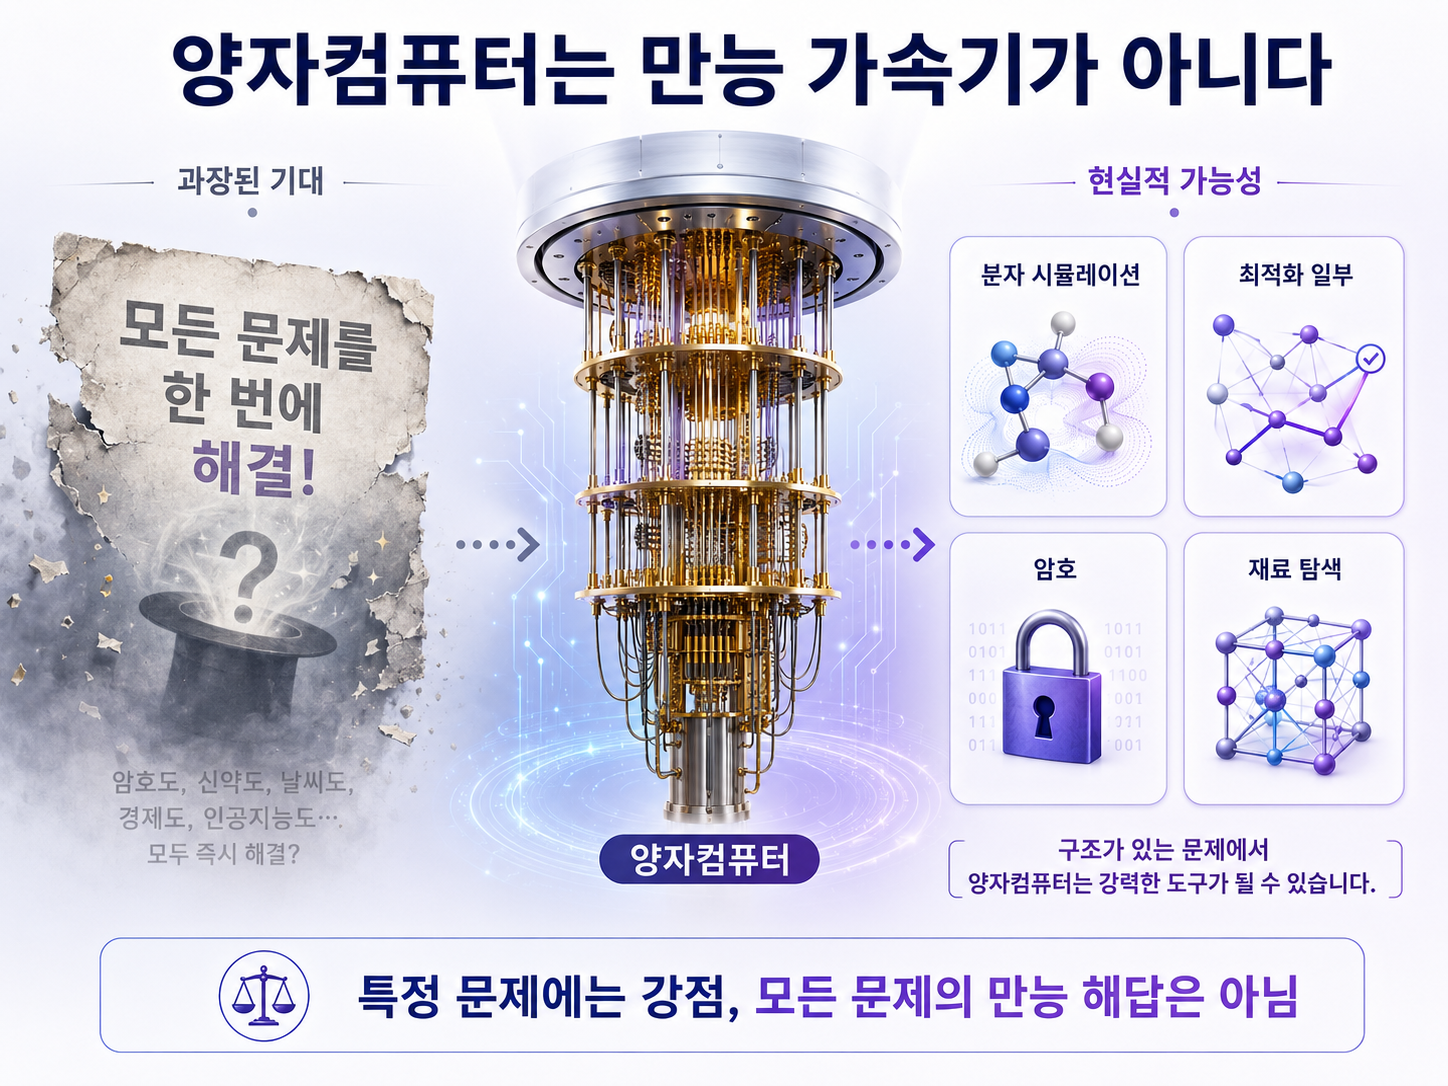
양자컴퓨터의 힘은 모든 문제를 빨리 푸는 데 있지 않고, 양자 자원이 잘 맞는 특정 문제 구조에서 드러납니다.
양자컴퓨터의 이론적 강점이 잘 알려진 사례 가운데 하나는 큰 수를 소인수분해하는 문제입니다. 쇼어 알고리즘(Shor’s algorithm)은 충분히 크고 오류가 잘 보정된 양자컴퓨터가 있다면, 알려진 고전적 방법과 다른 효율로 이 문제를 풀 수 있음을 보여 줍니다. 하지만 실제 암호 체계에 영향을 줄 규모로 실행하려면 지금보다 훨씬 많은 고품질 큐비트와 정교한 오류 정정이 필요합니다. 또 다른 중요한 분야는 작은 양자 세계를 다른 양자 장치로 흉내 내는 일입니다. 분자나 물질 속 전자들은 본래 양자역학의 규칙에 따라 움직이기 때문에, 고전 컴퓨터로 정확히 계산하기 매우 어려울 수 있습니다. 이런 대상을 양자 장치로 더 직접적으로 표현하고 계산하려는 방법을 양자 시뮬레이션(quantum simulation)이라고 합니다. 신약, 촉매, 배터리, 신소재 연구와 연결될 수 있어 중요한 가능성으로 연구되고 있습니다.
QAI에서도 비슷한 질문이 필요합니다. 양자컴퓨터가 모든 딥러닝 학습을 곧바로 빠르게 해 줄 것이라고 말하기는 어렵습니다. 고전 데이터를 양자 상태로 넣는 과정, 양자 회로를 여러 번 실행하는 비용, 측정 결과에서 충분한 정보를 얻는 데 필요한 반복 횟수, 큐비트의 잡음과 오류가 모두 성능에 영향을 줍니다. 양자 계산에서 얻는 이점보다 데이터를 넣고 결과를 읽는 비용이 더 크다면 실질적인 가속은 이루어지지 않습니다. 현재의 양자 장치는 아직 제한이 많습니다. 큐비트 수가 충분하지 않고, 오류가 쉽게 쌓이며, 중첩과 얽힘을 오래 안정적으로 유지하기도 어렵습니다. 작은 실험에서 흥미로운 결과가 나왔다고 해서 곧바로 산업 현장의 큰 문제를 안정적으로 해결할 수 있다는 뜻은 아닙니다. 양자컴퓨터의 가능성과 현재 장치의 한계는 구별해야 합니다.
그래서 양자컴퓨터의 성능을 말할 때는 단순한 계산 시간만 보면 안 됩니다. 장치를 준비하고 제어하는 비용, 오류를 줄이는 데 필요한 자원, 반복 측정 횟수, 데이터 입력과 출력, 고전 컴퓨터에서 수행하는 후처리까지 함께 따져야 합니다. 특정한 계산 단계가 빨라도 전체 작업이 더 효율적이지 않다면 실용적인 이점이라고 보기 어렵습니다. 이 점에서 양자 우위(quantum supremacy)나 양자 이점(quantum advantage)이라는 표현도 신중하게 써야 합니다. 양자컴퓨터가 어떤 문제에서 고전 컴퓨터보다 앞섰다고 말하려면, 어떤 문제를 풀었는지, 입력의 크기는 얼마였는지, 어떤 고전 알고리즘과 비교했는지, 정확도와 시간·에너지 비용을 어떻게 계산했는지를 함께 밝혀야 합니다. 제한된 시험 문제에서 앞서는 것과 현실의 유용한 문제에서 지속적인 이점을 얻는 것은 서로 다른 성과입니다.
양자컴퓨터가 모든 문제를 빠르게 풀지 못한다는 사실은 실망스러운 결론이 아닙니다. 오히려 더 정확한 연구 질문을 열어 줍니다. 어떤 문제의 수학적 구조가 양자 간섭과 잘 맞는지, 어떤 계산 과정에서 얽힘이 필요한지, 어느 부분을 양자 장치에 맡기고 어느 부분을 고전 컴퓨터가 처리해야 하는지를 찾아야 합니다. 결국 QAI의 전망을 읽을 때 “양자라서 빠르다”는 말에 머물러서는 안 됩니다. 어떤 데이터와 알고리즘을 쓰는지, 어떤 하드웨어 조건에서 실행되는지, 가장 강력한 고전적 방법과 비교해도 전체 비용에서 이점이 있는지를 물어야 합니다. 질문이 구체적일수록 과장은 줄어들고, 양자컴퓨팅이 실제로 유용해질 수 있는 자리가 더 선명해집니다.
8.5 양자기계학습의 기본 생각
복잡하게 뒤섞인 점들을 평면 위에서 보면 구분하기 어렵지만, 다른 각도에서 보거나 더 알맞은 좌표로 옮기면 숨어 있던 경계가 드러날 수 있습니다. 기계학습은 이처럼 데이터를 더 잘 구분할 수 있는 표현으로 바꾸고, 그 안에서 분류와 예측에 필요한 패턴을 찾습니다.
양자기계학습(quantum machine learning)은 이 표현의 공간을 양자 상태와 양자 회로로 넓혀 보려는 연구입니다. 고전적인 숫자, 이미지, 신호 데이터를 큐비트의 상태로 옮기고, 양자 회로를 통과시키며 진폭과 위상, 얽힘의 관계를 바꾼 뒤, 측정 결과를 학습에 활용합니다. 핵심 질문은 단순히 “양자를 쓰는가”가 아니라, 양자 상태가 실제로 데이터를 더 잘 구분하거나 예측하는 데 도움이 되는가입니다. 다만 양자 상태가 큰 수학적 공간에 놓인다는 사실만으로 학습이 자동으로 좋아지는 것은 아닙니다. 넓은 체육관이 있다고 해서 경기력이 저절로 좋아지지는 않습니다. 그 공간 안에서 데이터를 의미 있게 배치하고, 필요한 정보를 측정으로 꺼낼 수 있어야 합니다. 표현 공간의 크기와 실제 학습 능력은 같은 말이 아닙니다.
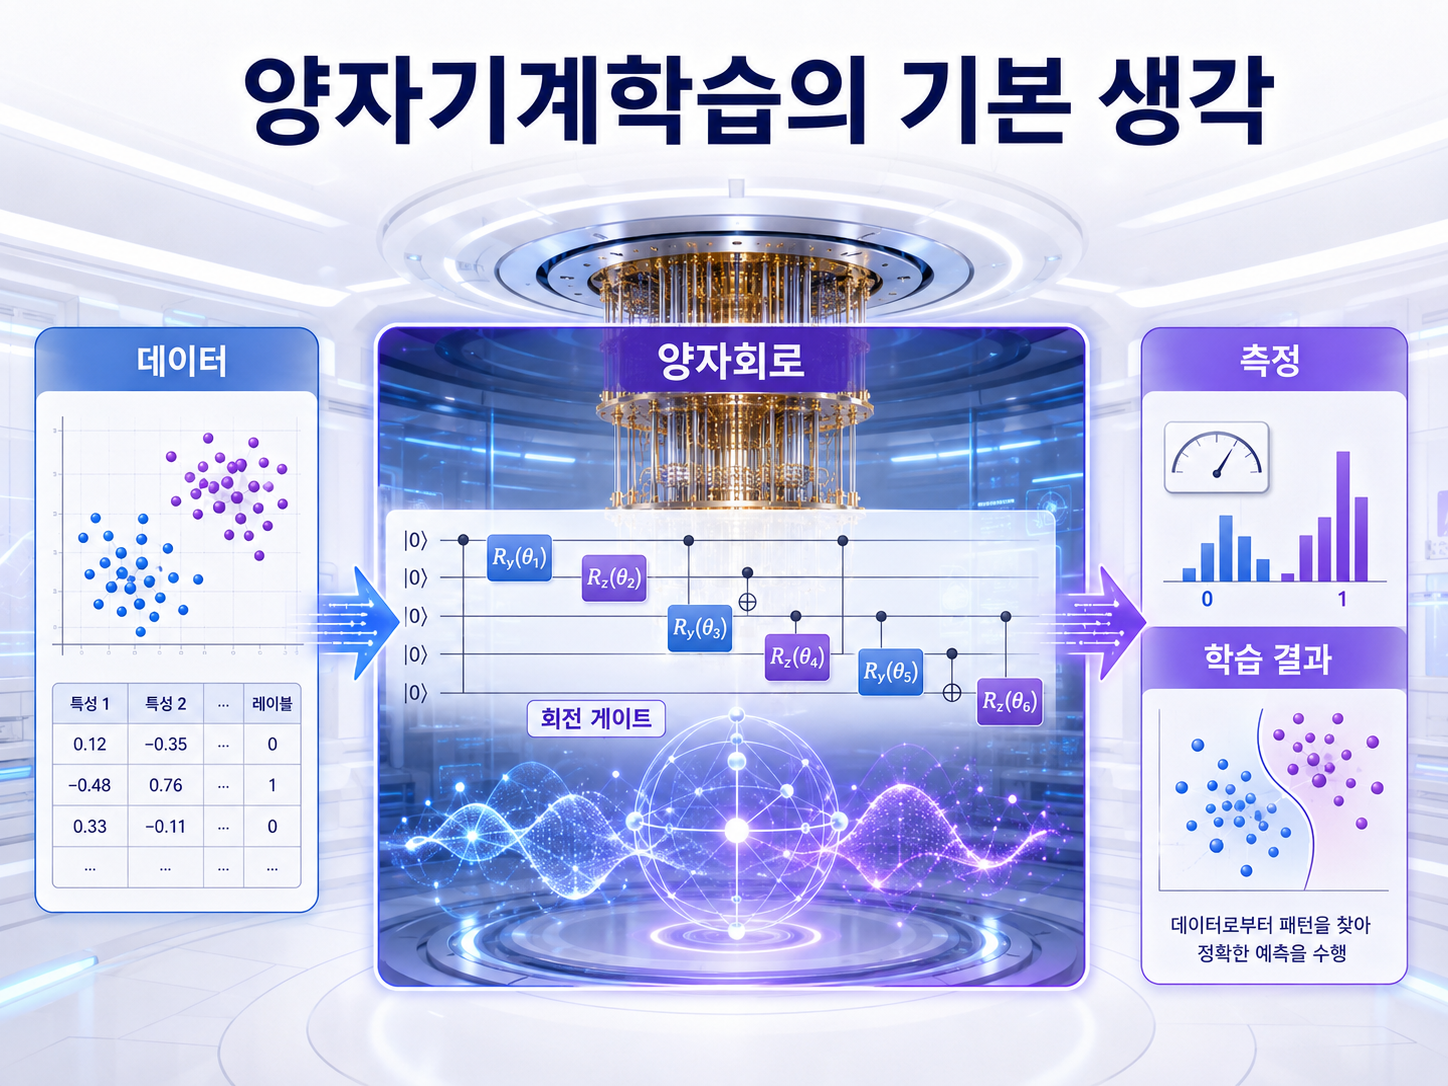
양자기계학습은 데이터를 양자 상태 공간으로 옮겨 새로운 표현을 찾으려 하지만, 입력 비용과 잡음, 큐비트 수의 한계를 함께 안고 있습니다.
대표적인 접근 가운데 하나는 두 데이터를 양자 상태로 바꾼 뒤, 그 상태들이 얼마나 비슷한지 비교하는 방법입니다. 이렇게 양자 상태 공간에서 계산한 유사도를 분류에 활용하는 방식을 양자 커널 방법(quantum kernel method)이라고 합니다. 중요한 질문은 이 유사도가 고전적인 방법으로는 얻기 어려운 구분 능력을 제공하는가입니다.
또 다른 접근은 조절 가능한 손잡이가 달린 양자 회로를 학습에 사용하는 것입니다. 양자 장치가 회로를 실행해 측정값을 내놓으면, 고전 컴퓨터가 그 결과를 보고 손잡이 값을 조금씩 바꿉니다. 이 과정을 반복하며 목표에 가까운 결과를 찾는 회로를 변분 양자 회로(variational quantum circuit)라고 합니다. 양자 장치가 상태를 만들고, 고전 컴퓨터가 학습 방향을 조정하는 혼합형 방식입니다. 이런 매개변수화된 양자 회로를 학습 모델로 사용하는 접근을 넓게 양자 신경망(quantum neural network)이라고 부르기도 합니다. 그러나 고전 신경망의 뉴런을 큐비트로 단순히 바꾼 것이라고 이해해서는 안 됩니다. 양자 신경망은 정보 표현, 연산, 측정 방식이 고전 신경망과 다르게 구성됩니다.
양자기계학습이 넘어야 할 첫 번째 관문은 데이터 입력입니다. 대부분의 현실 데이터는 숫자, 이미지, 문장처럼 고전적인 형태로 저장되어 있습니다. 이를 큐비트의 상태로 옮기려면 별도의 회로와 시간이 필요합니다. 데이터 입력 비용이 너무 크면, 양자 회로 안에서 얻을 수 있는 이점이 시작하기도 전에 줄어들 수 있습니다.
두 번째 관문은 측정 비용입니다. 양자 회로를 한 번 실행하면 가능한 결과 가운데 하나가 확률적으로 나옵니다. 안정적인 값을 얻으려면 같은 회로를 여러 번 반복 실행해야 합니다. 원하는 정밀도가 높아질수록 반복 횟수도 늘어날 수 있습니다. 양자 계산은 결과를 읽어내는 비용까지 함께 따져야 합니다.
세 번째 관문은 잡음과 회로 오류입니다. 현재의 양자 장치는 큐비트 상태를 오래 안정적으로 유지하기 어렵고, 양자 게이트와 측정에도 오류가 섞입니다. 회로가 깊어질수록 오류가 쌓이기 쉽습니다. 이론적으로 표현력이 좋은 회로라도 실제 장치에서는 안정적으로 실행하기 어려울 수 있습니다.
그래서 양자기계학습의 성능은 강력한 고전적 방법과 공정하게 비교해야 합니다. 양자 모델의 정확도만 보는 것으로는 충분하지 않습니다. 같은 데이터, 같은 목표, 비슷한 계산 자원을 놓고 가장 좋은 고전 모델보다 나은지 확인해야 합니다. 때로는 양자 회로의 효과를 고전 컴퓨터가 효율적으로 흉내 낼 수도 있으므로, 성능 향상이 정말 양자적 자원에서 나온 것인지도 검토해야 합니다. 그렇다고 양자기계학습의 가치가 낮다는 뜻은 아닙니다. 새로운 데이터 표현과 학습 구조를 탐구하는 일은 그 자체로 중요한 연구입니다. 특히 양자 센서, 양자 물질, 양자 화학처럼 데이터가 처음부터 양자 실험에서 만들어지는 경우에는 양자 상태를 직접 다루는 학습 방법이 더 자연스러울 수 있습니다.
결국 양자기계학습은 가까운 시일 안에 모든 고전 AI를 대체하는 기술이라기보다, 양자 상태와 회로가 데이터의 표현과 학습에 어떤 새로운 가능성을 줄 수 있는지 시험하는 분야입니다. 중요한 것은 가능성을 과장하는 일이 아니라, 어떤 데이터와 문제, 어떤 장치 조건에서 실제 이점이 생기는지 구체적으로 찾는 일입니다.
8.6 양자 시뮬레이션과 과학 AI
작은 모형 배를 수조에 띄우면 실제 배가 파도에 어떻게 흔들릴지 어느 정도 알아볼 수 있습니다. 모형이 실제 배와 완전히 같지는 않지만, 중요한 조건을 잘 맞추면 현실을 이해하는 데 도움이 됩니다. 양자 세계를 연구할 때도 비슷한 생각을 할 수 있습니다. 분자나 물질처럼 양자역학의 규칙을 따르는 대상을, 제어 가능한 다른 양자 장치로 흉내 내어 계산하려는 방법을 양자 시뮬레이션(quantum simulation)이라고 합니다.
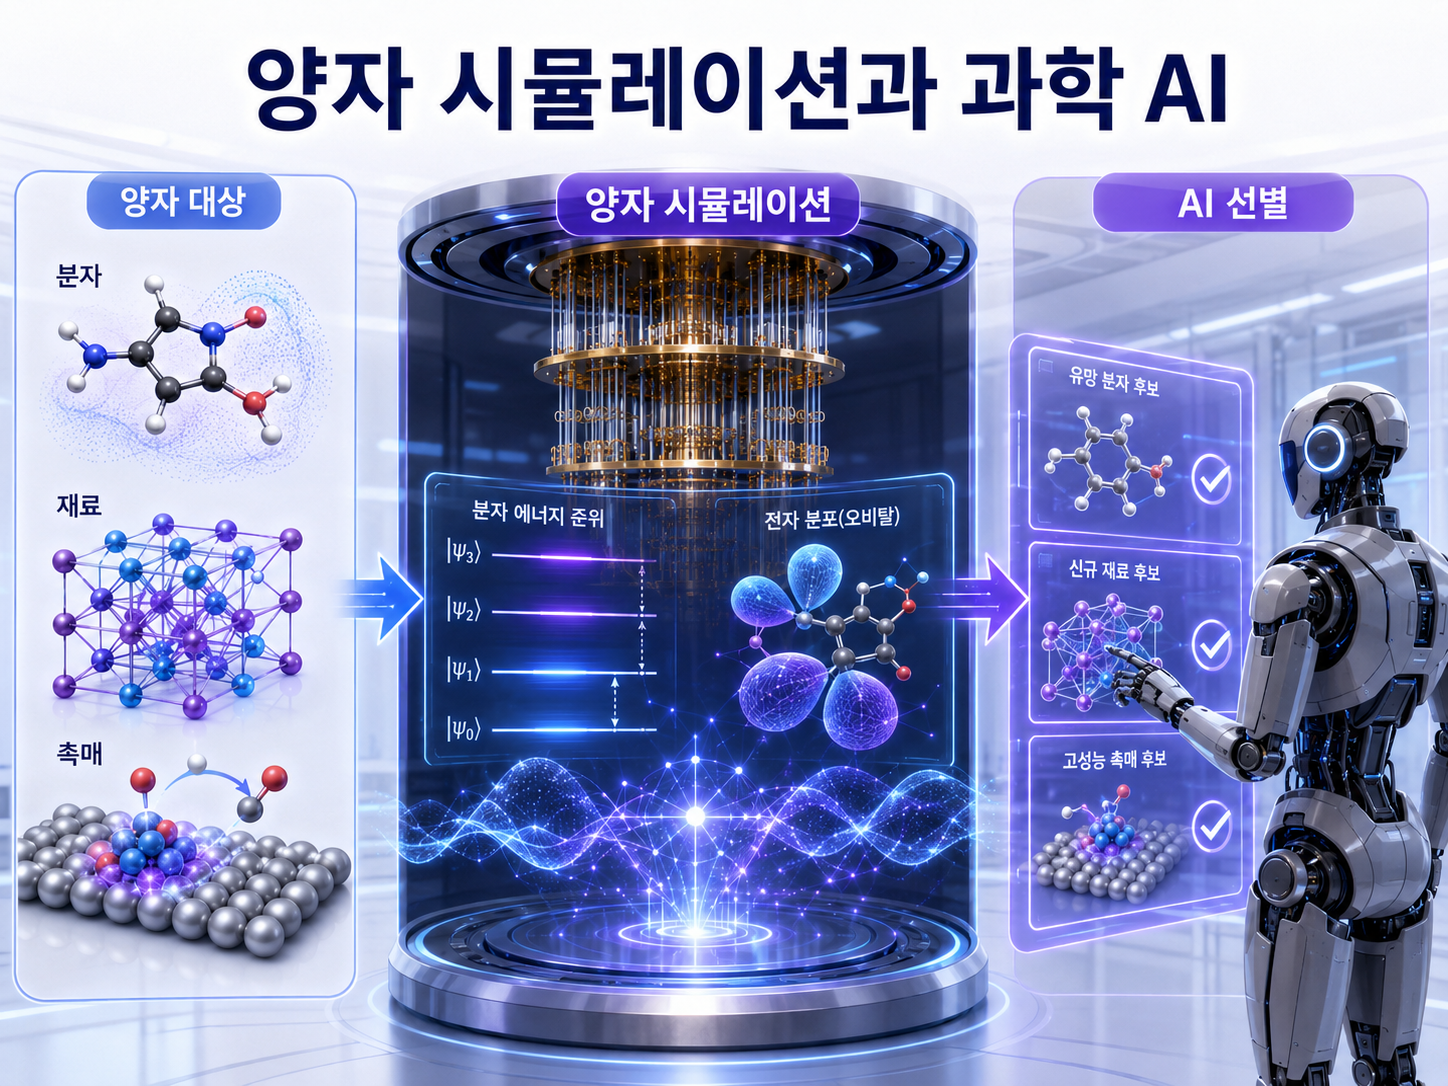
양자 시뮬레이션은 자연이 양자적이라는 사실을 계산의 가능성으로 바꾸려는, QAI의 중요한 연구 방향 가운데 하나입니다.
분자와 물질 속 전자들은 중첩, 얽힘, 파울리 배타원리 같은 양자 규칙을 따릅니다. 전자의 수가 늘어나면 가능한 상태의 수가 매우 빠르게 커지기 때문에, 고전 컴퓨터로 전체 상태를 정확히 계산하기 어려워질 수 있습니다. 물론 모든 분자 계산이 고전 컴퓨터로 불가능한 것은 아닙니다. 이미 많은 화학·재료 문제는 강력한 근사 계산으로 다루고 있습니다. 다만 전자 사이의 관계가 특히 복잡하거나 높은 정확도가 필요한 경우에는 계산 비용이 크게 늘어납니다. 양자 시뮬레이션은 바로 이런 영역에서 새로운 도구가 될 수 있습니다. 자연의 양자적 움직임을 고전적인 숫자로만 흉내 내기보다, 실제 양자 장치의 상태 변화로 표현해 보려는 것입니다. 원자, 이온, 초전도 회로 같은 장치를 이용해 특정한 양자 현상을 재현하거나, 양자 게이트를 차례로 적용해 분자와 물질의 에너지 상태를 계산할 수 있습니다.
이 지점에서 양자컴퓨팅과 과학 AI가 만납니다. AI는 수많은 분자와 재료 후보 가운데 가능성이 높은 대상을 먼저 골라낼 수 있습니다. 그런 뒤 양자 시뮬레이션은 그 후보의 전자 상태, 결합 안정성, 반응 에너지 같은 양자적 성질을 더 정밀하게 계산합니다. 계산 결과는 다시 AI의 학습 자료가 되어 다음 후보 선택을 개선합니다. 이 흐름은 하나의 연구 순환으로 볼 수 있습니다. 먼저 AI가 후보를 만들거나 고릅니다. 다음으로 양자 장치가 중요한 성질을 계산합니다. 이어 실제 실험으로 그 결과를 확인합니다. 마지막으로 실험 결과를 다시 AI에 넣어 다음 예측을 더 좋게 만듭니다. 이처럼 후보 생성–양자 계산–실험 검증–재학습이 반복되면, 신약·촉매·배터리·신소재 탐색의 속도를 높일 가능성이 있습니다.
AI는 양자 장치 자체를 다루는 데에도 도움을 줄 수 있습니다. 복잡한 양자 회로를 더 짧게 줄이거나, 실험 조건을 조정하고, 측정 잡음과 장치 오류를 보정하는 데 기계학습을 활용할 수 있습니다. 즉 양자 장치가 AI의 계산을 돕는 동시에, AI가 양자 장치를 더 안정적으로 제어하도록 돕는 상호작용이 가능합니다. 그러나 현실적인 장벽은 여전히 큽니다. 화학적으로 의미 있는 정밀도를 얻으려면 충분한 수의 안정적인 큐비트와 낮은 오류율이 필요합니다. 현재의 양자 장치는 회로 깊이와 측정 횟수에 제약이 있고, 오류를 줄이는 데도 큰 비용이 듭니다. 작은 분자에서 원리를 보인 것과 산업적으로 중요한 복잡한 분자를 안정적으로 계산하는 것은 다른 단계입니다.
따라서 양자 시뮬레이션의 성과는 신중하게 평가해야 합니다. 양자 장치가 계산한 값이 기존 고전 계산이나 실제 실험과 얼마나 잘 맞는지, 더 적은 자원으로 의미 있는 정보를 제공했는지 확인해야 합니다. 단지 양자 장치에서 실행되었다는 이유만으로 과학적 가치나 실용적 이점이 생기는 것은 아닙니다. 양자인공지능(Quantum AI, QAI)의 현실적인 가능성도 모든 AI를 양자컴퓨터로 옮기는 데 있지 않을 수 있습니다. 오히려 분자, 물질, 촉매처럼 본래 양자역학적인 과학 문제에서 고전 AI와 양자 장치가 역할을 나누는 방향이 더 먼저 의미 있는 성과를 낼 수 있습니다. AI는 후보를 찾고, 양자 장치는 중요한 양자 성질을 계산하며, 실험은 그 결과를 검증합니다.
결국 양자 시뮬레이션은 자연을 이해하기 위해 자연과 비슷한 원리를 가진 도구를 만드는 일입니다. QAI의 핵심도 화려한 전망이 아니라, 이 도구들을 어떻게 연결해 실제 과학 문제에서 검증 가능한 지식을 얻을 것인가에 있습니다. 가능성은 크지만, 그 가치는 실제 정확도와 반복 가능한 실험 결과로 평가되어야 합니다.
8.7 양자 잡음과 오류 보정
눈밭에 남은 발자국은 바람이 불면 금세 흐려집니다. 양자 상태도 비슷합니다. 큐비트가 주변 환경과 조금만 상호작용해도 중첩과 얽힘을 이루는 섬세한 관계가 쉽게 흐트러집니다. 양자컴퓨터가 실제 계산 도구가 되려면 양자 상태를 충분히 오래 유지하고, 연산 중에 생기는 오류를 찾아 줄여야 합니다. 양자 장치에서 생기는 흔들림과 불안정성을 통틀어 양자 잡음(quantum noise)이라고 합니다. 열, 전자기 신호, 주변 입자, 제어 장치의 미세한 불안정성이 모두 잡음의 원인이 될 수 있습니다. 이 잡음은 큐비트의 상태를 조금씩 바꾸고, 계산 결과의 신뢰도를 떨어뜨립니다.
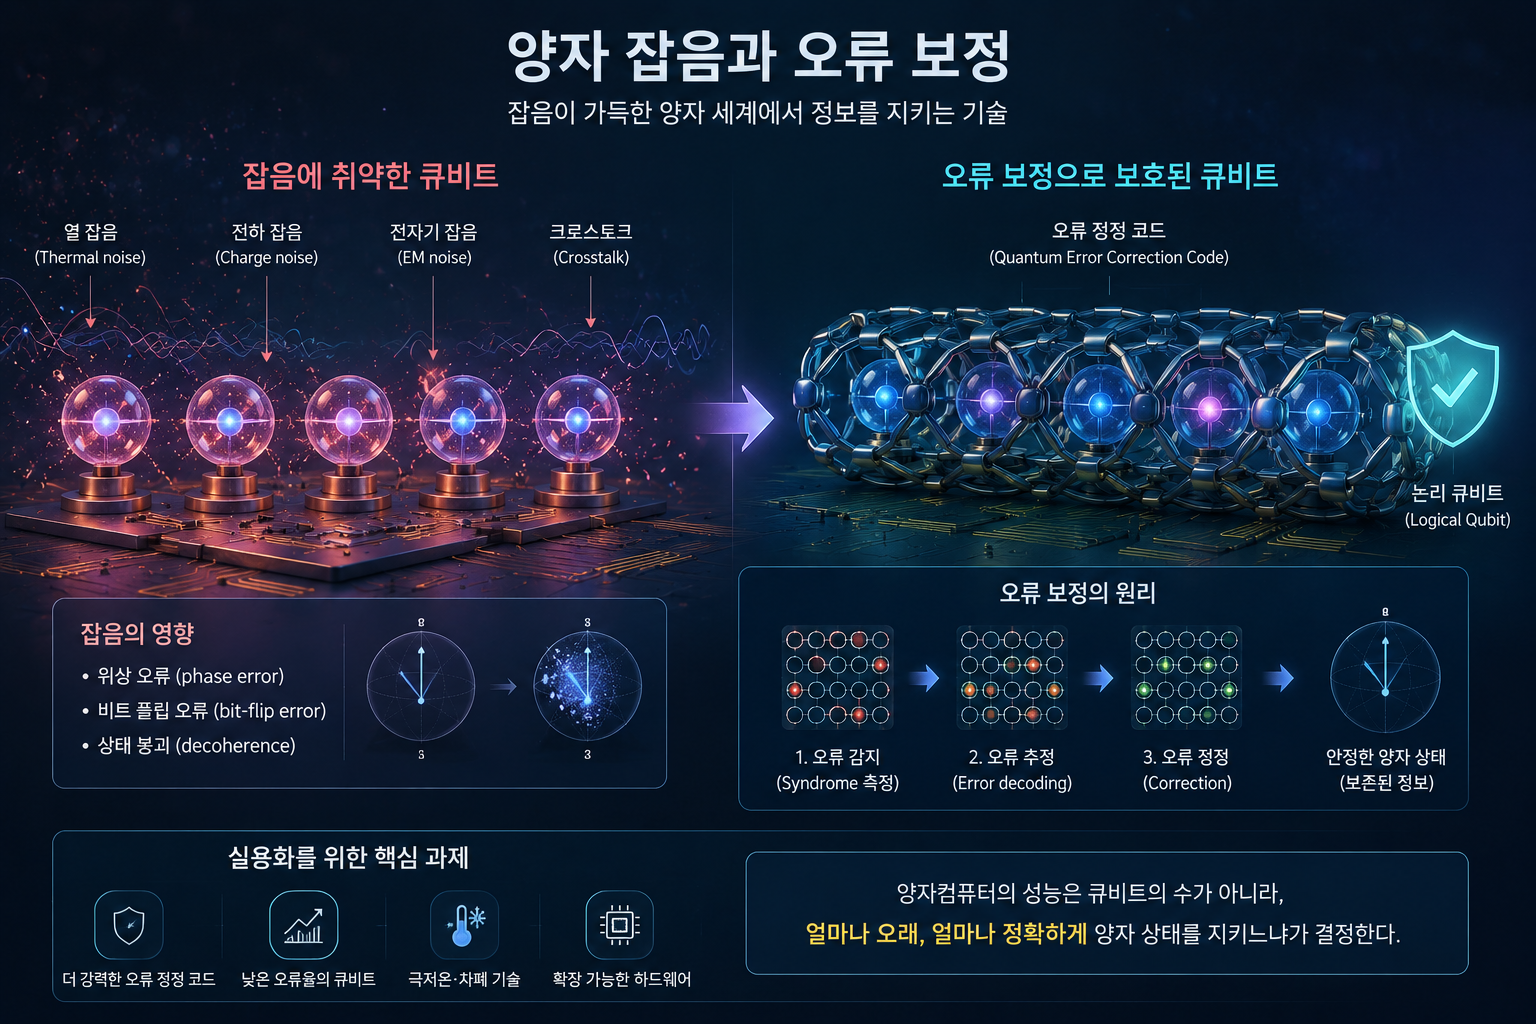
QAI의 현실성은 큐비트 수만이 아니라 잡음과 오류율, 회로 깊이와 연결 구조, 오류 보정에 필요한 자원을 함께 봐야 판단할 수 있습니다.
특히 중요한 문제는 양자 상태가 주변 환경과 얽히면서 원래 유지하던 위상 관계를 잃는 현상입니다. 중첩과 간섭에 필요한 섬세한 관계가 흐려지는 이 과정을 결어긋남(decoherence)이라고 합니다. 결어긋남이 커지면 큐비트는 더 이상 계산에 필요한 양자적 성질을 제대로 유지하지 못합니다. 오류는 결어긋남에서만 오지 않습니다. 큐비트를 원하는 만큼 정확히 회전시키지 못할 수도 있고, 두 큐비트를 연결하는 양자 게이트가 불완전할 수도 있습니다. 처음 준비한 상태가 기대와 다르거나, 측정 결과를 잘못 읽는 경우도 있습니다. 작은 오류라도 회로가 길어지면 계속 쌓여 최종 결과를 크게 바꿀 수 있습니다.
고전 컴퓨터에서는 정보를 여러 번 복사해 두고 서로 비교하면 오류를 찾기 쉽습니다. 그러나 양자 상태에서는 이 방법을 그대로 쓸 수 없습니다. 알지 못하는 임의의 양자 상태를 완벽하게 복사할 수 없기 때문입니다. 이를 복제 불가능 정리(no-cloning theorem)라고 합니다. 또한 양자 상태를 직접 들여다보면 측정 자체가 상태를 바꾸기 때문에, 계산 중인 정보를 마음대로 확인할 수도 없습니다. 그래서 양자 오류 보정은 우회로를 씁니다. 하나의 큐비트 정보를 실제 장치에 있는 여러 큐비트에 나누어 저장하고, 정보 자체를 직접 읽는 대신 어떤 종류의 오류가 생겼는지를 알려 주는 보조 신호를 측정합니다. 실제 장치에 놓인 개별 큐비트를 물리 큐비트(physical qubit)라고 하고, 여러 물리 큐비트가 함께 보호하는 하나의 안정된 정보 단위를 논리 큐비트(logical qubit)라고 합니다.
중요한 점은 물리 큐비트 수가 곧 계산에 사용할 수 있는 논리 큐비트 수가 아니라는 것입니다. 오류를 충분히 낮춘 논리 큐비트 하나를 만들려면 많은 물리 큐비트와 반복적인 오류 검사가 필요할 수 있습니다. 그래서 양자컴퓨터를 평가할 때는 큐비트 수만 볼 것이 아니라, 그 큐비트가 얼마나 안정적으로 동작하고 오류를 얼마나 잘 줄이는지도 함께 보아야 합니다. 아직 완전한 오류 보정이 어려운 장치에서는 오류를 모두 고치기보다, 잡음의 영향을 추정해 결과를 보정하는 방법도 사용됩니다. 이를 오류 완화(error mitigation)라고 합니다. 오류 완화는 제한된 실험에서 도움이 될 수 있지만, 오류를 계속 찾아 고치는 완전한 오류 보정(error correction)과는 다릅니다. 계산 규모가 커질수록 두 방법의 차이는 더 중요해집니다.
현재 많은 양자 장치는 완전한 오류 보정 단계에 이르지 못했습니다. 잡음이 있고, 큐비트 수는 어느 정도 늘어났지만, 대규모 안정 계산에는 아직 부족한 장치를 잡음이 있는 중간 규모 양자 장치(noisy intermediate-scale quantum, NISQ)라고 부릅니다. NISQ 장치에서는 짧은 회로와 고전 컴퓨터를 함께 쓰는 혼합형 알고리즘으로 제한된 문제에서 가능성을 찾는 연구가 이루어지고 있습니다. 그러나 NISQ 장치에서 작은 실험이 성공했다는 사실과, 오류가 보정된 대규모 양자컴퓨터가 실제 문제를 안정적으로 해결했다는 것은 다른 단계의 성과입니다. QAI의 가능성을 평가할 때도 사용한 큐비트 수, 회로의 깊이, 게이트와 측정의 오류율, 반복 실행 횟수, 고전적 후처리 비용을 함께 살펴야 합니다.
AI는 이 어려움을 줄이는 데 도움을 줄 수 있습니다. 장치의 잡음 특성을 분석하고, 제어 신호를 조정하며, 오류가 적은 회로 배치를 찾는 데 기계학습을 활용할 수 있습니다. 실험 중에 이상 신호를 감지하거나, 측정 결과에서 잡음의 영향을 줄이는 데에도 AI가 쓰일 수 있습니다. 양자 장치가 AI 계산을 돕는 것만큼, AI가 양자 장치를 안정적으로 운영하도록 돕는 일도 중요합니다. 결국 양자인공지능은 추상적인 알고리즘만의 문제가 아닙니다. 아무리 좋은 양자 회로가 설계되어도 실제 장치가 큐비트 상태를 오래 보존하지 못하면 계산의 이점은 사라집니다. 수학적 가능성은 냉각 장치, 제어 회로, 큐비트 연결, 오류 보정이라는 물리적 조건을 통과해야 합니다.
양자컴퓨터는 최고 속도만으로 평가할 수 있는 기계가 아닙니다. 정확도, 안정성, 연결 구조, 연산 속도, 오류 보정에 필요한 자원까지 함께 보아야 합니다. QAI의 미래도 큐비트를 많이 만드는 데서만 열리지 않습니다. 잡음 많은 양자 장치를 얼마나 정밀하게 제어하고, 오류를 얼마나 믿을 만하게 줄이며, 그 위에서 실제로 유용한 계산을 수행할 수 있는가에 달려 있습니다.
8.8 QAI 산업 전망과 과장
새로운 금광이 발견되었다는 소문이 돌면, 실제 금보다 기대가 먼저 거래되기도 합니다. 양자인공지능(Quantum AI, QAI)*도 비슷한 위험을 안고 있습니다. 양자 기술은 중요한 연구 분야이지만, 제한된 실험의 성과를 곧바로 “모든 AI가 양자로 대체될 것”이라는 전망으로 확대해서는 안 됩니다. 물론 기대는 필요합니다. 연구 자금과 인재를 모으고, 장비와 알고리즘 개발을 촉진하기 때문입니다. 그러나 기대가 지나친 약속으로 바뀌면 문제가 생깁니다. 성과가 예상보다 늦어질 때 큰 실망을 낳고, 그 실망은 실제로 가치 있는 기초 연구까지 불신하게 만들 수 있습니다. QAI에는 무조건적인 낙관도, 성급한 냉소도 어울리지 않습니다.
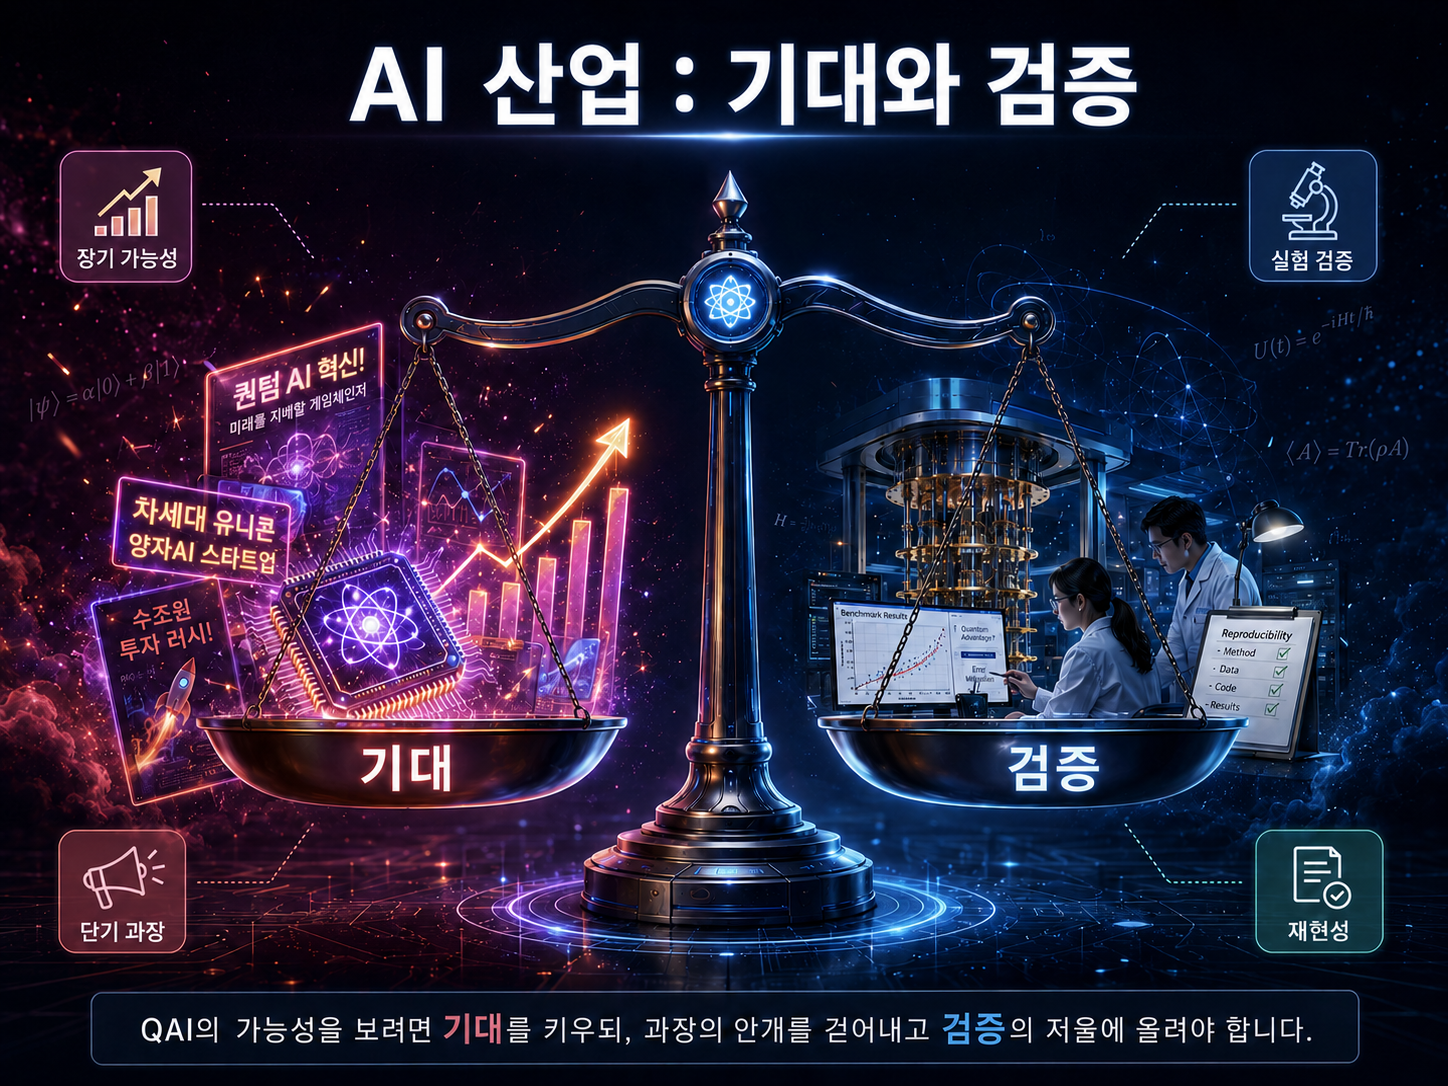
QAI의 산업 전망은 한 단계의 성공에 자만하지 않고, 연구와 실험, 상용화의 층위를 구분할 때 더 정확하게 이해할 수 있습니다.
그렇다면 신도시의 조감도를 떠올려 볼까요?. 그림에는 넓은 공원과 편리한 교통망, 아름다운 건물이 이미 완성된 것처럼 보입니다. 그러나 실제 도시는 토지, 예산, 환경, 주민 합의, 긴 공사 기간을 통과해야 합니다. QAI의 전망도 마찬가지입니다. 설계도와 완성된 도시를 구별하듯, 이론적 가능성과 실제 산업 성과를 구별해야 합니다. 기술 발전에는 단계가 있습니다. 먼저 수학적으로 가능한 방법을 제안하는 기초 연구가 있습니다. 다음에는 작은 장치나 제한된 자료에서 원리를 확인하는 실험적 시연이 이어집니다. 그 뒤 실제 산업 문제에서 기존 방법과 정확도, 속도, 비용을 비교하는 응용 검증이 필요합니다. 반복적으로 쓸 만한 경제적 가치가 확인되어야 비로소 상용화라고 말할 수 있습니다. 한 단계의 성공이 다음 단계의 완성을 보장하지는 않습니다.
QAI의 응용 분야로는 신약과 재료 설계, 분자 시뮬레이션, 금융과 물류의 최적화, 양자 센서 자료 분석 등이 자주 언급됩니다. 그러나 각 분야마다 조건이 다릅니다. 어떤 데이터가 필요한지, 양자 상태로 입력하는 비용은 얼마인지, 필요한 큐비트 수와 허용 가능한 오류는 어느 정도인지, 기존 AI보다 나은 경제적 가치가 있는지를 따로 검토해야 합니다. 한 분야의 가능성을 QAI 전체의 성공으로 확대해서는 안 됩니다.
‘양자’라는 말이 실제 기술보다 마케팅 장식으로 쓰이는 경우도 조심해야 합니다. 어떤 시스템이 중첩, 간섭, 얽힘 같은 양자 자원을 실제 계산에 사용하는지 확인해야 합니다. 양자컴퓨터를 직접 쓰지 않고, 양자 개념에서 아이디어를 얻어 고전 컴퓨터에서 실행하는 방법도 있습니다. 이를 양자 영감 알고리즘(quantum-inspired algorithm)이라고 부를 수 있습니다. 이런 방법도 유용할 수 있지만, 실제 양자컴퓨터를 사용한 기술과 같은 것으로 소개해서는 안 됩니다. 산업적 이점을 주장하려면 비교 기준도 분명해야 합니다. 어떤 문제와 데이터를 사용했는지, 가장 좋은 고전 알고리즘과 비교했는지, 장치 준비와 반복 측정, 데이터 입력과 후처리 비용까지 포함했는지 밝혀야 합니다. 속도나 정확도 가운데 유리한 항목만 골라 제시하면 실제 가치를 판단하기 어렵습니다.
시간의 층위도 나누어 보아야 합니다. 가까운 시기에는 고전 컴퓨터와 기존 AI가 대부분의 작업을 담당하고, 양자 장치는 특수한 계산이나 실험적 연구의 보조 도구로 활용될 가능성이 큽니다. 더 안정적인 논리 큐비트와 오류 보정 기술이 확보되면, 특정한 양자 시뮬레이션이나 최적화 문제에서 더 분명한 이점이 나타날 수 있습니다. 그러나 그 시점과 적용 범위는 구체적인 장치 성능과 문제 구조에 따라 달라집니다. 정책과 투자도 이 단계에 맞게 설계되어야 합니다. 기초 연구에는 실패를 허용하는 긴 호흡이 필요하고, 산업 지원에는 검증 가능한 중간 목표가 필요합니다. 교육과 대중 소통에서는 가능성뿐 아니라 현재의 한계와 필요한 조건을 함께 설명해야 합니다. 과장을 피하는 것은 비관이 아니라, 기술의 신뢰를 오래 지키는 태도입니다.
결국 QAI의 산업 전망을 읽을 때는 세 가지를 구별해야 합니다. 무엇이 이론적으로 제안되었는가. 무엇이 실제 장치에서 검증되었는가. 무엇이 기존 방법보다 비용까지 포함해 유용한가. 이 경계를 분명히 할 때 기대는 연구를 이끄는 힘이 되고, 과장은 과학의 자리를 대신하지 못합니다.
> QAI의 눈 : AI로봇이 진행하는 원자 수준의 검수작업 > 양자 센서는 양자 상태의 미세한 변화를 이용해 자기장·전류·온도 등을 정밀하게 감지하는 장치입니다. 이러한 양자 센서를 ‘눈’처럼 장착한 AI 로봇은 인간과 기존 장비가 놓치기 쉬운 초미세 신호를 분석해 결함과 열화(부품이나 재료가 시간이 지나며 약해지는 현상)의 패턴을 찾아낼 수 있습니다. 이 가능성을 실용화 단계에 가깝게 끌어올린 대표적 기술이 다이아몬드 NV 센터(nitrogen-vacancy center)를 이용한 양자 현미경입니다. NV 센터는 다이아몬드 결정 안에서 탄소 원자 하나가 질소 원자로 바뀌고, 그 옆자리가 비어 있을 때 생기는 원자 크기의 결함입니다. 보석으로 보면 흠이지만, 양자공학에서는 주변 자기장과 온도 변화에 민감하게 반응하는 초정밀 감각기관이 됩니다. 이 기술이 고도화되면 반도체 칩을 자르거나 망가뜨리지 않고도 내부 전류 흐름을 ‘들여다볼’ 수 있습니다. 특히 여러 층으로 쌓은 3D 칩과 첨단 패키징의 불량 분석에 유망합니다. 여기에 딥러닝 기반 신호 해석이 결합되면, AI는 복잡한 자기장 이미지에서 정상 전류와 비정상 전류를 구별하고 불량 징후를 조기에 판별할 수 있습니다. 이처럼 다이아몬드 NV 센터는 양자 인공지능(QAI)의 ‘눈’이 될 수 있습니다. 양자 센서는 원자 규모의 미세한 신호를 감지하고, AI는 그 신호를 해석해 반도체 생산의 수율과 신뢰성을 높이는 역할을 맡게 됩니다. >
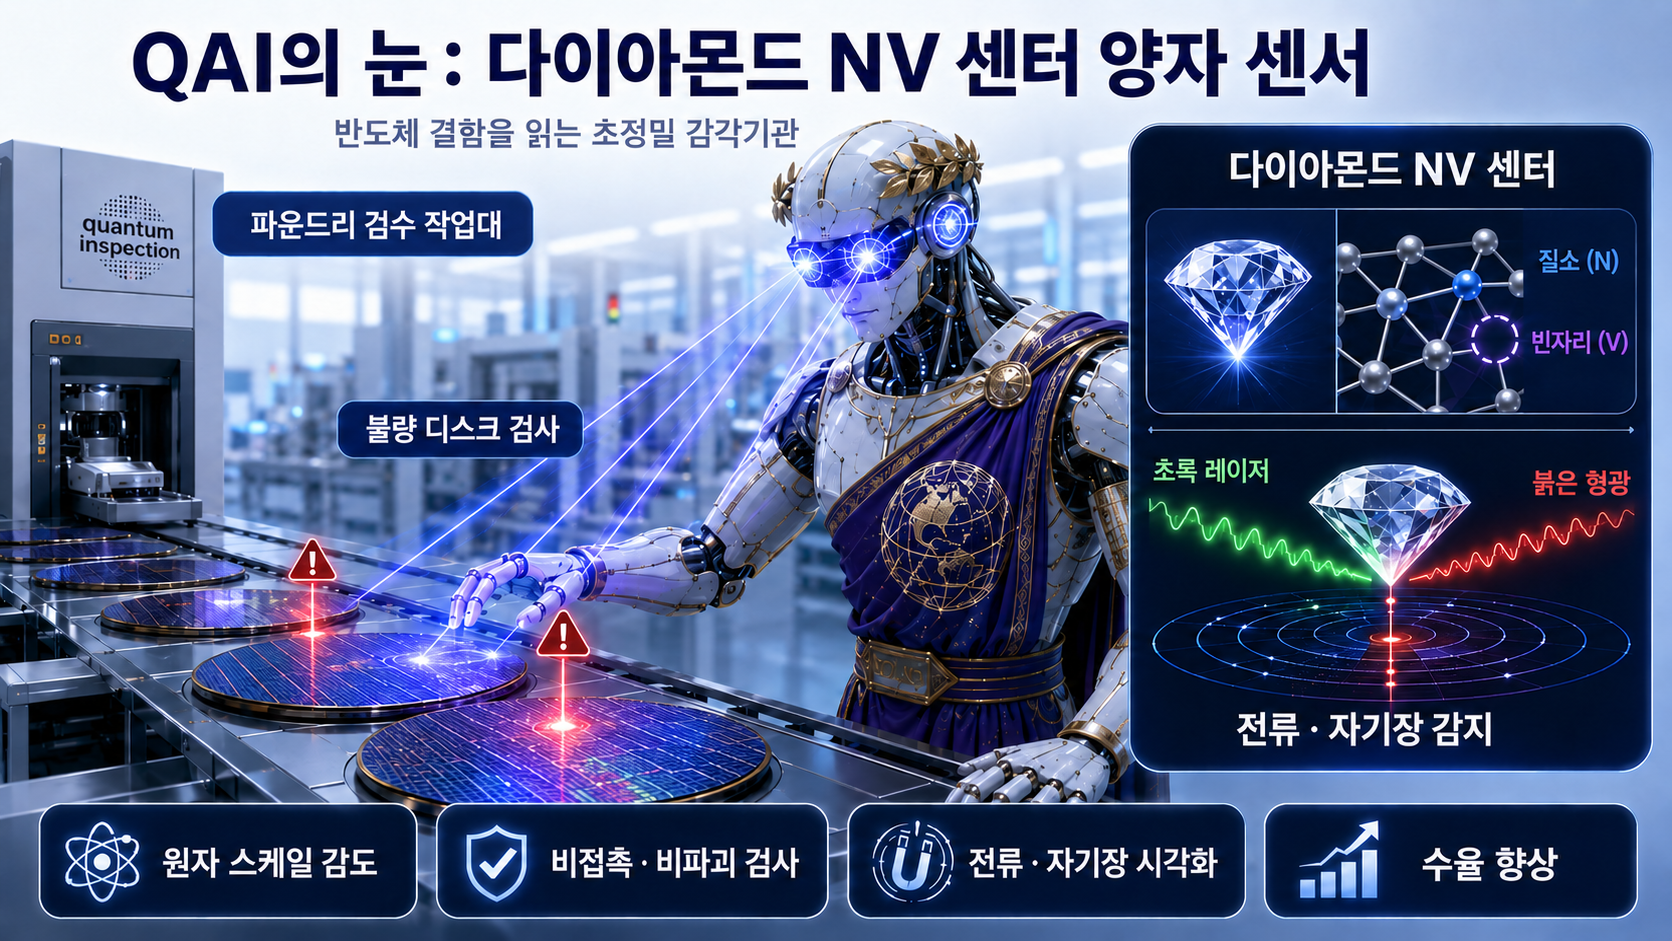
> > 다이아몬드 NV 센터 양자 센서를 ‘눈’처럼 장착한 AI 로봇이 반도체 파운드리 제조 공정에 투입되어, 웨이퍼의 결함과 이상을 초정밀 검사하는 장면을 상상한 가상도. >
8.9 고전 AI와 양자 AI의 협력
지하철과 버스는 서로를 없애지 않습니다. 이동 거리와 목적지에 따라 역할을 나누며 하나의 교통망을 이룹니다. 고전 컴퓨터와 양자컴퓨터의 관계도 경쟁만으로 볼 필요는 없습니다. 가까운 미래의 현실적인 모습은 고전 컴퓨터와 AI가 전체 계산을 관리하고, 양자 장치가 특정한 하위 계산을 맡는 혼합형 구조에 가깝습니다.
새로운 기술이 등장하면 이전 기술을 완전히 대체할 것이라는 전망이 자주 나옵니다. 그러나 실제 기술은 대부분 역할 분담 속에서 발전합니다. 비행기가 등장한 뒤에도 선박과 철도는 사라지지 않았습니다. 각각 적합한 거리와 화물을 맡았습니다. 양자컴퓨터도 고전 컴퓨터를 없애기보다, 일부 문제에서 특수한 계산 도구로 쓰일 가능성이 큽니다. 혼합형 계산에서는 고전 컴퓨터가 데이터를 준비하고, 양자 회로의 조건을 정합니다. 양자 장치는 그 조건에 따라 상태를 만들고 측정값을 내놓습니다. 그러면 고전 컴퓨터나 AI가 결과를 분석해 다음 회로의 매개변수를 조정합니다. 두 장치가 번갈아 계산하며 목표에 가까워지는 방식입니다.
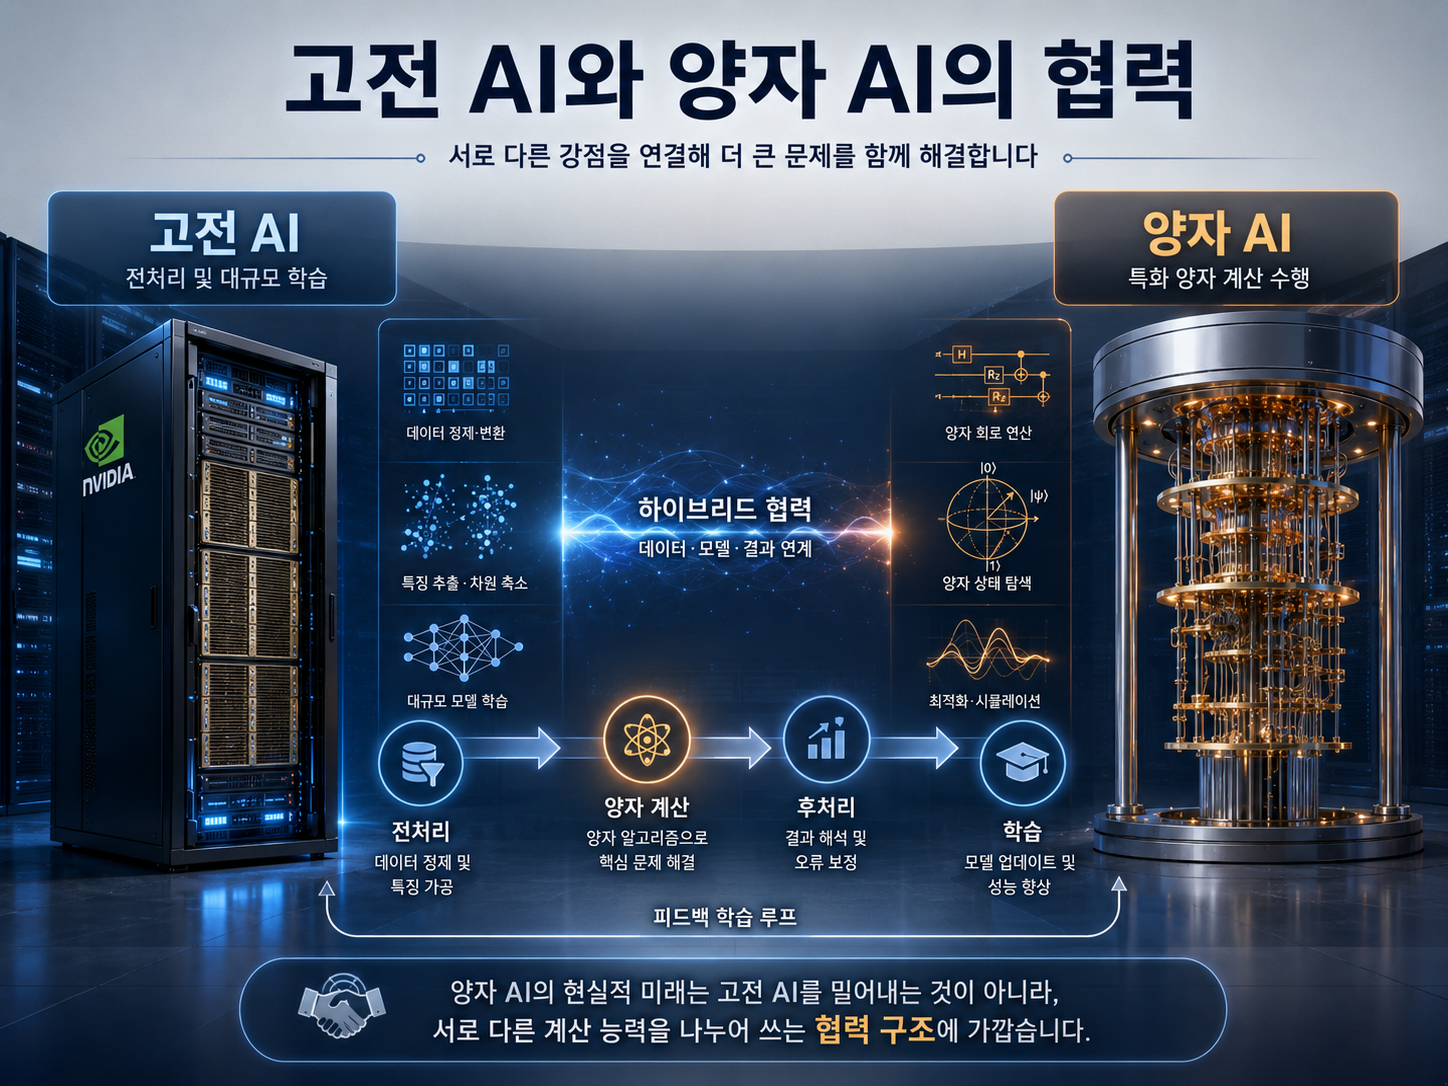
가까운 미래의 QAI는 양자가 모든 계산을 대체하는 모습보다, 고전 AI와 양자 장치가 역할을 나누는 협력 구조에 가까울 가능성이 큽니다.
분자나 물질의 안정한 상태를 찾는 문제를 생각해 봅시다. 산속에서 가장 낮은 골짜기를 찾듯이, 가능한 여러 양자 상태 가운데 에너지가 가장 낮은 상태를 찾아야 합니다. 양자 장치가 후보 상태를 만들고 에너지를 측정하면, 고전 컴퓨터가 그 결과를 보고 다음 후보를 조정합니다. 이런 방식으로 분자나 물질의 에너지를 추정하는 방법을 변분 양자 고유값 해법(variational quantum eigensolver, VQE)이라고 합니다.
또 다른 예는 여러 선택지 가운데 가장 좋은 조합을 찾는 문제입니다. 배송 경로, 작업 배치, 네트워크 연결처럼 가능한 조합이 매우 많을 때, 양자 회로로 후보 조합의 상태를 만들고 고전 컴퓨터가 회로의 매개변수를 조정할 수 있습니다. 이런 접근을 양자 근사 최적화 알고리즘(quantum approximate optimization algorithm, QAOA)이라고 합니다. 다만 VQE와 QAOA가 모든 문제에서 고전 알고리즘보다 뛰어나다는 뜻은 아닙니다. 실제 성능은 장치의 잡음, 반복 측정 비용, 문제 구조에 따라 달라집니다.
고전 AI는 양자 장치를 더 잘 운영하는 데에도 활용될 수 있습니다. 큐비트를 제어하는 신호를 조정하고, 회로를 장치의 연결 구조에 맞게 바꾸며, 잡음이 적은 연산 순서를 찾는 데 기계학습이 쓰일 수 있습니다. 실험 중 이상 신호를 감지하거나, 측정 결과에서 잡음의 영향을 줄이는 데에도 AI가 도움을 줄 수 있습니다. 양자 장치가 AI를 돕는 것만큼, AI가 양자 장치를 안정적으로 다루는 일도 중요합니다. 반대로 양자 장치가 발전하면 고전 AI에 새로운 학습 자료를 제공할 수 있습니다. 분자와 재료의 양자 시뮬레이션에서 얻은 에너지, 전자 분포, 반응 가능성은 신약 AI와 재료 AI의 중요한 입력이 될 수 있습니다. 고전 AI가 수많은 후보를 먼저 고르고, 양자 장치가 그중 일부를 더 정밀하게 계산하며, 실험이 실제 성질을 확인하는 순환도 가능해집니다.
이 협력에서 중요한 질문은 “양자가 모든 것을 대신할 것인가”가 아닙니다. 전체 작업 가운데 어느 부분을 양자 장치에 맡겨야 실제 이점이 생기는가입니다. 데이터 입력 비용, 회로 실행 시간, 반복 측정 횟수, 고전적 후처리 비용까지 포함해 전체 흐름을 따져야 합니다. 특정 계산 단계가 빨라도 전체 작업이 더 효율적이지 않다면 실용적인 장점이라고 보기 어렵습니다. 또한 고전 기술도 멈춰 있지 않습니다. 양자 하드웨어와 알고리즘이 발전하는 동안 고전 반도체, 슈퍼컴퓨터, 근사 알고리즘, AI 모델도 계속 좋아집니다. 따라서 QAI의 성능은 오래된 고전 방법이 아니라 같은 시점의 가장 강력한 고전적 기준과 비교해야 합니다.
결국 가까운 미래의 QAI는 ‘양자 대 고전’의 대결보다 ‘양자와 고전의 협력’으로 전개될 가능성이 큽니다. 고전 AI는 데이터를 정리하고, 후보를 고르며, 양자 장치를 제어하고 결과를 해석합니다. 양자 장치는 그중 양자적 표현이 실제 도움이 되는 특정 계산을 맡습니다. 덜 극적인 그림이지만, 실제 기술은 대개 이런 역할 분담 속에서 성장합니다.
8.10 인문학적 해석: 가능성을 정직하게 말하는 법
『역경』은 세계를 고정된 사물의 집합이라기보다 끊임없이 변화하는 관계와 가능성으로 읽으려 했습니다. 키르케고르는 가능성이 인간에게 자유를 열어 주는 동시에 불안을 낳는다고 보았습니다. 이러한 통찰은 QAI를 바라보는 데에도 도움이 됩니다. 가능성은 새로운 연구를 시작하게 하지만, 조건이 생략된 가능성은 쉽게 과장으로 바뀝니다.
가능성을 정직하게 말한다는 것은 무엇을 보였고 무엇을 아직 보이지 않았는지를 함께 밝히는 태도입니다.
양자인공지능은 중첩과 얽힘, 양자 우위와 새로운 표현 공간, 양자 시뮬레이션이라는 말로 미래의 여러 길을 엽니다. 그러나 이러한 개념은 각각 구체적인 조건을 필요로 합니다. 어떤 양자 효과를 사용하는지, 어느 문제의 구조와 맞는지, 현재 장치에서 실행할 수 있는지, 고전적 방법보다 어떤 이점을 주는지를 물어야 합니다. 가능성을 정직하게 말한다는 것은 가능성을 작게 말하는 것이 아닙니다. 입증된 사실과 기대되는 전망을 구분하는 것입니다. 제한된 장치에서 작동한 실험은 그대로 중요한 성과이지만, 곧바로 대규모 산업 문제의 해결을 뜻하지는 않습니다. 이론적으로 가능한 속도 향상도 필요한 오류 보정 장치가 아직 없다면 미래의 조건으로 밝혀야 합니다.
QAI에 관한 설명에는 적어도 세 가지 시간이 함께 존재합니다. 이미 실험으로 확인된 현재, 하드웨어와 알고리즘이 발전하면 가능할 것으로 예상되는 가까운 미래, 그리고 오류가 보정된 대규모 양자컴퓨터를 전제로 하는 장기적 전망입니다. 이 시간들을 한 문장에 뒤섞으면 가능성이 현재의 사실처럼 보일 수 있습니다. ‘할 수 있다’는 말에도 단계가 있습니다. 물리 법칙상 금지되지 않는다는 뜻일 수 있고, 수학적으로 알고리즘이 제안되었다는 뜻일 수도 있습니다. 작은 실험에서 실행되었다거나, 실제 산업 문제에서 경제적 가치가 입증되었다는 뜻일 수도 있습니다. 좋은 설명은 이 서로 다른 가능성을 같은 단어로 뭉뚱그리지 않습니다.
양자역학의 낯섦도 과장의 재료로 사용해서는 안 됩니다. 중첩은 모든 답을 한 번에 읽는 능력이 아니고, 얽힘은 초광속 통신이나 인간 정신의 신비를 자동으로 설명하지 않습니다. 양자 현상이 일상적 직관과 다르다는 사실은 무엇이든 주장해도 된다는 허가가 아니라, 더 정확한 수학과 실험을 요구하는 이유입니다. QAI를 평가할 때 필요한 질문은 어렵지 않습니다. 어떤 문제를 풀었는가, 어떤 양자 장치를 사용했는가, 오류와 측정 비용을 포함했는가, 가장 좋은 고전적 방법과 공정하게 비교했는가, 다른 연구자가 결과를 재현할 수 있는가를 물으면 됩니다. 질문이 구체적일수록 신비의 언어는 줄고 과학의 내용은 선명해집니다.
불확실성을 밝히는 태도도 중요합니다. 연구자가 “아직 모른다”고 말하는 것은 실패가 아닙니다. 어느 조건에서 효과가 나타났고 어디에서 사라졌는지, 모델과 장치의 한계가 무엇인지 기록하는 일은 다음 연구의 출발점이 됩니다. 과학의 신뢰는 틀리지 않는 데서만 생기지 않고, 틀릴 가능성을 공개하고 수정하는 데서도 생깁니다. 가능성과 과장 사이에는 미묘한 차이가 있습니다. 가능성은 필요한 조건과 장애물을 함께 말하지만, 과장은 조건을 지우고 결과만 앞당겨 말합니다. 가능성은 비교와 검증을 요청하지만, 과장은 낯선 용어와 먼 미래의 약속으로 질문을 막습니다. 가능성은 실패에서도 배우지만, 과장은 실패를 숨기거나 다음 약속으로 덮으려 합니다.
인문학은 기술의 성능을 대신 계산하지 않습니다. 대신 우리가 그 기술을 어떤 언어로 말하고, 어떤 기대를 만들며, 그 과정에서 누가 이익과 위험을 부담하는지 묻습니다. QAI가 실제로 가치 있는 도구가 되더라도 그 접근권과 비용, 보안과 산업 집중의 문제는 별도로 논의해야 합니다. 양자컴퓨터가 암호와 과학 연구, 산업 구조에 영향을 준다면 그 혜택과 위험은 고르게 나뉘지 않을 수 있습니다. 일부 국가와 기업만 장치와 데이터를 통제할 가능성도 있습니다. 그러므로 QAI의 미래는 계산 성능뿐 아니라 공공 연구와 교육, 보안 전환과 기술 접근성의 문제까지 함께 살펴야 합니다.
『역경』의 "변화는 무엇이든 가능하다"는 말은 무질서를 뜻하지 않습니다. 변화에도 조건과 때, 관계와 방향이 있습니다. 키르케고르가 말한 '가능성의 불안' 역시 가능성을 포기하라는 뜻이 아니라 선택에 따르는 책임을 직시하라는 요청에 가깝습니다. QAI의 가능성도 물리적 조건과 사회적 선택 속에서 구체화되어야 합니다. 제8강에서 우리가 배운 것은 양자컴퓨터가 신비한 만능 기계가 아니라는 사실입니다. 큐비트의 중첩과 간섭, 얽힘은 실제로 검증된 물리적 자원이지만, 이를 유용한 계산으로 바꾸려면 정밀한 장치와 알고리즘, 오류 보정과 공정한 비교가 필요합니다. 양자인공지능을 바라보는 가장 좋은 태도는 가능성을 진지하게 탐구하되, 무엇이 입증되었고 무엇이 가설인지 분명히 하는 것입니다. 가능성을 사랑하면서도 조건을 생략하지 않는 것, 기대를 품으면서도 검증을 요구하는 것. 그것이 QAI를 과장이 아니라 과학의 언어로 말하는 방법입니다.
제9강. 인공지능의 열역학
겨울 아침 전기장판을 켜면, 보이지 않는 전자의 움직임이 곧 따뜻함으로 바뀝니다. AI도 마찬가지입니다. 화면에 나타나는 문장과 이미지는 가벼워 보이지만, 그 뒤에서는 반도체 칩이 전력을 쓰고, 메모리가 데이터를 옮기며, 서버의 열을 식히는 냉각 장치가 작동합니다. AI는 ‘클라우드 속 지능’처럼 보이지만, 실제로는 반도체와 메모리, 전력망과 냉각 설비 위에서 움직이는 물리적 기술입니다. 이번 강의에서는 AI의 예측 능력 자체보다, 그 능력을 가능하게 하는 물질과 에너지의 흐름을 살펴봅니다. 그 핵심 주제는 지능의 물리적 비용입니다. 앞선 강의에서 AI의 예측 능력과 가능성을 살펴보았다면, 이번 강의에서는 그 능력이 어떤 물질과 에너지의 흐름 위에서 구현되는지 살피려 헙니다.
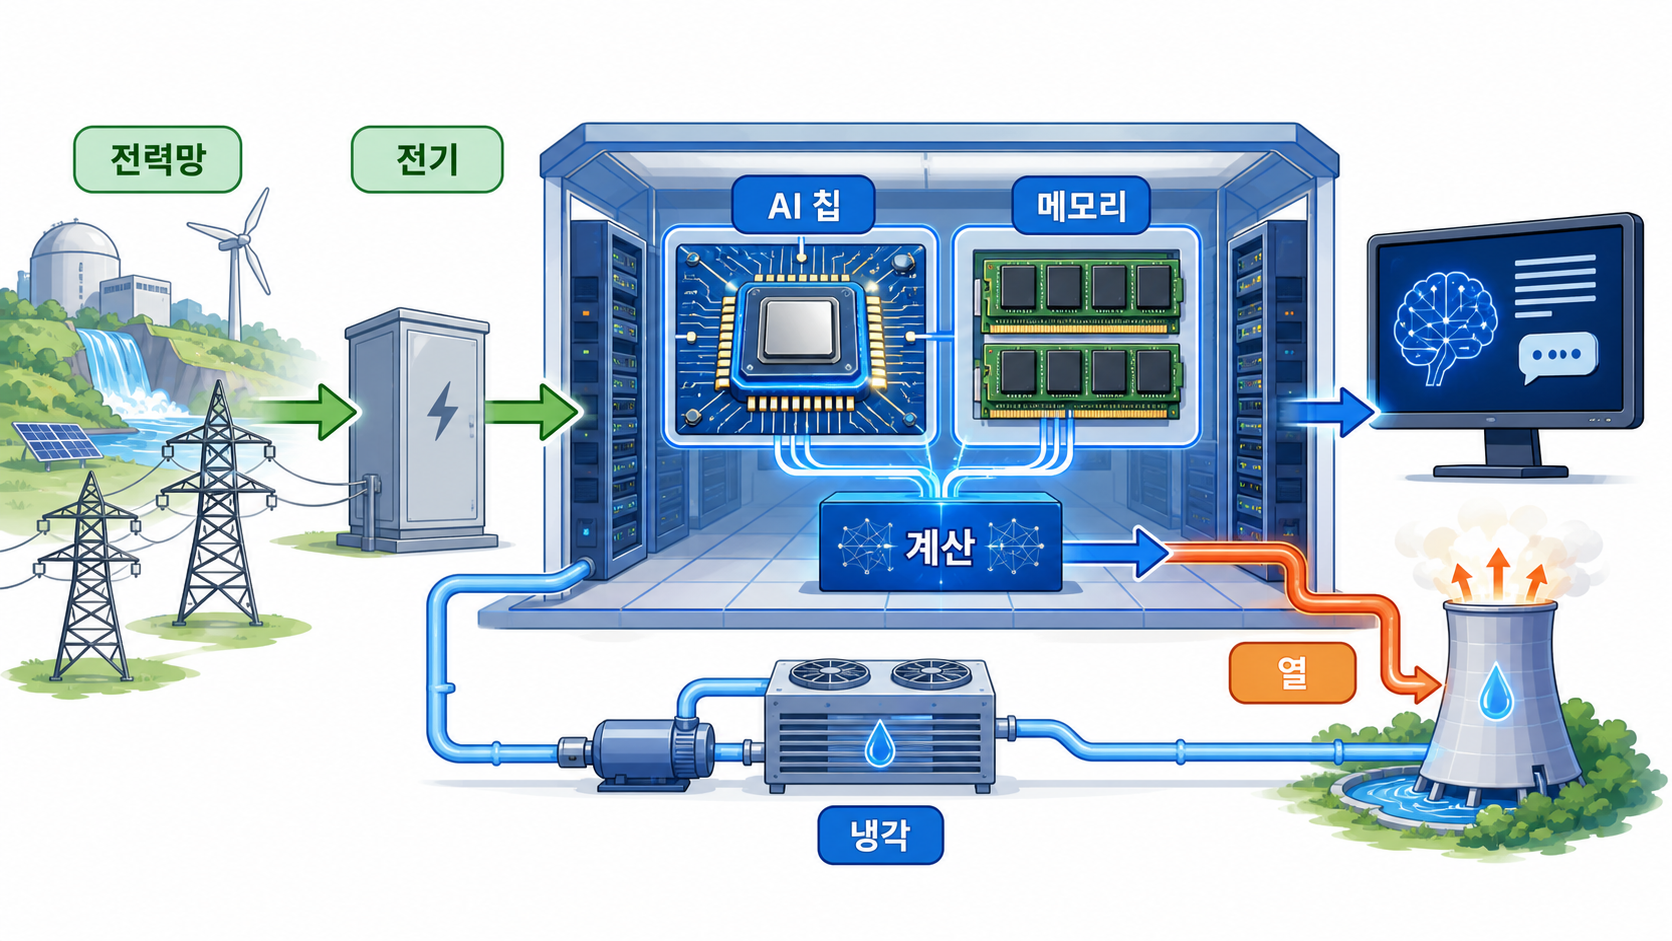
AI는 구름 위의 추상이 아니라, 전기를 사용하고 데이터를 옮기며 열을 내는 물리적 시스템 위에서 작동합니다.
9.1 계산은 물리적 과정이다
엘리베이터에서 버튼을 누르면 표시창의 숫자만 바뀌는 것처럼 보입니다. 그러나 실제로는 버튼의 신호가 제어 장치로 전달되고, 모터와 제동 장치가 작동하며, 엘리베이터의 위치가 달라집니다. ‘3층으로 이동한다’는 정보가 기계의 물리적 움직임으로 바뀌는 것입니다. 컴퓨터의 계산도 마찬가지입니다.
우리는 0과 1을 추상적인 기호로 배우지만, 실제 칩 안의 0과 1은 종이에 적힌 숫자가 아닙니다. 전압의 높고 낮음, 전하의 저장 여부, 트랜지스터의 켜짐과 꺼짐처럼 구분 가능한 물리적 상태로 표현됩니다. 정보를 처리한다는 것은 결국 장치의 상태를 바꾸는 일입니다. 이 상태 변화에는 에너지가 필요합니다. 반도체 안에서는 트랜지스터와 배선이 전하를 충전하고 방전하며, 전류가 회로를 흐르는 동안 일부 에너지가 열로 바뀝니다. 계산이 많아지고 회로가 빠르게 작동할수록 전력 소비와 발열도 커집니다. 계산은 머릿속에서만 일어나는 추상이 아니라, 전기와 열을 동반하는 물리적 과정입니다.
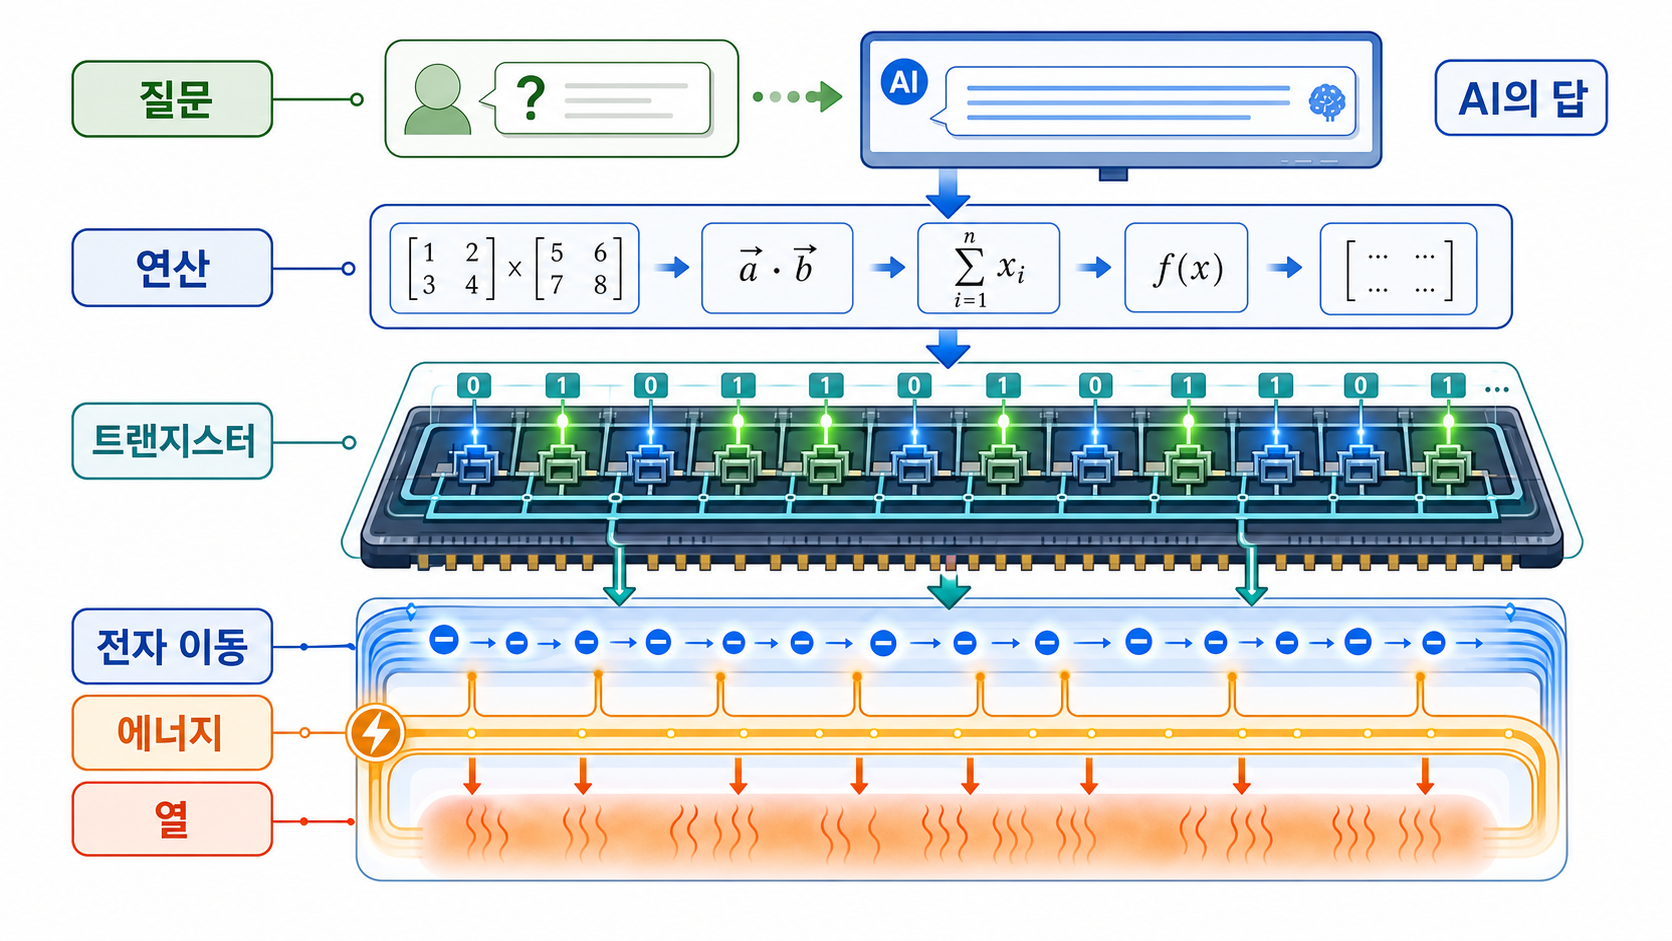
AI의 대답은 화면 위의 문장이지만, 그 아래에서는 전하의 상태가 바뀌고 데이터가 이동하며 에너지가 사용됩니다.
AI의 추론도 이 원리에서 벗어나지 않습니다. 사용자가 “이 문장을 요약해 줘”라고 입력하면, AI는 문장을 작은 단위로 나누고 숫자로 바꿉니다. 그다음 내부에 저장된 수많은 조정값을 이용해 어떤 단어가 다음에 올 가능성이 큰지 계산합니다. 이렇게 입력을 처리하고 출력을 만들어 내는 전체 계산 구조를 모델(model)이라고 합니다. 모델 안에는 학습을 통해 정해진 수많은 숫자가 들어 있습니다. 이 숫자들은 입력 정보의 중요도와 연결 방식을 조절하는 역할을 합니다. 이를 가중치(weights)라고 합니다. AI가 답을 만든다는 것은, 이 가중치와 입력값을 대규모로 곱하고 더하면서 다음 결과의 가능성을 계산하는 일입니다.
수학적으로 보면 이것은 거대한 행렬 연산입니다. 그러나 실제 하드웨어 안에서는 전하의 이동, 트랜지스터의 상태 전환, 메모리 읽기와 쓰기, 칩 사이의 통신으로 이루어집니다. AI의 문장은 화면에 가볍게 나타나지만, 그 문장을 만들기 위해서는 반도체와 메모리, 전력과 통신망이 함께 움직입니다. 에너지는 계산 자체에만 쓰이지 않습니다. 모델의 가중치를 메모리에서 불러오고, 중간 계산 결과를 저장하며, 여러 칩 사이로 데이터를 주고받는 데에도 전력이 필요합니다. 데이터가 많이 움직일수록 에너지 비용도 커집니다. AI 계산에서 중요한 병목은 연산 속도만이 아니라, 데이터를 얼마나 빠르고 효율적으로 옮기느냐에도 있습니다.
계산에 쓰인 전력의 상당 부분은 결국 열로 바뀝니다. 데이터센터의 서버가 안정적으로 작동하려면 이 열을 계속 밖으로 내보내야 합니다. 그래서 AI 인프라에는 반도체 칩뿐 아니라 냉각 장치, 전력 설비, 건물 구조, 네트워크가 함께 필요합니다. AI는 소프트웨어처럼 보이지만, 실제로는 거대한 물리적 기반 위에서 작동합니다. 우리는 편의상 “AI가 생각한다”고 말합니다. 그러나 물리학의 관점에서는 “반도체와 메모리로 이루어진 장치가 상태를 바꾸며 계산한다”고 말할 수 있습니다. 이 표현은 AI의 능력을 낮추는 말이 아닙니다. 오히려 그 능력이 어디에서, 어떤 조건 위에서 구현되는지 더 정확하게 보여 줍니다.
따라서 AI를 이해할 때는 화면에 나타난 결과만 보아서는 부족합니다. 그 뒤에는 칩과 메모리, 전력망과 냉각 설비, 데이터센터와 통신망이 있습니다. 가상 공간은 물리 공간을 없애는 것이 아니라, 사용자에게 보이지 않는 다른 장소로 옮깁니다. 이번 강의의 출발점은 단순합니다. 계산은 언제나 물리적 장치에서 일어납니다. AI의 편리함을 제대로 이해하려면, 그 편리함을 가능하게 하는 물질과 에너지의 흐름도 함께 보아야 합니다.
9.2 반도체 스위치와 병렬 계산
한 사람이 피아노의 모든 음을 차례로 연주하는 경우와 여러 연주자가 동시에 합주하는 경우를 비교해 봅시다. 단순한 멜로디라면 혼자서도 충분하지만, 많은 음을 한꺼번에 처리해야 하는 곡이라면 여러 연주자가 나누어 연주하는 편이 훨씬 효율적입니다. AI 계산도 이와 비슷합니다. 하나의 계산을 빠르게 하는 능력만큼, 수많은 계산을 동시에 처리하는 능력이 중요합니다. 반도체 칩의 가장 작은 일꾼은 전류의 흐름을 켜고 끄는 미세한 스위치입니다. 이 스위치를 트랜지스터(transistor)라고 합니다. 여러 트랜지스터를 연결하면 0과 1을 처리하는 논리 회로가 만들어지고, 이 회로들이 대규모로 모이면 덧셈, 곱셈, 비교, 저장 같은 계산을 수행할 수 있습니다. 현대 반도체 칩에는 이런 트랜지스터가 수십억 개 이상 들어갑니다.
컴퓨터의 중심에는 여러 종류의 계산 장치가 있습니다. 먼저 중앙처리장치(CPU, Central Processing Unit)는 컴퓨터의 지휘자에 가깝습니다. 운영체제를 관리하고, 프로그램의 명령을 해석하며, 조건에 따라 달라지는 복잡한 작업을 유연하게 처리합니다. CPU는 다양한 일을 잘하는 범용 장치입니다. 반면 그래픽처리장치(GPU, Graphics Processing Unit)는 많은 연주자가 같은 박자에 맞춰 동시에 연주하는 합주단에 가깝습니다. 원래는 화면의 수많은 픽셀과 도형을 빠르게 계산하기 위해 발전했지만, 같은 종류의 곱셈과 덧셈을 대량으로 반복하는 데 강합니다. 딥러닝의 핵심 계산인 행렬 연산이 바로 이런 구조와 잘 맞습니다. 신경망처리장치(NPU, Neural Processing Unit)는 AI 계산에 더 직접적으로 맞춘 전용 장치입니다. 스마트폰, 자동차, 카메라, 엣지 기기처럼 전력과 공간이 제한된 환경에서 신경망 연산을 효율적으로 수행하도록 설계됩니다. 간단히 말하면 CPU는 다양한 작업을 지휘하는 장치, GPU는 많은 계산을 병렬로 밀어붙이는 장치, NPU는 AI 신경망 계산에 맞춰 효율을 높인 장치입니다.
GPU는 수많은 연산을 병렬로 처리한다
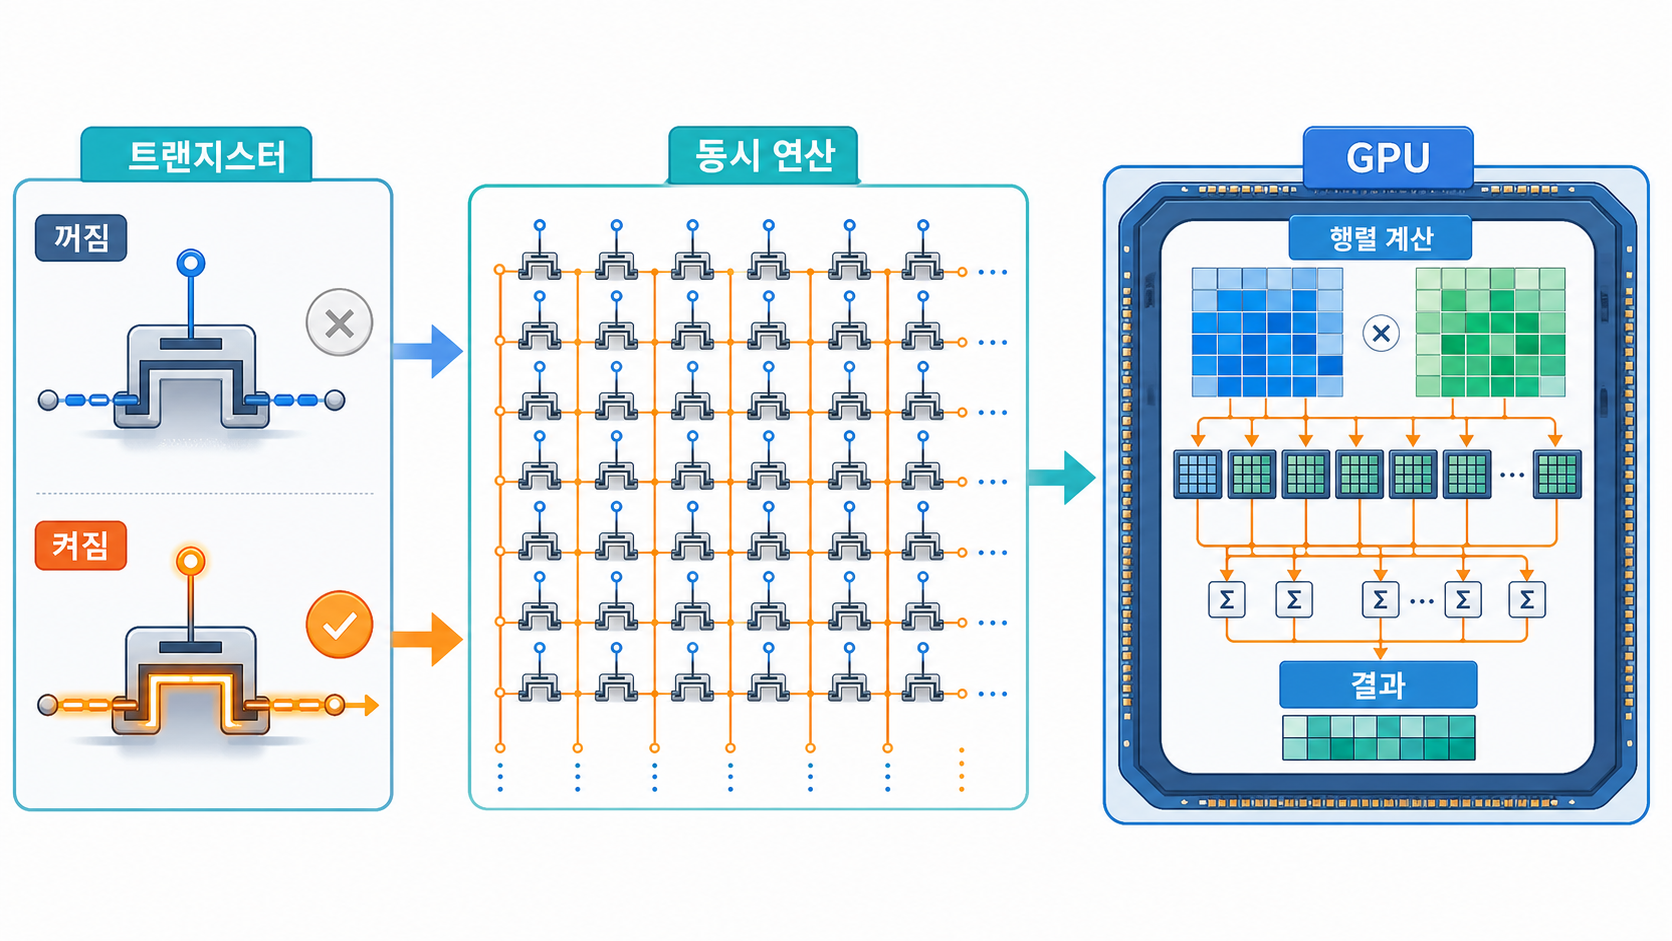
AI의 속도는 하나의 거대한 연산보다, 수많은 작은 연산을 동시에 수행하는 병렬성에서 나옵니다.
AI 모델은 문장, 이미지, 음성 데이터를 숫자로 바꾼 뒤 엄청난 양의 곱셈과 덧셈을 반복합니다. 문장의 토큰, 이미지의 픽셀, 신경망의 가중치와 중간 계산값은 대규모 행렬 형태로 처리됩니다. 그래서 AI의 속도는 하나의 “빠른 생각”에서만 나오지 않습니다. 수많은 작은 계산을 동시에 진행하는 병렬 계산에서 나옵니다. AI 계산이 커지면서 더 특화된 반도체도 등장했습니다. 특정 작업에 맞춰 회로를 설계한 전용 반도체를 ASIC(Application-Specific Integrated Circuit)이라고 합니다. AI용 ASIC은 행렬 곱셈, 텐서 계산, 낮은 정밀도의 수치 연산처럼 AI가 자주 사용하는 작업을 더 빠르고 적은 에너지로 처리하도록 설계됩니다. 범용성을 일부 줄이는 대신 효율을 높이는 방식입니다.
이 차이는 도구의 차이와 비슷합니다. 만능 칼은 여러 일을 할 수 있지만, 빵을 많이 자를 때는 제빵용 칼이 더 효율적입니다. CPU는 범용성이 강하고, GPU는 대규모 병렬 계산에 강하며, NPU와 AI ASIC은 신경망 계산의 효율을 높이는 데 초점을 둡니다. 어떤 장치가 더 좋은지는 절대적으로 정해지지 않습니다. 어떤 AI 모델을 어디에서, 얼마나 빠르고 적은 전력으로 실행해야 하는지에 따라 달라집니다. AI 성능은 트랜지스터 수나 칩의 속도만으로 결정되지 않습니다. 데이터를 메모리에서 얼마나 빨리 가져오는지, 여러 연산 장치가 일을 얼마나 잘 나누는지, 여러 칩이 어떻게 연결되는지, 소프트웨어가 계산을 하드웨어에 어떻게 배치하는지가 모두 중요합니다. AI 계산에서는 연산 자체만큼 데이터 이동도 큰 비용을 차지합니다.
트랜지스터가 상태를 바꿀 때는 에너지가 필요하고, 그 에너지의 일부는 열로 바뀝니다. 더 많은 회로를 더 빠르게 작동시키면 계산량은 늘어나지만 전력 소비와 발열도 커집니다. 그래서 AI 하드웨어의 발전은 단순한 속도 경쟁이 아닙니다. 제한된 전력과 온도 안에서 얼마나 많은 유용한 계산을 할 수 있는지가 핵심입니다. 반도체는 AI의 배경 부품이 아닙니다. AI가 어느 크기의 모델을 얼마나 빠르고 경제적으로 실행할 수 있는지를 결정하는 물리적 기반입니다. AI는 알고리즘의 사건인 동시에, 트랜지스터와 병렬 계산, 전력과 열 관리의 사건입니다.
반도체 스위치의 흐름
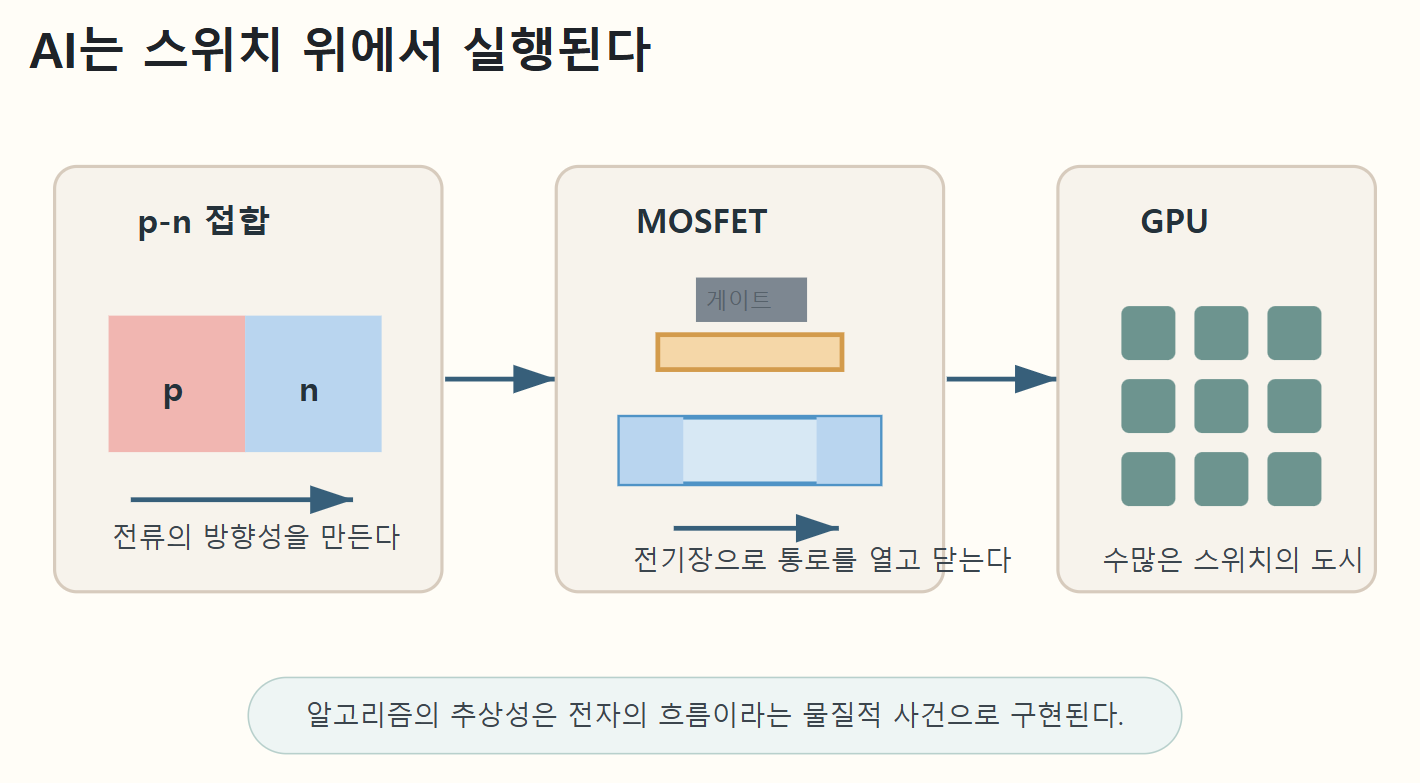
반도체 스위치는 전하와 전압의 상태를 조절하는 물리 장치이며, 그 조합이 논리 연산과 병렬 계산의 기반이 됩니다.
9.3 메모리 병목과 데이터 이동
요리 대회에 뛰어난 요리사가 나왔다고 생각해 봅시다. 칼질과 불 조절이 아무리 빨라도 재료가 냉장고에서 늦게 오면 요리는 멈춥니다. 전체 속도는 요리사의 손놀림이 아니라 재료가 조리대에 도착하는 속도에 의해 결정됩니다. AI 하드웨어에서도 같은 일이 일어납니다. 연산 장치가 아무리 빨라도 계산에 필요한 숫자가 제때 도착하지 않으면 장치는 데이터를 기다리며 멈춰 있어야 합니다. 계산 능력에 비해 메모리에서 데이터를 공급하는 속도가 부족해 전체 성능이 제한되는 현상을 메모리 병목(memory bottleneck)이라고 합니다.
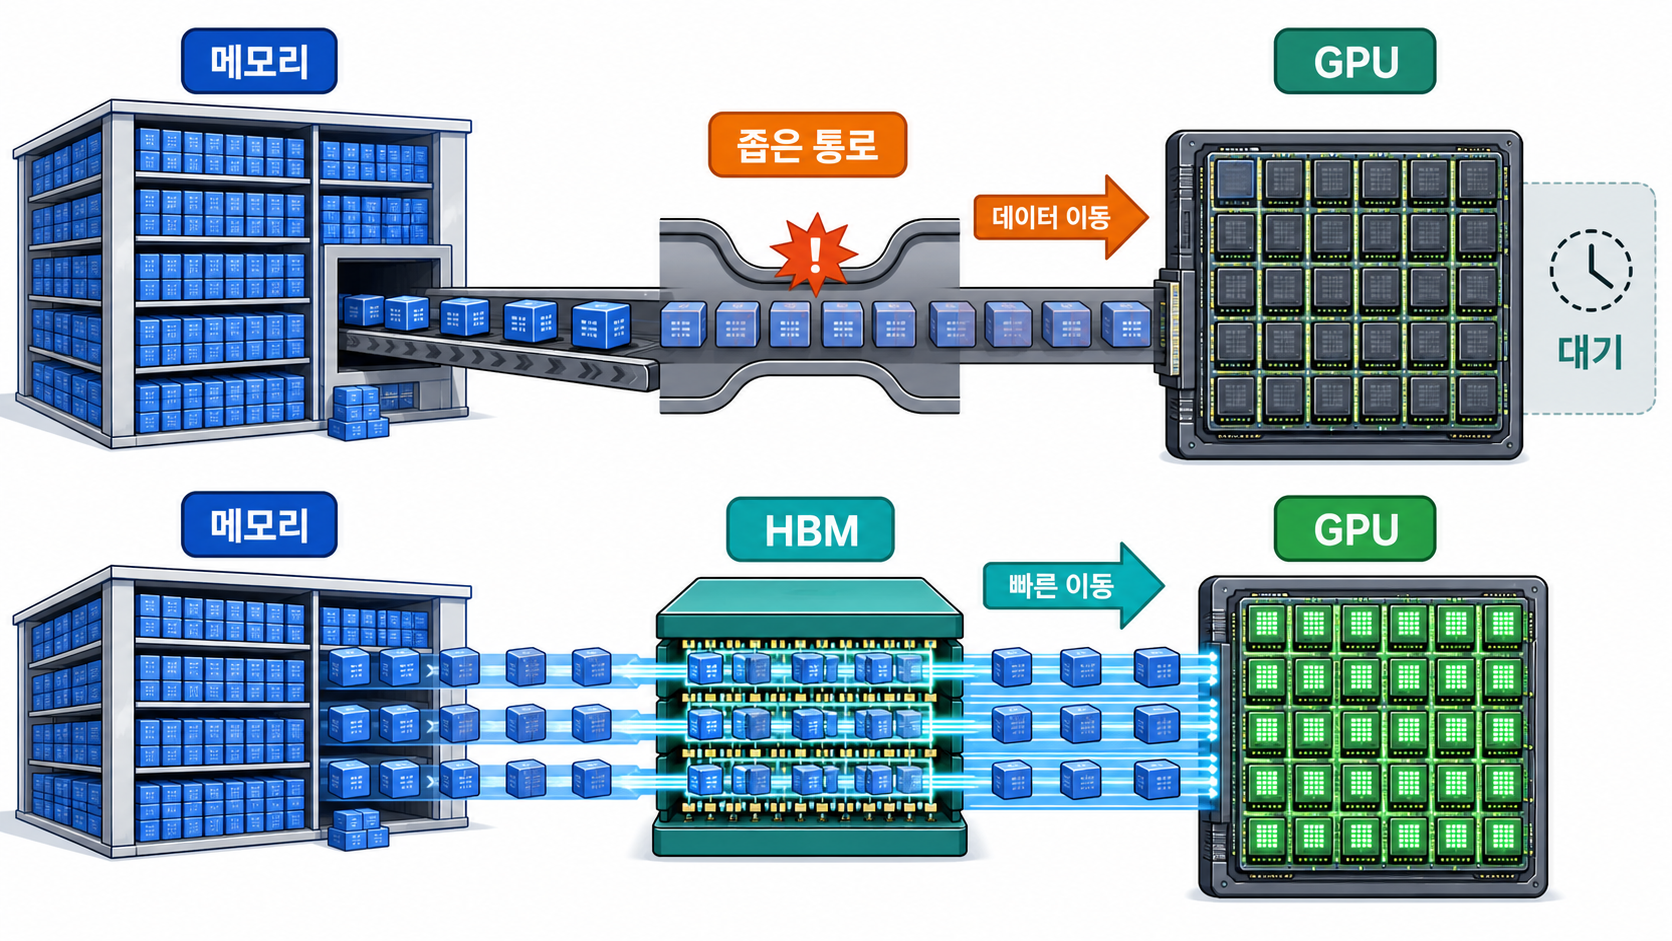
AI 하드웨어의 병목은 계산 장치가 느려서가 아니라, 데이터가 계산 장소까지 도착하는 길이 좁아서 생기기도 합니다.
AI는 숫자를 끊임없이 읽고 씁니다. 문장과 이미지는 모델 안에서 숫자로 바뀌고, 이 숫자들은 여러 층을 지나며 곱해지고 더해집니다. 이렇게 많은 숫자의 연결 관계를 학습해 예측을 수행하는 구조를 딥러닝 모델(deep learning model)이라고 합니다. 모델이 커질수록 읽어야 할 숫자도 많아지고, 메모리와 연산 장치 사이를 오가는 데이터도 늘어납니다. 특히 대규모 언어 모델은 다음 단어를 만들 때마다 내부의 많은 가중치와 중간 계산값을 다시 사용합니다. 긴 대화를 처리할 때는 앞에서 계산한 정보를 버리지 않고 저장해 두었다가 다음 계산에 활용합니다. 이처럼 이전 토큰들의 핵심 정보를 저장해 재사용하는 공간을 KV 캐시(KV cache)라고 합니다. 대화가 길어질수록 이 캐시도 커지고, 메모리 사용량과 데이터 이동량이 함께 늘어납니다.
AI 계산의 부담은 단계마다 다릅니다. 입력 문장을 한꺼번에 처리할 때는 많은 연산을 동시에 수행하므로 연산 장치의 힘이 중요합니다. 반면 답변을 한 토큰씩 생성할 때는 가중치와 캐시를 반복해서 불러와야 하므로 메모리 대역폭이 속도를 좌우하는 경우가 많습니다. AI가 느려지는 이유가 항상 “계산을 못해서”만은 아닙니다. 때로는 필요한 데이터를 제때 가져오지 못해서입니다. 여기서 중요한 물리적 사실이 있습니다. 데이터를 옮기는 데에도 에너지가 듭니다. 숫자를 곱하고 더하는 일뿐 아니라, 그 숫자를 메모리에서 읽어 연산 장치로 보내고, 결과를 다시 저장하는 과정에도 전력이 필요합니다. 데이터가 멀리 이동하거나 여러 칩을 거칠수록 시간과 에너지 비용은 커집니다.
그래서 좋은 AI 하드웨어는 단순히 연산기를 많이 넣은 장치가 아닙니다. 자주 쓰는 데이터를 계산 장치 가까이에 두고, 불필요한 이동을 줄이며, 한 번에 더 많은 데이터를 전달할 수 있어야 합니다. 자주 쓰는 재료를 냉장고 깊숙한 곳이 아니라 조리대 가까이에 두는 것과 같습니다. 이렇게 필요한 데이터를 가까운 곳에 두어 이동을 줄이는 성질을 데이터 지역성(data locality)이라고 합니다. 컴퓨터는 이를 위해 여러 단계의 메모리를 사용합니다. 연산 장치 가까이에 있는 작은 저장 공간은 빠르지만 용량이 작고, 멀리 있는 큰 메모리는 많은 데이터를 담을 수 있지만 상대적으로 느립니다. AI 하드웨어의 성능은 이 여러 저장 공간을 얼마나 잘 배치하고 활용하느냐에 크게 달려 있습니다.
고대역폭 메모리(HBM, High Bandwidth Memory)가 AI 가속기에서 중요한 이유도 여기에 있습니다. HBM은 여러 층의 메모리를 수직으로 쌓고 넓은 통로로 가속기와 연결해, 많은 데이터를 한꺼번에 빠르게 전달합니다. GPU가 데이터를 기다리는 시간을 줄여 주기 때문에 대규모 AI 계산에 유리합니다. 다만 HBM도 용량, 비용, 발열, 패키징 난도라는 한계를 갖습니다. 모델이 더 커지면 하나의 가속기와 메모리만으로 부족해집니다. 여러 칩과 메모리 장치를 함께 연결해야 하고, 이때 장치 사이의 데이터 이동이 다시 병목이 될 수 있습니다. 여러 계산 장치와 메모리 자원을 더 유연하게 연결하고 공유하도록 돕는 규격 가운데 하나가 CXL(Compute Express Link)입니다. HBM이 가속기 가까이에서 빠른 데이터 공급을 돕는다면, CXL은 여러 장치와 메모리를 더 넓은 시스템 안에서 연결하는 데 초점을 둡니다.
소프트웨어도 데이터 이동을 줄이는 데 중요한 역할을 합니다. 모델의 숫자 정밀도를 낮추는 양자화, 꼭 필요한 연결만 남기는 가지치기, 여러 연산을 묶어 메모리 접근을 줄이는 방법이 사용됩니다. 좋은 AI 알고리즘은 계산 횟수만 줄이는 것이 아니라, 데이터가 움직이는 거리와 횟수도 줄여야 합니다. 결국 AI의 속도와 에너지 효율은 연산 능력만으로 결정되지 않습니다. 필요한 데이터를 얼마나 가까이 두고, 얼마나 빨리 공급하며, 얼마나 적게 움직이게 하느냐가 중요합니다. 좋은 AI 하드웨어는 많이 계산하는 장치인 동시에, 데이터를 덜 움직이게 하는 장치입니다.
인공지능의 물리적 비용을 이해하려면 “얼마나 많이 계산하는가”만 물어서는 부족합니다. “얼마나 많은 정보를 어디까지 옮기는가”도 함께 보아야 합니다. AI의 지능은 계산에서 나오지만, 그 계산의 속도와 비용은 데이터 이동의 질서에 의해 결정됩니다.
> 생성형 AI는 GPU와 메모리를 어떻게 사용할까 > > 생성형 AI가 문장을 만들 때는 입력된 문맥을 바탕으로 다음 토큰의 확률을 여러 신경망 층에서 계산합니다. GPU와 AI 가속기는 이 과정에 필요한 대규모 행렬 곱셈을 병렬로 수행합니다. > > 그러나 계산 장치만 빨라서는 충분하지 않습니다. 모델의 가중치와 입력 토큰, 중간 결과를 메모리에서 끊임없이 불러와야 하기 때문입니다. 긴 문장을 생성할 때는 이전 토큰에서 계산한 정보를 재사용하기 위한 KV 캐시도 계속 읽고 갱신합니다. > > 입력 문장을 처음 처리할 때는 많은 토큰을 병렬로 계산하므로 연산 능력이 중요합니다. 이후 토큰을 하나씩 생성할 때는 모델의 가중치와 캐시를 반복해서 읽어야 하므로 메모리 대역폭이 속도를 좌우하는 경우가 많습니다. > > HBM은 여러 층의 메모리를 가속기 가까이에 배치하고 넓은 통로로 데이터를 공급해 이러한 병목을 줄입니다. 생성형 AI의 성능은 GPU의 연산 능력뿐 아니라 메모리 용량과 대역폭, 여러 칩을 연결하는 통신 방식에 의해 함께 결정됩니다. >
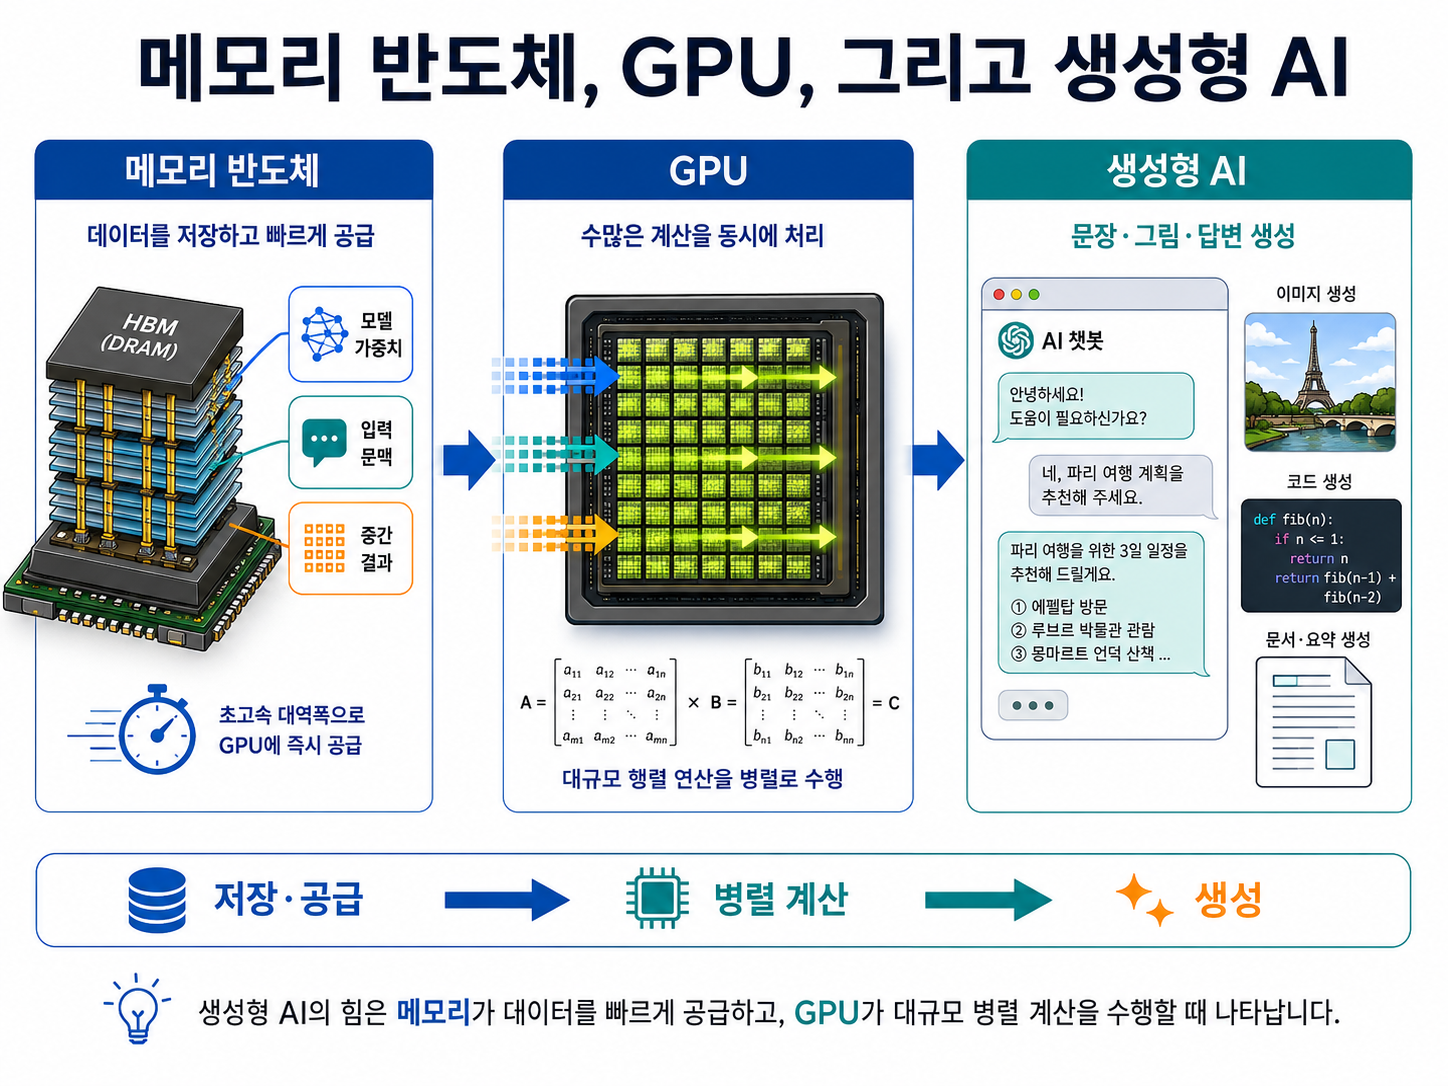
> > GPU가 대규모 병렬 계산을 맡는다면, 고대역폭 메모리는 모델의 가중치와 중간 결과를 가까운 곳에서 빠르게 공급해 계산의 흐름을 유지합니다. > > 화면의 자연스러운 답변 뒤에서는 반도체와 메모리, 전력과 냉각 장치가 함께 작동합니다. 생성형 AI는 순수한 소프트웨어가 아니라 물질과 에너지의 흐름 위에서 구현되는 계산 시스템입니다.
9.4 열은 왜 문제가 되는가
스마트폰으로 오래 영상을 찍거나 무거운 앱을 실행하면 기기가 뜨거워집니다. 온도가 너무 올라가면 화면이 어두워지고, 앱의 속도가 느려지며, 일부 기능이 제한되기도 합니다. 기기가 갑자기 약해진 것이 아닙니다. 부품을 보호하기 위해 스스로 작동 속도와 전력을 낮추는 것입니다. 이런 과정을 열적 조절, 또는 스로틀링(thermal throttling)이라고 합니다.
AI 서버의 반도체 칩에서도 같은 일이 일어납니다. 트랜지스터가 빠르게 켜지고 꺼질 때 전하가 움직이고, 전류가 회로를 흐르는 동안 전기에너지의 일부가 열로 바뀝니다. 더 많은 연산을 더 좁은 공간에서 더 빠르게 수행할수록 열은 더 많이 쌓입니다. AI 계산은 화면에서는 조용히 보이지만, 칩 안에서는 전기와 열의 격렬한 흐름으로 이루어집니다.
칩의 열을 빼내는 데이터센터
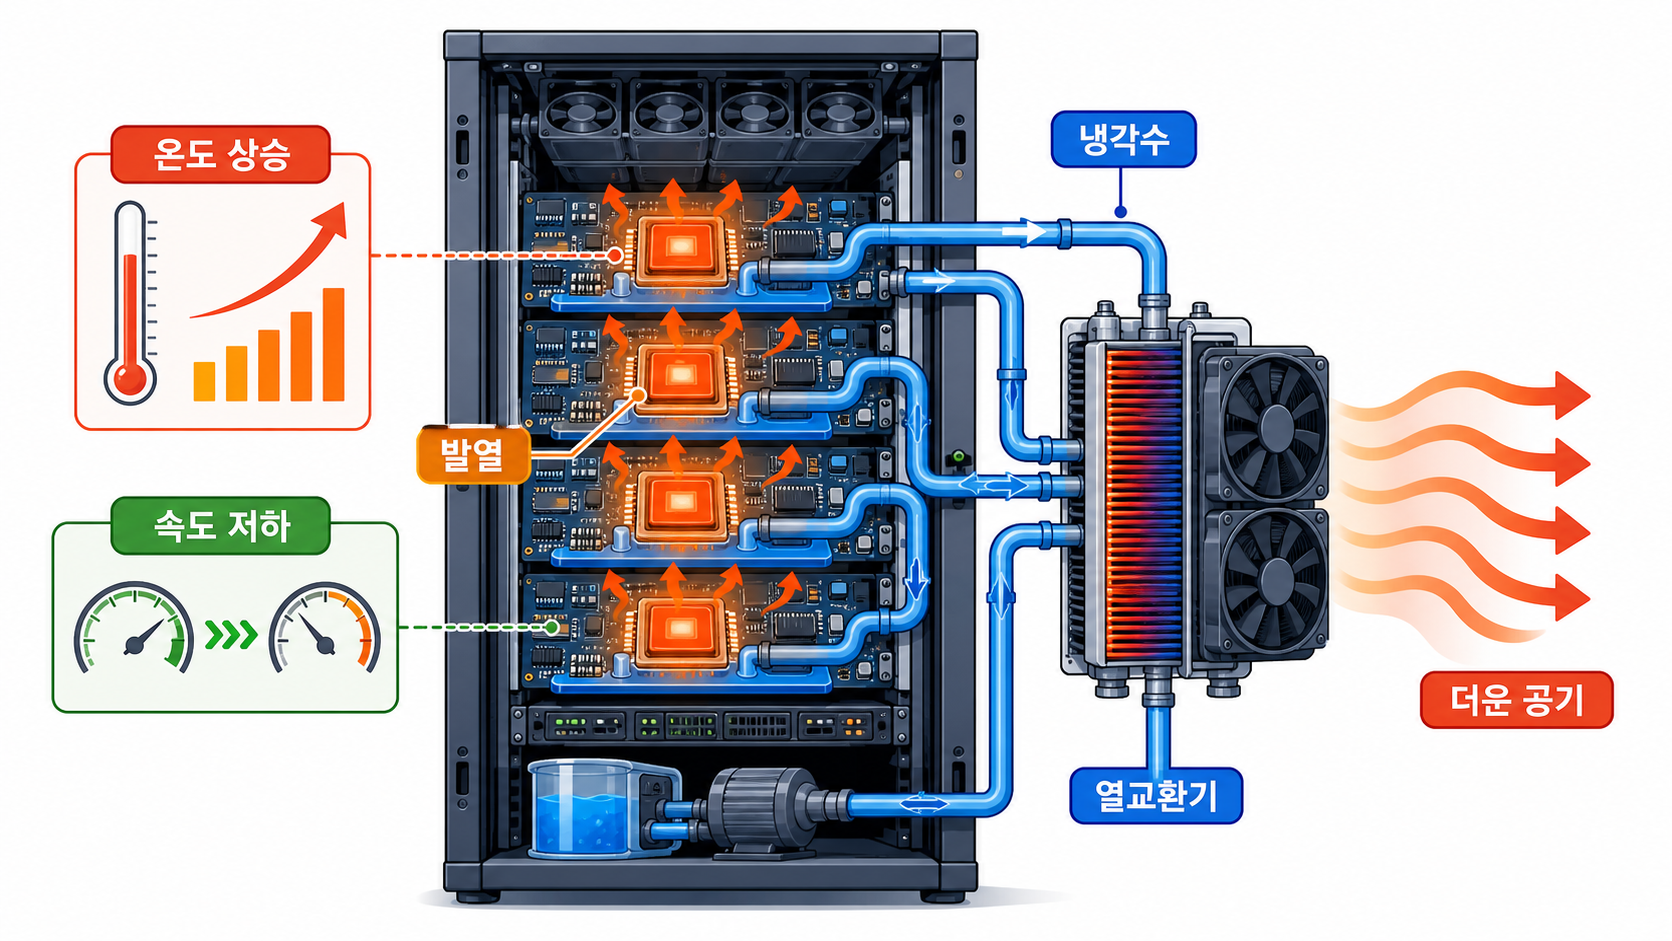
AI가 커질수록 문제는 계산의 속도뿐 아니라, 그 계산에서 발생한 열을 얼마나 안정적으로 제거할 수 있는가로 확장됩니다.
열이 쌓이면 문제가 생깁니다. 칩의 온도가 높아지면 트랜지스터의 동작이 불안정해지고, 전류가 새어 나가는 현상도 늘어날 수 있습니다. 계산 오류의 가능성이 커지고 부품의 수명도 줄어듭니다. 특히 칩 전체가 아니라 특정 부분에 열이 몰리는 지점이 생길 수 있는데, 이를 열점(hot spot)이라고 합니다. 평균 온도는 괜찮아 보여도 열점이 생기면 성능을 낮춰야 할 수 있습니다. 그래서 고성능 AI 서버에는 냉각 장치가 필수입니다. 일반 컴퓨터는 팬과 방열판으로 열을 빼내지만, 대규모 AI 서버는 더 강한 냉각 방식을 필요로 합니다. 냉각판에 액체를 흘려 칩의 열을 직접 빼앗는 직접 액체 냉각, 장비를 절연성 액체에 담그는 침지 냉각 같은 방식도 사용됩니다. 중요한 것은 열을 없애는 것이 아니라, 칩에서 바깥 환경으로 계속 옮기는 것입니다.
냉각에도 비용이 듭니다. 팬, 펌프, 냉각기, 공조 설비는 모두 전력을 사용합니다. 서버가 사용한 전기에너지는 대부분 결국 열이 되고, 데이터센터는 그 열을 안정적으로 외부로 내보내야 합니다. 따라서 AI의 전력 소비는 계산에 쓰이는 전기만이 아니라, 그 계산에서 생긴 열을 처리하는 비용까지 포함해 보아야 합니다. AI 모델이 커질수록 열 문제는 더 중요해집니다. 학습 과정에서는 많은 가속기가 오랜 시간 높은 부하로 작동합니다. 추론 과정에서는 이미 학습된 모델이 수많은 사용자의 요청을 반복해서 처리합니다. 한 번의 응답에 드는 에너지는 작아 보여도, 그것이 수억 번 반복되면 전체 전력과 열 부담은 커집니다.
서비스의 성격에 따라 열관리의 기준도 달라집니다. 대화형 AI나 검색 서비스는 사용자가 기다리지 않도록 짧은 지연 시간과 안정적인 순간 성능이 중요합니다. 반면 대규모 학습이나 과학 시뮬레이션은 오랜 시간 높은 부하를 견디는 안정성과 전체 에너지 효율이 더 중요할 수 있습니다. AI 성능은 단순히 최고 속도만으로 평가할 수 없습니다. 데이터센터가 놓인 지역도 중요합니다. 외부 온도와 습도, 전력망의 안정성, 물 사용 가능성에 따라 냉각 방식과 비용이 달라집니다. 더운 지역에서는 냉각 전력이 더 많이 들 수 있고, 물이 부족한 곳에서 물을 많이 쓰는 냉각 방식을 택하면 지역사회와 갈등이 생길 수 있습니다.
결국 열은 계산이 끝난 뒤 처리하는 부산물이 아닙니다. AI의 규모와 속도를 처음부터 제한하는 설계 조건입니다. 더 큰 모델과 더 많은 계산을 말할 때는 그 계산에서 생긴 열을 어디로, 어떤 에너지와 자원을 써서 내보낼지도 함께 물어야 합니다. AI의 성능은 얼마나 빠르게 계산하는가만으로 결정되지 않습니다. 제한된 전력과 온도 안에서 얼마나 많은 유용한 계산을 안정적으로 지속할 수 있는가가 중요합니다. 열관리는 AI 바깥의 보조 기술이 아니라, 지능의 물리적 한계를 결정하는 핵심 조건입니다.
9.5 랜다우어 원리와 정보의 비용
책상 위에 영수증이 어지럽게 쌓여 있다고 생각해 봅시다. 정리하려면 필요한 것은 남기고, 불필요한 것은 버리며, 뒤섞인 상태를 하나의 질서 있는 상태로 바꾸어야 합니다. 이 과정에는 손의 움직임과 시간이 필요합니다. 컴퓨터에서 정보를 지우는 일도 이와 비슷합니다. 추상적인 숫자를 없애는 것이 아니라, 메모리의 물리적 상태를 바꾸는 일입니다. 컴퓨터의 0과 1은 종이에 적힌 기호가 아닙니다. 전압, 전하, 자기적 상태처럼 구별 가능한 물리적 상태로 저장됩니다. 정보를 초기화한다는 것은 0일 수도 있고 1일 수도 있었던 상태를 하나의 정해진 상태로 되돌리는 것입니다. 이때 정보 처리는 열역학과 만나게 됩니다.
정보 삭제에도 물리적 비용이 있다
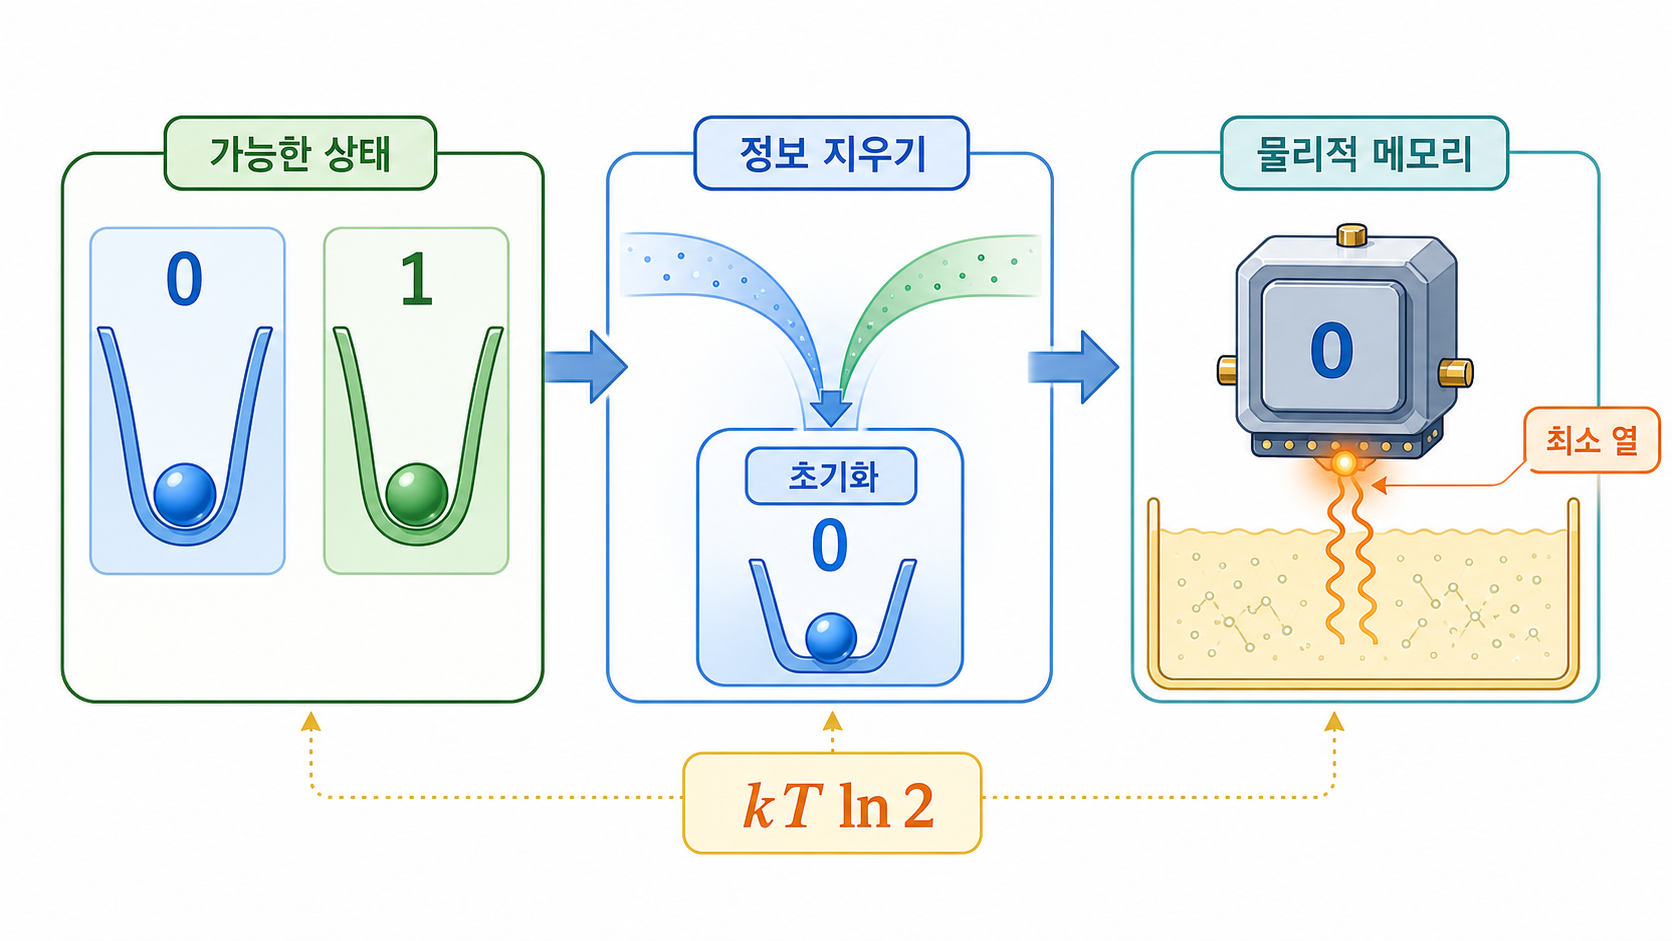
정보는 물리적 상태로 저장되며, 논리적으로 되돌릴 수 없는 정보 삭제에는 열역학적 최소 비용이 따릅니다.
정보를 지우는 데에는 원리적으로 최소한의 에너지 비용이 따른다는 생각을 랜다우어 원리(Landauer’s principle)라고 합니다. 예를 들어 어떤 비트가 0인지 1인지와 관계없이 모두 0으로 초기화하려면, 그 장치가 가질 수 있었던 가능한 상태의 수를 줄여야 한다는 것입니다. 이 줄어든 불확실성은 그냥 사라지지 않고, 주변 환경에 열의 형태로 넘겨집니다. 이 원리는 정보가 물질과 완전히 분리된 추상이 아니라는 점을 보여 줍니다. 정보를 저장하고 지우고 다시 쓰는 일은 언제나 어떤 물리적 장치의 상태 변화로 이루어집니다. 비트 하나를 지울 때 필요한 이론적 최소 에너지는 매우 작지만 0은 아닙니다. 계산은 아무 흔적 없이 일어나는 순수한 생각이 아니라, 자연법칙 안에서 진행되는 물리적 과정입니다.
다만 랜다우어 원리만으로 오늘날 AI 서버의 전력 사용량을 직접 계산할 수는 없습니다. 실제 AI 하드웨어가 쓰는 에너지는 이론적 한계보다 훨씬 큽니다. 트랜지스터의 충전과 방전, 누설전류, 메모리 접근, 데이터 이동, 칩 사이의 통신, 전원 변환, 냉각 장치가 모두 전력을 사용합니다. 현대 AI의 에너지 비용은 정보 삭제의 최소 한계뿐 아니라, 거대한 장치 전체의 작동 조건에서 결정됩니다. AI는 정보를 끊임없이 읽고, 저장하고, 변환하고, 일부는 버립니다. 학습 과정에서는 데이터가 모델의 가중치를 바꾸고, 추론 과정에서는 입력 문맥과 중간 계산 결과가 메모리에 저장되었다가 다시 초기화됩니다. 화면에는 문장 하나가 나타나지만, 그 뒤에서는 전하가 이동하고 메모리가 읽히고 쓰이며, 결국 에너지의 일부가 열로 바뀝니다.
여기서 “지식에도 열이 있다”는 말은 비유로는 유용합니다. 그러나 더 정확히 말하면, 지식 자체가 열을 갖는 것이 아니라 지식을 저장하고 검색하고 생성하는 물리적 장치가 에너지를 쓰고 열을 발생시킵니다. AI가 의미 있는 답을 만든다는 사실과, 그 답을 만들기 위해 장치가 물리적 비용을 치른다는 사실을 구분해야 합니다. 랜다우어 원리는 AI 시대 중요한 관점을 제공합니다. 정보는 공중에 떠 있는 것이 아니라 물리적 상태로 저장되고 처리됩니다. 따라서 AI의 효율을 말할 때는 알고리즘의 성능만 볼 수 없습니다. 데이터를 어디에 저장하고, 얼마나 자주 읽고 쓰며, 어떤 장치에서 계산하고, 그 과정에서 얼마나 많은 에너지와 열이 발생하는지도 함께 보아야 합니다.
결국 정보의 비용은 AI의 바깥 문제가 아닙니다. AI가 더 큰 모델과 더 긴 문맥, 더 많은 서비스를 향해 나아갈수록 정보 처리의 물리적 비용은 더 중요해집니다. 랜다우어 원리는 그 출발점에서 우리에게 단순한 사실을 알려 줍니다. 정보는 물리적이며, AI의 계산도 열역학의 세계 안에서 이루어집니다.
9.6 데이터센터와 전력망
항구에는 배만 있는 것이 아닙니다. 컨테이너, 창고, 도로, 철도, 전력 설비가 함께 연결되어 물자의 흐름을 만들고 다시 퍼뜨립니다. 데이터센터도 디지털 세계의 항구와 비슷합니다. 데이터가 통신망을 통해 들어오고, 서버에서 계산과 저장이 이루어진 뒤 결과가 다시 사용자에게 전달됩니다. 대규모 AI 모델의 학습과 추론, 검색과 추천, 이미지 생성과 과학 계산은 모두 이러한 물리적 시설에 의존합니다.
데이터센터(data center)*는 서버와 저장장치, 네트워크 장비를 한곳에 모아 대량의 데이터를 처리하고 보관하는 시설입니다. AI 데이터센터에는 GPU 같은 AI 가속기가 들어간 서버, 데이터를 저장하는 스토리지, 서버들을 연결하는 고속 네트워크, 전기를 안정적으로 공급하는 전력 설비, 열을 빼내는 냉각 설비가 함께 필요합니다. 정전이나 장비 고장에 대비해 배터리, 비상 발전기, 이중화된 전력·통신 장치도 갖춥니다. 그래서 데이터센터는 단순한 컴퓨터실이 아니라 전력, 냉각, 통신, 보안, 건축이 결합된 산업 인프라입니다.
지역 인프라와 데이터센터
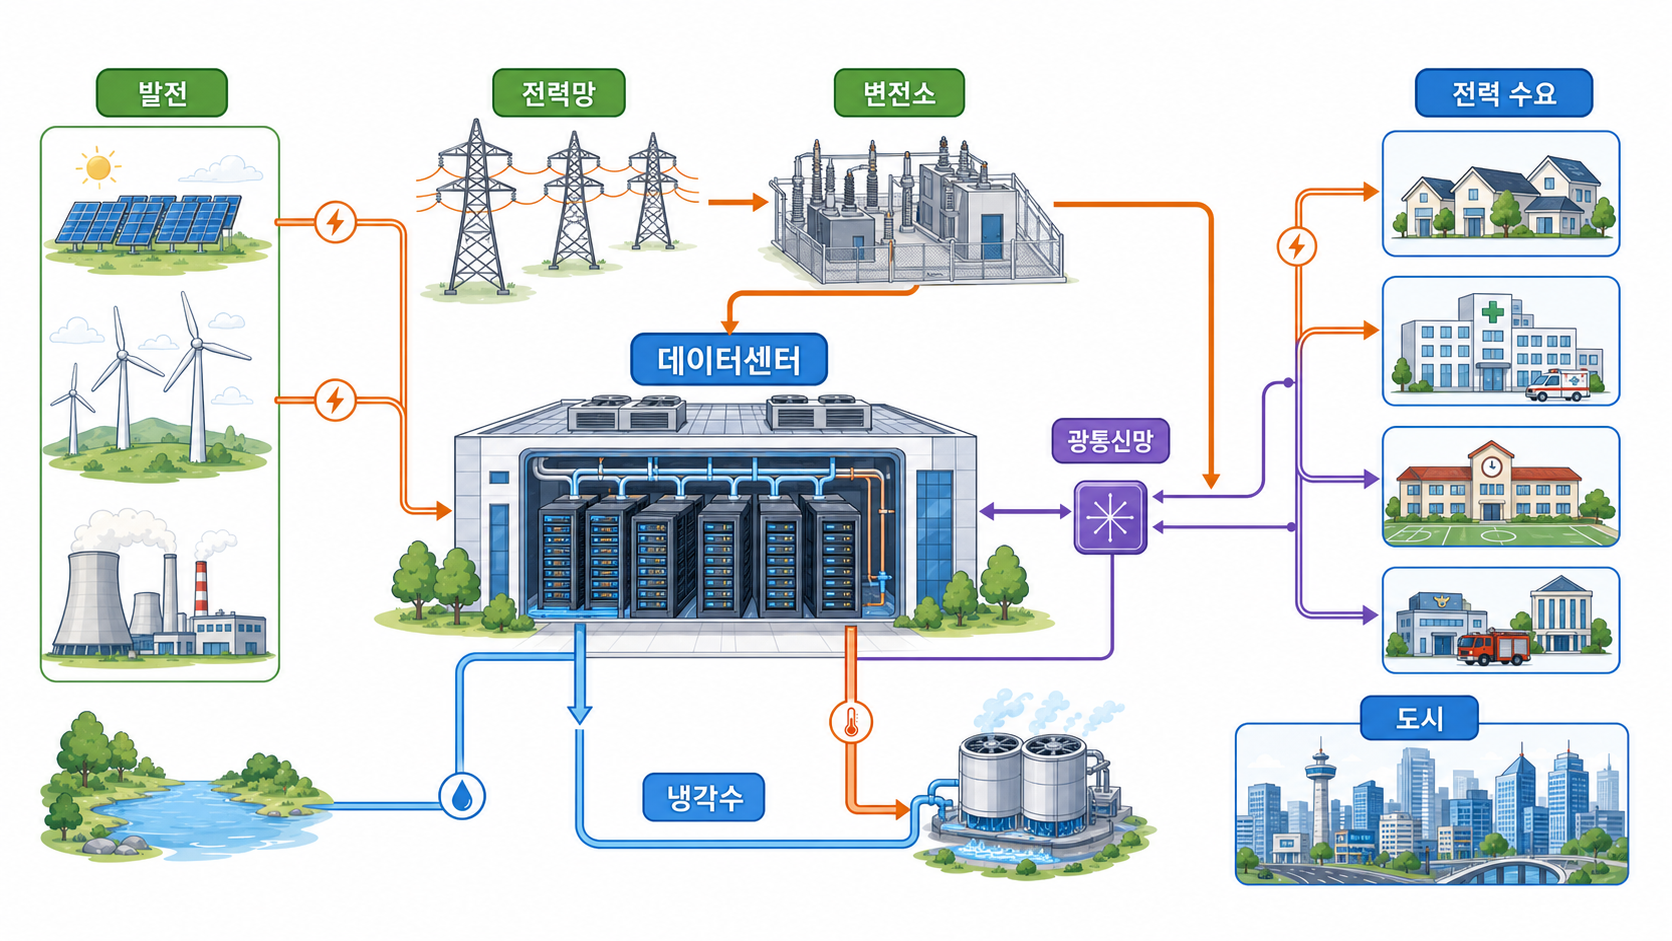
AI는 클라우드에 떠 있는 것이 아니라, 지역의 전력망과 통신망, 물과 냉각 설비 위에서 작동합니다.
데이터센터가 들어서려면 몇 가지 조건이 필요합니다. 먼저 많은 전기를 안정적으로 공급받을 수 있어야 합니다. 송전선과 변전소가 충분한 부하를 감당해야 하고, 순간적인 전압 변화에도 장비가 안정적으로 작동해야 합니다. 둘째, 발생한 열을 계속 배출할 수 있는 냉각 조건이 필요합니다. 외부 기온과 습도, 물 사용 가능성, 냉각 방식이 모두 중요합니다. 셋째, 빠른 통신망과 적절한 입지, 보안, 토지 이용 조건도 필요합니다. 한국에서도 데이터센터가 중요한 관심사가 되는 까닭은, 이 시설이 전력망과 지역 환경, 산업 경쟁력에 동시에 영향을 주기 때문입니다.
AI 데이터센터에 필요한 전기는 콘센트에서 저절로 생기지 않습니다. 발전소에서 생산된 전기는 송전망과 변전소, 배전 설비를 거쳐 공급됩니다. 대규모 데이터센터가 특정 지역에 들어서면 지역 전력 수요가 크게 늘고, 전력망에 새로운 부담이 생길 수 있습니다. 데이터센터를 늘리려면 발전량뿐 아니라 송전선과 변전 설비가 그 부하를 감당할 수 있는지도 함께 살펴야 합니다. 전기를 얼마나 쓰는가만큼 언제 쓰는가도 중요합니다. 지역의 냉방 수요와 산업 수요가 높은 시간대에 데이터센터의 부하까지 겹치면 전력망 부담은 더 커집니다. 일부 AI 학습 작업은 전력 수요가 낮거나 재생에너지 공급이 많은 시간대로 옮길 수 있습니다. 하지만 대화형 AI나 검색처럼 즉각적인 응답이 필요한 서비스는 시간 조절이 어렵습니다.
냉각도 데이터센터의 핵심 조건입니다. AI 서버가 사용한 전력의 상당 부분은 결국 열로 바뀝니다. 이 열을 밖으로 내보내지 못하면 칩의 성능과 수명이 떨어집니다. 공기 냉각은 외부 기온과 습도의 영향을 받고, 액체 냉각은 높은 열밀도를 다루는 데 유리하지만 설비와 유지보수 방식이 달라집니다. 어떤 냉각 방식이 좋은지는 지역의 기후, 물 사용 가능성, 전력 가격, 서버 구성에 따라 달라집니다. 물 사용도 단순히 양만 볼 수 없습니다. 물이 풍부한 지역에서의 사용과 가뭄이 잦은 지역에서의 사용은 의미가 다릅니다. 전력을 아끼기 위해 물을 더 많이 쓰는 냉각 방식을 선택했다면, 전력 절감과 지역 수자원 부담을 함께 비교해야 합니다. 전기, 물, 탄소 배출은 따로 떨어진 지표가 아니라 서로 맞물린 조건입니다.
데이터센터의 에너지 효율을 볼 때 자주 쓰는 지표가 있습니다. 서버와 저장장치 같은 실제 IT 장비가 쓴 에너지에 비해, 건물 전체가 얼마나 많은 에너지를 썼는지를 비교하는 방식입니다. 이를 전력사용효율(PUE, Power Usage Effectiveness)이라고 합니다. 값이 1에 가까울수록 냉각과 전력 변환 같은 부대 설비에 쓰인 에너지 비중이 작다는 뜻입니다. 하지만 PUE가 낮다고 해서 환경 부담이 반드시 작다는 뜻은 아닙니다. 매우 효율적인 데이터센터라도 규모가 크면 총전력 사용량은 클 수 있습니다. 또 사용한 전기의 탄소 배출, 물 사용량, 장비 생산과 폐기까지 PUE 하나로 알 수는 없습니다. 물 사용을 함께 보려면 물사용효율(WUE, Water Usage Effectiveness) 같은 지표가 사용됩니다. 다만 이 수치도 측정 범위와 계산 방식에 따라 달라지므로, 숫자만 보지 말고 어떻게 계산했는지 확인해야 합니다.
AI 인프라의 효율은 칩 하나의 성능표로 끝나지 않습니다. 서버, 메모리, 네트워크, 냉각 설비, 전력 변환 장치, 건물 전체, 더 넓게는 전력망과 지역 수자원까지 이어집니다. 칩에서 전력을 아꼈더라도 데이터 이동과 냉각, 통신에서 비용이 커지면 전체 절감 효과는 줄어들 수 있습니다. 그렇다고 AI가 전기를 많이 쓴다는 이유만으로 모든 활용을 같은 기준으로 판단할 수는 없습니다. 질병 연구, 신소재 개발, 재난 예측, 장애 보조처럼 큰 계산 비용을 감수할 사회적 이유가 있는 활용도 있습니다. 반대로 작은 편의를 위해 지나치게 큰 모델을 반복 실행하거나, 더 작은 모델로 가능한 일에 불필요하게 많은 계산을 쓰는 경우도 있습니다.
여기서 필요한 기준은 계산의 목적과 비용이 균형을 이루는가입니다. 이를 비례성(proportionality)이라고 할 수 있습니다. 어떤 계산이 정말 필요한지, 같은 목적을 더 작은 모델이나 더 효율적인 장치로 달성할 수 있는지, 그 사회적 가치가 전력과 물, 환경 비용에 비해 충분한지 물어야 합니다. AI는 클라우드에서 작동하는 것처럼 보이지만, 그 클라우드는 땅 위의 시설입니다. 데이터센터에는 주소가 있고, 전력과 물의 공급원이 있으며, 열을 내보내는 장소가 있습니다. AI의 물리적 비용을 이해한다는 것은 화면 속 결과뿐 아니라 그 결과를 떠받치는 건물, 전력망, 냉각 설비, 지역사회의 조건까지 함께 보는 일입니다.
9.7 효율적인 모델과 작은 지능
라면 하나를 끓이기 위해 대형 급식 설비를 가동할 필요는 없습니다. 반대로 수백 명의 식사를 작은 냄비 하나로 준비한다면 시간과 에너지가 지나치게 많이 듭니다. 도구의 크기는 목적과 작업량에 맞아야 합니다. AI도 마찬가지입니다. 중요한 것은 가장 큰 지능이 아니라, 목적에 충분한 지능입니다. AI 모델이 클수록 일반적으로 더 많은 메모리와 연산, 전력을 요구합니다. 복잡한 추론과 폭넓은 지식이 필요한 문제에는 큰 범용 모델이 유리할 수 있습니다. 그러나 짧은 문장 분류, 음성 명령 인식, 사진 보정, 센서 이상 감지처럼 범위가 분명한 작업에는 작고 전문화된 모델이 더 적합할 수 있습니다. 성능 향상이 실제 목적에 거의 기여하지 않는다면, 추가 계산은 효율보다 낭비에 가까워집니다.
클라우드 AI와 온디바이스 AI
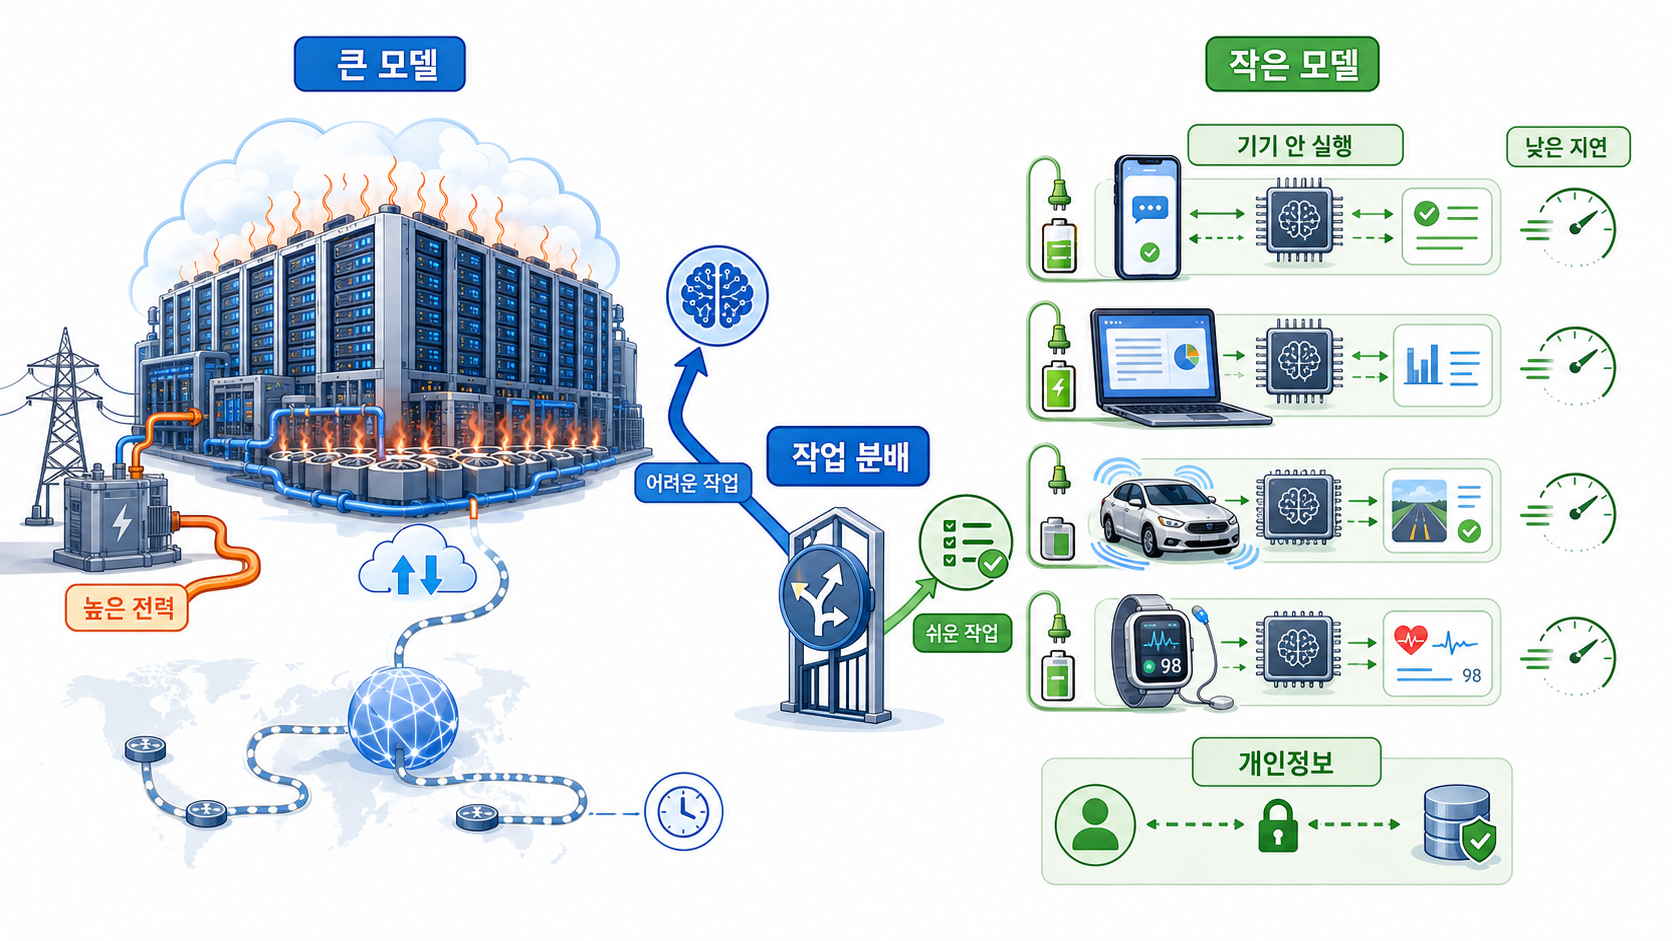
좋은 AI는 언제나 가장 큰 AI가 아니라, 필요한 장소에서 적은 자원으로 목적을 충분히 달성하는 AI일 수 있습니다.
AI의 학습과 추론도 구별해야 합니다. 학습(training)은 모델이 많은 데이터를 보며 내부의 가중치를 조정하는 과정입니다. 새 공장을 짓고 설비를 맞추는 일에 가깝습니다. 많은 데이터를 오래 처리해야 하므로 대규모 GPU, 고대역폭 메모리, 빠른 저장장치와 네트워크, 강력한 냉각 설비가 필요합니다. 여러 서버가 동시에 작동하며 긴 시간 높은 부하를 견뎌야 합니다. 추론(inference)은 이미 학습된 모델을 사용해 실제 질문에 답하는 과정입니다. 완성된 공장에서 주문에 맞춰 제품을 내보내는 일에 가깝습니다. 추론에서는 응답 속도, 비용, 전력 효율이 중요합니다. 대화형 AI처럼 많은 사용자가 동시에 요청하는 서비스에서는 작은 지연도 문제가 될 수 있습니다. 그래서 추론용 하드웨어는 빠른 응답과 낮은 전력, 많은 요청을 안정적으로 처리하는 능력이 중요합니다.
모델을 작고 가볍게 만드는 방법도 다양합니다. 먼저 모든 숫자를 지나치게 세밀하게 표현하지 않고, 정확도를 크게 해치지 않는 범위에서 더 적은 자리수로 계산할 수 있습니다. 이렇게 모델의 숫자 정밀도를 낮추는 방법을 양자화(quantization)라고 합니다. 여기서 양자화는 양자컴퓨터의 ‘양자’와는 다른 말입니다. 숫자를 더 거칠지만 효율적인 단위로 표현해 메모리 사용량과 데이터 이동, 연산 비용을 줄이는 기술입니다. 또 모델 안의 모든 연결이 똑같이 중요한 것은 아닙니다. 기여도가 낮은 연결이나 가중치, 연산을 덜어내면 모델을 더 가볍게 만들 수 있습니다. 나무의 불필요한 가지를 잘라내듯이 모델의 일부를 제거하는 방법을 가지치기(pruning)라고 합니다. 다만 실제 속도 향상은 하드웨어와 소프트웨어가 이렇게 듬성듬성한 구조를 효율적으로 처리할 수 있을 때 나타납니다. 큰 모델이 배운 판단 방식을 작은 모델에 전해 주는 방법도 있습니다. 숙련된 교사가 모든 문제를 대신 풀어 주는 것이 아니라, 중요한 풀이 방식과 판단 기준을 학생에게 가르치는 것과 비슷합니다. 이 방법을 지식 증류(knowledge distillation)라고 합니다. 작은 모델은 큰 모델의 모든 능력을 보존하지는 못하지만, 제한된 작업에서는 비슷한 성능을 훨씬 적은 자원으로 낼 수 있습니다.
클라우드 AI와 온디바이스 AI도 역할이 다릅니다. 클라우드(cloud) AI는 데이터센터의 강력한 서버에서 AI를 실행하는 방식입니다. 큰 모델을 사용할 수 있고, 복잡한 요청을 처리하기 좋습니다. 대신 통신망을 거쳐야 하므로 지연 시간이 생기고, 사용자 데이터가 외부 서버로 이동할 수 있으며, 데이터센터의 전력과 냉각 비용이 필요합니다. 온디바이스(on-device) AI는 스마트폰, 노트북, 자동차, 가전제품, 의료기기처럼 사용자의 기기 안에서 AI를 직접 실행하는 방식입니다. 민감한 데이터를 기기 밖으로 보내지 않아도 되고, 네트워크가 불안정해도 작동할 수 있으며, 응답 지연을 줄일 수 있습니다. 하지만 배터리, 메모리, 칩 성능, 발열이라는 제한이 있습니다. 그래서 온디바이스 AI에는 작고 효율적인 모델과 NPU 같은 전용 처리장치가 중요합니다.
실제 서비스에서는 두 방식을 섞는 경우가 많습니다. 간단하고 민감한 작업은 기기 안의 작은 모델이 처리하고, 복잡한 문제는 클라우드의 큰 모델에 맡깁니다. 쉬운 요청은 작은 모델이 먼저 답하고, 어렵거나 불확실한 요청만 큰 모델로 넘기는 방식도 가능합니다. 이렇게 하면 모든 질문에 가장 비싼 계산을 쓰는 일을 줄일 수 있습니다. 효율은 모델 크기만의 문제가 아닙니다. 이미 계산한 결과나 자주 쓰는 정보를 가까운 곳에 저장해 두면 같은 작업을 처음부터 반복하지 않아도 됩니다. 이를 캐시(cache)라고 합니다. 다만 저장된 정보가 오래되었거나 현재 맥락과 맞지 않을 수 있으므로, 언제 다시 계산하고 갱신할지 판단하는 기준도 필요합니다.
이 절의 핵심은 제한된 자원 안에서 가장 알맞은 선택을 찾는 일입니다. 전력, 메모리, 응답 시간, 발열, 정확도는 모두 무한하지 않습니다. 이러한 조건 속에서 필요한 성능을 얻도록 모델과 하드웨어, 실행 위치를 조정하는 일을 제약 속의 최적화(optimization under constraints)라고 할 수 있습니다. AI가 사회 곳곳에서 지속적으로 쓰이려면 큰 모델만으로는 충분하지 않습니다. 큰 모델은 새로운 능력을 탐색하고 복잡한 문제를 해결하는 데 중요하지만, 일상적이고 반복적인 작업에는 작은 모델이 더 적절할 수 있습니다. 작은 지능은 단순한 절약의 상징이 아닙니다. 필요한 장소에 필요한 만큼의 계산을 배치하는 기술입니다.
9.8 광연결, 칩렛, 뉴로모픽
좋은 건물은 방 하나의 크기만으로 평가되지 않습니다. 방과 방을 잇는 복도, 문, 이동 경로가 잘 설계되어야 전체 공간이 편리하게 작동합니다. AI 하드웨어도 마찬가지입니다. 개별 칩의 계산 능력만큼이나 칩과 메모리, 서버와 서버를 어떻게 연결하는지가 중요합니다. AI 모델이 커지면서 하나의 칩이나 서버 안에서 모든 계산을 처리하기 어려워졌습니다. 여러 가속기와 메모리를 연결하면 계산 능력은 커지지만, 그만큼 데이터가 오가는 길도 복잡해집니다. 연결 통로가 느리거나 멀면 연산 장치는 서로의 결과를 기다리고, 데이터 이동에는 추가 전력과 열이 발생합니다. 미래 AI 하드웨어의 핵심 질문은 “얼마나 많이 계산하는가”와 함께 “데이터를 얼마나 덜 움직이게 할 수 있는가”입니다.
빛과 전기로 잇는 AI 하드웨어
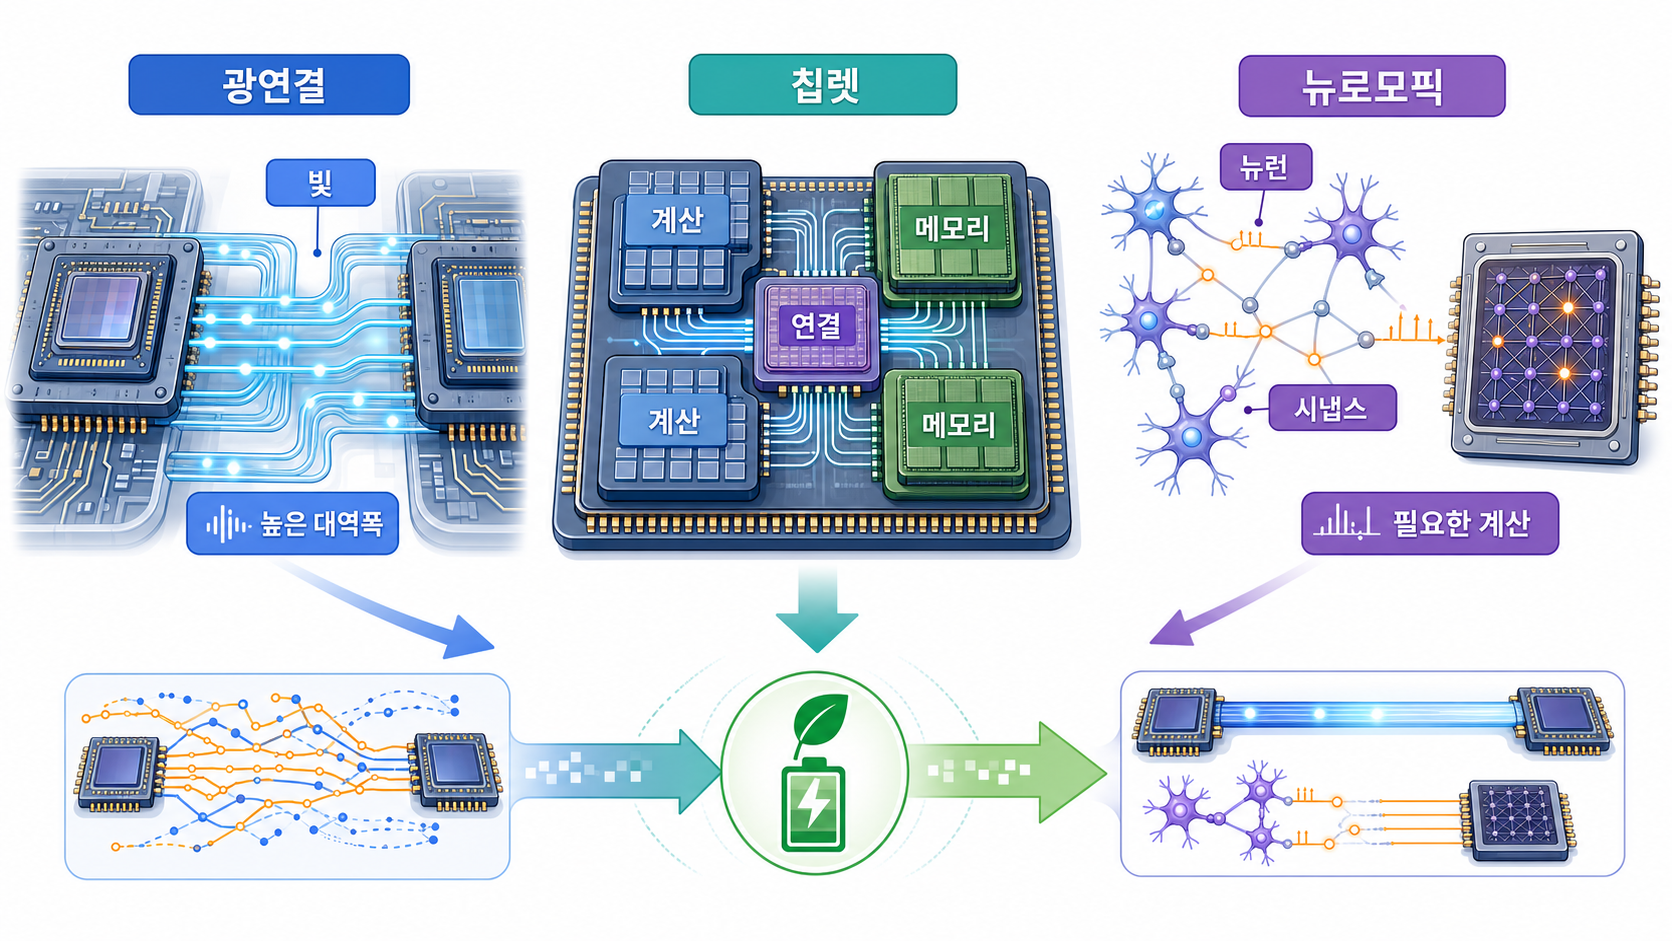
AI 하드웨어는 더 많은 연산 장치를 넣는 데서 나아가, 데이터가 이동하는 거리와 방식, 계산과 저장의 배치를 다시 설계하고 있습니다.
먼 거리로 많은 데이터를 보내야 할 때 전기 신호만으로는 한계가 생길 수 있습니다. 이때 빛을 이용해 데이터를 전달하는 방법이 주목받습니다. 전기 신호 대신 빛으로 정보를 보내는 연결 방식을 광연결(optical interconnect)이라고 합니다. 광섬유는 이미 데이터센터 사이와 내부 통신에 널리 쓰이고 있으며, 최근에는 칩과 칩, 가속기와 메모리 사이의 더 가까운 연결에도 빛을 활용하려는 연구가 이어지고 있습니다. 빛은 특정한 거리와 데이터량에서 높은 대역폭을 제공하고, 전기 배선에서 생기는 신호 감쇠와 간섭을 줄이는 데 유리할 수 있습니다. 여러 파장의 빛을 한 통로에 함께 실으면 많은 데이터를 동시에 보낼 수도 있습니다. 하지만 빛이 언제나 전기보다 좋은 것은 아닙니다. 전기 신호를 빛으로 바꾸고 다시 전기로 되돌리는 과정에도 장치와 에너지가 필요합니다. 따라서 광연결의 가치는 “빛이라서 무조건 빠르다”가 아니라, 데이터 이동 거리와 양, 변환 비용을 따져 유리한 구간에 적용하는 데 있습니다.
칩의 구성 방식도 달라지고 있습니다. 모든 기능을 하나의 거대한 칩에 넣으면 설계는 단순해 보이지만, 칩이 커질수록 제조 결함의 위험과 비용이 커집니다. 그래서 여러 개의 작은 칩 조각을 하나의 패키지 안에서 가깝게 연결하는 방식이 쓰입니다. 이런 작은 칩 조각을 칩렛(chiplet)이라고 합니다. 칩렛 구조에서는 연산, 메모리 제어, 입출력 같은 기능을 각각 알맞은 공정으로 만든 뒤 조합할 수 있습니다. 결함이 없는 부품을 골라 조립할 수 있고, 필요한 기능을 모듈처럼 재사용하기도 쉽습니다. 하지만 칩렛 사이를 오가는 데이터가 많아지면 통신 지연과 전력 소비가 커질 수 있습니다. 칩렛의 장점은 단순히 칩을 쪼개는 데 있지 않습니다. 어떤 기능을 어디에 배치하고, 어떻게 짧고 빠르게 연결할 것인지 설계하는 데 있습니다.
AI의 학습과 추론은 필요한 하드웨어도 다릅니다. 학습은 거대한 데이터를 오래 처리하며 모델의 가중치를 조정하는 과정입니다. 많은 GPU나 AI 가속기, 고대역폭 메모리, 빠른 네트워크, 강력한 냉각 설비가 필요합니다. 여러 서버가 동시에 작동하므로 칩 사이와 서버 사이의 연결 성능이 매우 중요합니다. 광연결과 칩렛 같은 기술은 이런 대규모 학습 시스템에서 데이터 이동의 병목을 줄이는 데 도움을 줄 수 있습니다. 추론은 이미 학습된 모델을 사용해 사용자의 요청에 답하는 과정입니다. 여기서는 응답 속도, 전력 효율, 비용이 중요합니다. 대화형 AI처럼 요청이 계속 들어오는 서비스에서는 한 번의 계산을 얼마나 빠르고 안정적으로 처리하는지가 핵심입니다. 작은 모델이나 전용 가속기, 메모리 가까이에서 계산하는 구조가 유리할 수 있습니다. 학습이 거대한 공장을 짓는 일이라면, 추론은 그 공장에서 수많은 주문을 효율적으로 처리하는 일에 가깝습니다.
클라우드 AI와 온디바이스 AI도 역할이 다릅니다. 클라우드 AI(cloud AI)는 데이터센터의 강력한 서버에서 큰 모델을 실행하는 방식입니다. 복잡한 문제를 처리하기 좋지만, 통신망을 거쳐야 하고 데이터센터의 전력과 냉각 비용이 필요합니다. 반면 온디바이스 AI(on-device AI)는 스마트폰, 자동차, 가전제품, 산업 장비 안에서 AI를 직접 실행하는 방식입니다. 민감한 데이터를 기기 밖으로 보내지 않아도 되고 응답 지연을 줄일 수 있지만, 배터리와 발열, 메모리와 칩 성능의 제한을 받습니다. 이 때문에 미래 AI는 클라우드와 온디바이스가 역할을 나누는 방향으로 갈 가능성이 큽니다. 간단하고 민감한 작업은 기기 안의 작은 모델이 처리하고, 복잡한 추론이나 대규모 계산은 클라우드의 큰 모델이 맡을 수 있습니다. 좋은 AI 시스템은 모든 계산을 한곳에 몰아넣는 것이 아니라, 작업의 성격에 따라 계산 위치를 나누는 시스템입니다.
또 하나의 방향은 뇌와 신경계에서 힌트를 얻는 하드웨어입니다. 뇌를 그대로 복제한다는 뜻은 아니지만, 계산과 기억을 가깝게 두고, 필요한 순간에 필요한 부분만 반응하게 만들려는 접근입니다. 이런 계산 구조를 뉴로모픽 하드웨어(neuromorphic hardware)라고 합니다. 변화가 없을 때는 거의 쉬고, 사건이 생길 때만 짧은 신호로 반응하도록 만들면 센서 자료나 저전력 엣지 장치에서 효율을 높일 수 있습니다. 다만 뉴로모픽 하드웨어가 현재의 대규모 언어 모델을 그대로 대체한다는 뜻은 아닙니다. 적합한 알고리즘, 학습 방법, 소프트웨어 도구가 함께 발전해야 합니다. 뉴로모픽은 모든 AI를 위한 만능 장치라기보다, 낮은 전력으로 빠르게 반응해야 하는 특정 작업에서 가능성을 탐색하는 방향에 가깝습니다.
광연결, 칩렛, 뉴로모픽은 서로 다른 기술처럼 보이지만 같은 질문을 공유합니다. 데이터를 얼마나 멀리 움직여야 하는가. 계산과 기억을 얼마나 가까이 둘 수 있는가. 필요한 순간에 필요한 연산만 수행할 수 있는가. AI 하드웨어의 효율은 더 강한 연산기만이 아니라, 데이터가 지나가는 길과 계산이 놓이는 위치에 의해 결정됩니다. 결국 미래의 AI 하드웨어는 더 센 근육만을 추구하지 않을 것입니다. 더 짧은 길, 더 가까운 메모리, 더 효율적인 연결, 더 알맞은 계산 위치를 함께 설계해야 합니다. AI의 물리적 비용을 줄이는 일은 칩 하나를 빠르게 만드는 일이 아니라, 계산과 데이터 이동의 전체 구조를 다시 짜는 일입니다.
9.9 하드웨어 공급망과 지정학
연극 무대에서는 배우가 가장 눈에 띕니다. 그러나 공연이 이루어지려면 조명, 음향, 의상, 무대 장치, 전기, 운송, 기술 인력이 함께 필요합니다. AI에서도 모델과 서비스가 무대 위의 배우처럼 보입니다. 하지만 그 모델이 실제로 작동하려면 보이지 않는 거대한 하드웨어 공급망이 필요합니다. AI 모델을 실행하려면 반도체 칩, 메모리, 서버, 네트워크, 전력, 냉각 설비가 모두 필요합니다. 특히 대규모 AI는 GPU와 같은 AI 가속기, 고대역폭 메모리, 첨단 패키징, 데이터센터 인프라에 크게 의존합니다. 좋은 알고리즘만으로는 충분하지 않습니다. 그것을 빠르고 안정적으로 실행할 물리적 기반이 있어야 합니다.
AI 칩을 중심으로 연결된 세계 공급망
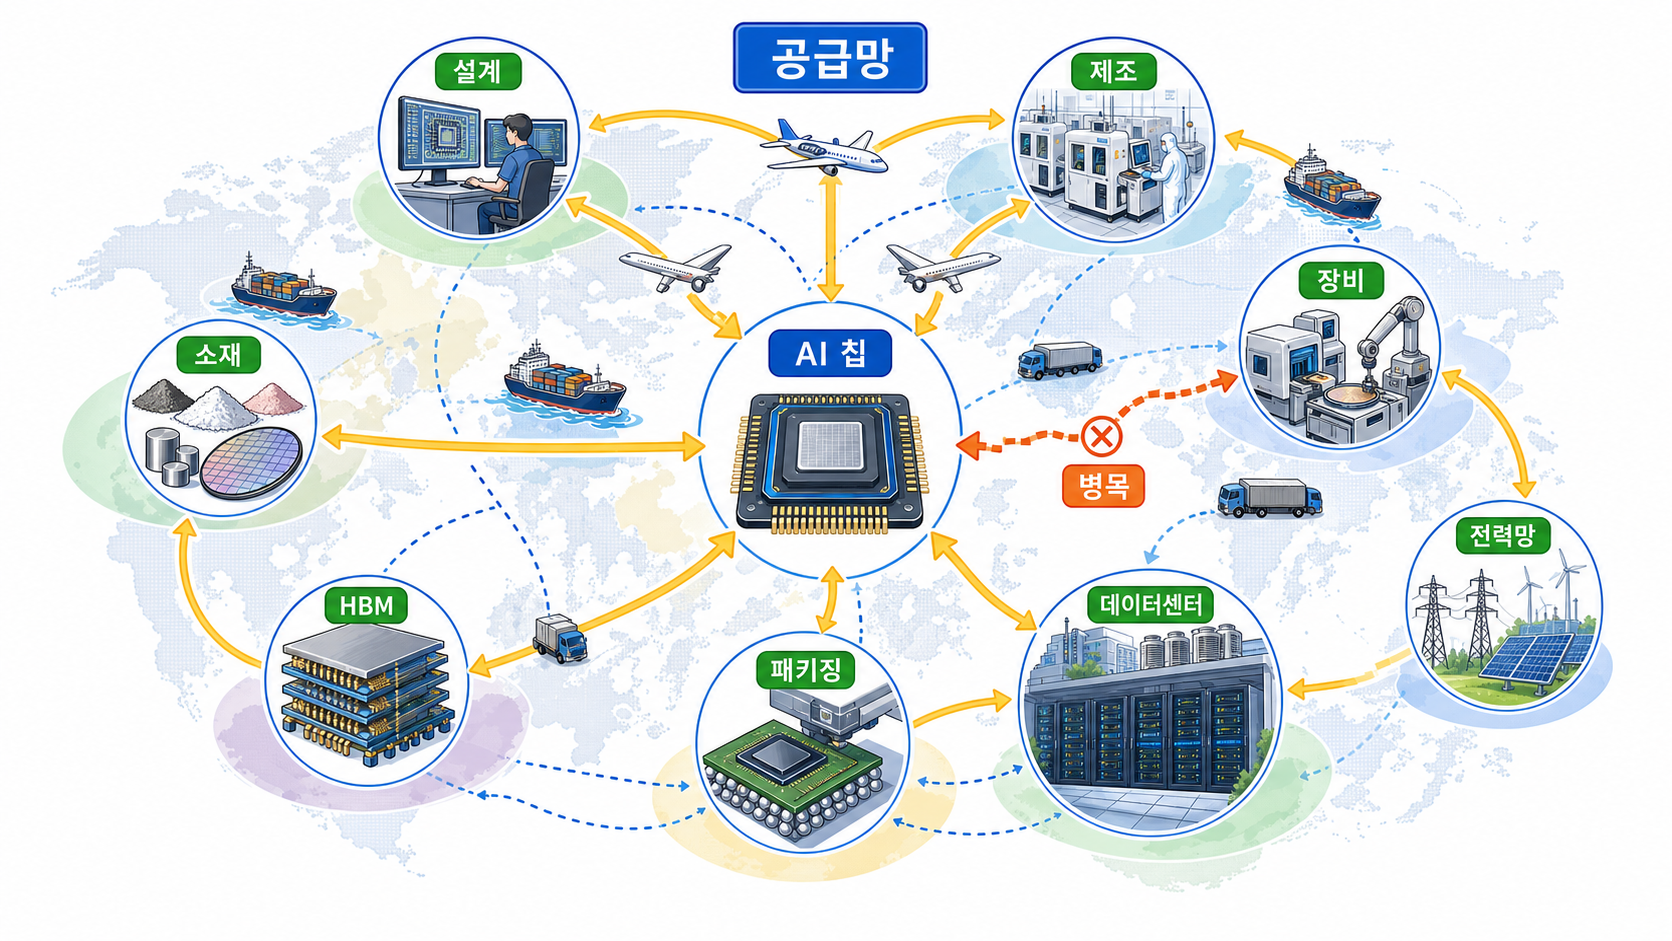
AI 칩은 작은 반도체이지만, 그 생산과 작동에는 세계의 산업 공급망과 에너지 인프라가 함께 연결되어 있습니다.
반도체는 한 기업이나 한 국가가 모든 과정을 혼자 맡기 어려울 만큼 복잡하게 만들어집니다. 먼저 칩의 구조를 설계해야 하고, 그 설계를 실제 회로로 바꾸는 소프트웨어와 지식재산이 필요합니다. 이후 고순도 웨이퍼 위에 회로를 새기고, 물질을 쌓고, 깎고, 검사하는 과정이 이어집니다. 빛을 이용해 아주 미세한 회로 무늬를 새기는 공정을 노광(lithography)이라고 하며, 이 과정에는 극도로 정밀한 장비와 소재가 필요합니다. 칩을 만든 뒤에도 끝이 아닙니다. AI 가속기는 메모리와 가까이 연결되어야 하고, 여러 칩이 빠르게 데이터를 주고받아야 합니다. 이때 칩과 메모리를 한 덩어리처럼 효율적으로 묶는 기술이 중요합니다. 여러 부품을 정밀하게 결합해 하나의 고성능 장치처럼 작동하게 만드는 과정을 첨단 패키징(advanced packaging)이라고 합니다. 칩 하나가 충분해도 메모리나 패키징이 부족하면 AI 시스템 전체를 완성하기 어렵습니다.
이처럼 AI 하드웨어 공급망은 여러 단계가 촘촘히 연결되어 있습니다. 설계 소프트웨어, 제조 장비, 웨이퍼와 화학물질, 메모리, 패키징, 서버 조립, 데이터센터 운영 가운데 어느 한 부분에서 문제가 생기면 전체 산업에 영향이 퍼질 수 있습니다. 특정 소재나 장비, 생산 시설이 일부 지역에 집중되어 있다면 자연재해, 무역 갈등, 수출 규제도 AI 산업의 변수가 됩니다. 그래서 AI는 경제와 외교, 안보의 문제이기도 합니다. 첨단 칩을 설계하고 생산할 수 있는 능력, 필요한 장비와 소재에 접근하는 능력, 데이터센터에 전력을 안정적으로 공급하는 능력은 국가와 기업의 기술 경쟁력을 좌우합니다. AI 경쟁은 모델의 성능 경쟁이면서 동시에 반도체와 전력망, 공급망의 경쟁입니다.
하지만 공급망을 지정학적 경쟁만으로 보아서는 부족합니다. 반도체와 서버를 만들기 위해서는 광물, 화학물질, 물, 전기, 숙련된 노동이 필요합니다. 공장 건설과 장비 생산, 폐기와 재활용 과정에서도 환경 부담이 생깁니다. AI 하드웨어의 안정성은 단순히 제품을 끊기지 않고 공급하는 문제만이 아니라, 그 비용과 위험이 어디에 쌓이는가의 문제이기도 합니다. 공급망을 강화한다는 말도 모든 생산을 한곳에 모은다는 뜻은 아닙니다. 특정 지역에 지나치게 의존하면 위험이 커지지만, 모든 공정을 중복해 구축하면 비용과 자원 사용이 늘어납니다. 중요한 것은 공급처의 다양성, 기술 협력, 적절한 재고, 재활용, 노동과 환경 기준 사이의 균형입니다.
전력 인프라도 공급망의 일부입니다. AI 가속기를 충분히 생산해도 데이터센터에 필요한 전기를 공급할 발전·송전 설비가 부족하면 실제 계산 능력으로 이어지지 않습니다. 칩, 메모리, 서버, 전력망, 냉각 설비는 따로 떨어진 부품이 아니라 하나의 계산 인프라를 이룹니다. 따라서 AI를 이해할 때는 “어느 모델이 더 똑똑한가”만 물어서는 부족합니다. 이 모델은 어떤 칩에서 작동하는가. 그 칩은 어떤 소재와 장비로 만들어졌는가. 필요한 메모리와 패키징은 충분한가. 계산에 쓰는 전력은 어디에서 오는가. 발생한 열은 어떻게 처리되는가. 이런 질문들이 함께 따라야 합니다.
이 질문들은 AI의 지능을 낮추어 보려는 것이 아닙니다. 지능이 현실에서 작동하기 위해 필요한 조건을 정확히 보려는 것입니다. 훌륭한 배우도 무대와 조명 없이 공연할 수 없듯, 뛰어난 AI 모델도 반도체와 메모리, 전력망과 공급망 없이 작동할 수 없습니다. AI는 소프트웨어의 사건인 동시에 세계 공급망 위에서 벌어지는 물리적 사건입니다.
9.10 에필로그: 지능의 몸을 잊지 않기
연극에서 관객의 눈은 배우에게 먼저 갑니다. 그러나 한 편의 공연은 배우만으로 이루어지지 않습니다. 무대 바닥, 조명, 음향, 의상, 전기, 보이지 않는 스태프의 손길이 함께 있어야 비로소 장면이 살아납니다. AI도 이와 비슷합니다. 화면에 나타나는 문장과 이미지는 배우처럼 눈에 띄지만, 그 뒤에는 반도체와 메모리, 전력과 냉각, 데이터센터와 공급망이라는 무대가 있습니다. 우리는 AI를 ‘클라우드 속 지능’처럼 상상하기 쉽습니다. 그러나 클라우드는 이름만 구름일 뿐, 실제로는 땅 위의 건물과 전력망, 냉각 설비 위에서 작동합니다. AI의 계산은 허공에서 일어나지 않습니다. 칩 안에서 전하가 움직이고, 데이터가 메모리와 연산 장치 사이를 오가며, 소비된 전력은 결국 열로 바뀝니다. 그 열을 식히기 위해 다시 팬과 펌프와 냉각 장치가 움직입니다.
철학은 오래전부터 정신과 몸, 형식과 재료의 관계를 물어 왔습니다. 아름다운 조각은 예술가의 생각만으로 존재하지 않습니다. 대리석의 무게와 결, 끌의 방향과 손의 힘이 함께 있어야 합니다. 악보도 종이 위의 기호에 머물면 음악이 되지 않습니다. 악기의 나무와 현, 연주자의 호흡과 공간의 울림을 만나야 소리가 됩니다. AI의 지능도 마찬가지입니다. 알고리즘이라는 형식은 반도체와 전력, 열관리라는 몸을 만나야 현실에서 작동합니다. 제9강에서 살펴본 흐름은 이 한 가지 사실로 모입니다. 계산은 물리적 과정입니다. AI 모델은 수많은 숫자를 계산하지만, 그 숫자는 메모리에서 읽히고 칩 사이를 이동해야 합니다. 데이터 이동에는 시간과 에너지가 들고, 사용된 에너지는 열로 바뀝니다. 열을 처리하려면 냉각 장치와 데이터센터가 필요하며, 데이터센터는 다시 전력망과 물, 토지와 지역사회에 연결됩니다. AI의 비용은 화면 안에 머물지 않고 물질 세계로 이어집니다.
AI의 몸을 기억한다는 것은 사용할 때마다 더 정확한 질문을 던지자는 뜻입니다. 이 작업에는 얼마나 큰 모델이 필요한가. 더 작은 모델로도 충분한가. 계산은 어디에서 이루어지는가. 전력과 냉각은 어떻게 마련되는가. 그 비용과 부담은 누구에게 돌아가는가. 이런 질문은 AI의 가능성을 줄이는 것이 아니라, 그 가능성을 더 책임 있게 만드는 질문입니다. 인공지능을 신비한 정신처럼만 바라보면 우리는 그 힘을 과장하거나 두려워하기 쉽습니다. 반대로 그것이 몸을 가진 기술임을 알게 되면, 더 차분하게 판단할 수 있습니다. AI는 놀라운 문장을 만들 수 있지만, 그 문장 뒤에는 칩과 전기, 열과 물, 노동과 공급망이 있습니다. AI라는 지능을 떠받치는 세계는 이처럼 결코 가볍지 않습니다.
AI 시대의 물리학적 교양은 화면 너머를 보는 능력입니다. 문장 한 줄과 이미지 한 장 뒤에서 어떤 계산이 일어나고, 어떤 물질과 에너지가 그 계산을 떠받치며, 그 비용이 사회와 환경에 어떻게 나뉘는지를 함께 묻는 일입니다. 지능의 가능성을 인정하면서도 그 몸과 한계를 잊지 않는 것. 그것이 AI를 책임 있게 이해하고 사용하는 출발점입니다.
AI=뇌 아래 연결된 다양한 물질=몸
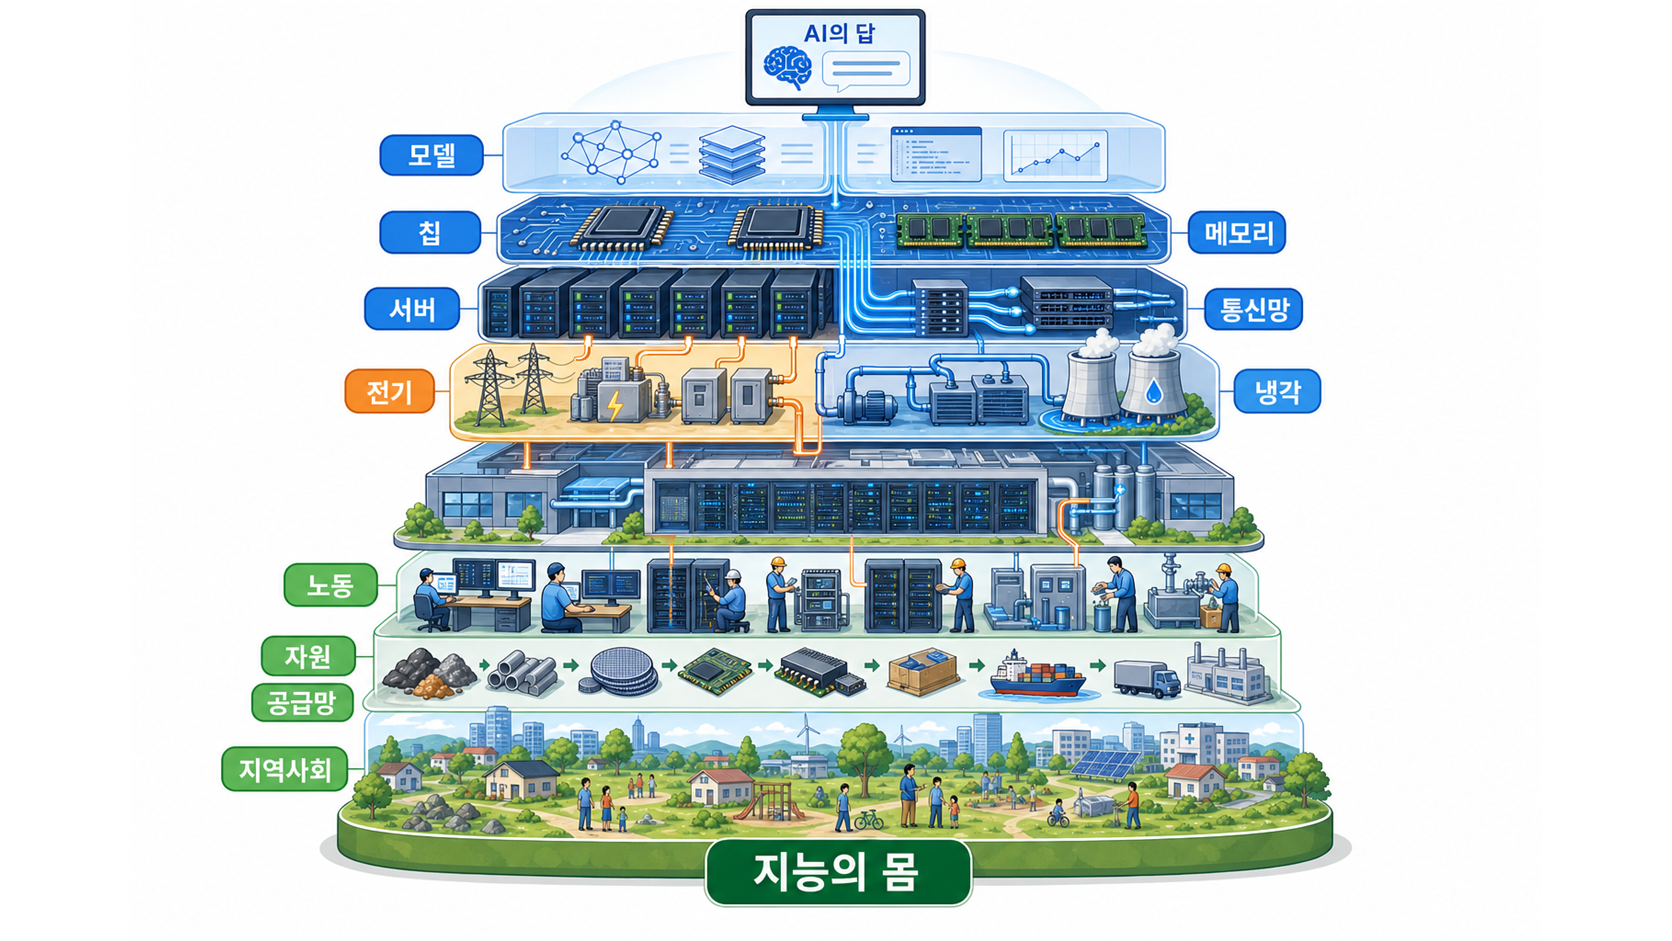
AI를 이해한다는 것은 그 대답만 보는 것이 아니라, 그 대답을 가능하게 하는 물질적 몸까지 보는 일입니다.
제10강. AI 자동화 실험
옷감에 색을 입히는 장인은 처음부터 원하는 빛깔을 얻지 못합니다. 작은 천 조각을 먼저 물들여 보고, 온도와 시간을 바꾸며 결과를 다시 확인합니다. 과학 실험도 이와 비슷합니다. 이론과 계산이 결과를 예측하더라도 실제 물질은 온도, 압력, 시료의 순도, 장비 상태에 따라 다르게 반응합니다. 실험실은 가설이 물질과 만나 검증되는 장소입니다. 과학적 발견은 질문을 세우고, 실험하고, 측정하고, 그 결과를 다시 다음 실험에 반영하는 순환 속에서 이루어집니다. AI는 이 순환을 빠르게 돌리는 데 도움을 줄 수 있습니다. 많은 실험 기록과 논문을 비교해 유망한 후보를 찾고, 다음에 시험할 조건의 우선순위를 정하며, 측정 결과에서 중요한 패턴을 표시할 수 있습니다.
이번 강의의 중심 주제는 자동화 실험실입니다. AI가 로봇, 센서, 측정 장비와 연결되어 시료를 다루고, 실험을 실행하며, 결과를 기록하고, 다음 조건을 제안하는 과정입니다. 그러나 자동화 실험실은 사람 없이 모든 것을 판단하는 ‘인공 과학자’가 아닙니다. 사람은 목표와 안전 기준을 정하고, AI와 로봇은 그 범위 안에서 반복과 탐색을 수행합니다. 자동화 실험실의 핵심은 로봇 한 대가 아니라 질문–실험–측정–학습이 이어지는 순환입니다. 이번 강의에서는 AI가 어떻게 실험의 손과 눈을 확장하고, 과학적 탐색의 속도와 정밀도를 바꾸는지 살펴보겠습니다.
자동화 실험실의 순환형 과학
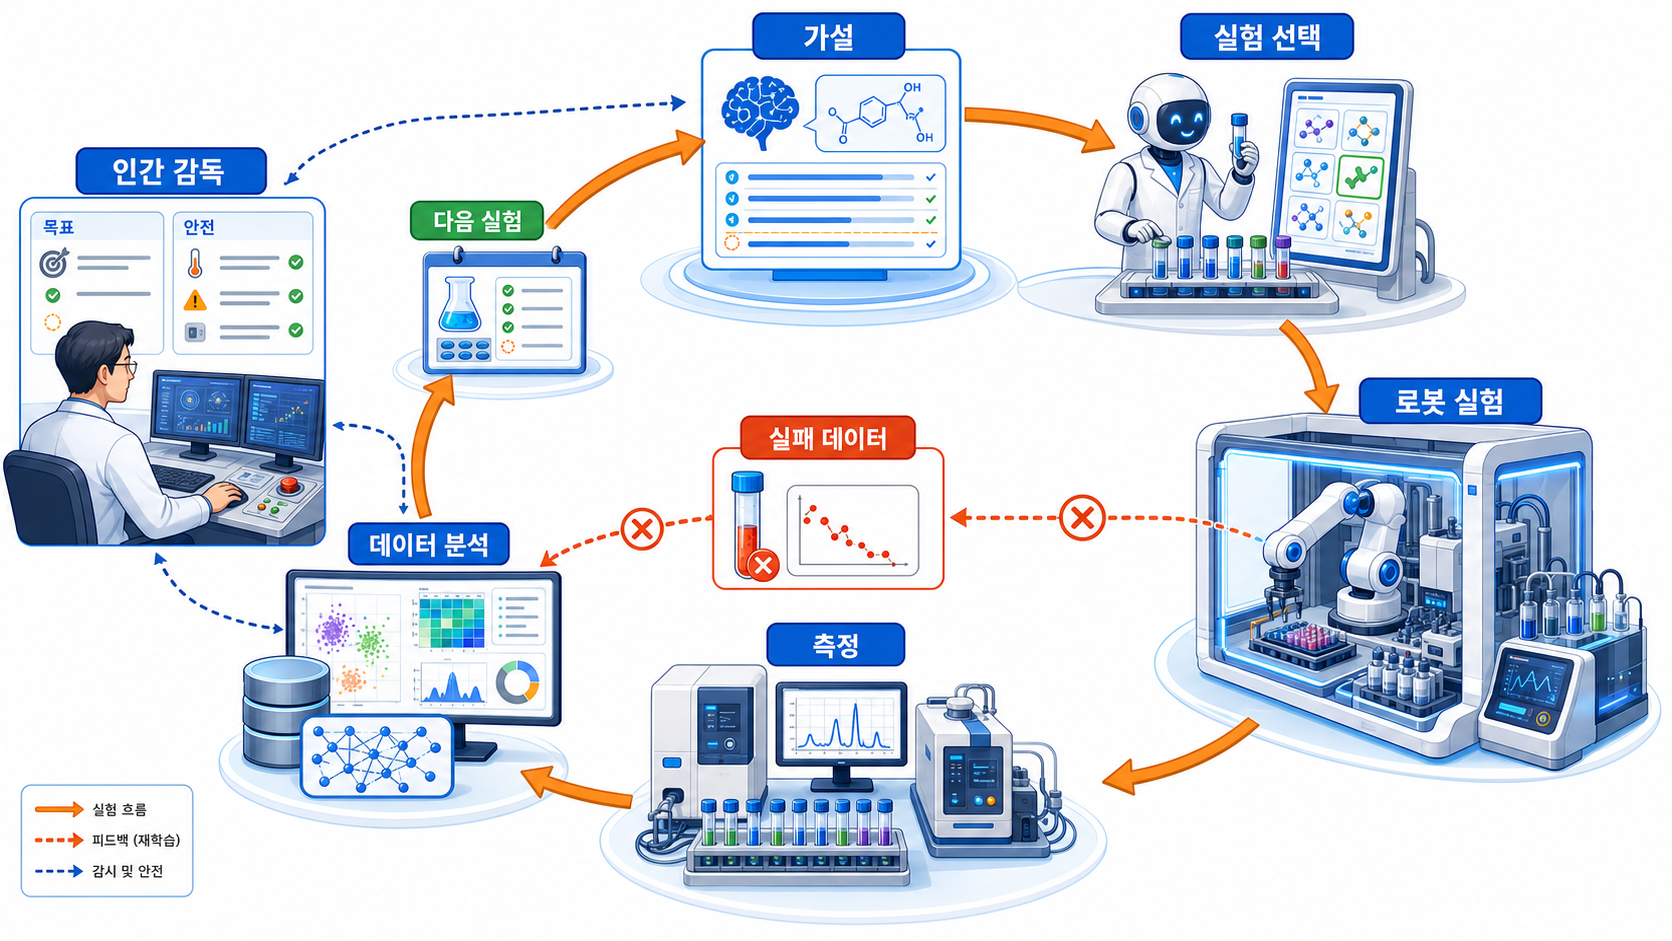
(이 장에 반복해서 등장하는 아틀라스는 최신 전기식 휴머노이드의 외형을 참고해 만든 교육용 안내자입니다.)
10.1 실험은 왜 반복의 예술인가
새 만년필로 글씨를 쓰면 종이의 결, 펜촉의 각도, 손의 압력, 잉크의 양이 조금만 달라도 획이 달라집니다. 같은 글자를 여러 번 쓰며 조건을 조절하다 보면 어느 순간 선이 안정됩니다. 반복은 같은 일을 무의미하게 되풀이하는 것이 아니라, 결과를 바꾸는 조건을 알아 가는 과정입니다.
과학 실험도 한 번의 결과로 끝나지 않습니다. 같은 조건에서 다시 해 보았을 때 비슷한 결과가 나오는지 확인해야 합니다. 이렇게 같은 연구자가 같은 장비와 조건에서 실험했을 때 결과가 안정적으로 나타나는지를 반복성(repeatability)이라고 합니다. 반복성이 높을수록 그 결과가 우연한 흔들림이 아닐 가능성이 커집니다. 하지만 과학은 한 연구실 안에서만 끝나지 않습니다. 다른 연구자나 다른 실험실이 같은 방법으로 실험했을 때도 비슷한 결과가 나와야 합니다. 이를 재현성(reproducibility)이라고 합니다. 반복성이 한 연구실 안의 안정성을 묻는다면, 재현성은 그 결과가 더 넓은 과학 공동체에서도 다시 확인될 수 있는지를 묻습니다.
반복 실험이 만드는 패턴
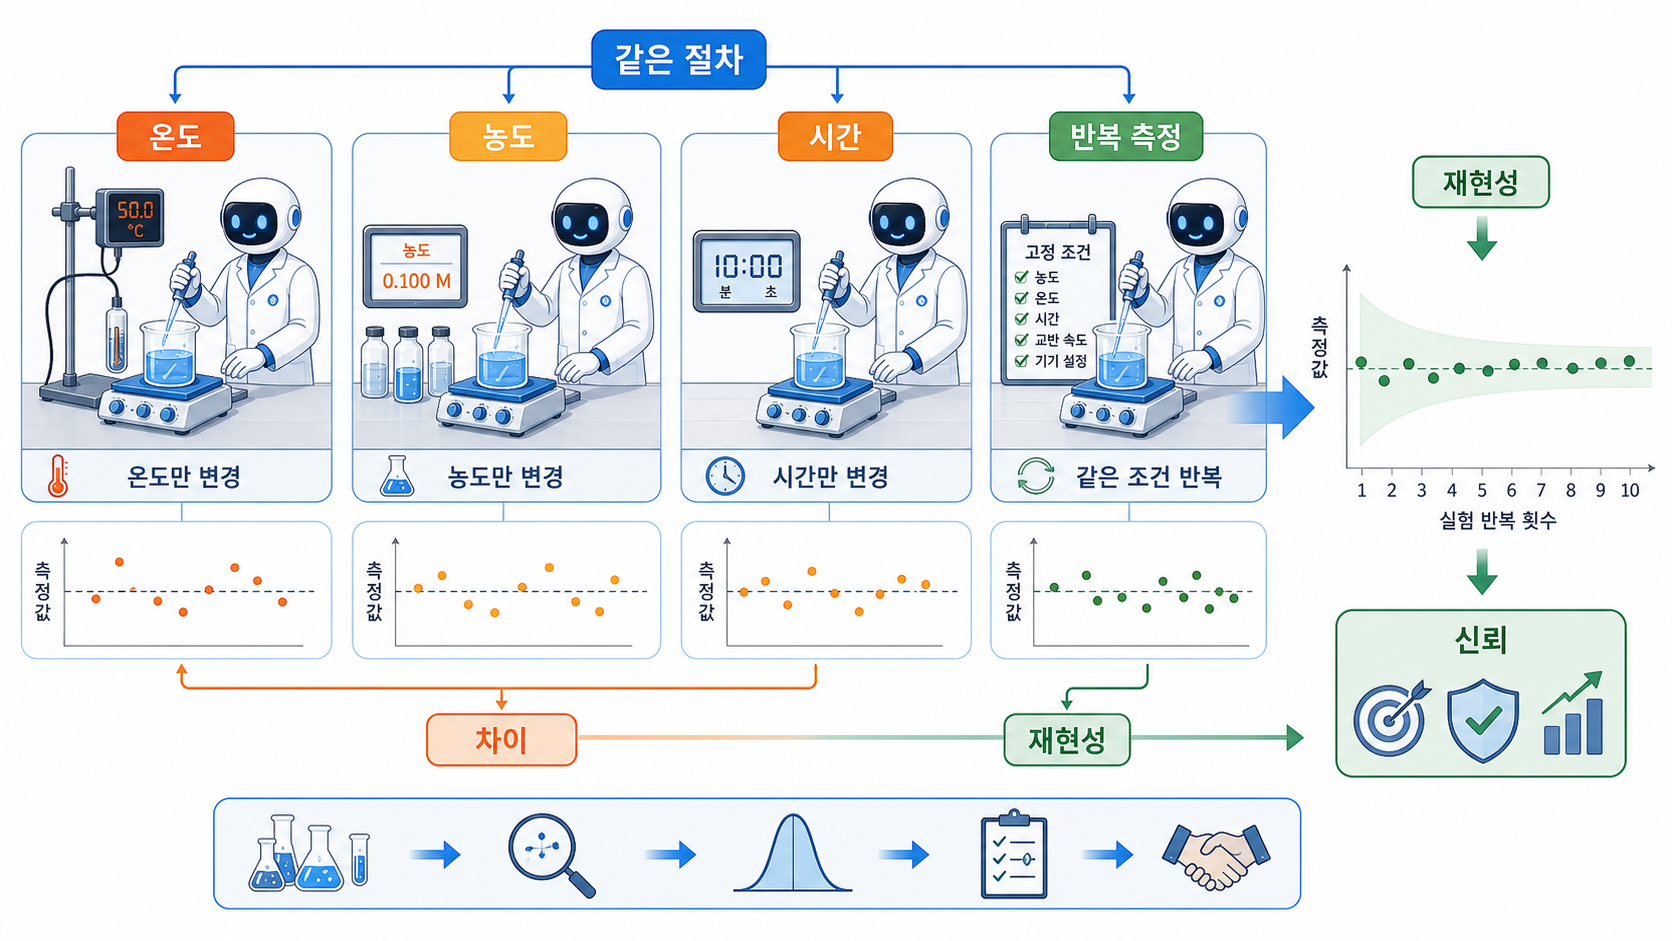
아틀라스가 조건을 조금씩 바꾸어 실험하는 장면은 실험이 한 번에 정답을 맞히는 일이 아니라, 반복 속에서 차이와 규칙을 찾는 과정임을 보여 줍니다.
실험 결과는 언제나 조금씩 흔들립니다. 시료의 미세한 차이, 장비의 오차, 온도와 습도의 변화가 결과에 영향을 줄 수 있습니다. 따라서 반복 실험은 모든 값이 완전히 똑같아지는지를 확인하는 일이 아닙니다. 결과가 어느 범위에서 흔들리는지, 그 흔들림이 설명 가능한지 확인하는 과정입니다.
자동화 실험실은 이 반복의 속도와 일관성을 높일 수 있습니다. 사람이 하루에 몇 번밖에 하지 못하는 작업을 로봇은 정해진 절차에 따라 장시간 반복할 수 있습니다. 액체를 일정량 옮기고, 시료를 나누고, 온도를 조절하고, 반응 시간을 기록하는 일처럼 피로와 실수의 영향을 받기 쉬운 작업에서 특히 유용합니다. AI는 여기서 반복의 방향을 정하는 데 도움을 줍니다. 이전 실험 결과를 분석해 어떤 조건을 다음에 시험할지 제안하고, 측정값에서 이상한 패턴을 찾아내며, 성공과 실패의 기록을 바탕으로 탐색 범위를 좁힐 수 있습니다. 자동화 실험실에서 AI의 역할은 실험을 대신 이해하는 것이 아니라, 반복 실험을 더 효율적인 탐색으로 바꾸는 데 있습니다.
그러나 자동화가 곧 신뢰성을 보장하는 것은 아닙니다. 로봇의 보정이 잘못되면 틀린 양을 계속 옮길 수 있고, 센서가 오염되면 잘못된 값을 일관되게 기록할 수 있습니다. 자동화는 우연한 실수를 줄일 수 있지만, 잘못 설정된 절차를 더 빠르게 반복할 위험도 있습니다. 그래서 장비의 보정 상태, 시료의 위치, 측정값의 이상 여부를 계속 점검해야 합니다. 반복 실험의 가치는 횟수보다 기록에서 나옵니다. 어떤 시료를 썼는지, 어느 장비를 사용했는지, 온도와 압력을 어떻게 조절했는지, 어떤 순서로 처리했는지가 남아야 합니다. “조금 데웠다”거나 “색이 진해졌다”는 표현만으로는 다른 연구자도, 기계도 같은 실험을 되풀이하기 어렵습니다.
그래서 자동화 실험실은 과학의 언어를 더 정밀하게 만들도록 요구합니다. 시료와 장비에 일관된 이름을 붙이고, 단위와 측정 형식을 통일하며, 성공한 결과뿐 아니라 실패와 중단의 이유도 기록해야 합니다. 자동화의 핵심 자산은 로봇의 움직임만이 아니라, 그 움직임과 결과를 연결하는 데이터입니다. 실험을 많이 한다고 좋은 과학이 자동으로 만들어지는 것은 아닙니다. 잘못된 질문을 빠르게 반복하면 잘못된 방향으로 더 멀리 갈 수 있습니다. 따라서 자동화 실험에서 속도보다 먼저 정해야 할 것은 질문입니다. 무엇을 알고 싶은지, 어떤 조건을 바꿀 것인지, 무엇을 일정하게 유지할 것인지, 어떤 결과를 성공으로 볼 것인지가 분명해야 합니다.
자동화 실험실은 부지런한 조수에 그치지 않습니다. 자연에 질문을 반복해서 던지고, 그 응답의 차이를 기록하며, 다음 질문을 더 정밀하게 만드는 장치입니다. 반복을 과학으로 만드는 것은 실험 횟수가 아니라 질문의 방향, 측정의 신뢰성, 그리고 결과를 다음 실험으로 연결하는 능력입니다.
10.2 로봇 실험실의 기본 구조
자동화 실험실을 떠올리면 먼저 로봇 팔이 생각나기 쉽습니다. 그러나 실제 자동화 실험실은 로봇 하나가 아니라 여러 장치와 소프트웨어가 연결된 실험 시스템입니다. 시료를 준비하고, 반응 조건을 맞추고, 결과를 측정하고, 데이터를 저장하며, 다음 실험을 고르는 과정이 하나의 흐름으로 이어져야 합니다. 이 구조는 악기 하나보다 합주단에 가깝습니다. 액체 취급 장치는 시약을 정확히 옮기고, 반응기와 배양기는 온도와 압력을 유지합니다. 현미경과 분광기, 전기적 측정 장비는 실험 결과를 읽습니다. 데이터 시스템은 어떤 시료가 어떤 조건을 거쳤고 어떤 결과를 냈는지 연결해 기록합니다. 어느 한 장치가 뛰어나도 서로 박자가 맞지 않으면 실험은 멈춥니다.
자동화 실험실은 정밀한 실험 생태계
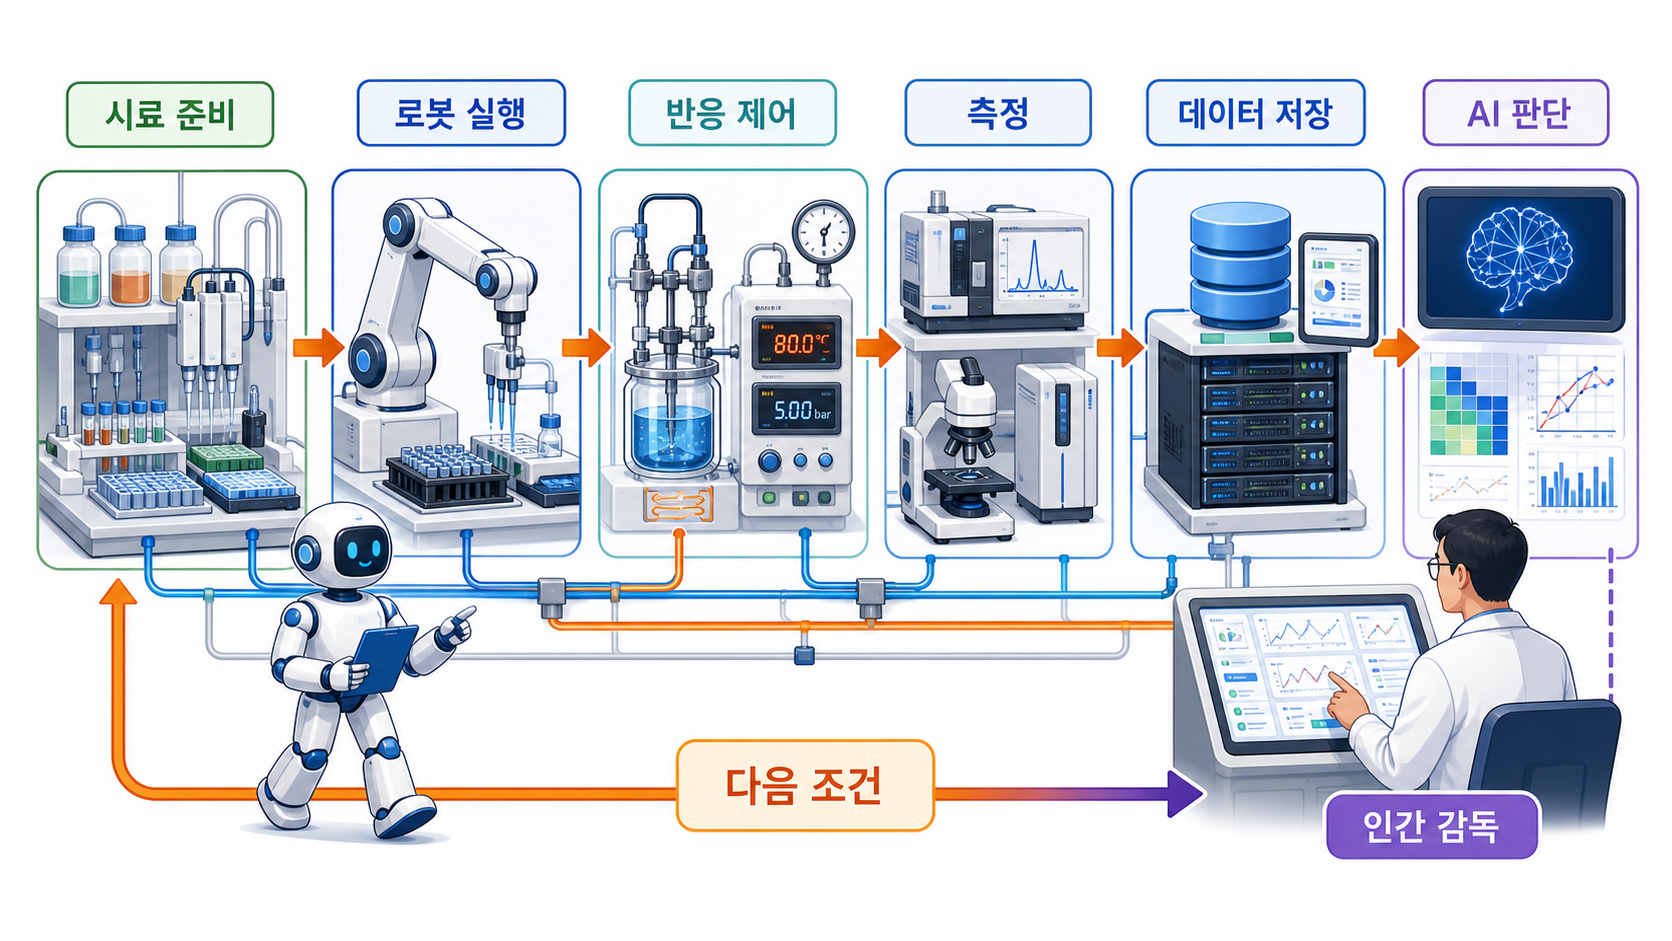
아틀라스는 시료 준비에서 반응과 측정, 기록으로 이어지는 자동화 라인을 지나며 로봇 실험실이 여러 장치가 연결된 하나의 시스템임을 보여 줍니다.
자동화 실험의 기본 흐름은 네 단계로 볼 수 있습니다. 첫째, 어떤 시료와 시약을 사용할지, 온도와 시간은 어느 범위로 둘지 정합니다. 둘째, 로봇과 장비가 계획에 따라 시료를 섞고 가열하거나 냉각하며 실험을 실행합니다. 셋째, 색, 질량, 이미지, 스펙트럼, 전기적 특성 같은 결과를 측정하고 기록합니다. 넷째, AI가 결과를 분석해 다음에 시험할 조건을 제안합니다. 이 과정이 다시 첫 단계로 돌아가면 실험 순환이 만들어집니다. 자동화 실험실의 핵심에는 현재 상태를 보고 다음 행동을 조정하는 원리가 있습니다. 난방 장치는 방의 온도를 재고, 목표 온도보다 낮으면 출력을 높이고, 목표에 가까워지면 출력을 낮춥니다. 이렇게 결과를 확인해 다음 행동을 바꾸는 과정을 피드백(feedback)이라고 합니다. 자동화 실험실도 실험 결과를 보고 다음 조건을 바꿉니다. 다만 목표는 단순히 온도를 맞추는 것보다 복잡합니다. 더 좋은 성능을 찾거나, 어떤 변수가 결과를 바꾸는지 알아내거나, 예측의 불확실성을 줄이려 합니다.
AI가 들어오면 이 피드백은 단순한 반복을 넘어섭니다. AI는 지금까지 가장 좋은 결과가 나온 조건 주변을 더 자세히 살필지, 아직 자료가 부족한 새로운 영역을 시험할지 제안할 수 있습니다. 즉 AI의 역할은 로봇에게 “계속 반복하라”고 명령하는 데 있지 않습니다. 어떤 반복이 더 많은 정보를 줄지 판단하도록 돕는 데 있습니다. 이때 중요한 것은 장비를 원하는 상태로 안정적으로 움직이는 일입니다. 로봇이 시약을 정해진 양만큼 옮기고, 반응기가 온도와 압력을 일정 범위 안에 유지하며, 측정 장비가 정해진 방식으로 값을 읽어야 합니다. 이렇게 실험 장치를 목표한 조건에 맞게 작동시키는 과정을 제어(control)라고 합니다. 좋은 자동화 실험실은 제어가 안정적이고, 피드백이 정확하게 이어지는 실험실입니다.
그러나 장비가 연결되고 AI가 다음 조건을 제안한다고 해서 완전한 자율 과학자가 탄생하는 것은 아닙니다. 연구 목표, 안전 범위, 사용할 물질, 허용할 온도와 압력, 측정값의 품질 기준은 사람이 정해야 합니다. 예상하지 못한 상황에서 실험을 멈추거나 계획을 바꾸는 책임도 여전히 인간에게 있습니다. 안전은 자동화 실험실의 부가 기능이 아닙니다. 충돌, 누출, 과열, 압력 상승, 독성 물질 노출, 잘못된 시료 혼합을 감지하는 장치가 필요합니다. 위험한 조건으로 접근하면 AI의 판단과 관계없이 실험을 멈추는 물리적 안전장치도 있어야 합니다. 빠른 실험보다 먼저 필요한 것은 안전하게 멈출 수 있는 실험입니다.
데이터 연결도 중요합니다. 시료 이름이 잘못 붙거나 용기의 위치가 바뀌면 측정값 전체가 다른 시료와 연결될 수 있습니다. 장비마다 단위와 파일 형식이 다르면 결과를 비교하기 어렵습니다. 자동화 실험실의 신뢰성은 로봇의 정밀도뿐 아니라 시료와 데이터의 추적 가능성에 달려 있습니다. 최근의 피지컬 AI(physical AI)는 카메라와 센서로 실험대의 상황을 파악하고, 언어 지시를 로봇 행동으로 바꾸는 데 활용될 수 있습니다. 예를 들어 병과 장비를 구분하고, 시료를 옮기며, 예상하지 못한 장애물을 피하도록 도울 수 있습니다. 그러나 모든 기능을 하나의 거대한 모델이 처리할 필요는 없습니다. 실험 계획, 로봇 제어, 안전 감시, 데이터 분석은 서로 다른 속도와 정확도를 요구하므로 여러 시스템이 역할을 나누는 편이 더 현실적입니다.
로봇의 형태도 작업에 맞아야 합니다. 사람이 쓰는 문과 선반, 손잡이를 다뤄야 한다면 이동형 로봇이나 양팔 로봇이 유리할 수 있습니다. 반면 수천 개의 시료에 미세한 양의 액체를 빠르게 나누는 작업에는 전용 액체 취급 장치가 더 정확하고 효율적입니다. 자동화의 목표는 사람 모양의 로봇을 만드는 것이 아니라, 과학적 질문에 가장 알맞은 장치와 센서를 연결하는 데 있습니다. 결국 로봇 실험실의 힘은 화려한 동작에서 나오지 않습니다. 계획, 실행, 측정, 기록, 분석, 안전이 끊어지지 않고 이어질 때 나타납니다. 자동화 실험실을 평가하는 기준도 로봇의 외형이 아니라, 이 순환이 얼마나 정확하고 투명하게 작동하는가에 있어야 합니다.
10.3 능동학습과 베이지안 최적화
넓은 해변에서 반짝이는 돌을 찾는다고 생각해 봅시다. 이미 좋은 돌이 나온 곳 주변을 더 자세히 살펴볼 수도 있고, 아직 가 보지 않은 곳을 새로 탐색할 수도 있습니다. 익숙한 곳만 파면 더 좋은 장소를 놓칠 수 있고, 새로운 곳만 돌아다니면 유망한 지점을 충분히 조사하지 못합니다. 좋은 탐색에는 이미 좋아 보이는 곳을 더 살피는 일과, 아직 모르는 곳을 시험하는 일 사이의 균형이 필요합니다. 과학 실험도 마찬가지입니다. 온도, 압력, 농도, 시간, 촉매, 용매의 조합은 너무 많아서 모두 시험하기 어렵습니다. 실험에는 시약과 장비, 시간과 안전 비용이 듭니다. 따라서 중요한 문제는 “무엇을 모두 해 볼 것인가”가 아니라, “다음에 무엇을 해 보면 가장 많이 배울 수 있는가”입니다.
능동학습과 베이지안 최적화
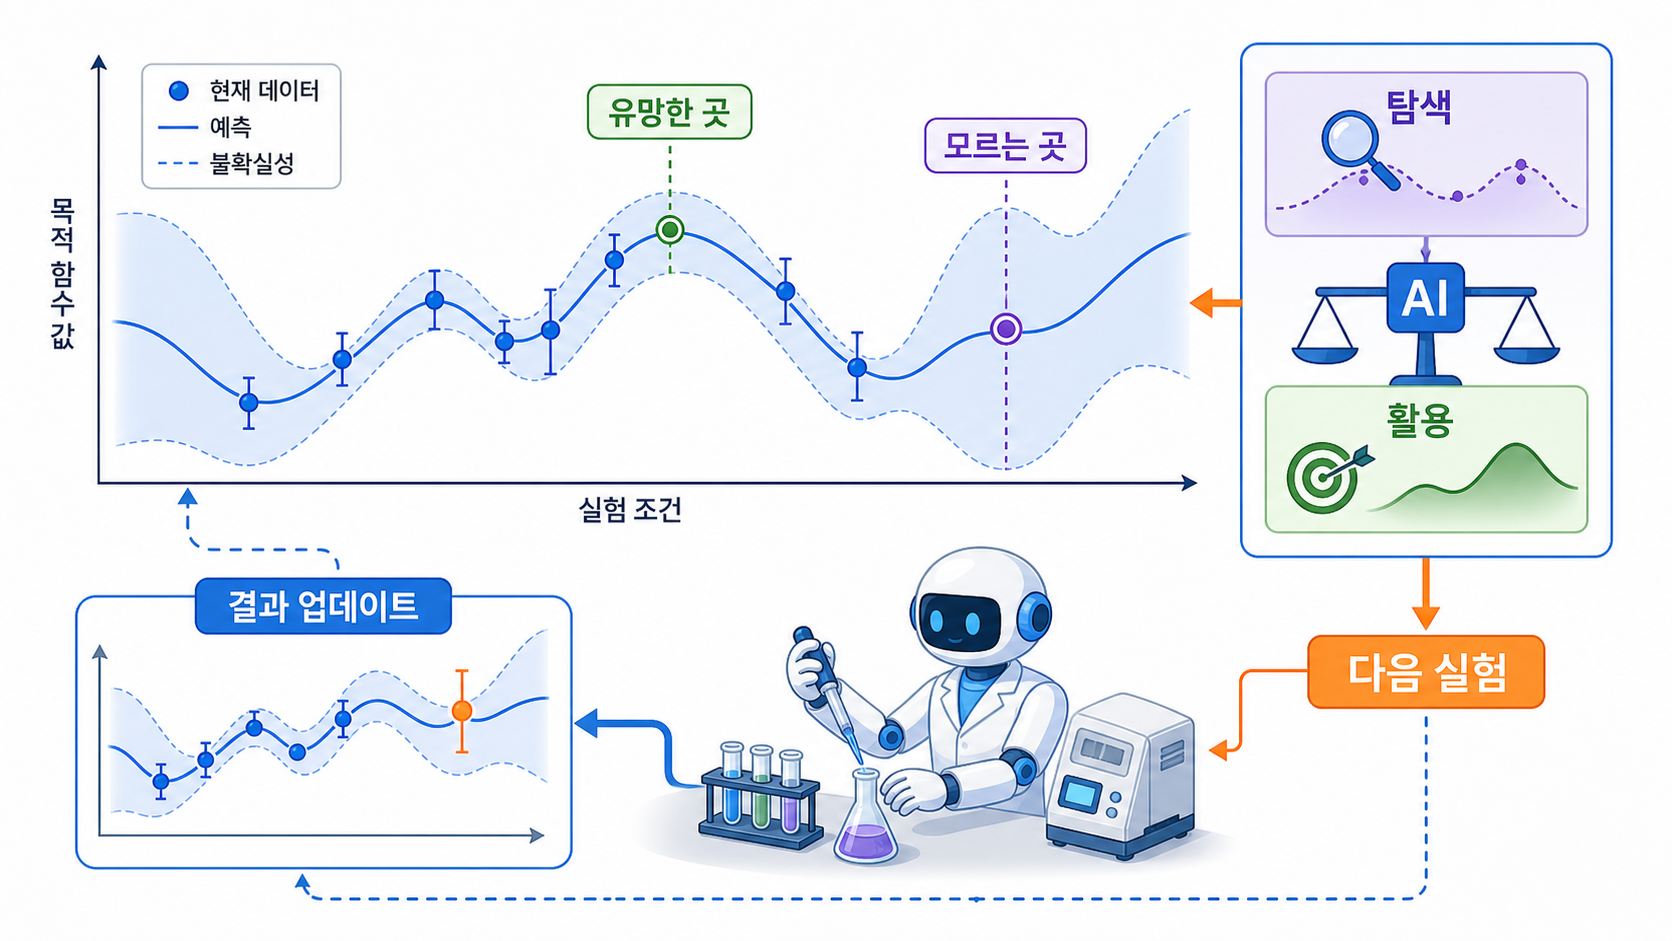
아틀라스는 AI가 제안한 다음 후보를 실험합니다. 자동화 실험실의 알고리즘은 좋은 결과가 예상되는 조건과 아직 불확실한 조건을 비교해 다음 실험을 선택합니다.
AI는 이 선택을 돕는 도구가 될 수 있습니다. 지금까지의 실험 결과를 바탕으로 아직 정보가 부족한 조건, 성능이 좋아 보이는 조건, 또는 두 가능성을 구분해 줄 조건을 제안합니다. 모델이 스스로 필요한 데이터를 골라 더 배우려는 접근을 능동학습(active learning)이라고 합니다. 이미 주어진 데이터만 학습하는 것이 아니라, 다음에 어떤 데이터를 얻으면 더 똑똑해질지를 묻는 방식입니다. 예를 들어 새로운 물질의 이미지를 분류하는 AI가 있다고 해 봅시다. 이미 확실히 아는 시료를 반복해서 보여 주기보다, AI가 헷갈려 하는 시료를 전문가에게 먼저 확인하게 하면 더 적은 데이터로 성능을 높일 수 있습니다. 능동학습의 핵심은 가장 좋은 조건을 바로 찾는 데만 있지 않습니다. 모델이 더 잘 배우도록, 가장 정보가 큰 다음 자료를 고르는 데 있습니다.
실험 목표가 “가장 좋은 조건을 찾는 것”이라면 조금 다른 접근이 필요합니다. 실제 실험을 모두 해 보는 대신, 지금까지의 결과로 대략적인 지도를 먼저 그리고 그 지도를 보며 다음 실험을 고릅니다. 이런 방식이 베이지안 최적화(Bayesian optimization)입니다. 평가에 비용이 많이 드는 실험에서 적은 횟수로 좋은 조건을 찾는 데 자주 사용됩니다. 베이지안 최적화에서는 실제 실험을 대신해 조건과 결과의 관계를 어림하는 계산 모델을 만듭니다. 이를 대리모형(surrogate model)이라고 합니다. 대리모형은 “이 조건에서는 성능이 이 정도일 것 같다”는 예상뿐 아니라 “이 예상이 얼마나 불확실한가”도 함께 보여 줍니다. 말하자면 실제 지형을 모두 걸어 보지 않고, 지금까지의 발자국으로 임시 지도를 그리는 셈입니다.
그다음에는 이 임시 지도를 보고 다음에 어디를 시험할지 정해야 합니다. 이미 성능이 높아 보이는 곳을 더 확인할 수도 있고, 불확실성이 커서 새로운 정보를 많이 줄 곳을 선택할 수도 있습니다. 이 선택 기준을 획득함수(acquisition function)라고 합니다. 획득함수는 좋은 결과가 기대되는 곳과 아직 모르는 곳 사이에서 균형을 잡도록 돕습니다. 실험 조건들이 이루는 전체 가능성의 범위를 탐색 공간(search space)이라고 합니다. 온도, 압력, 농도, 반응 시간, 촉매, 용매가 각각 하나의 축이 될 수 있습니다. 축이 많아질수록 탐색 공간은 빠르게 커집니다. AI는 이 넓은 공간을 모두 아는 것이 아닙니다. 일부 실험 결과를 바탕으로 불완전한 지도를 만들고, 다음 실험으로 그 지도를 가장 유용하게 고치려는 것입니다.
자동화 실험실에서는 이 과정이 하나의 닫힌 순환을 이룹니다. AI가 다음 조건을 제안하고, 로봇이 실험을 수행하며, 측정 장비가 결과를 기록합니다. 그 결과는 다시 모델을 갱신하고, AI는 다음 조건을 다시 고릅니다. 이 순환이 잘 작동하면 무작정 많은 실험을 하는 것보다 적은 횟수로 유망한 영역을 찾을 수 있습니다. 하지만 AI가 항상 좋은 다음 실험을 고르는 것은 아닙니다. 초기 데이터가 한쪽에 치우쳐 있으면 모델도 편향될 수 있습니다. 실제 관계가 복잡한데 대리모형이 지나치게 단순하면 중요한 영역을 놓칠 수 있습니다. 측정 오류를 실제 패턴으로 잘못 배우면 틀린 조건을 계속 추천할 수도 있습니다.
목표를 어떻게 정하는지도 중요합니다. 반응 수율 하나만 높이도록 설정하면 독성, 원료 비용, 장기 안정성, 재현성을 희생한 조건을 고를 수 있습니다. 실제 과학과 공학에서는 성능뿐 아니라 안전성, 비용, 환경 영향, 반복 가능성을 함께 고려해야 합니다. 좋은 최적화는 하나의 숫자를 높이는 일이 아니라, 여러 조건 사이에서 쓸 만한 균형을 찾는 일입니다. 안전 범위도 처음부터 정해야 합니다. AI가 정보 가치가 높다고 판단하더라도 장비의 허용 온도와 압력을 넘거나 위험한 반응이 예상되는 조건은 시험해서는 안 됩니다. 안전은 실험을 하다 보면 알게 되는 선택지가 아니라, 탐색 전에 정해 두어야 할 경계입니다.
실패 기록도 중요합니다. 시료가 만들어지지 않았거나 측정이 실패한 결과를 단순히 지워 버리면, AI는 그 조건의 어려움과 위험을 배우지 못합니다. 다만 장비 고장과 실제 물질의 실패는 원인이 다르므로 구별해 기록해야 합니다. 자동화 실험실에서 실패는 쓰레기 데이터가 아니라, 다음 실험을 더 똑똑하게 만드는 정보가 될 수 있습니다. 결국 능동학습과 베이지안 최적화는 AI가 정답을 미리 알고 있다는 뜻이 아닙니다. 불완전한 지식 속에서 다음에 무엇을 물어야 할지 더 합리적으로 고르는 방법입니다. 자동화 실험실의 지능은 알고리즘 혼자서 생기지 않습니다. 좋은 목표, 안전한 탐색 범위, 신뢰할 수 있는 측정, 실패까지 포함한 기록이 함께 있을 때 AI는 실험의 반복을 발견의 순환으로 바꿀 수 있습니다.
10.4 실패한 실험의 가치
새 열쇠를 맞출 때는 자물쇠에 들어맞지 않는 홈도 중요한 정보를 줍니다. 어느 부분이 걸리는지, 어느 홈이 너무 깊은지 알수록 가능한 모양의 범위가 좁아집니다. 성공한 열쇠 하나를 찾는 과정은 맞지 않는 수많은 형태를 지워 나가는 과정이기도 합니다. 과학 실험도 마찬가지입니다. 반응이 일어나지 않은 결과, 원하는 결정이 만들어지지 않은 결과, 세포가 예상보다 일찍 죽은 결과, 측정 신호가 너무 약했던 결과도 잘 기록하면 지식이 됩니다. 어떤 조건에서 현상이 나타나지 않는지를 알면 다음 실험에서 피해야 할 영역과 더 자세히 살펴야 할 경계를 구분할 수 있습니다.
실패한 결과까지 학습하는 AI 실험실
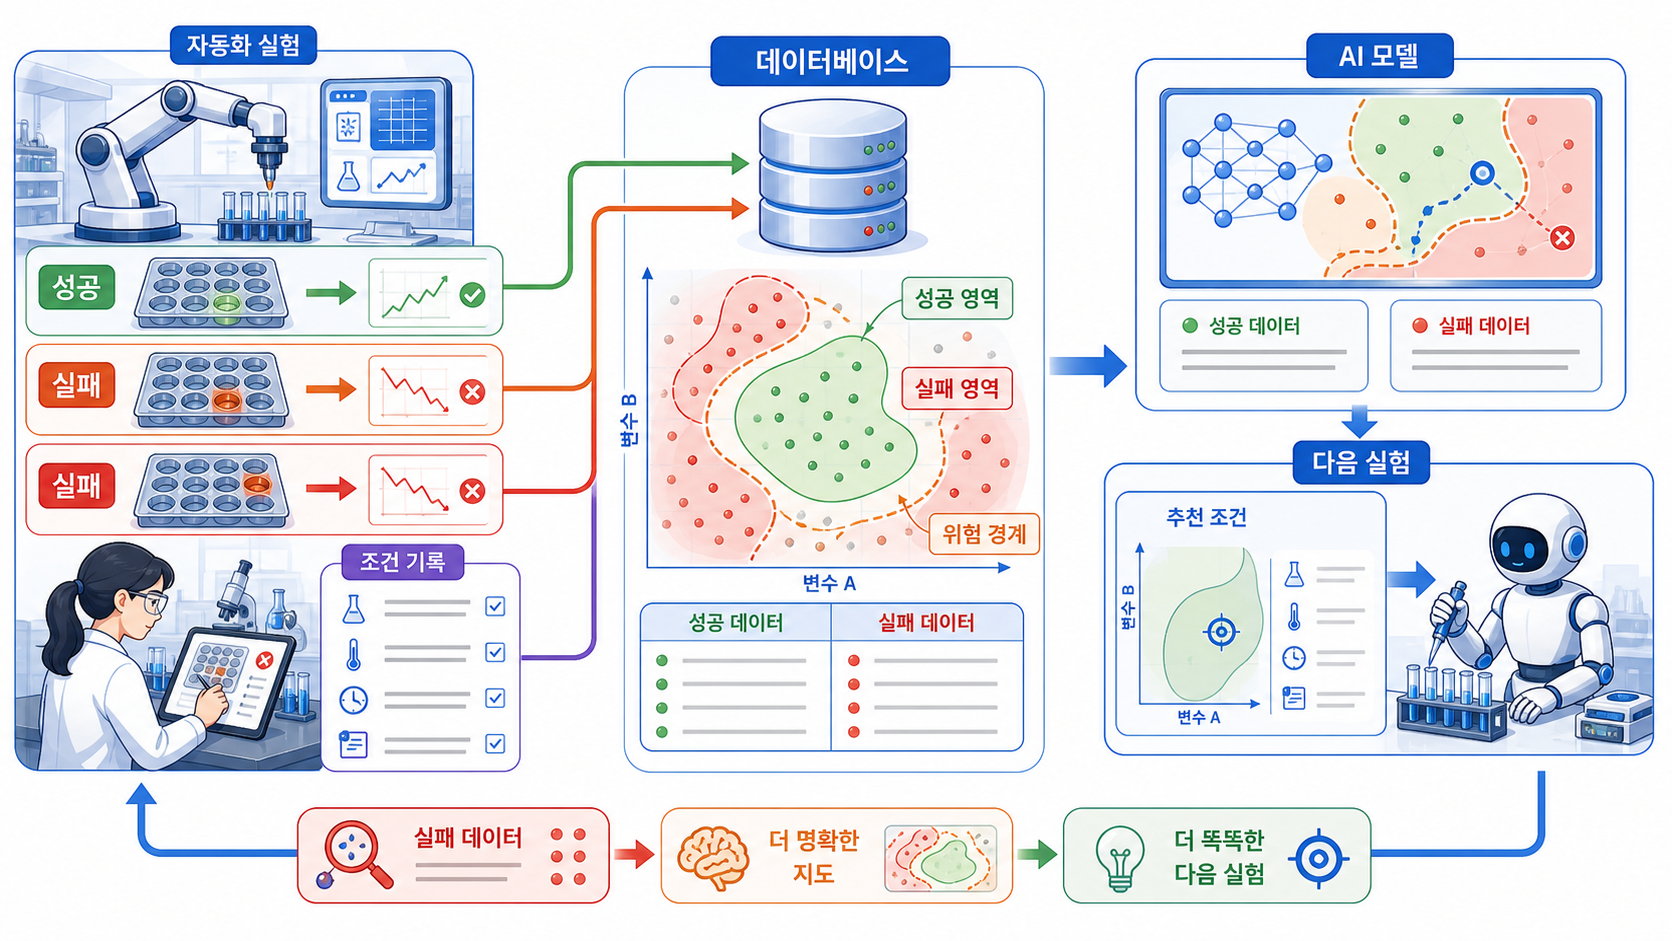
아틀라스는 기대한 결과가 나오지 않은 실험도 원인과 조건을 구분해 기록합니다. 실패는 다음 실험의 탐색 범위를 조정하는 중요한 데이터가 됩니다.
AI가 실험 데이터를 학습할 때 실패 기록은 특히 중요합니다. 성공한 사례만 모인 데이터에서는 실제보다 성공 가능성이 높게 보입니다. AI는 어떤 조건이 좋은 결과를 만드는지는 배울 수 있지만, 어디에서 반응이 멈추고 성능이 무너지며 위험이 커지는지는 알기 어렵습니다. 실패 데이터는 이런 지나친 낙관을 교정합니다. 예를 들어 특정 온도에서 원하는 결정 구조가 만들어지지 않았다는 기록은 재료 탐색 모델이 그 조건을 피하거나 다른 조성과 함께 다시 시험하도록 돕습니다. 특정 용매에서 부산물이 반복해서 생겼다면 그 반응 조건의 한계를 알 수 있습니다. 어떤 농도에서 세포 독성이 나타났다면 생명 실험의 안전한 범위를 정하는 데 도움이 됩니다.
다만 모든 실패가 같은 뜻을 갖는 것은 아닙니다. 자연이 “이 조건에서는 일어나지 않는다”고 답한 경우와, 장비 고장이나 시료 혼동 때문에 결과를 믿기 어려운 경우는 구별해야 합니다. 전자는 과학적 정보가 될 수 있지만, 후자는 실험 절차에 관한 경고에 가깝습니다. 그래서 실패는 원인에 따라 나누어 기록해야 합니다. 실제로 반응이 일어나지 않은 결과, 목표 성능에 미치지 못한 결과, 측정 한계 때문에 신호를 확인하지 못한 결과, 장비 이상이나 오염으로 신뢰하기 어려운 결과, 안전 문제로 중단한 결과는 서로 다른 데이터입니다. 이런 구분이 있어야 AI도 실패의 의미를 잘못 배우지 않습니다.
자동화 실험실은 실패 기록을 체계화하는 데 강점을 가질 수 있습니다. 실험이 진행되는 동안 시약과 시료 정보, 장비 상태, 온도와 시간, 측정값, 중단 사유를 자동으로 남길 수 있기 때문입니다. 기대한 결과가 나오지 않았더라도 무엇이 언제 어떻게 일어났는지 추적할 수 있습니다. 하지만 기록이 많다고 좋은 데이터가 되는 것은 아닙니다. 측정값의 품질, 장비의 신뢰도, 검출 한계, 실패 원인을 함께 남겨야 합니다. 좋은 실패 데이터는 단순히 “실패”라고 표시된 항목이 아니라, 왜 실패했는지 해석할 수 있는 문맥을 가진 기록입니다.
실패가 기록되지 않으면 여러 연구실이 이미 막힌 길을 반복해서 걸을 수 있습니다. 성공한 결과만 남는 문화에서는 어떤 조건이 작동하지 않았는지 알기 어렵습니다. 실패 조건을 적절히 공유하면 다른 연구자는 같은 시행착오를 줄이고, 더 유망한 방향으로 실험을 이어 갈 수 있습니다. 물론 모든 실패 기록을 그대로 공개할 수는 없습니다. 산업 기밀이나 개인정보가 포함될 수 있고, 위험한 생물·화학 실험의 세부 조건은 오용될 가능성도 있습니다. 중요한 것은 실패를 감추지 않되, 그 의미와 위험에 맞는 방식으로 남기고 공유하는 일입니다.
자동화 실험실은 성공을 빠르게 찾는 장치인 동시에 실패를 정확히 보존하는 장치여야 합니다. 자연은 성공한 결과로만 말하지 않습니다. 때로는 “이 조건에서는 일어나지 않는다”는 응답으로 가능성의 경계를 알려 줍니다. 실패는 버려야 할 흔적이 아니라, AI가 더 정확한 탐색 지도를 그리기 위해 필요한 빈칸입니다.
10.5 재료·화학·생명 실험의 자동화
분야에 맞는 실험의 손을 설계하는 AI
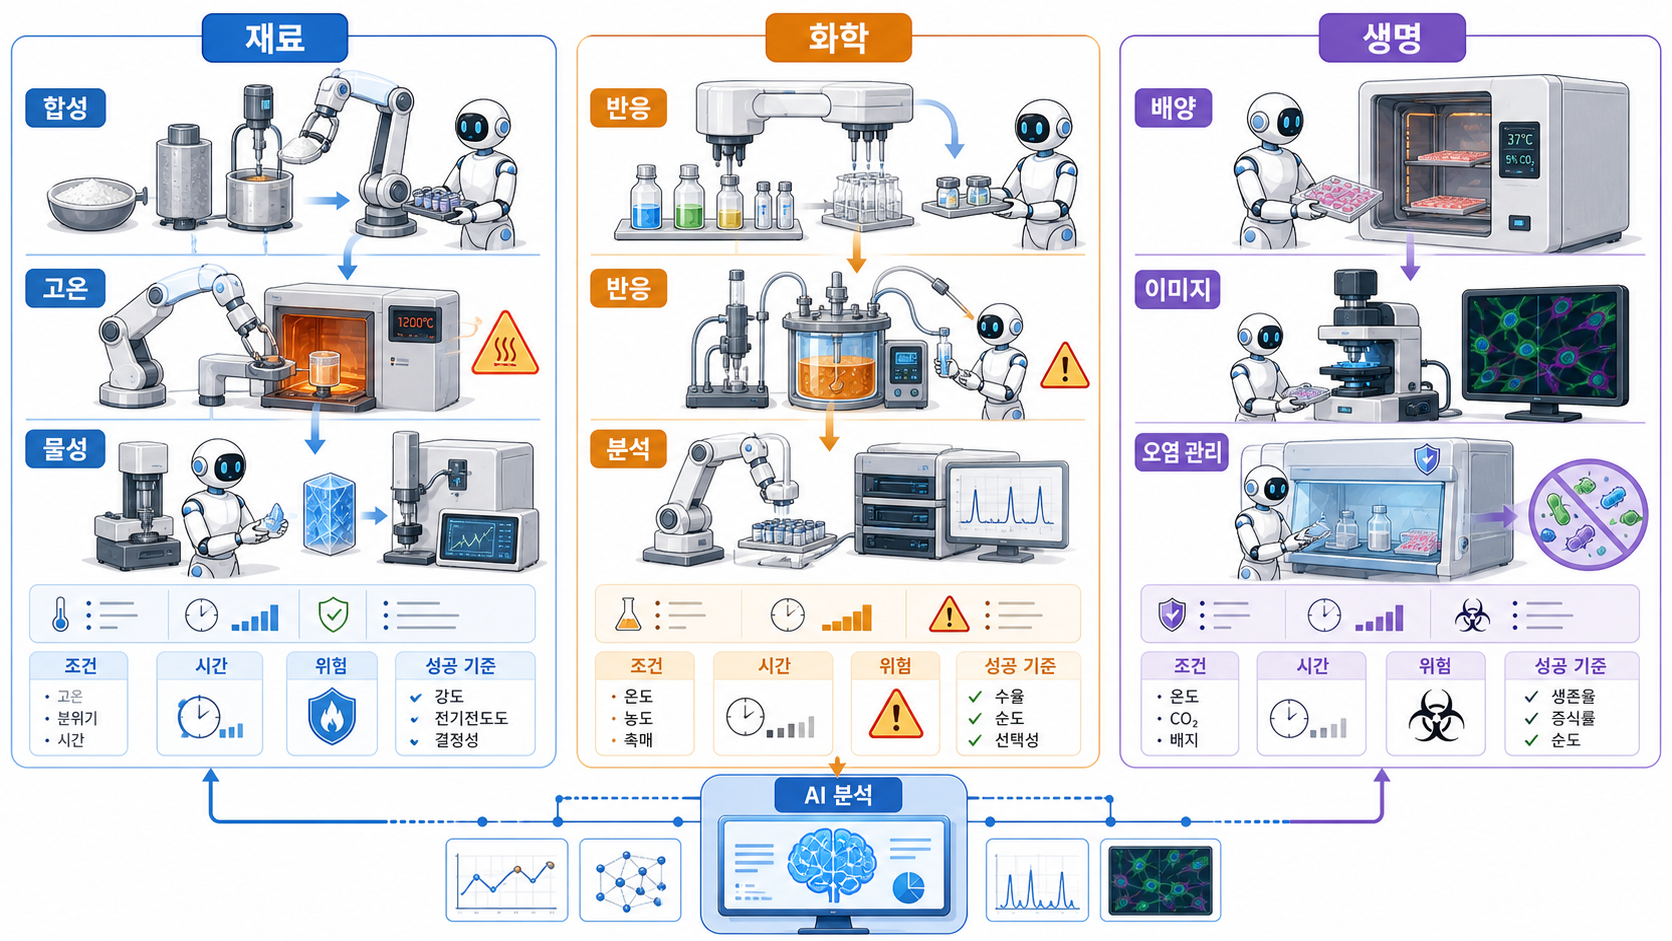
아틀라스는 재료·화학·생명 실험대를 오가며, 자동화가 분야마다 다른 물질과 시간, 측정과 안전 조건에 맞추어 설계되어야 함을 보여 줍니다.
자동화 실험실이라고 해서 모든 실험이 같은 모습으로 바뀌는 것은 아닙니다. 재료, 화학, 생명 실험은 다루는 대상과 시간, 위험과 측정 방식이 서로 다릅니다. 자동화는 하나의 만능 로봇을 만드는 일이 아니라, 각 분야의 질문에 맞는 실험의 손과 눈을 설계하는 일입니다. 재료과학에서는 무엇을 섞고, 어떻게 만들었는지가 성질을 좌우합니다. 같은 원소를 써도 비율, 온도, 압력, 냉각 속도에 따라 결정 구조와 결함이 달라지고, 전기전도도와 강도, 자성 같은 성질도 달라질 수 있습니다. 자동화 재료 실험실은 여러 조성과 공정 조건을 체계적으로 바꾸어 시료를 만들고, 구조와 물성을 연속해서 측정합니다. AI는 그 결과를 분석해 유망한 조성과 제조 조건을 제안할 수 있습니다.
하지만 계산상 좋아 보이는 재료가 실제로 쉽게 만들어진다는 뜻은 아닙니다. 소량에서는 합성되지만 대량 생산에서는 재현되지 않을 수도 있고, 특정 조건에서만 안정할 수도 있습니다. 따라서 재료 실험에서 AI는 성능뿐 아니라 합성 가능성, 공정 안정성, 반복 가능성을 함께 고려해야 합니다. 화학 실험에서는 어떤 물질이 얼마나 만들어졌는지만이 아니라, 어떤 경로로 반응이 진행되는지도 중요합니다. 같은 반응물이라도 촉매, 용매, 온도, 농도, 첨가 순서에 따라 원하는 생성물과 부산물의 비율이 달라집니다. 자동화 화학 실험실은 시약의 양과 반응 조건을 정밀하게 바꾸며 반응의 지도를 만들 수 있습니다. AI는 수율, 선택성, 반응 시간, 비용을 함께 비교해 다음 실험 조건을 제안합니다.
다만 화학 실험에는 위험이 따릅니다. 압력이 올라가거나 열이 급격히 발생할 수 있고, 유독가스나 폭발성 중간체가 생길 수도 있습니다. AI가 정보 가치가 높은 조건을 제안하더라도, 장비의 허용 범위와 안전 기준을 넘어서는 실험은 수행해서는 안 됩니다. 화학 자동화에서 안전은 선택 사항이 아니라 실험 설계의 일부입니다. 생명 실험은 살아 있는 대상을 다룬다는 점에서 더 섬세합니다. 세포와 미생물, 조직은 온도, 산소, 영양분, 배양 밀도에 민감하게 반응합니다. 같은 세포주라도 배양 기간과 상태에 따라 결과가 달라질 수 있고, 오염이 생기면 긴 실험 전체를 사용할 수 없게 될 수도 있습니다. 자동화는 세포 배양, 액체 분주, 현미경 촬영, 반복적인 생체 신호 측정에 유용합니다.
AI는 생명 실험에서 특히 이미지와 시간 변화를 해석하는 데 도움을 줄 수 있습니다. 현미경 영상에서 세포의 모양과 움직임, 성장과 사멸의 변화를 찾고, 배양 상태의 이상 징후를 표시할 수 있습니다. 그러나 생물학적 변동을 단순한 잡음으로만 보아서는 안 됩니다. 같은 조건에서도 세포와 개체가 다르게 반응하는 것은 생명현상의 중요한 정보일 수 있습니다. 세 분야에서 AI의 역할은 조금씩 다릅니다. 재료과학에서는 넓은 조성·공정 조건을 탐색하고, 구조와 물성의 관계를 찾는 일이 중요합니다. 화학에서는 수율과 선택성, 안전한 반응 조건을 함께 최적화하는 일이 중심이 됩니다. 생명과학에서는 이미지 분석, 배양 상태 감시, 시간에 따른 변화와 이상 신호 탐지가 중요합니다.
실험의 시간표도 다릅니다. 화학반응은 몇 초나 몇 시간 안에 끝날 수 있지만, 배터리 수명 시험이나 재료의 열화는 오래 걸립니다. 세포 성장과 약물 반응도 며칠에서 몇 주 동안 관찰해야 할 수 있습니다. 자동화 실험실은 단순히 실험을 빠르게 하는 장치가 아니라, 서로 다른 시간 규모의 실험을 안정적으로 관리하는 시스템이어야 합니다. 이 때문에 자동화에는 공통 규칙과 분야별 설계가 함께 필요합니다. 시료 이름, 단위, 데이터 형식, 장비 기록처럼 여러 실험이 공유해야 할 규칙을 세우는 일을 표준화(standardization)라고 합니다. 표준화가 되어야 AI가 여러 실험 결과를 비교하고 학습할 수 있습니다.
반대로 모든 실험을 똑같은 방식으로 만들 수는 없습니다. 재료, 화학, 생명 실험은 목표와 위험, 성공과 실패의 기준이 다릅니다. 각 분야와 질문에 맞게 장비와 절차를 조정하는 일을 맞춤화(customization)라고 할 수 있습니다. 좋은 자동화 실험실은 반복 가능한 부분은 표준화하되, 분야의 특성과 과학적 맥락은 맞춤화합니다. 결국 자동화 실험은 실험실을 하나의 공장으로 바꾸는 일이 아닙니다. AI가 모든 분야를 같은 방식으로 처리하는 것도 아닙니다. 중요한 것은 질문에 맞는 장치, 측정, 데이터 형식, 안전 기준을 연결하는 일입니다. 성숙한 자동화는 하나의 만능 손이 아니라, 서로 다른 과학적 질문에 맞는 여러 손과 눈을 정교하게 연결하는 기술입니다.
10.6 실험 데이터의 표준화
오래된 박물관의 표본실을 떠올려 봅시다. 표본이 아무리 많아도 이름, 채집 장소, 날짜, 보존 방법이 기록되어 있지 않다면 과학적 가치는 크게 줄어듭니다. 반대로 작은 표본이라도 언제 어디서 어떤 조건으로 얻었는지가 정확히 남아 있다면 훗날 중요한 연구 자료가 될 수 있습니다. 실험 데이터도 마찬가지입니다. 측정값이 많다고 좋은 데이터가 되는 것은 아닙니다. 그 값이 무엇을 뜻하고 어떤 조건에서 얻어졌는지 함께 기록되어야 합니다. 자동화 실험실에서 데이터 기록은 실험의 뼈대입니다. AI가 서로 다른 실험을 비교하려면 온도, 농도, 시간, 압력의 단위가 일관되어야 합니다. ‘농도 10’이라는 숫자만으로는 의미를 알 수 없습니다. 질량비인지 몰농도인지, 어떤 용매에서 측정했는지를 알아야 합니다. ‘온도 300’도 섭씨인지 켈빈인지에 따라 전혀 다른 조건이 됩니다. 숫자는 단위와 정의를 만날 때 비로소 과학적 정보가 됩니다.
실험의 기억을 공유 가능한 언어로 바꾸는 표준화
아틀라스가 서로 다른 장비와 실험 기록을 하나의 데이터 흐름으로 연결합니다. 표준화는 실험의 기억을 기계와 연구자가 함께 읽을 수 있는 언어로 바꾸는 과정입니다.
이처럼 측정값을 해석하게 해 주는 주변 정보를 메타데이터(metadata)라고 합니다. 사용한 시료와 장비, 실험 시각과 환경, 장비의 보정 상태, 전처리와 분석 방법, 실험 중 발생한 문제 등이 여기에 포함됩니다. 측정값이 실험의 결과라면, 메타데이터는 그 결과를 읽게 해 주는 문맥입니다. 시료가 어디서 왔고 어떤 과정을 거쳤는지도 중요합니다. 재료가 어느 공급처에서 왔는지, 세포가 몇 차례 배양되었는지, 화학 시약이 언제 개봉되어 어떻게 보관되었는지에 따라 결과가 달라질 수 있습니다. 데이터가 시료의 생성과 처리 과정을 따라 추적될 수 있어야 합니다. 이런 기록을 출처(provenance)라고 할 수 있습니다.
측정값에는 불확실성도 함께 남겨야 합니다. 장비가 표시한 숫자를 절대적인 참값처럼 다루면 안 됩니다. 어느 정도의 오차가 예상되는지, 신호가 장비의 측정 범위 안에 있는지, 반복 측정에서 얼마나 흔들렸는지를 알아야 결과를 올바르게 비교할 수 있습니다. 자동화 실험실에서는 이런 기록이 더욱 중요합니다. 사람이 직접 실험할 때는 연구자의 기억과 노트가 빈틈을 메울 수 있지만, AI는 기록되지 않은 맥락을 알 수 없습니다. “조금 이상했다”거나 “색이 진해 보였다”는 표현은 사람에게는 단서가 될 수 있지만, 기계가 일관되게 해석하기는 어렵습니다. 가능하면 색상값, 탁도, 이미지, 센서 신호처럼 비교 가능한 자료로 남겨야 합니다.
데이터가 어떤 처리 과정을 거쳤는지도 기록해야 합니다. 원자료를 보정했는지, 잡음을 걸러냈는지, 일부 값을 제외했는지, 어떤 분석 방법을 적용했는지가 남아야 합니다. 이렇게 데이터가 바뀐 과정을 변환 이력(transformation history)이라고 합니다. 변환 이력이 있어야 나중에 오류가 발견되었을 때 어느 단계에서 문제가 생겼는지 확인하고 다시 계산할 수 있습니다. 표준화(standardization)는 단순히 파일 형식을 같게 만드는 일이 아닙니다. 어떤 항목을 반드시 기록할지, 단위를 어떻게 통일할지, 결측값과 실패를 어떻게 표시할지, 원자료와 보정 자료를 어떻게 구분할지 정하는 일입니다. 같은 물질과 조건을 연구실마다 다른 이름으로 기록하면 AI는 그것을 서로 다른 대상으로 오해할 수 있습니다.
그러나 표준화가 모든 실험을 하나의 틀에 억지로 넣는 일이어서는 안 됩니다. 지나치게 경직된 양식은 예상하지 못한 색 변화나 새로운 침전처럼 새로운 발견의 단서를 놓치게 할 수 있습니다. 좋은 표준은 반드시 필요한 핵심 항목을 요구하되, 자유로운 관찰과 새로운 변수, 이미지와 메모를 추가할 여지를 남겨야 합니다. 표준화의 목적은 차이를 없애는 것이 아니라, 차이가 무엇인지 비교할 수 있게 만드는 데 있습니다. 표준화된 데이터는 한 연구실의 실험을 다른 연구실에서도 이해하고 다시 분석할 수 있게 합니다. 시간이 지난 뒤 새로운 알고리즘으로 다시 살펴보거나, 여러 연구기관의 결과를 결합해 더 큰 AI 모델을 훈련할 수도 있습니다. 실험은 일회성 사건에서 축적 가능한 공동의 경험으로 바뀝니다.
다만 표준화된 데이터라고 해서 자동으로 정확해지는 것은 아닙니다. 잘못된 장비 설정과 편향된 시료 선택도 깔끔한 형식으로 기록될 수 있습니다. 표준화는 데이터의 품질을 보장하는 절차가 아니라, 품질을 평가하고 오류를 추적할 수 있게 하는 기반입니다. 자동화 실험실이 정말 지능적으로 작동하려면 손의 속도만 빨라져서는 안 됩니다. 무엇을 실험했고, 어떤 조건에서 측정했으며, 그 결과를 얼마나 신뢰할 수 있는지 정확히 기억해야 합니다. 데이터 표준화는 행정적인 부속 업무가 아닙니다. 실험의 기억을 보존하고, AI가 활용할 수 있는 과학 지식으로 바꾸는 과정입니다.
10.7 닫힌 루프 과학
자동 초점 카메라라고 해서 처음부터 정확한 초점 위치를 알지 못합니다. 렌즈를 조금 움직이고, 화면이 얼마나 선명한지 확인한 뒤, 그 결과에 따라 다시 조정합니다. 측정하고, 바꾸고, 다시 측정하는 과정을 반복하며 초점에 가까워집니다. 자동화 실험실도 이와 비슷합니다. 실험 조건을 정하고, 로봇이 실험을 수행하고, 장비가 결과를 측정한 뒤, AI가 그 결과를 분석해 다음 실험 조건을 제안합니다. 이렇게 결과가 다시 다음 선택으로 돌아가는 순환 구조를 닫힌 루프 과학(closed-loop science)이라고 합니다.
닫힌 루프로 이어지는 AI 실험실
아틀라스는 측정 결과를 다음 실험 조건의 선택으로 되돌려 보냅니다. 닫힌 루프 실험실에서는 질문과 실험, 측정과 학습이 반복적으로 갱신됩니다.
전통적인 실험도 이전 결과를 바탕으로 다음 실험을 설계합니다. 다만 사람이 데이터를 정리하고 회의하며 다음 조건을 정하는 데 시간이 걸립니다. 닫힌 루프 실험실에서는 측정값이 곧바로 기계가 읽을 수 있는 데이터로 저장되고, AI가 이를 분석해 다음 조건을 제안합니다. 실험의 질문–실행–측정–학습이 끊기지 않고 이어지는 것입니다. 이 구조의 장점은 빠르게 반응할 수 있다는 데 있습니다. 예상과 다른 결과가 나오면 다음 실험을 바로 바꿀 수 있고, 유망한 조건이 발견되면 그 주변을 더 자세히 살필 수 있습니다. 반복해서 실패하는 영역은 우선순위를 낮출 수도 있습니다. 이렇게 결과에 맞추어 실험 방향을 바꾸는 능력을 적응성(adaptability)이라고 할 수 있습니다.
하지만 빠르게 돈다고 해서 좋은 과학이 자동으로 만들어지는 것은 아닙니다. 목표가 잘못 설정되면 닫힌 루프는 잘못된 방향으로 더 빠르게 갈 수 있습니다. 예를 들어 반응 수율만 높이도록 목표를 정하면 독성 부산물, 원료 비용, 장기 안정성, 재현성을 놓칠 수 있습니다. 가장 강한 신호만 찾도록 하면 장비 오염이나 측정 오류를 좋은 결과로 오해할 수도 있습니다. 그래서 닫힌 루프 실험실의 성능은 속도만으로 평가할 수 없습니다. 얼마나 빨리 다음 실험을 고르는가를 닫힌 루프 속도(closed-loop speed)라고 한다면, 그 속도는 측정의 신뢰성, 안전 기준, 목표의 적절성과 함께 보아야 합니다. 빠른 순환보다 중요한 것은 올바른 순환입니다.
AI는 이 순환에서 다음 실험을 고르는 역할을 합니다. 지금까지의 결과를 바탕으로 성능이 좋아 보이는 영역을 더 탐색할지, 아직 정보가 부족한 영역을 시험할지 제안합니다. 그러나 AI가 제안하는 것은 확정된 정답이 아닙니다. 현재 데이터 안에서 가장 합리적으로 보이는 다음 질문입니다. 따라서 사람의 점검 지점이 필요합니다. 모든 반복 작업을 사람이 직접 해야 한다는 뜻은 아닙니다. 다만 위험도가 높은 실험, 기존 범위를 크게 벗어난 조건, 지나치게 좋은 결과, 이론과 맞지 않는 이상한 결과는 사람이 다시 보아야 합니다. 이런 확인 과정을 검토(review)라고 할 수 있습니다.
때로는 순환의 방향 자체를 바꾸어야 합니다. AI가 한 영역에 지나치게 몰두하거나, 처음 정한 목표가 실제 연구 목적과 어긋나면 사람이 목표와 제약 조건을 다시 정해야 합니다. 이렇게 탐색의 기준을 고쳐 잡는 과정을 재설정(reset)이라고 할 수 있습니다. 좋은 자동화는 사람을 모든 단계에 붙잡아 두지 않지만, 사람이 개입해야 할 순간을 숨기지도 않습니다. 닫힌 루프에서는 실제 실험과 계산 모형을 함께 사용할 수 있습니다. 시뮬레이션으로 많은 후보를 먼저 비교하고, 위험하거나 가능성이 낮은 조건을 걸러낸 뒤, 유망한 조건만 현실에서 시험할 수 있습니다. 실제 실험 결과는 다시 모형을 고치는 자료가 됩니다.
그러나 시뮬레이션은 현실을 대신하지 못합니다. 모형은 알려진 법칙과 기존 데이터에 의존합니다. 장비의 상태, 시료의 미세한 불순물, 예상하지 못한 반응 경로는 실제 실험에서 드러날 수 있습니다. 시뮬레이션은 지도이고, 실험은 실제 땅입니다. 지도에서 길을 좁히고, 현실에서 확인하며, 둘 사이의 차이로 다시 지도를 고쳐야 합니다. 닫힌 루프 과학의 힘은 AI나 로봇 어느 하나에 있지 않습니다. 질문을 실험 조건으로 바꾸고, 결과를 측정해 기록하며, 그 결과를 다음 질문으로 되돌리는 순환에 있습니다. 과학자는 이 순환이 무엇을 향해 움직이는지, 어디에서 속도를 낮추어야 하는지, 어떤 결과를 다시 의심해야 하는지를 설계합니다. 자동화 실험실은 사람 없는 실험실이 아니라, 반복은 기계가 맡고 판단의 지점은 더 분명하게 드러나는 실험실입니다.
10.8 안전과 책임
자동문은 빠르게 열리고 닫히는 것보다, 사람이 끼었을 때 즉시 멈추는 능력이 더 중요합니다. 자동화 실험실도 마찬가지입니다. 많은 실험을 빠르게 수행하는 능력만으로는 충분하지 않습니다. 위험을 알아차리고, 필요할 때 안전한 상태로 멈출 수 있어야 합니다. 실험실의 위험은 분야마다 다릅니다. 화학 실험에는 폭발, 화재, 독성가스, 부식성 물질의 위험이 있습니다. 생명 실험에서는 오염, 병원체 확산, 유전자 변형 생물의 잘못된 취급을 막아야 합니다. 재료 실험에는 고온, 고압, 강한 전류와 자기장, 레이저와 방사선이 포함될 수 있습니다. 자동화 실험실이 야간이나 무인 상태에서도 작동한다면 이런 위험 관리는 더 중요해집니다.
자동화 실험실의 안전한 루프
안전 경계 앞에 선 아틀라스는 자동화의 속도가 높아질수록 인간 승인과 물리적 차단, 비상 정지가 먼저 설계되어야 함을 보여 줍니다.
AI가 다음 실험 조건을 제안했다고 해서 곧바로 실행되어서는 안 됩니다. 제안된 조건은 먼저 장비의 허용 범위, 물질 간의 금지 조합, 온도와 압력의 한계를 통과해야 합니다. 실험이 넘어서는 안 되는 경계를 안전 경계(safety boundary)라고 할 수 있습니다. 이 경계를 벗어나는 조건은 자동으로 막거나, 전문가의 승인을 받은 뒤에만 실행해야 합니다. 안전은 한 겹의 장치로 충분하지 않습니다. 먼저 위험 자체를 줄이는 설계가 필요합니다. 가능하면 위험한 시약의 양을 줄이고, 낮은 온도와 압력에서 실험하며, 위험한 공정을 최소화해야 합니다. 그다음에는 밀폐, 환기, 차폐벽, 압력 해제 장치, 누출·가스·온도 센서, 비상 정지 버튼 같은 물리적 안전장치가 필요합니다.
소프트웨어의 판단만 믿어서도 안 됩니다. 로봇이 허용된 속도와 위치를 넘지 않도록 감시하고, 온도나 압력이 위험 범위에 가까워지면 즉시 멈추는 별도의 장치가 있어야 합니다. 이런 장치를 제어 시스템(control system)이라고 합니다. 특히 충돌 방지나 과열 차단처럼 즉각적인 반응이 필요한 기능은 범용 AI 모델에만 맡기기보다, 검증된 제어 장치와 명확한 규칙으로 처리해야 합니다. 낯선 물질 조합이나 고위험 조건은 사람이 검토해야 합니다. 자동으로 실행해도 되는 영역과 인간 승인이 필요한 영역을 분명히 나누어야 합니다. 사람이 판단 과정에 들어오는 구조를 인간 참여형 판단(human-in-the-loop)이라고 할 수 있습니다. 이는 자동화를 방해하는 장치가 아니라, 위험한 결정이 무심코 실행되지 않게 하는 안전망입니다.
기록도 안전의 일부입니다. 누가 어떤 목표를 정했는지, AI가 어떤 조건을 제안했는지, 어떤 규칙을 거쳐 실행되었는지, 장비가 왜 멈췄는지가 남아야 합니다. 사고나 오류가 생겼을 때 원인을 되짚어 볼 수 있는 기록을 감사 기록(audit trail)이라고 합니다. 기록이 있어야 같은 문제가 반복되는 것을 막을 수 있습니다. 좋은 안전 시스템은 고장이 전혀 나지 않는 시스템이 아닙니다. 고장이 나더라도 피해가 커지기 전에 안전한 상태로 전환되는 시스템입니다. 전원이나 통신이 끊기고, 센서가 고장 나고, 시료가 잘못 놓였을 때 장비가 어떻게 멈출지도 미리 정해야 합니다. 이런 설계를 고장 안전(fail-safe)이라고 부릅니다.
책임도 분명해야 합니다. 연구 목표를 정한 사람, 안전 범위를 승인한 사람, 장비를 관리한 사람, 데이터를 검토한 사람의 역할은 서로 다릅니다. 자동화가 늘어난다고 책임이 사라지는 것은 아닙니다. 오히려 누가 무엇을 승인했고, 어떤 기준으로 실험이 실행되었는지를 더 명확히 해야 합니다. “AI가 제안했다”는 말은 책임의 설명이 될 수 없습니다. AI는 주어진 데이터와 목표, 허용된 조건 안에서 다음 실험을 제안할 뿐입니다. 그 제안을 어떤 범위에서 실행할지 정하고, 안전성과 결과에 책임지는 주체는 연구기관과 운영자, 승인 체계입니다.
안전은 연구의 속도를 늦추는 장애물이 아닙니다. 안전 경계가 명확할수록 시스템은 그 안에서 더 빠르고 넓게 탐색할 수 있습니다. 반대로 기준이 모호하면 매 단계에서 불안한 판단이 반복되고, 사고가 나면 자동화 실험 전체에 대한 신뢰가 무너질 수 있습니다. 자동화 실험실의 성숙도는 얼마나 오래 혼자 작동하는가만으로 평가할 수 없습니다. 위험 앞에서 얼마나 확실하게 멈추는가, 사람이 언제든 개입해 실험을 보류하거나 중단할 수 있는가도 중요합니다. 좋은 AI 실험실은 빠르게 실험하는 실험실이 아니라, 빠르게 배우면서도 안전하게 멈출 줄 아는 실험실입니다.
10.9 과학자의 손은 사라지는가
사진 필름을 현상하던 사람은 빛의 세기와 약품의 농도, 물의 온도와 현상 시간을 몸으로 익혔습니다. 디지털 사진이 등장하면서 많은 과정이 자동화되었지만, 빛을 읽고 구도를 정하며 어떤 순간을 남길지 판단하는 능력까지 사라진 것은 아닙니다. 도구가 바뀌면 숙련의 형태도 달라집니다.
과학자의 손과 로봇의 손
아틀라스가 반복 조작을 맡고 과학자가 조건과 결과를 검토하는 장면은, 인간의 손이 직접 작업의 손에서 설계와 판단의 손으로 확장되는 모습을 보여 줍니다.
자동화 실험실도 과학자의 손을 완전히 없애지는 않습니다. 시료를 반복해서 옮기고, 장비를 일정한 순서로 작동시키며, 측정 결과를 옮겨 적는 일은 로봇과 소프트웨어가 맡을 수 있습니다. 그만큼 연구자는 질문을 설계하고 결과를 해석하며, 예상 밖의 상황을 판단하는 데 더 많은 시간을 사용할 수 있습니다. 그러나 반복 작업을 자동화하는 과정에서 실험의 감각까지 잃어서는 안 됩니다. 직접 실험해 본 연구자는 숫자로 표시되기 전의 작은 변화를 알아차리기도 합니다. 액체의 색과 점도가 평소와 다르거나, 장비에서 낯선 진동과 소리가 나고, 시료의 표면이나 냄새가 달라지는 경우가 있습니다. 이러한 경험적 지식을 암묵지라고 부를 수 있습니다. 명확한 문장과 수치로 표현하기 어렵지만, 숙련된 사람이 상황을 판단할 때 사용하는 지식입니다. 자동화 시스템은 기록하기 쉬운 값만 남기고 이러한 단서를 버릴 위험이 있습니다.
따라서 자동화는 암묵지를 없애기보다 관측 가능한 정보로 전환하려 노력해야 합니다. 실험대의 영상과 장비의 소리, 진동과 냄새를 감지하는 센서를 추가할 수 있습니다. 실험자가 느낀 이상 징후도 자유로운 주석과 구조화된 기록으로 남길 수 있습니다. 모든 암묵지를 완전히 데이터로 바꿀 수 있는 것은 아닙니다. 그렇기 때문에 경험 있는 연구자가 자동화된 결과를 정기적으로 검토하고, 시스템이 놓치는 패턴을 찾아내는 일이 계속 필요합니다. 사람과 자동화 시스템은 서로 다른 감각을 가진 관찰자입니다. 과학 교육도 이러한 변화에 맞추어야 합니다. 학생이 자동 장비의 버튼을 누르는 방법만 배우면 실험 조건이 왜 중요한지 이해하기 어렵습니다. 반대로 모든 작업을 반드시 손으로 해야 한다고 고집하면 현대 실험의 규모와 정밀도를 활용하지 못합니다. 좋은 교육은 직접 실험을 통해 물질의 반응과 측정의 한계를 경험하게 하면서, 자동화 시스템의 구조와 데이터 처리 방식도 이해하게 해야 합니다. 학생은 장비를 사용하는 법뿐 아니라 장비가 무엇을 측정하고 어디에서 틀릴 수 있는지를 배워야 합니다.
자동화 이후 과학자의 역할은 실험 수행에서 완전히 벗어나는 것이 아니라 더 높은 층으로 이동합니다. 어떤 문제를 연구할지 정하고, 무엇을 측정해야 질문에 답할 수 있는지 판단하며, 성공과 실패의 기준을 세워야 합니다. AI가 찾아낸 패턴이 자연의 원리를 보여 주는지, 장비나 데이터 처리의 흔적인지를 구분하는 역할도 남습니다. 실험실의 계산과 제어는 필요한 응답 시간에 따라 배치가 달라질 수 있습니다. 장비의 전체 실험 계획과 여러 연구 자료의 분석은 원격 서버에서 수행할 수 있습니다. 반면 로봇 팔의 충돌 방지와 액체의 넘침, 급격한 온도·압력 상승에 대한 대응은 장비 가까이에서 즉시 이루어져야 합니다. 이러한 국소적 제어를 흔히 엣지 또는 온디바이스 처리와 연결해 생각할 수 있습니다. 통신망의 지연이나 장애가 발생하더라도 기본적인 장비 제어와 안전 정지는 현장에서 계속 작동해야 합니다. 다만 즉각적인 안전 기능은 학습 모델의 판단에만 의존하기보다 검증된 제어기와 센서, 물리적 차단 장치로 뒷받침되어야 합니다.
자동화 실험실에는 서로 다른 시간 규모의 지능이 공존합니다. 밀리초 단위로 움직임을 조절하는 빠른 제어가 있고, 여러 실험 결과를 분석해 다음 조건을 고르는 느린 판단이 있습니다. 더 긴 시간에는 연구 목표와 이론 자체를 다시 검토하는 과학자의 판단이 있습니다. 과학자의 새로운 숙련은 이 층들을 연결하는 능력에 있습니다. 어떤 판단을 장비 가까이에서 자동으로 내려야 하는지, 어떤 문제를 큰 모델과 데이터베이스에 맡길지, 어느 순간 사람이 개입해야 하는지를 설계해야 합니다. 과학자의 손은 사라지는 것이 아니라 역할을 바꿉니다. 반복적인 조작의 일부는 로봇의 손으로 이동하지만, 질문을 세우고 예외를 알아보며 결과에 의미를 부여하는 손은 더욱 중요해집니다. 자동화는 숙련을 없애는 기술이 아니라 숙련을 재배치하는 기술입니다.
10.10 인문학적 해석: 도구가 손을 바꿀 때
『장자』에는 소를 해체하는 데 뛰어난 포정의 이야기가 나옵니다. 포정은 힘으로 칼을 밀어붙이지 않습니다. 뼈와 살의 구조를 살피고, 그 사이의 틈을 따라 칼을 움직입니다. 그의 숙련은 손이 빠른 데 있지 않습니다. 대상의 결을 읽고, 그 결에 맞추어 움직이는 데 있습니다. 좋은 과학 실험도 이와 비슷합니다. 자연을 억지로 원하는 결과에 맞추는 것이 아니라, 물질과 생명이 어떤 조건에서 어떻게 반응하는지 살피고, 그 응답에 따라 질문과 방법을 바꾸는 일입니다. 과학자의 숙련은 자연의 결을 읽는 능력에 가깝습니다.
전통적 손의 숙련을 대신하는 피지컬 AI
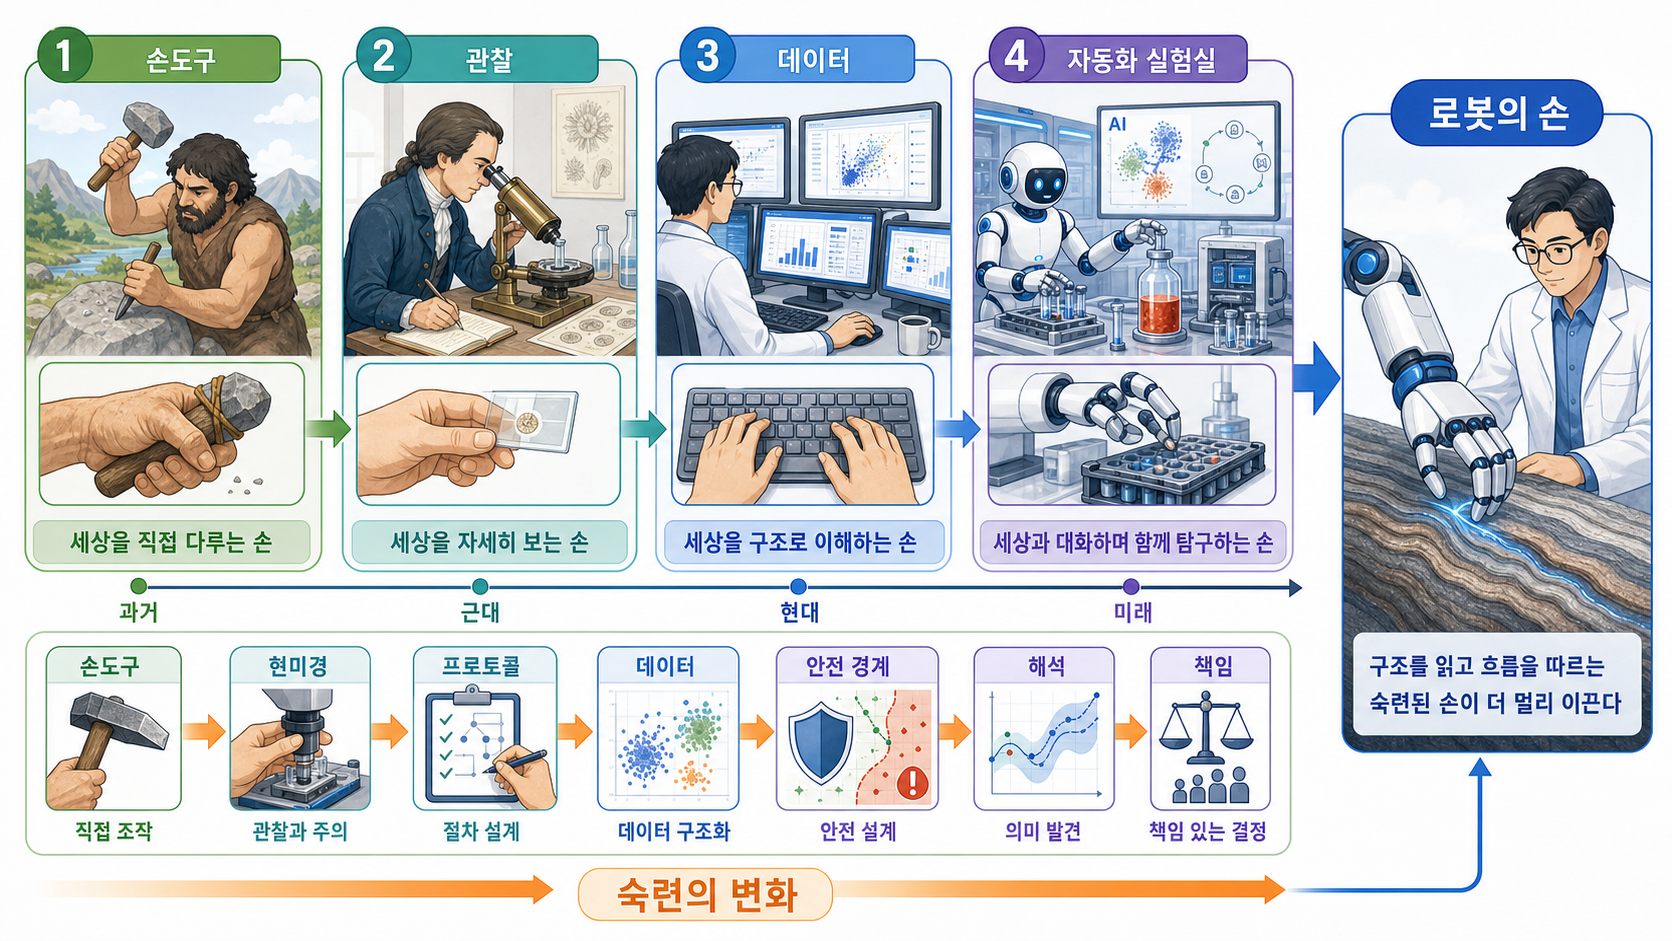
망치와 현미경과 컴퓨터를 지나 아틀라스로 이어지는 도구의 흐름은, 도구가 바뀔 때 인간의 숙련과 책임도 함께 재구성됨을 보여줍니다.
자동화 실험실은 이 손의 방식을 바꾸고 있습니다. 로봇은 더 많은 조건을 더 오래, 더 일정하게 시험할 수 있습니다. AI는 이전 실험 결과를 비교해 다음 조건을 제안하고, 측정 데이터에서 사람이 놓치기 쉬운 패턴을 찾아낼 수 있습니다. 자연에 던지는 질문의 수와 속도가 달라지는 것입니다. 그러나 질문이 많아진다고 이해가 자동으로 깊어지는 것은 아닙니다. 무엇을 측정할지, 어떤 차이를 중요하게 볼지, 발견된 패턴을 어떤 이론과 연결할지는 여전히 판단을 필요로 합니다. AI는 다음 질문을 제안할 수 있지만, 그 질문이 왜 중요한지까지 스스로 결정하지는 않습니다.
도구는 손의 능력을 넓히지만, 동시에 손의 습관을 바꿉니다. 현미경은 눈의 한계를 넓혔고, 망원경은 시야를 우주까지 확장했습니다. 자동화 실험실은 인간의 손이 수행할 수 있는 반복과 정밀도의 범위를 넓힙니다. 하지만 도구가 강력해질수록 “무엇을 위해 이 힘을 쓰는가”라는 질문도 더 중요해집니다. AI는 과학자의 해석을 도울 수 있습니다. 방대한 문헌과 실험 기록을 연결하고, 여러 가설을 비교하며, 예상하지 못한 관계를 제안할 수 있습니다. 그러나 어떤 발견을 추구할 가치가 있는지, 위험과 이익을 어떻게 나눌지, 어느 수준의 증거를 받아들일지는 과학 공동체와 사회가 함께 판단해야 합니다. 계산 능력이 커진다고 책임이 자동으로 기계에 넘어가지는 않습니다.
자동화 이후 과학자의 일은 사라지기보다 더 깊은 층으로 이동합니다. 반복적인 조작에서 질문의 설계로, 개별 측정에서 전체 순환의 검토로, 결과의 생산에서 의미와 책임의 판단으로 무게중심이 옮겨 갑니다. 과학자의 손은 로봇에게 빼앗기는 것이 아니라, 더 넓은 실험의 구조를 설계하는 손으로 바뀝니다. 포정의 칼이 오래도록 무뎌지지 않았던 까닭은 무작정 힘을 가하지 않고 대상의 틈과 구조를 따랐기 때문입니다. 자동화 실험실도 더 많은 힘으로 자연을 밀어붙이는 기술이 되어서는 안 됩니다. 자연이 보여 주는 구조와 한계를 더 정밀하게 읽는 기술이어야 합니다.
과학의 새로운 손은 이전보다 빠르고 오래 움직일 수 있습니다. 그러나 그 손이 어떤 질문을 붙잡고, 어느 경계에서 멈추며, 발견된 지식을 누구를 위해 사용할 것인지는 여전히 인간 공동체의 몫입니다. 좋은 자동화는 인간의 손을 지우는 것이 아니라, 그 손이 책임 있게 닿아야 할 곳을 더 선명하게 보여 주는 기술입니다.
제11강. 예측과 이해의 철학
낯선 도시에서 길 찾기 앱을 켜면 목적지까지 가는 경로와 예상 시간이 곧바로 나타납니다. 어디에서 방향을 바꾸고 어느 교통수단으로 갈아타야 하는지도 알려 줍니다. 그러나 그 도시가 왜 지금의 모습으로 형성되었는지, 시장이 왜 그 자리에 들어섰는지, 강을 따라 도로가 굽이치는 까닭까지 설명해 주지는 않습니다. 목적지에 도달하는 능력과 도시의 구조를 이해하는 능력은 서로 연결되어 있지만 같은 것은 아닙니다. 오늘날 AI는 과학의 여러 영역에서 놀라운 예측 능력을 보여 줍니다. 단백질과 생체분자의 구조를 예측하고, 새로운 재료와 알고리즘의 후보를 제안하며, 방대한 실험 자료에서 사람이 놓치기 쉬운 패턴을 찾아냅니다. 일부 시스템은 연구 아이디어와 실험 계획을 제안하고, 계산 결과를 정리해 보고서나 논문의 초안을 만드는 단계까지 나아가고 있습니다. 이러한 발전은 과학의 속도와 범위를 넓히지만 중요한 질문도 남깁니다.
AI가 결과를 정확하게 예측했다면, 우리는 그 현상을 이해했다고 말할 수 있는가?
예측이 반복해서 맞으면 강력한 도구가 됩니다. 그러나 과학적 이해에는 결과를 맞히는 능력뿐 아니라 원인과 작동 과정, 적용 조건과 한계를 밝히는 일이 포함됩니다. AI는 이 과정에도 도움을 줄 수 있지만, 높은 정확도가 저절로 설명과 이해로 바뀌는 것은 아닙니다. 제11강에서는 예측과 설명, 모델과 현실의 관계를 살펴봅니다. 핵심은 AI의 예측 능력을 낮추어 보는 데 있지 않습니다. 그 예측이 어떤 근거 위에 서 있으며, 어디까지 믿을 수 있고, 어떻게 검증되어 과학적 지식이 되는지를 묻는 데 있습니다.
데이터와 이해 사이에 놓아야 할 것들
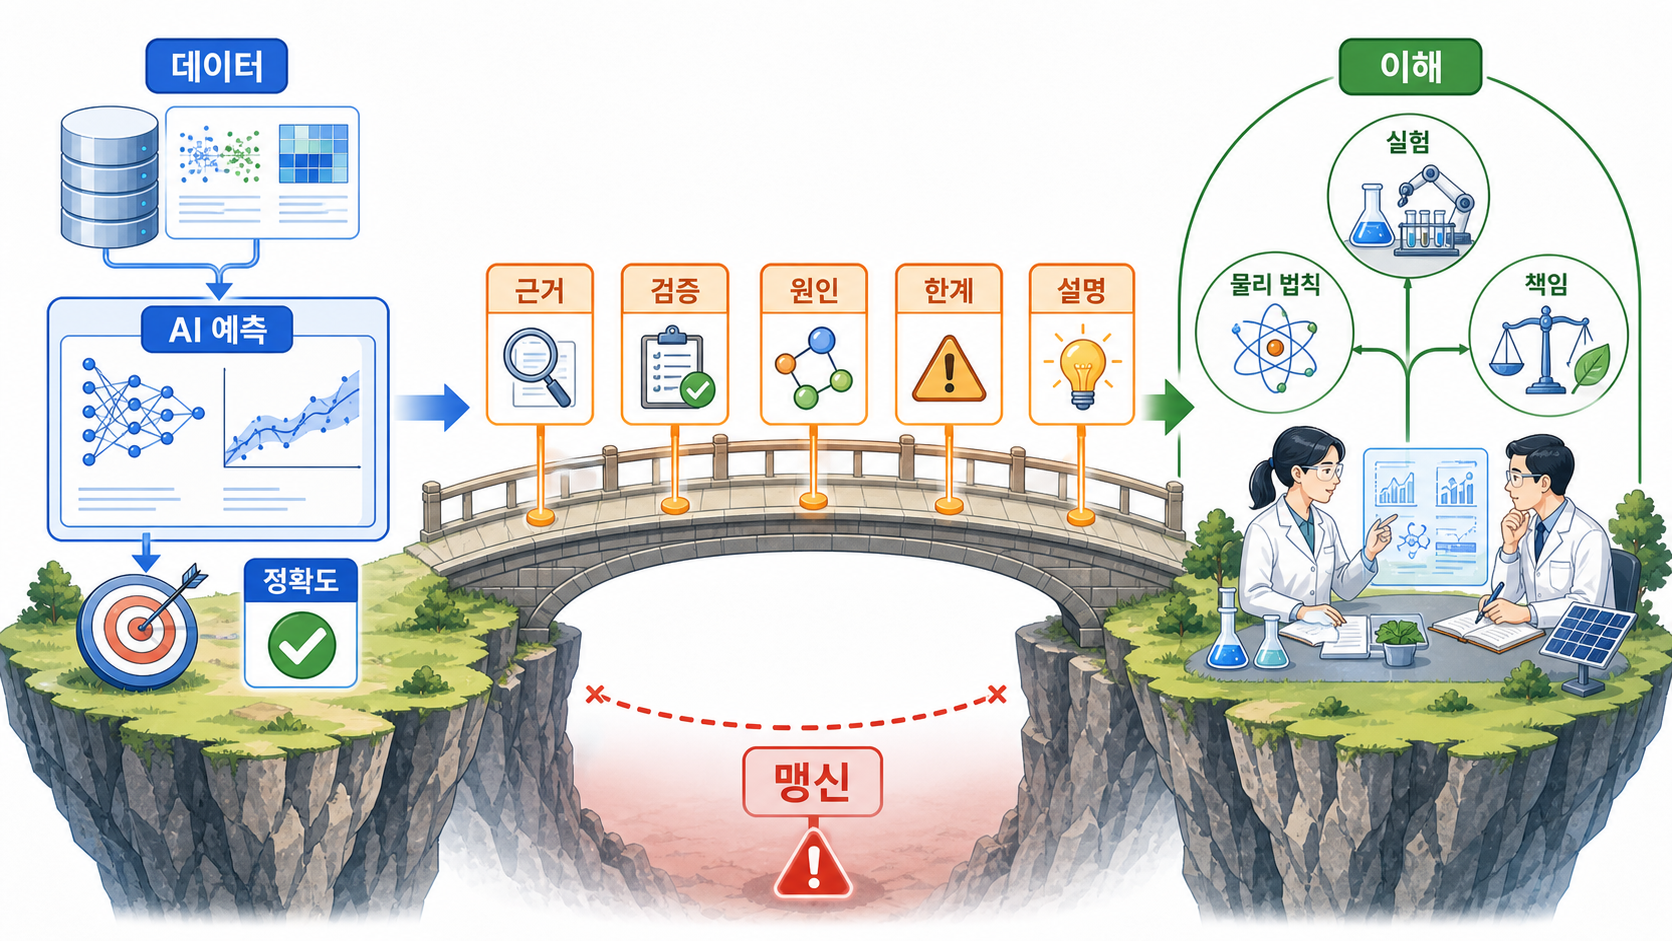
도해 11-0. AI의 예측이 과학적 이해로 이어지려면 근거와 검증, 원인과 적용 범위, 설명과 책임이라는 다리를 건너야 합니다.
11.1 맞히는 것과 아는 것은 같은가
야구장에서 들려오는 관중의 함성만으로도 숙련된 팬은 안타인지 홈런인지 어느 정도 짐작할 수 있습니다. 환호의 크기와 길이, 순간적인 침묵과 뒤이어 터지는 함성이 단서가 되기 때문입니다. 그러나 결과를 맞혔다고 해서 타자가 어떤 공을 어떤 각도로 쳤는지, 수비 위치와 바람이 어떤 영향을 주었는지까지 아는 것은 아닙니다. 결과를 예측하는 일과 그 결과가 생긴 과정을 이해하는 일은 다릅니다.
맞히는 것과 아는 것이 언제나 같지는 않다
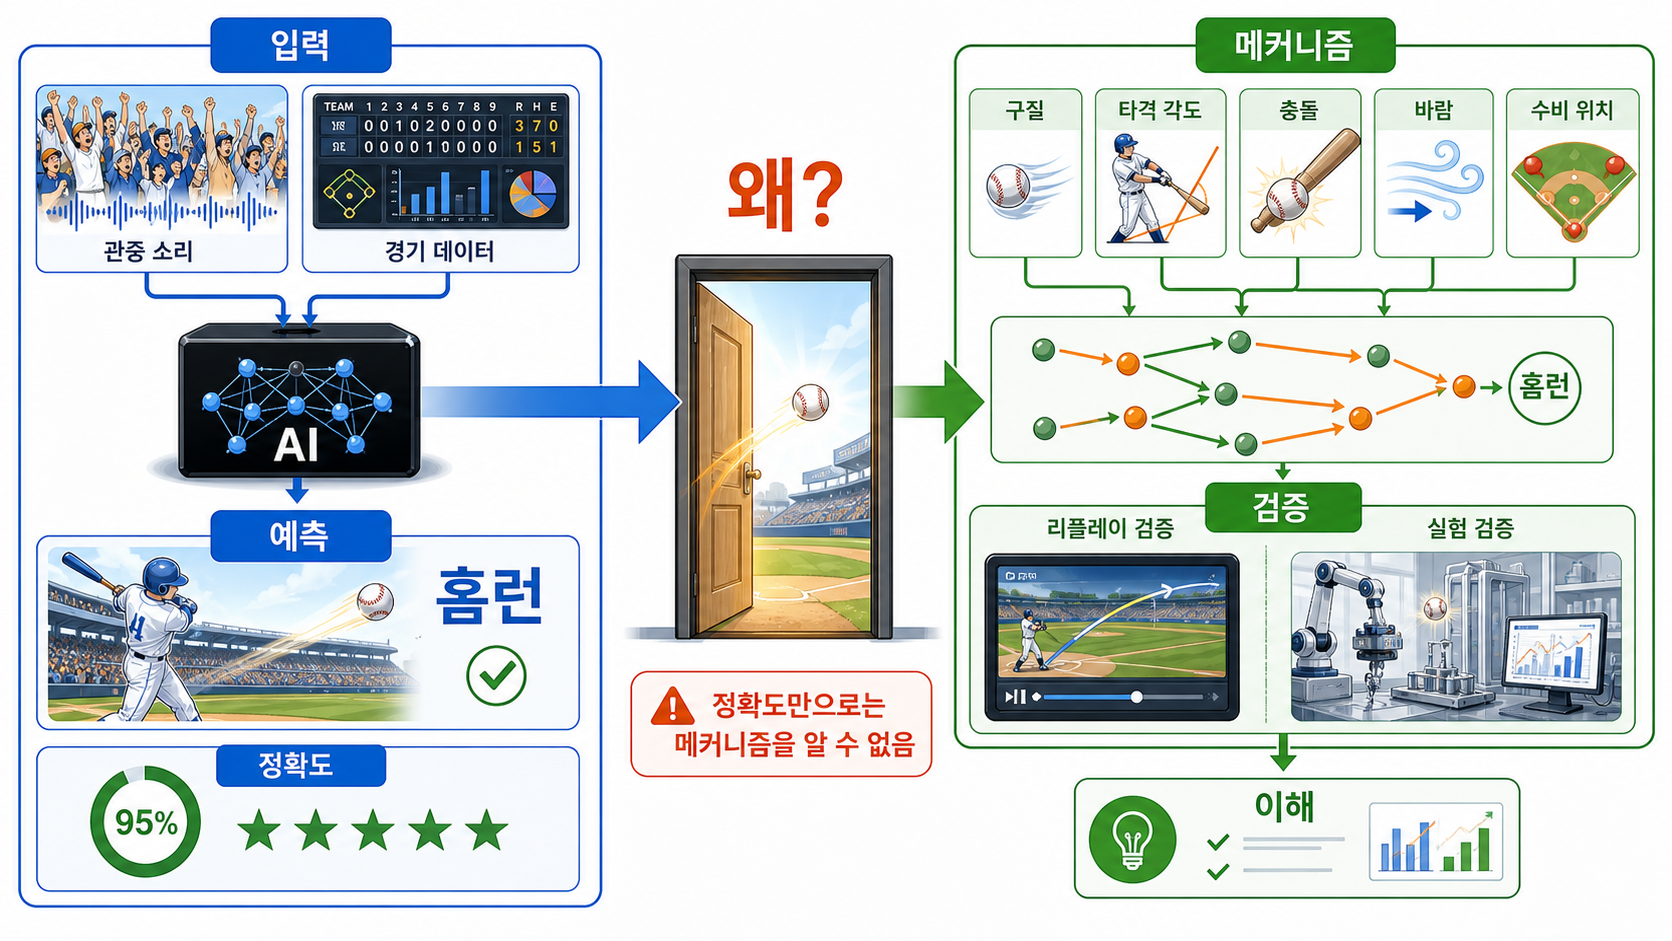
도해 11-1. 결과를 정확히 예측하는 능력과, 원인과 메커니즘을 밝혀 그 결과를 이해하는 능력은 서로 연결되지만 동일하지 않습니다.
과학에서 예측은 매우 중요합니다. 천체의 위치, 물질의 성질, 화학반응의 결과를 정확히 예측하는 능력은 이론과 모형의 힘을 보여 줍니다. 그러나 예측이 잘 맞는다고 해서 곧바로 이해가 완성되는 것은 아닙니다. 서로 다른 모형이 같은 결과를 맞힐 수 있고, 관측된 자료 안에서는 구별되지 않다가 새로운 조건에서 서로 다른 예측을 내놓을 수도 있습니다. 과학적 이해에는 예측 뒤의 질문이 따라야 합니다. 왜 그런 결과가 나타났는가. 어떤 조건에서 같은 결과가 반복되는가. 조건이 달라지면 무엇이 바뀌는가. 관측된 관계가 원인인지, 단순히 함께 나타난 상관관계(correlation)인지도 확인해야 합니다. 좋은 과학은 맞히는 데서 멈추지 않고, 왜 맞았는지를 묻습니다.
AI의 과학적 성과를 볼 때도 이 구분이 필요합니다. 예를 들어 AlphaFold 계열은 아미노산 서열로부터 단백질의 입체 구조를 예측하는 능력을 크게 발전시켰습니다. AlphaFold 3는 단백질뿐 아니라 핵산과 작은 분자들이 함께 이루는 복합체의 구조 예측으로 범위를 넓혔습니다. 이것은 생명과학과 약물 후보 탐색에서 중요한 전환입니다. 하지만 구조를 잘 예측한다는 사실이 생명현상 전체를 이해했다는 뜻은 아닙니다. 작은 분자가 단백질의 특정 부위에 붙어 기능에 영향을 줄 때, 그 분자를 리간드(ligand)라고 합니다. 단백질과 리간드가 어떤 모양으로 결합할지 예측하는 일은 매우 중요하지만, 그 결합이 세포 안에서 얼마나 안정한지, 시간에 따라 어떻게 움직이는지, 몸속에서 어떤 반응을 일으키는지는 다시 실험과 검증이 필요합니다.
예측, 설명, 이해는 서로 이어지지만 같은 말은 아닙니다. 예측은 무엇이 일어날 가능성이 높은지를 말합니다. 설명은 어떤 원리와 과정 때문에 그런 일이 일어나는지를 보여 줍니다. 이해는 그 설명이 어디까지 적용되고, 어떤 조건에서 실패하는지까지 파악하는 능력입니다. AI가 새로운 알고리즘이나 코드를 제안할 때도 마찬가지입니다. AI가 더 나은 방법처럼 보이는 코드를 만들었다면, 실제로 실행되는지, 기존 방법보다 어느 조건에서 빠른지, 입력이 커져도 이점이 유지되는지 확인해야 합니다. 가능하다면 수학적 분석과 다른 연구자의 재현도 필요합니다. 제안은 출발점이지, 곧바로 과학적 성과가 되는 것은 아닙니다.
벤치마크(benchmark)도 조심해서 읽어야 합니다. 벤치마크는 같은 문제와 평가 기준으로 여러 AI 모델을 비교하는 시험대입니다. 점수가 높으면 유용한 능력을 보여 줄 수 있지만, 그 분야의 원리를 깊이 이해한다고 바로 말할 수는 없습니다. 시험 자료가 학습 자료와 겹쳤는지, 문제 형식이 실제 연구와 비슷한지, 조건을 조금 바꾸어도 성능이 유지되는지 살펴야 합니다. 정확도는 이해의 문을 열 수 있습니다. 그러나 그 문 안으로 들어가려면 다시 물어야 합니다. 왜 맞았는가. 어떤 증거가 그 설명을 뒷받침하는가. 언제 틀리는가. 다른 조건에서도 같은 원리가 작동하는가. 이러한 질문은 AI의 성과를 깎아내리는 것이 아닙니다. 예측의 성공을 재현 가능한 과학 지식으로 바꾸는 과정입니다.
11.2 과학적 설명의 여러 얼굴
고장 난 시계를 고치는 사람은 “시계가 멈췄다”는 관찰만으로 멈추지 않습니다. 배터리가 방전되었는지, 톱니바퀴가 걸렸는지, 습기가 들어갔는지, 충격으로 축이 휘었는지를 살펴봅니다. 같은 결과라도 원인과 작동 과정은 다를 수 있습니다. 과학적 설명도 하나의 방식만 있는 것은 아닙니다.
과학적 설명의 여러 얼굴
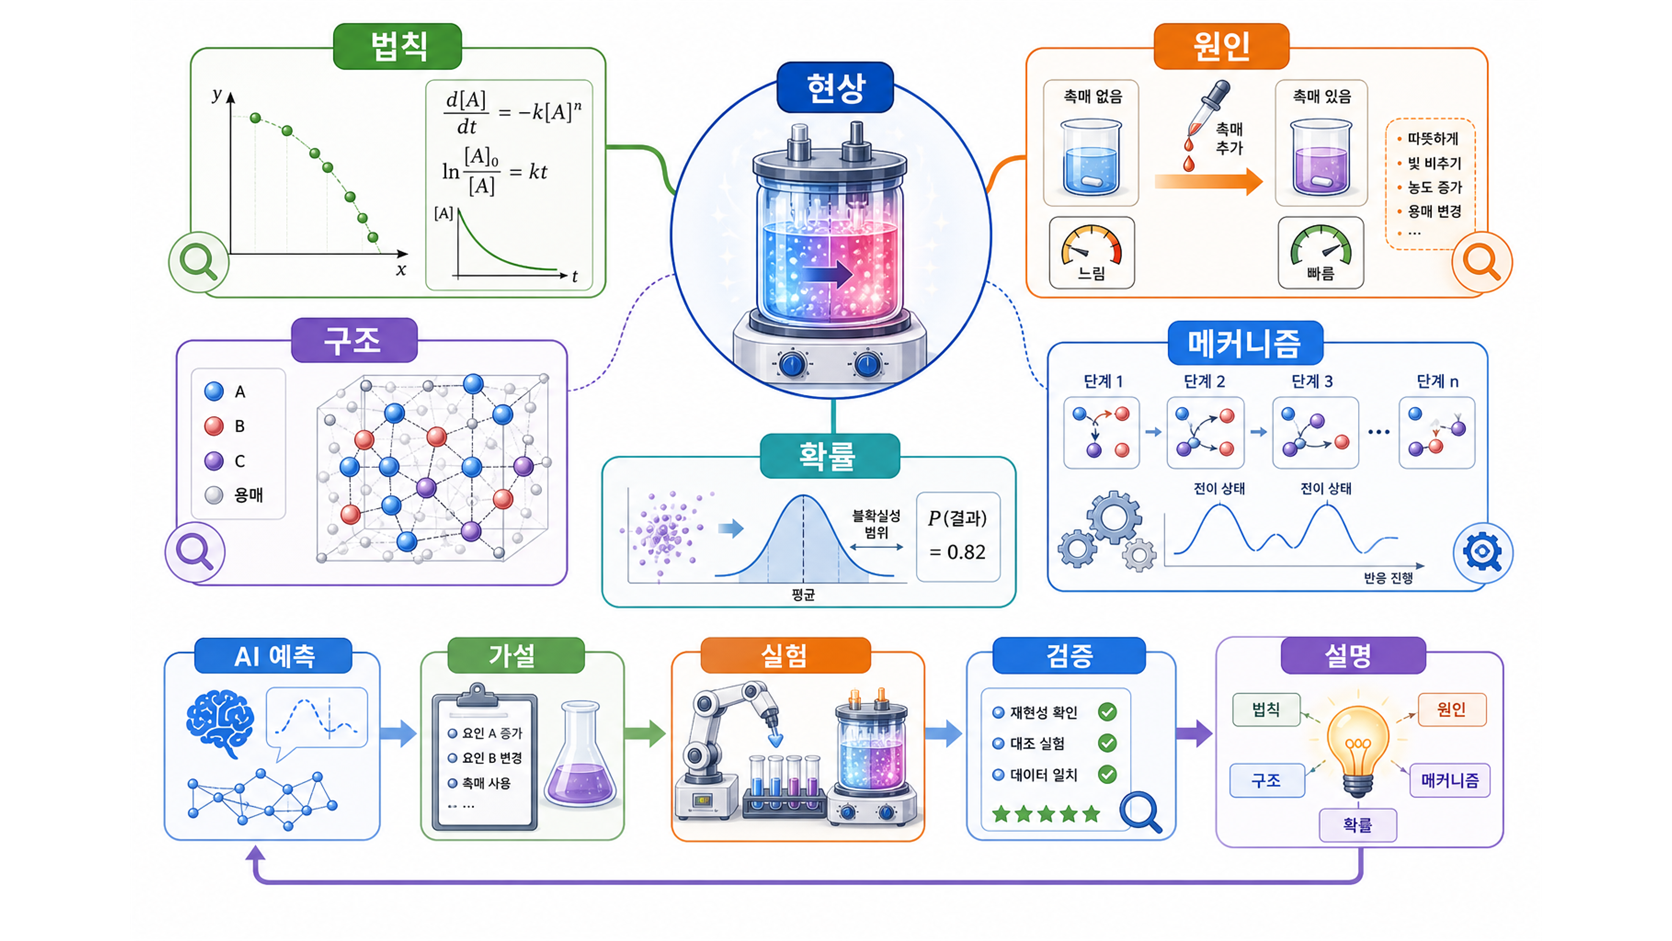
도해 11-2. 하나의 현상도 법칙과 원인, 구조와 메커니즘, 확률과 모형이라는 서로 다른 관점에서 설명할 수 있습니다.
어떤 설명은 넓은 관계를 보여 줍니다. 물체의 운동을 힘과 가속도의 관계로 나타내거나, 기체의 압력과 부피, 온도의 관계를 방정식으로 정리하는 방식입니다. 이런 설명을 법칙을 통한 설명(law-based explanation)이라고 할 수 있습니다. 여러 현상을 하나의 일반적인 관계 아래 묶어 주는 힘이 있습니다.
어떤 설명은 “무엇이 무엇을 일으켰는가”를 묻습니다. 특정 물질을 넣었더니 반응 속도가 빨라졌는지, 유전자 변화가 세포 기능 변화를 일으켰는지를 실험으로 확인하는 방식입니다. 이것이 인과적 설명(causal explanation)입니다. 단순히 함께 나타나는 관계가 아니라, 실제로 원인과 결과가 연결되어 있는지를 따집니다.
또 어떤 설명은 내부 과정을 보여 줍니다. 세포 안에서 어떤 단백질이 먼저 활성화되고, 그 신호가 다음 분자로 어떻게 전달되는지 추적하는 식입니다. 현상을 이루는 부품과 순서, 상호작용을 밝히는 설명을 메커니즘 설명(mechanistic explanation)이라고 합니다.
모든 현상을 하나하나 정확히 결정할 수 없을 때도 설명은 가능합니다. 날씨, 질병의 전파, 양자현상처럼 결과가 확률적으로 나타나는 경우에는 어떤 조건에서 가능성이 높아지고 낮아지는지를 설명해야 합니다. 이런 방식을 통계적 설명(statistical explanation)이라고 할 수 있습니다. 확률은 모르는 것을 대충 처리하는 임시방편이 아니라, 어떤 분야에서는 설명의 핵심이 됩니다.
복잡한 현실을 그대로 다 담을 수 없을 때는 중요한 관계만 골라 단순화하기도 합니다. 기후 모형, 원자 모형, 생명현상 모형이 그렇습니다. 현실의 축소판을 만들어 특정 질문에 답하도록 돕는 설명을 모형을 통한 설명(model-based explanation)이라고 할 수 있습니다.
AI의 과학적 출력도 이런 설명 구조와 연결될 때 의미를 얻습니다. 예를 들어 AI가 새로운 촉매 후보를 제안했다고 해 봅시다. “성능이 높을 것”이라는 예측만으로는 충분하지 않습니다. 그 물질의 전자 구조가 반응물의 결합을 어떻게 바꾸는지, 촉매 표면에서 어떤 중간체가 생기는지, 반응에 필요한 에너지 장벽이 낮아지는지를 살펴야 합니다. 예측은 설명으로 이어질 수 있지만, 그 자체가 설명은 아닙니다. AlphaFold 3 같은 구조 예측 모델도 마찬가지입니다. 예측된 분자 구조는 어떤 부위가 결합에 관여하는지, 특정 돌연변이가 결합 형태를 어떻게 바꿀 수 있는지에 관한 가설을 세우게 합니다. 그러나 구조 예측만으로 기능 전체가 설명되지는 않습니다. 세포 안의 농도와 위치, 주변 분자와의 경쟁, 시간에 따른 구조 변화, 몸속 대사 과정이 함께 작용하기 때문입니다.
최근에는 AI가 논문과 실험 자료를 비교해 가설 후보와 실험 방향을 제안하기도 합니다. 이런 시스템을 AI 공동 연구자(AI co-scientist)라고 부를 수 있습니다. 다만 이것은 인간과 독립적으로 책임지는 완성된 과학자라기보다, 연구자가 검토할 아이디어와 계획을 만드는 보조 시스템에 가깝습니다. AI가 제안한 가설은 설명이 아니라, 설명이 될 가능성이 있는 후보입니다. 과학적 가설은 시험될 수 있어야 합니다. 어떤 결과가 나오면 지지되고, 어떤 결과가 나오면 수정되거나 버려져야 하는지가 분명해야 합니다. 모든 결과를 나중에 그럴듯하게 끼워 맞출 수 있는 주장은 검증하기 어렵습니다. 좋은 가설은 틀릴 위험을 감수합니다. 실험은 그 위험을 자연 앞에 세우는 과정입니다.
대화형 AI는 설명처럼 들리는 문장을 매우 자연스럽게 만들 수 있습니다. 이것은 과학 소통에 도움이 되지만, 매끄러운 문장을 실제 설명으로 착각하게 만들 위험도 있습니다. 과학적 설명은 문체의 설득력으로 평가되지 않습니다. 개념이 명확한지, 증거와 연결되어 있는지, 다른 연구자가 검토할 수 있는지, 적용 한계와 반례를 제시하는지가 중요합니다. AI가 “이 분자는 안정하다”고 말한다면 어떤 안정성을 뜻하는지 물어야 합니다. 낮은 에너지 상태라는 뜻인지, 특정 시간 동안 분해되지 않는다는 뜻인지, 어느 온도와 용매 조건에서 안정하다는 뜻인지 구분해야 합니다. AI가 “이 알고리즘은 효율적이다”라고 말한다면 시간, 메모리, 통신 비용 가운데 무엇이 줄었는지 확인해야 합니다.
좋은 설명은 질문을 끝내는 문장이 아니라 다음 검증을 가능하게 하는 구조입니다. 어떤 변수를 바꾸어야 하는지, 어떤 결과가 나오면 설명을 수정해야 하는지 알려 줍니다. AI가 과학적 설명을 돕는다는 것은 그럴듯한 이유를 만들어 낸다는 뜻이 아닙니다. 예측, 원리, 메커니즘, 실험, 반례와 수정이 서로 이어지도록 돕는다는 뜻입니다.
11.3 모델은 현실인가, 지도인가
여행 가방에 붙은 짐표에는 목적지와 항공편, 바코드가 적혀 있습니다. 그 표는 가방 자체가 아니지만, 공항 시스템이 가방을 목적지로 보내는 데 필요한 정보를 담고 있습니다. 모델도 이와 비슷합니다. 모델은 현실 그 자체가 아니라, 특정한 목적을 위해 현실의 일부를 골라 관계를 표현한 지도입니다. 과학의 모델은 복잡한 현실을 단순화합니다. 실제 기체 분자는 크기도 있고 서로 영향을 주고받지만, 이상기체 모형은 많은 세부를 생략합니다. 그래도 일정한 조건에서는 압력, 부피, 온도의 관계를 잘 설명합니다. 모델이 현실의 모든 것을 담지 않는다는 사실은 반드시 약점만을 뜻하지 않습니다. 오히려 무엇을 생략하고 무엇을 남길지 선택하기 때문에 중요한 관계가 더 잘 보이기도 합니다.
모델은 현실의 일부를 선택해 그린 지도
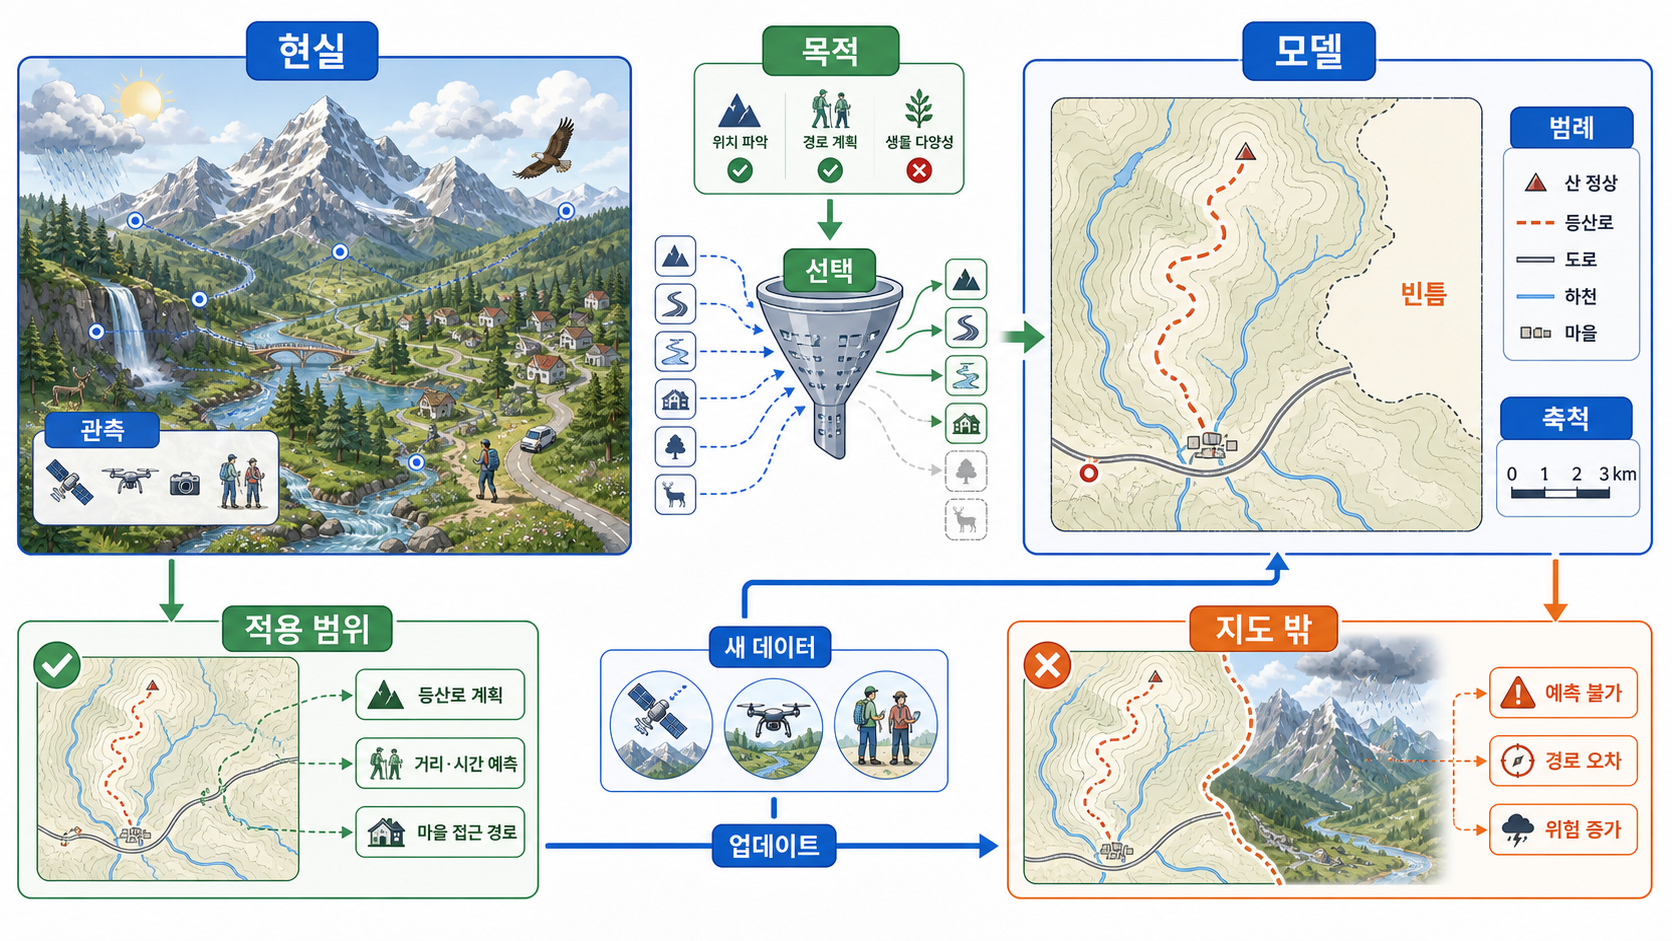
도해 11-3. 모델은 목적에 필요한 현실의 일부를 선택해 그린 지도입니다. 적용 범위와 빈틈을 알고 새로운 관측에 따라 수정해야 합니다.
좋은 모델을 평가할 때는 “현실과 똑같은가”보다 “어떤 목적에 얼마나 적합한가”를 물어야 합니다. 어느 조건에서 정확한가. 무엇을 의도적으로 생략했는가. 어떤 질문에는 답할 수 없는가. 어느 지점부터 오차가 커지는가. 지도를 볼 때 축척과 범례, 표시되지 않은 지역을 확인하듯이 모델도 적용 범위와 한계를 함께 보아야 합니다.
AI 모델도 현실의 복사본이 아닙니다. 주어진 데이터에서 입력과 출력 사이의 관계를 학습한 계산 구조입니다. 특정 과제에서 뛰어난 성능을 내더라도 현실 전체를 이해한다고 말할 수는 없습니다. 모델이 경험한 세계는 학습 데이터, 측정 방법, 목표 함수, 평가 기준에 의해 제한됩니다. 예를 들어 밝은 은하의 자료가 많은 데이터로 학습한 AI는 희미한 은하를 잘 보지 못할 수 있습니다. 깨끗한 실험실 자료로 학습한 모델은 현장의 오염, 장비 차이, 불규칙한 조건에 흔들릴 수 있습니다. 모델의 성능은 언제나 어떤 자료와 어떤 조건 안에서 측정된 성능입니다.
그래서 모델이 익숙하게 학습한 범위를 벗어나는 상황에서는 주의해야 합니다. 익숙한 길에서는 잘 작동하던 내비게이션도 새로 생긴 도로나 폐쇄된 다리 앞에서는 틀릴 수 있습니다. 이렇게 모델이 학습한 조건과 다른 상황을 분포 밖 조건(out-of-distribution condition)이라고 합니다. AI는 자신이 잘 모르는 영역에서도 그럴듯한 답을 내놓을 수 있으므로, 예측값만이 아니라 불확실성도 함께 살펴야 합니다. 불확실성을 본다는 것은 모델이 얼마나 자신 있게 말하는지와 실제로 얼마나 자주 맞는지를 비교하는 일입니다. 높은 확신과 높은 정확도는 같은 말이 아닙니다. 어떤 모델은 틀리면서도 자신만만할 수 있습니다. 따라서 과학에서 AI를 사용할 때는 예측의 수치뿐 아니라, 그 예측을 얼마나 믿을 수 있는지도 함께 점검해야 합니다. 피지컬 AI에서 말하는 월드 모델(world model)도 같은 관점에서 이해할 수 있습니다. 로봇이 물체를 밀면 어떻게 움직일지, 어느 방향으로 가면 장애물을 만날지 미리 예상하는 내부 지도가 필요합니다. 이런 내부 모형을 월드 모델이라고 부릅니다. 그러나 이름과 달리 세계 전체를 완전히 담은 모델은 아닙니다. 특정 센서, 행동 범위, 학습 환경 안에서 필요한 변화를 근사한 지도에 가깝습니다.
AI 모델을 현실과 혼동하면 두 가지 문제가 생깁니다. 첫째, 모델이 잘 작동한 영역을 현실 전체로 확대합니다. 둘째, 모델이 보지 못한 변수와 맥락을 없는 것처럼 취급합니다. 환자 자료가 특정 집단에 치우쳐 있다면 다른 집단에서도 같은 성능을 낸다고 가정할 수 없습니다. 재료 예측 모델이 이상적인 결정 구조만 많이 배웠다면 실제 시료의 결함과 제조 과정의 차이를 충분히 반영하지 못할 수 있습니다. 이 한계를 인정하는 것은 AI 모델을 낮추어 보는 일이 아닙니다. 오히려 모델을 올바르게 쓰기 위한 조건입니다. 지도를 신뢰하려면 언제 만들어졌고, 어떤 축척이며, 무엇이 표시되어 있고 무엇이 빠져 있는지 알아야 합니다. AI 모델도 훈련 자료, 평가 방법, 적용 범위, 불확실성을 함께 보아야 더 유용해집니다.
지도는 현실이 바뀌면 갱신되어야 합니다. 새로운 길이 생기고 다리가 막히면 오래된 지도는 틀릴 수 있습니다. AI 모델도 새로운 장비, 새로운 데이터, 변화한 환경에서는 성능이 달라질 수 있습니다. 한 번의 시험에서 높은 점수를 얻었다고 영원히 유효한 것은 아닙니다. 따라서 모델은 사용된 뒤에도 계속 점검되어야 합니다. 특정 조건에서 오류가 늘어나는지, 데이터의 성격이 바뀌었는지, 새로운 편향이 나타나는지 확인해야 합니다. 필요하면 다시 학습하거나 사용 범위를 조정해야 합니다. 과학에서 널리 쓰이는 AI 모델일수록 이런 점검은 더 중요합니다.
많은 연구자가 같은 모델에 의존하면 연구 속도와 비교 가능성은 높아질 수 있습니다. 그러나 그 모델의 편향과 사각지대가 여러 연구에 동시에 퍼질 위험도 있습니다. 특정 모델이 놓치는 현상이 있다면 그것은 한 연구실의 문제가 아니라 연구 공동체 전체의 공통된 빈틈이 될 수 있습니다. 모델은 현실을 대신하는 우상이 아닙니다. 현실을 더 잘 질문하게 하는 도구입니다. 모델과 현실의 차이를 기억할 때 우리는 AI의 성과를 과소평가하지 않으면서도, 그 성과를 현실 전체의 진실로 확대하는 오류를 피할 수 있습니다. AI 모델은 현실이 아니라 현실을 향한 지도입니다. 중요한 것은 그 지도를 절대화하는 것이 아니라, 지도를 들고 다시 현실을 확인하는 일입니다.
11.4 블랙박스와 신뢰
도자기를 고르는 사람은 겉모양만 보지 않습니다. 표면과 굽을 살피고, 가볍게 두드려 소리를 듣고, 유약에 균열이 없는지 확인합니다. 겉보기에 아름다워도 내부에 결함이 있으면 오래 쓰기 어렵습니다. 신뢰는 결과가 좋아 보인다는 이유만으로 생기지 않습니다. 어떤 조건에서 만들어졌고, 어디까지 견딜 수 있는지를 함께 알아야 합니다. AI도 마찬가지입니다. 모델이 여러 번 정확한 답을 내놓으면 우리는 그 결과를 믿고 싶어집니다. 그러나 과학적으로 중요한 판단일수록 한 걸음 더 나아가 물어야 합니다. 이 모델은 어떤 자료를 근거로 예측했는가. 우연한 상관관계를 이용한 것은 아닌가. 조건이 조금 달라져도 같은 결과를 내는가. 기존의 물리 법칙과 실험 결과에 어긋나지는 않는가.
블랙박스 AI의 신뢰를 만드는 조건
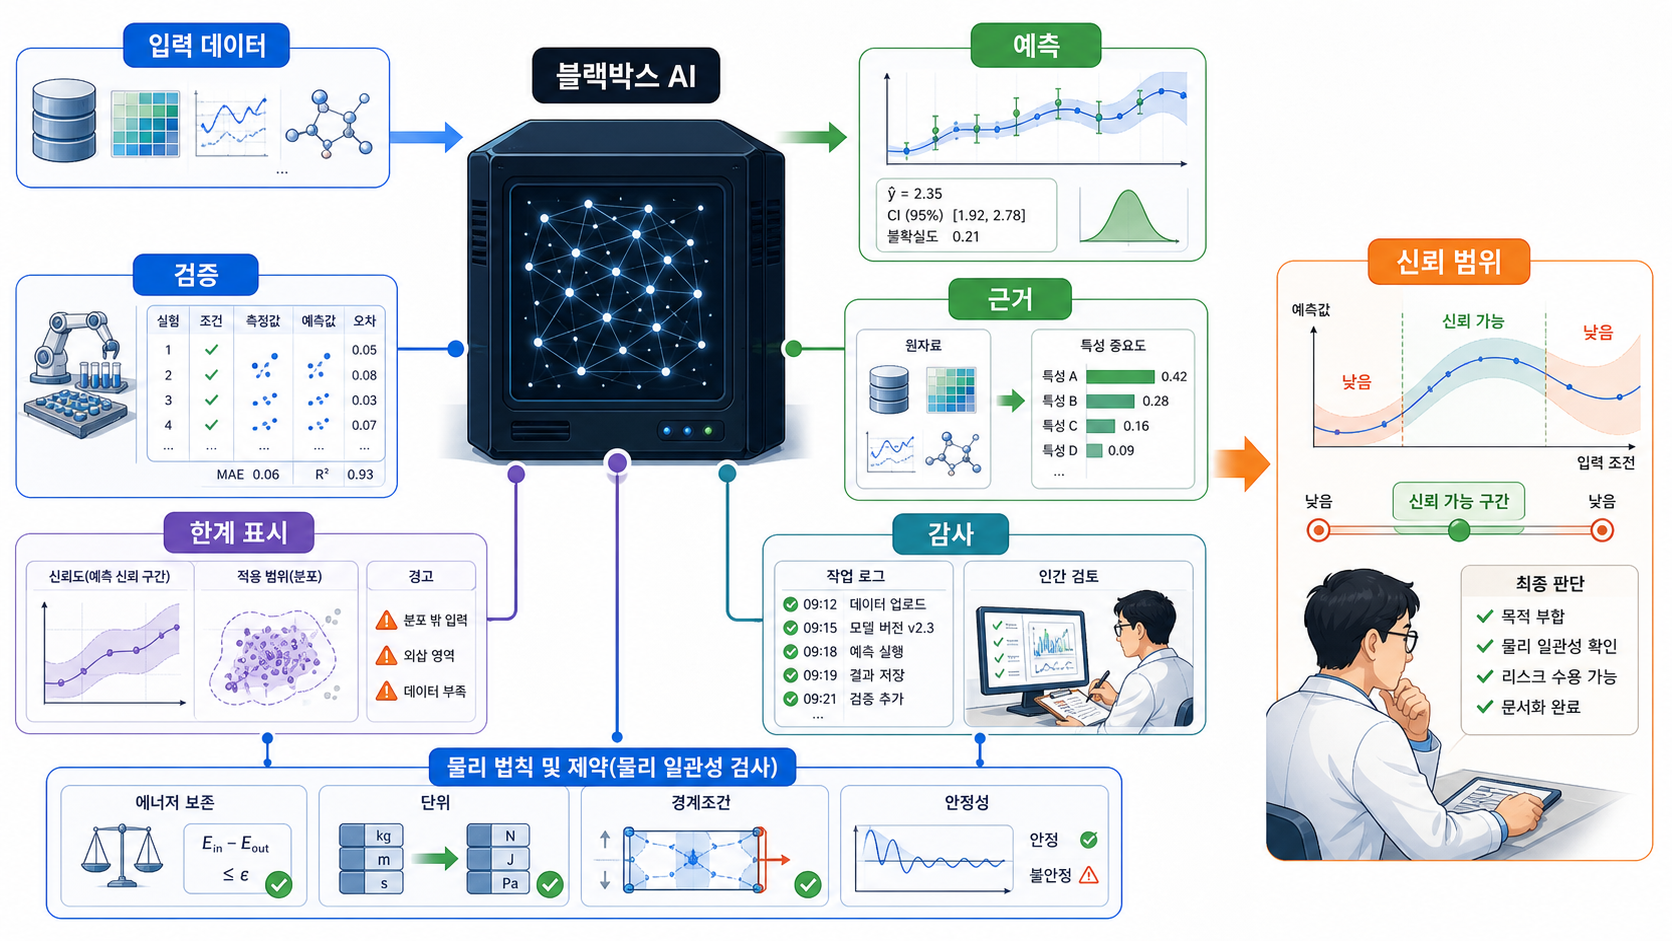
도해 11-4. AI의 내부 과정을 완전히 해석하지 못하더라도 반복 검증과 독립 시험, 불확실성 표시와 물리 법칙 점검을 통해 신뢰할 수 있는 범위를 정할 수 있습니다.
AI의 내부 계산 과정은 사람이 쉽게 따라가기 어려울 때가 많습니다. 입력과 출력은 볼 수 있지만, 그 사이에서 어떤 계산이 어떤 판단으로 이어졌는지 분명히 알기 어려운 모델을 블랙박스(black box)라고 합니다. 대규모 신경망은 수많은 매개변수와 층이 얽혀 작동하기 때문에, 특정 답이 만들어진 경로를 간단한 문장으로 설명하기 어렵습니다. 그렇다고 블랙박스가 곧 믿을 수 없다는 뜻은 아닙니다. 인간 전문가의 판단도 어느 정도는 불투명합니다. 숙련된 의사나 장인은 이상을 빠르게 알아차리지만, 그 판단에 사용한 모든 단서를 즉시 말로 풀어내지 못할 때가 있습니다. 중요한 것은 내부가 복잡하다는 사실 자체가 아니라, 어떤 상황에서 얼마나 믿을 수 있는가입니다.
과학에서 신뢰는 감탄이 아니라 검증에서 생깁니다. 새로운 자료에서도 성능이 유지되는지, 다른 연구자가 독립적으로 시험해도 비슷한 결과가 나오는지, 입력을 조금 바꾸었을 때 예측이 지나치게 흔들리지 않는지 확인해야 합니다. AI의 답이 맞는지만 볼 것이 아니라, 언제 흔들리고 언제 틀리는지도 보아야 합니다. 모델의 확신도 따로 살펴야 합니다. AI가 자신 있게 말한다고 해서 실제로 정확하다는 뜻은 아닙니다. 모델이 표현한 확신과 실제 오류율이 얼마나 잘 맞는지를 확인하는 일을 보정(calibration)이라고 합니다. 좋은 과학 AI는 자신이 잘 모르는 조건에서는 불확실성을 드러낼 수 있어야 합니다.
생성형 AI에는 또 다른 위험이 있습니다. 존재하지 않는 논문, 실제로 측정되지 않은 값, 실행되지 않는 코드, 검증되지 않은 설명을 그럴듯한 문장으로 만들 수 있습니다. 이런 오류를 환각(hallucination)이라고 합니다. 문장이 자연스럽다고 해서 실제 근거가 있는 것은 아니므로, 과학 연구에서는 원자료와 계산 과정, 실험 기록을 반드시 확인해야 합니다.
AI 결과를 재현하려면 최종 문장이나 그래프만 남겨서는 부족합니다. 어떤 데이터를 사용했는지, 전처리를 어떻게 했는지, 모델과 소프트웨어의 버전은 무엇인지, 어떤 조건에서 계산했는지를 함께 기록해야 합니다. 그래야 다른 연구자가 같은 절차를 다시 실행해 비슷한 결론에 도달하는지 확인할 수 있습니다. 물리학은 AI 검증에 유용한 기준을 제공합니다. 예측이 에너지와 질량 보존에 어긋나지 않는지, 단위와 차원이 맞는지, 극한 조건에서 이미 알려진 결과와 연결되는지 확인할 수 있습니다. 재료 예측 모델이라면 물리적으로 존재하기 어려운 구조를 높은 확신으로 제안하지 않는지도 살펴야 합니다.
최근에는 AI의 학습 과정이나 출력에 자연법칙을 반영하려는 시도도 있습니다. 예를 들어 방정식이나 보존 법칙을 모델 안에 넣어 물리적으로 말이 되지 않는 답을 줄이는 방식입니다. 이를 물리 제약 AI(physics-constrained AI)라고 할 수 있습니다. 그러나 법칙을 넣었다고 모든 결과가 자동으로 옳아지는 것은 아닙니다. 그 법칙이 해당 조건에서 유효한지, 입력 자료와 경계 조건이 정확한지는 다시 검토해야 합니다. 설명 가능성(explainability)도 중요합니다. 모델이 어떤 입력을 중요하게 보았는지 표시하거나, 특정 조건을 바꾸었을 때 출력이 어떻게 달라지는지 보여 줄 수 있습니다. 복잡한 모델의 행동을 더 단순한 모델로 근사해 이해하려는 방법도 있습니다. 다만 이런 설명은 실제 내부 계산을 완전히 보여 주기보다 사후적으로 단순화한 해석일 수 있습니다. 보기 좋은 설명이 곧 진짜 판단 이유라고 단정해서는 안 됩니다.
결국 신뢰는 하나의 요소로 결정되지 않습니다. 내부 설명, 외부 검증, 재현 가능성, 물리 법칙과의 일관성, 적용 분야의 위험 수준이 함께 고려되어야 합니다. 사진을 분류하는 AI와 환자의 치료 방향을 제안하는 AI에 같은 수준의 검증을 요구할 수는 없습니다. 오류의 피해가 클수록 더 강한 검증과 인간의 감독이 필요합니다. AI 과학 도구를 평가할 때는 최소한 다음과 같은 질문을 해야 합니다.
이 모델은 정확히 무엇을 예측하는가? 어떤 자료와 조건에서 검증되었는가? 알려진 과학 지식과 어긋나지 않는가? 낯선 조건이나 오류를 만났을 때 이를 알아차릴 수 있는가? 사용자가 책임 있게 판단할 만큼 근거와 한계가 제시되는가?
“AI가 그렇게 말했다”는 말은 과학적 근거가 될 수 없습니다. 어떤 모델이 어떤 자료를 사용해, 어느 조건에서, 어떤 검증을 거쳐 내놓은 결과인지 밝혀야 합니다. 블랙박스 시대의 신뢰는 모든 내부를 완전히 들여다보는 데서만 생기지 않습니다. 무엇을 알고, 무엇을 아직 모르며, 어디까지 믿을 수 있는지를 분명히 정하는 데서 생깁니다.
11.5 인과와 상관
비 오는 날에는 우산을 든 사람이 많습니다. 그렇다고 우산이 비를 내리게 한 것은 아닙니다. 습한 공기와 기압, 구름의 움직임이 비를 만들고, 사람들은 비에 대비해 우산을 듭니다. 두 현상이 함께 나타난다는 사실과 하나가 다른 하나의 원인이라는 주장은 다릅니다.
숨은 원인을 살펴야 하는 상관관계
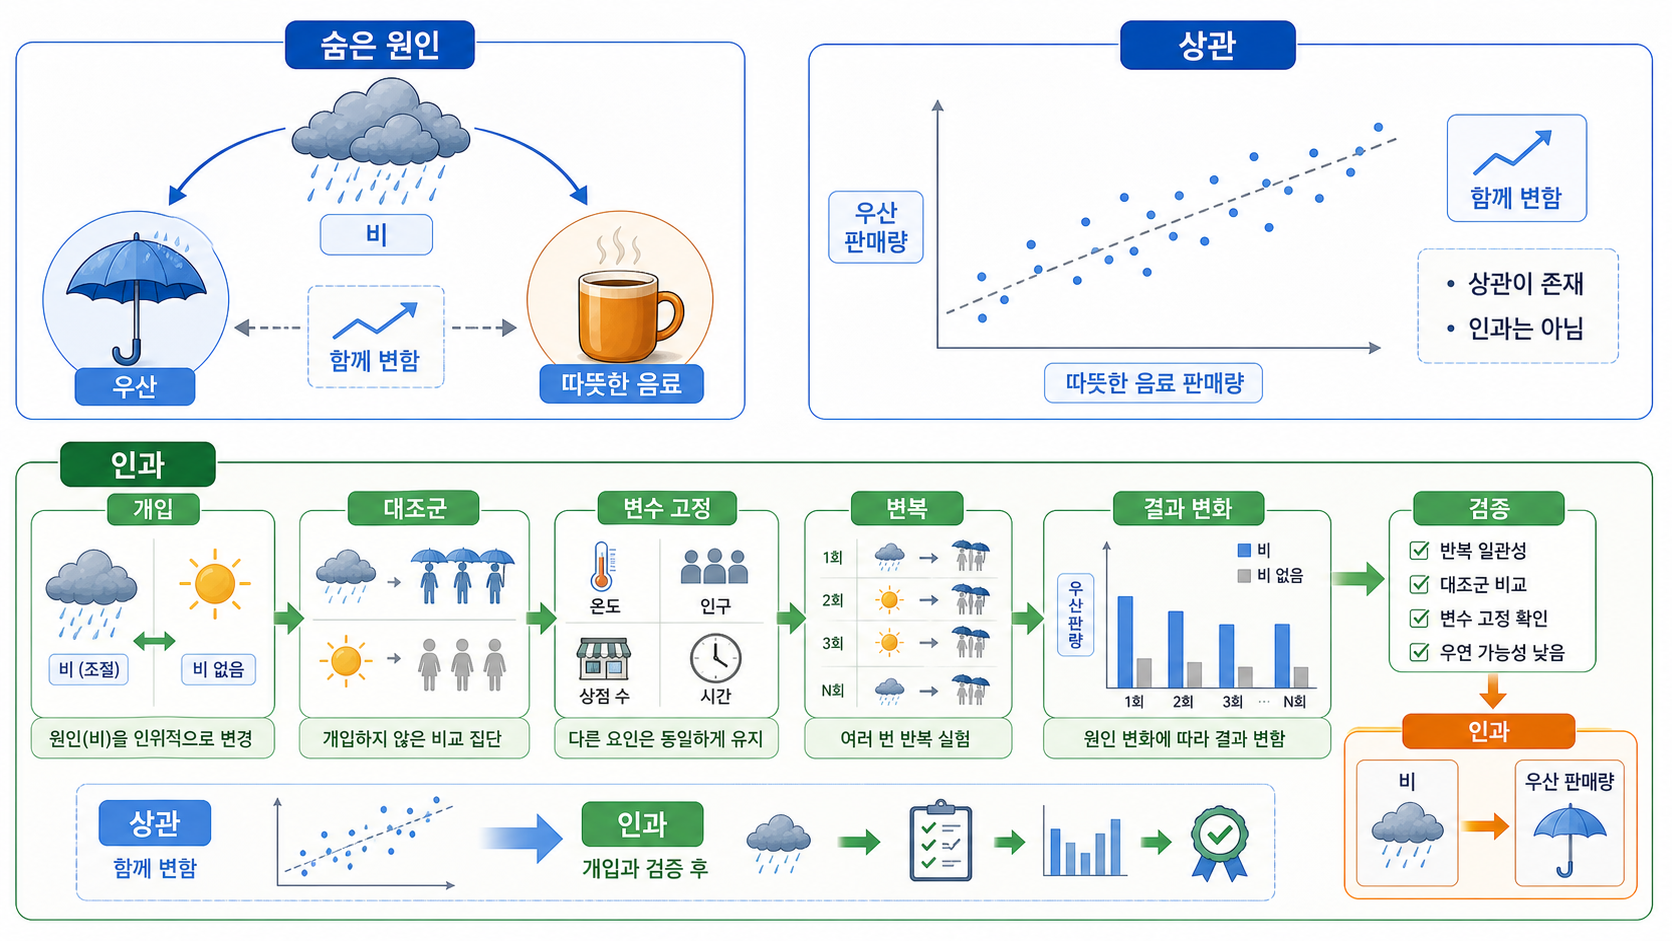
도해 11-5. 두 현상이 함께 변한다는 사실만으로 인과관계를 단정할 수 없습니다. 숨은 변수를 살피고, 적절한 개입과 비교 실험을 통해 원인과 결과를 구분해야 합니다.
AI는 방대한 데이터에서 함께 움직이는 패턴을 찾는 데 뛰어납니다. 특정 생체 신호가 질병과 자주 함께 나타나는지, 어떤 원소 조합이 높은 전도성과 관련되는지, 어느 대기 조건이 폭우에 앞서 나타나는지를 빠르게 찾아낼 수 있습니다. 이렇게 두 현상이 함께 나타나는 관계를 상관관계(correlation)라고 합니다. 상관관계는 질병 위험 예측, 실험 후보 선별, 이상 징후 탐지에 매우 유용합니다. 그러나 과학은 “함께 나타난다”에서 멈추지 않습니다. 한 조건을 실제로 바꾸었을 때 다른 결과가 달라지는지를 묻습니다. 이것이 인과관계(causality)의 질문입니다. 인과관계를 알면 단순한 예측을 넘어 개입할 수 있습니다. 어떤 약물이 특정 생화학 경로를 바꾸어 증상을 완화한다면 용량과 투여 시기를 조절할 수 있고, 어떤 열처리 조건이 재료 구조를 바꾼다면 원하는 성질을 만들도록 공정을 설계할 수 있습니다.
상관에서 인과를 바로 끌어내기 어려운 까닭은 숨은 변수가 있을 수 있기 때문입니다. 아이스크림 판매량과 물놀이 사고가 함께 늘어난다고 해서 아이스크림이 사고를 일으키는 것은 아닙니다. 더운 날씨가 두 현상을 함께 증가시킨 것입니다. 원인과 결과의 방향이 반대일 수도 있습니다. 어떤 물질이 질병을 일으킨다고 생각했지만, 실제로는 질병 때문에 그 물질의 농도가 바뀐 것일 수도 있습니다. 인과를 확인하려면 비교가 필요합니다. 한 조건만 의도적으로 바꾸고 나머지는 가능한 한 같게 유지한 뒤 결과를 살펴봅니다. 이렇게 실제로 조건을 바꾸어 보는 일을 개입(intervention)이라고 합니다. 약물 효과를 확인할 때 치료를 받은 집단과 받지 않은 집단을 비교하는 방식도 여기에 속합니다. 비교 기준이 되는 집단을 대조군(control group)이라고 합니다.
하지만 모든 연구에서 직접 개입할 수 있는 것은 아닙니다. 기후와 천문 현상은 연구자가 마음대로 조작하기 어렵고, 사람에게 위험한 처치를 시험하는 것은 윤리적으로 허용되지 않습니다. 이런 경우에는 시간적 순서, 자연스럽게 발생한 조건 차이, 여러 자료원의 비교를 통해 인과 가능성을 조심스럽게 추정해야 합니다. 인과를 생각할 때는 “다른 조건은 그대로인데 이 요인만 달랐다면 결과가 어떻게 되었을까”라는 질문도 중요합니다. 실제로는 한 대상에게 두 조건을 동시에 적용할 수 없기 때문에, 비교 집단과 통계적 모형으로 보이지 않는 경우를 추정합니다. 이런 질문을 반사실적 질문(counterfactual question)이라고 합니다.
AI가 특정 유전자와 질병 사이의 관계를 발견했다고 해 봅시다. 그 유전자가 질병의 원인일 수도 있지만, 질병에 대한 반응으로 유전자 발현이 달라졌을 수도 있습니다. 생활환경이나 다른 유전적 요인이 두 현상에 함께 영향을 주었을 가능성도 있습니다. 따라서 세포 실험, 동물 모형, 다른 집단에서의 재현, 분자 메커니즘 확인이 함께 필요합니다. AI 공동 연구자나 자동 가설 생성 시스템도 마찬가지입니다. AI는 멀리 떨어져 있던 자료에서 새로운 관계를 빠르게 찾아낼 수 있습니다. 그러나 그 관계는 인과적 결론이 아니라 시험해야 할 후보입니다. 좋은 AI 연구 보조 시스템은 “이 두 변수가 관련 있어 보인다”에서 멈추지 않고, 어떤 변수를 바꾸어야 두 설명을 구분할 수 있는지 제안해야 합니다.
여기서 자동화 실험실의 역할이 중요해집니다. AI가 데이터에서 발견한 관계를 바탕으로 실험 조건을 제안하면, 로봇 실험실은 특정 변수를 실제로 바꾸어 결과를 확인할 수 있습니다. 관찰에서 얻은 상관관계가 개입 실험을 거치며 인과적 가설로 발전하는 것입니다. 그렇다고 실험을 많이 한다고 인과가 저절로 밝혀지는 것은 아닙니다. 여러 조건을 한꺼번에 바꾸면 무엇이 결과를 만들었는지 알기 어렵습니다. 무엇을 바꾸고, 무엇을 그대로 둘지, 어떤 결과가 서로 다른 설명을 가를 수 있는지 먼저 정해야 합니다. 인과를 밝히는 힘은 실험 횟수보다 비교 구조에서 나옵니다.
핵심은 분명합니다. 상관은 탐색할 방향을 보여 주고, 인과는 개입할 근거를 제공합니다. AI는 상관관계를 발견하는 눈을 넓혀 줍니다. 과학은 그 패턴을 대조, 개입, 반복 검증을 통해 행동 가능한 지식으로 바꿉니다. 인과는 데이터가 많아지면 저절로 생기는 것이 아니라, 좋은 질문과 비교 가능한 실험에서 얻어지는 성취입니다.
11.6 환원주의와 복잡성
합창을 녹음한 뒤 각 사람의 목소리를 하나씩 분리해 들으면 많은 사실을 알 수 있습니다. 누가 높은 음을 맡았는지, 누가 박자를 놓쳤는지, 어떤 목소리가 전체 음량에 크게 기여했는지 알 수 있습니다. 그러나 합창의 울림은 각 목소리를 따로 분석한 결과만으로 완전히 설명되지 않습니다. 서로의 음정과 박자, 공연장의 울림, 함께 호흡하는 순간이 전체 소리를 만듭니다.
부분에서 전체로 이어지는 다층적 이해
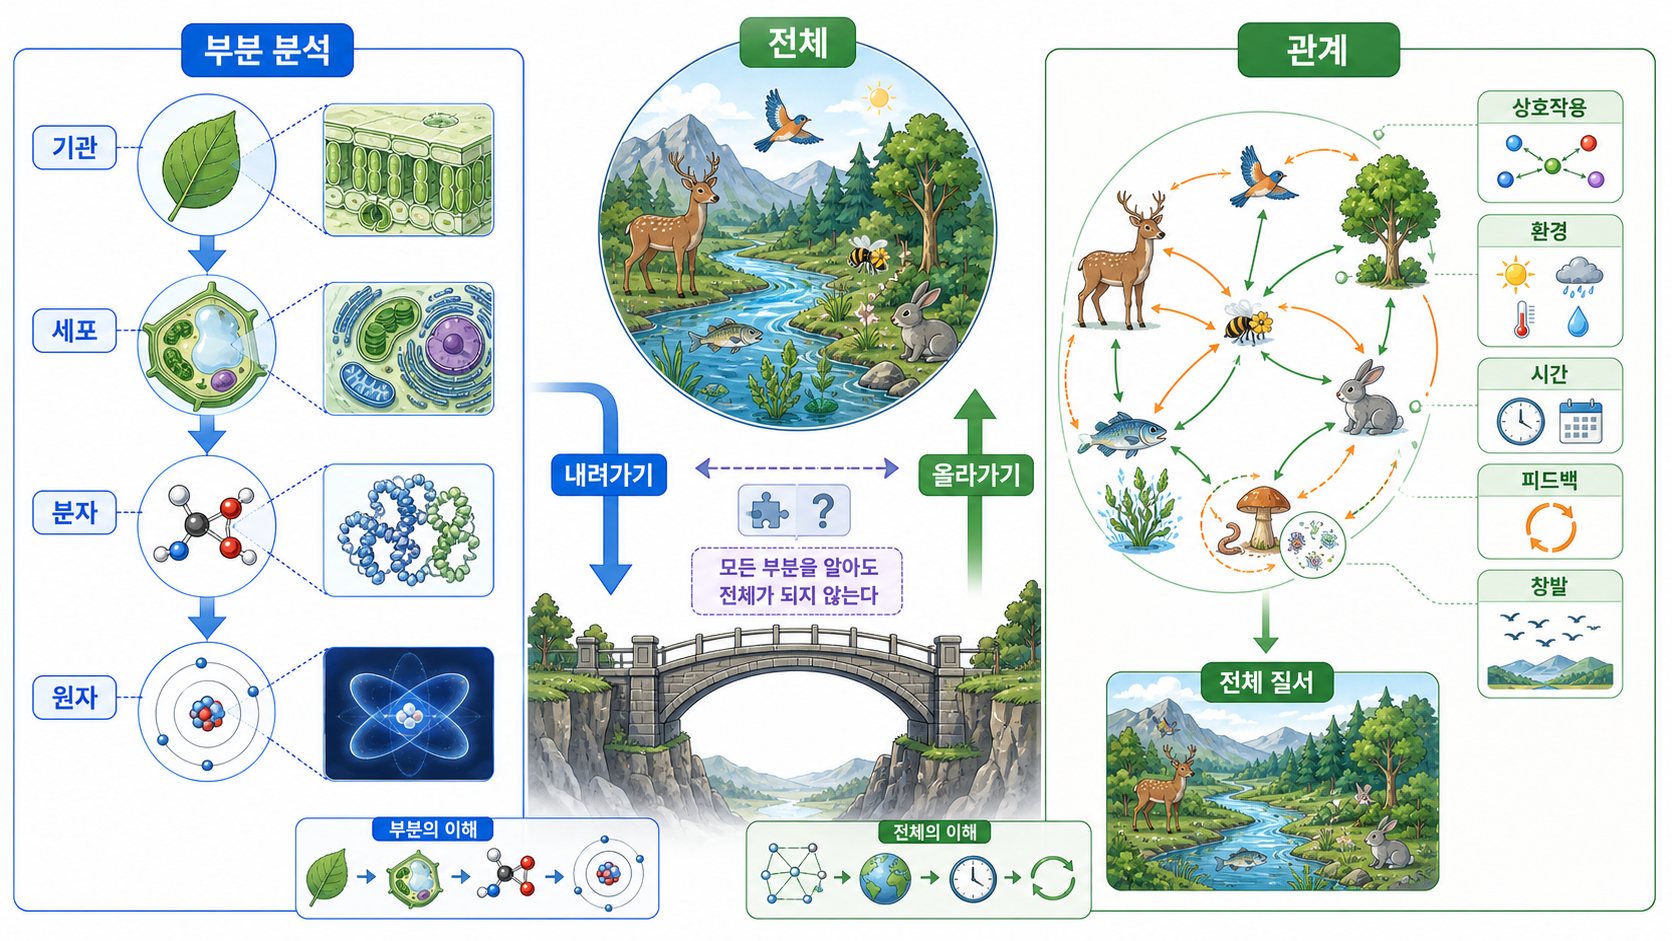
과학적 이해에는 전체를 기관과 세포, 분자와 원자로 나누어 보는 분석과, 상호작용·환경·시간·피드백이 만드는 전체 질서를 다시 연결하는 작업이 함께 필요합니다.
과학도 부분을 나누어 보면서 발전해 왔습니다. 물질을 원자와 입자로, 생명을 세포와 분자로, 뇌를 뉴런과 시냅스로 분석하면서 많은 것을 알아냈습니다. 복잡한 현상을 더 작은 요소와 기본 법칙으로 나누어 이해하려는 접근을 환원주의(reductionism)라고 합니다. 환원주의는 과학의 강력한 도구입니다. 중요한 요소를 분리하고, 변수를 통제하며, 각 부분이 어떤 기능을 하는지 정밀하게 시험할 수 있기 때문입니다. 그러나 부분의 목록만으로 전체의 행동이 곧바로 드러나는 것은 아닙니다. 물 분자 하나에는 파도나 소용돌이라는 성질이 없습니다. 많은 물 분자가 함께 움직일 때 흐름과 파도, 소용돌이가 나타납니다. 이렇게 구성 요소들이 상호작용하면서 개별 요소만으로는 보이지 않던 성질이 나타나는 것을 창발(emergence)이라고 합니다.
창발은 신비한 힘을 뜻하지 않습니다. 전체의 성질도 결국 구성 요소들의 상호작용에서 나옵니다. 다만 그것을 설명하려면 부분의 목록만이 아니라, 부분들이 어떻게 연결되고 어떤 조건에서 함께 움직이는지를 보아야 한다는 뜻입니다. 기체의 온도와 압력도 분자 하나의 성질이 아니라 수많은 분자의 운동이 모여 나타난 거시적 성질입니다. 생명과 기후, 뇌와 사회처럼 많은 요소가 서로 영향을 주고받는 시스템에서는 이런 문제가 더 중요해집니다. 작은 변화가 전체 구조를 바꾸고, 바뀐 전체 구조가 다시 개별 요소의 행동에 영향을 줄 수 있습니다. 이런 되돌림의 과정을 피드백(feedback)이라고 합니다. 여러 층의 요소가 얽혀 피드백을 주고받는 대상을 복잡계(complex system)라고 부를 수 있습니다.
AI는 복잡계를 연구하는 데 큰 도움을 줄 수 있습니다. 사람이 한꺼번에 보기 어려운 많은 변수와 비선형 관계를 찾아내고, 기후·생명·재료·뇌 데이터에서 숨은 패턴을 발견할 수 있습니다. 그러나 높은 예측 성능만으로 어떤 원인이 중요한지, 부분들이 어떻게 전체의 성질을 만드는지 자동으로 설명되는 것은 아닙니다. AI가 패턴을 찾는 능력과 과학자가 그 패턴을 이해하는 능력은 연결되어야 합니다. 알파폴 계열의 사례도 이 점을 잘 보여 줍니다. 단백질과 분자 복합체의 구조 예측은 생명현상을 이해하는 데 매우 중요한 정보를 제공합니다. 구조를 알면 결합 부위, 돌연변이의 영향, 분자 사이의 상호작용을 추정할 수 있습니다. 그러나 살아 있는 세포의 기능은 구조 하나로 결정되지 않습니다. 분자의 농도와 위치, 시간에 따른 움직임, 주변 분자와의 경쟁, 세포와 조직의 상태가 함께 작용합니다.
따라서 분자 구조의 이해에서 질병과 치료의 이해로 나아가려면 여러 층을 연결해야 합니다. 분자에서 세포로, 세포에서 조직으로, 조직에서 몸 전체와 환경으로 이어지는 관계를 보아야 합니다. 작은 층의 설명은 큰 층의 연구를 대신하지 않습니다. 오히려 더 큰 설명으로 나아가기 위한 출발점이 됩니다. AI 모델 자체도 복잡한 대상입니다. 대규모 신경망은 많은 층과 매개변수가 상호작용하며 작동합니다. 때로는 모델의 규모가 커지면서 이전에는 잘 보이지 않던 능력이 나타나는 것처럼 보이기도 합니다. 그러나 이런 현상을 곧바로 신비한 창발로 부르기보다는, 어떤 데이터와 학습 과정, 내부 구조가 그 능력을 만들었는지 다시 분석해야 합니다.
결국 환원주의와 복잡성은 서로 반대편에만 서 있지 않습니다. 부분을 나누어 보지 않으면 무엇이 중요한지 알기 어렵고, 부분을 다시 연결하지 않으면 전체의 행동과 맥락을 놓치게 됩니다. 좋은 과학적 설명은 질문에 맞추어 여러 수준을 오갑니다. 물질의 성질을 전자의 운동으로 설명하면서도 결정 구조를 함께 보고, 질병을 분자의 변화로 분석하면서도 면역계와 생활환경을 함께 고려해야 합니다. AI 과학의 좋은 설명도 마찬가지입니다. 데이터 속 작은 패턴을 찾는 데서 멈추지 않고, 그 패턴이 더 큰 구조와 어떤 관계를 맺는지 보여 주어야 합니다. 이해는 모든 것을 하나의 작은 원인으로 줄이는 일이 아닙니다. 부분을 분석하고, 다시 관계 속에 놓으며, 여러 층의 설명을 연결할 때 깊어집니다.
11.7 예측 가능한 세계와 이해 가능한 세계
제빵사는 반죽이 어느 정도 부풀지 경험으로 예상합니다. 온도, 효모의 양, 밀가루의 성질, 발효 시간이 결과에 영향을 준다는 것을 알기 때문입니다. 그러나 같은 조리법을 써도 습도와 재료의 상태, 반죽의 미세한 차이에 따라 빵의 질감은 조금씩 달라집니다. 어떤 현상은 정밀하게 예측할 수 있지만, 어떤 현상은 가능한 범위와 경향만 말할 수 있습니다.
예측 가능한 세계와 이해 가능한 세계
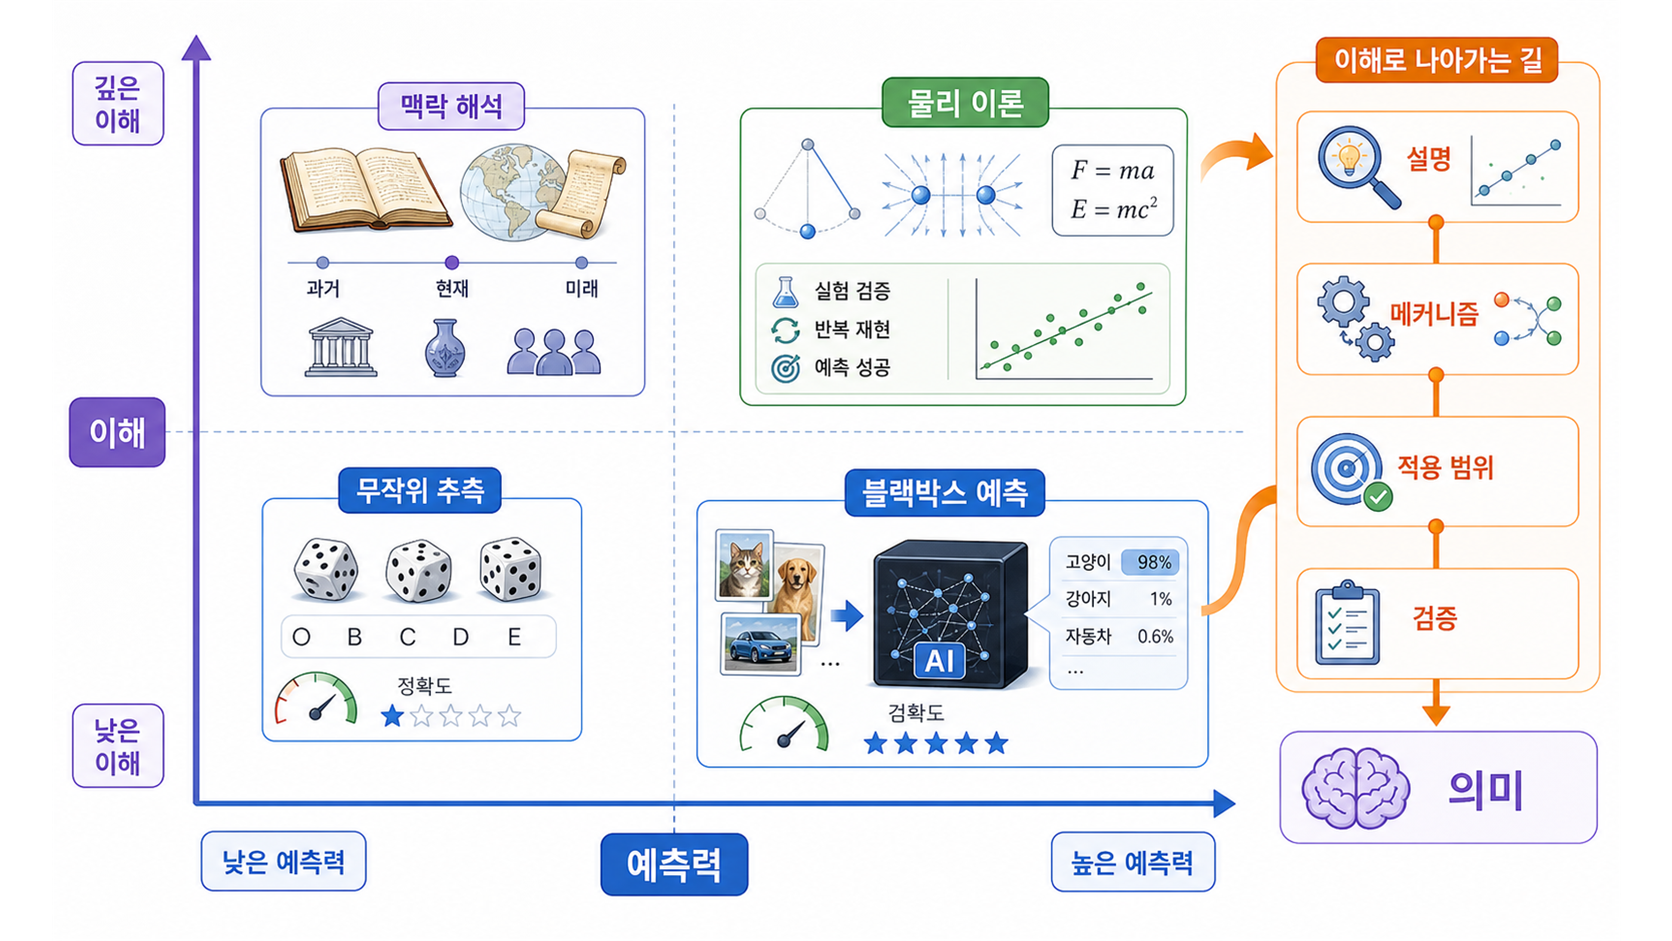
높은 예측력과 깊은 이해는 동일한 척도가 아닙니다. AI의 예측이 설명과 메커니즘, 적용 범위와 검증을 만날 때 과학적 이해에 가까워집니다.
물리학은 자연을 예측하는 강력한 방법을 보여 주었습니다. 천체의 운동과 전자기 현상은 매우 높은 정확도로 계산할 수 있습니다. 양자역학은 개별 사건이 아니라 결과들의 확률 분포를 정밀하게 예측합니다. 열역학은 수많은 입자의 움직임을 하나하나 알지 못해도 계 전체가 어느 방향으로 변할지 설명합니다. 그러나 모든 세계가 같은 방식으로 예측되는 것은 아닙니다. 날씨처럼 초기의 작은 차이가 시간이 지나며 크게 증폭되는 현상에서는 먼 미래를 정확히 맞히기 어렵습니다. 이런 대상을 혼돈계(chaotic system)라고 합니다. 생명과 사회처럼 환경, 역사, 선택, 피드백이 얽힌 대상에서는 예측의 한계가 더 복잡해집니다. 예측의 어려움은 단순히 데이터가 부족해서만 생기는 것이 아닙니다. 대상의 구조와 질문의 성격에 따라 예측 가능성 자체가 달라집니다.
AI는 이 예측의 범위를 넓혀 줍니다. 사람이 한눈에 보기 어려운 관계를 찾고, 방대한 자료에서 반복되는 패턴을 학습합니다. 단백질 구조와 재료 성질을 예측하고, 기상모형을 보완하며, 의료영상에서 이상 징후를 찾고, 다음 실험 조건을 제안할 수 있습니다. AI는 과학이 더 넓은 가능성을 더 빠르게 탐색하도록 돕습니다. 하지만 예측이 정확해졌다고 해서 현상을 같은 깊이로 이해한 것은 아닙니다. 거대한 신경망이 이미지를 정확히 분류하더라도 어떤 특징이 판단에 결정적으로 작용했는지, 새로운 환경에서도 같은 기준이 유지되는지는 따로 확인해야 합니다. 맞히는 능력과 설명하는 능력은 서로 연결되지만 같은 것은 아닙니다.
반대의 경우도 있습니다. 어떤 현상은 정확히 예측하기 어렵지만 의미 있게 이해할 수 있습니다. 역사적 사건이나 인간의 선택은 수학적으로 완벽하게 예측하기 어렵습니다. 그러나 당시의 제도, 이해관계, 행위자의 동기, 사회적 맥락을 살피면 왜 그런 방향으로 전개되었는지 이해할 수 있습니다. 예측력과 이해의 깊이는 언제나 같은 방향으로 움직이지 않습니다. 이 강의의 목적은 예측과 이해를 갈라놓는 데 있지 않습니다. 둘의 관계를 정확히 보는 데 있습니다. 예측의 성공은 설명을 찾게 하고, 좋은 설명은 아직 관측하지 않은 결과를 예측하게 합니다. 과학은 예측과 설명이 서로를 시험하고 수정하도록 만드는 과정입니다.
AI가 연구 아이디어를 내고, 실험 조건을 제안하고, 결과를 정리해 논문 형태의 문서를 만들 수 있는 시대가 오고 있습니다. 그러나 문서의 형식이 갖추어졌다고 해서 과학적 이해가 완성되는 것은 아닙니다. 주장이 새롭고 중요한지, 실험이 적절한지, 다른 연구자가 재현할 수 있는지, 대안적 설명을 검토했는지 확인해야 합니다. AI가 과학의 여러 단계를 자동화할수록 검토와 해석은 더 중요해집니다. 좋은 AI 과학은 예측의 힘을 이해의 전부로 착각하지 않습니다. 예측이 어디에서 잘 맞고 어디에서 무너지는지 살피며, 그 성공과 실패를 통해 자연에 대한 설명을 더 정교하게 만들어 갑니다.
11.8 설명 가능한 AI와 물리학
항공기 조종석에는 속도, 고도, 연료량, 엔진 상태, 방향, 기상 조건을 보여 주는 계기판이 있습니다. 조종사는 비행기가 움직인다는 사실만 보지 않습니다. 어떤 신호가 정상 범위에 있고, 어떤 신호가 위험을 알리는지 함께 살핍니다. 과학에서 AI를 사용할 때도 마찬가지입니다. 모델이 답을 내놓았다는 사실보다, 그 답을 어떤 근거와 조건 안에서 믿을 수 있는지가 중요합니다.
설명 가능한 AI와 물리학
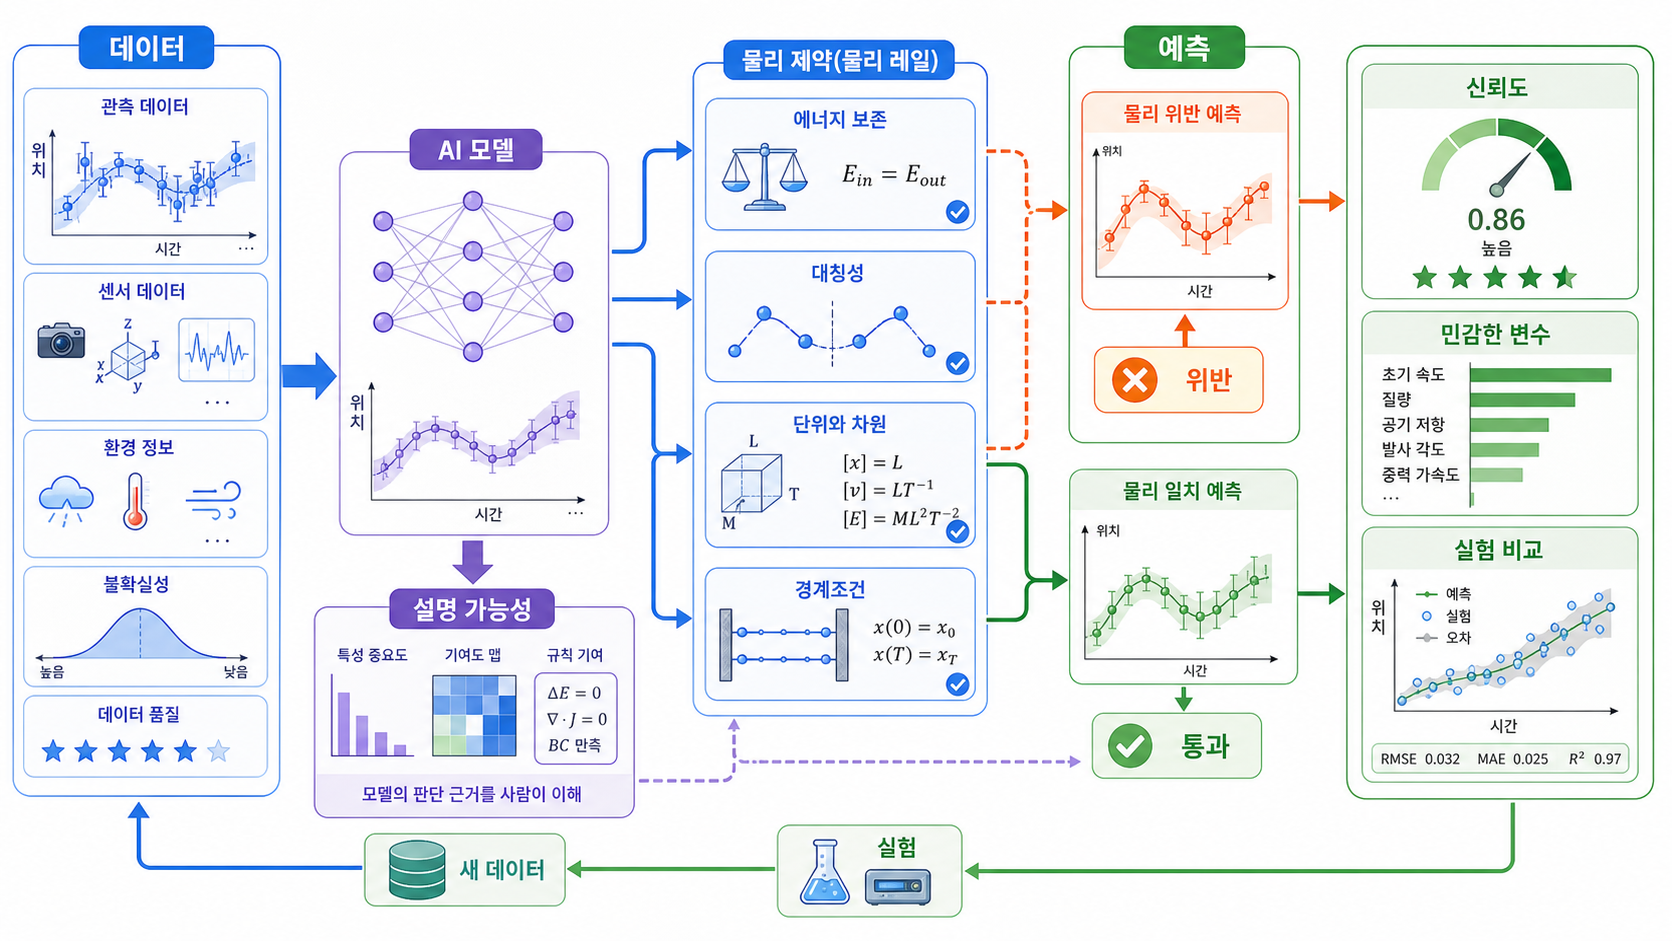
에너지 보존과 대칭성, 단위와 차원, 초기·경계 조건은 AI의 예측을 물리적으로 점검하는 기준입니다. 다만 이러한 제약도 가정과 적용 범위를 함께 밝혀야 합니다.
AI가 어떤 입력에 민감했는지, 어떤 특징이 결과에 영향을 주었는지, 어느 조건에서 신뢰가 낮아지는지를 사람이 살펴볼 수 있게 하는 접근을 설명 가능한 AI(explainable AI)라고 합니다. 예를 들어 이미지의 어느 부분을 중요하게 보았는지 표시하거나, 어떤 변수를 바꾸었을 때 예측이 어떻게 달라지는지 보여 줄 수 있습니다. 이런 방법은 모델을 점검하는 데 유용한 단서를 줍니다. 그러나 보기 좋은 설명이 곧 실제 판단 과정을 완전히 보여 주는 것은 아닙니다. 입력을 조금만 바꾸어도 설명이 흔들릴 수 있고, 서로 다른 설명 방법이 서로 다른 이유를 제시할 수도 있습니다. 따라서 설명 가능한 AI의 목표는 그럴듯한 해설을 붙이는 데 있지 않습니다. 모델의 예측을 검토하고, 반례를 찾고, 어디까지 믿을 수 있는지 확인하게 만드는 데 있습니다.
물리학은 이 검토에 강력한 기준을 제공합니다. 어떤 계에서는 에너지와 질량이 함부로 사라지거나 생겨나서는 안 됩니다. 단위와 차원도 맞아야 합니다. 길이와 시간을 그대로 더하거나, 에너지와 힘을 같은 물리량처럼 다루는 식은 과학적 의미를 갖기 어렵습니다. AI가 복잡한 예측을 내놓더라도 이런 기본 기준을 적용하면 명백한 오류를 걸러낼 수 있습니다. 또한 물리적으로 같은 상황이라면 좌표를 옮기거나 회전해도 본질적인 결과는 같아야 할 때가 많습니다. 이런 성질을 대칭성(symmetry)이라고 합니다. AI 모델이 이런 대칭성을 반영하면, 물리적으로 말이 되지 않는 예측을 줄일 수 있습니다. 보존 법칙과 대칭성, 단위의 일관성은 AI가 현실과 만나는 첫 번째 점검표가 됩니다.
최근에는 이런 물리 지식을 모델 안에 직접 넣으려는 시도도 있습니다. 예를 들어 AI가 데이터를 맞히는 동시에 알려진 방정식이나 보존 법칙을 크게 벗어나지 않도록 학습시키는 방식입니다. 이를 물리정보 신경망(physics-informed neural network) 또는 물리 제약 AI(physics-constrained AI)라고 부를 수 있습니다. 물리적으로 가능한 해의 범위를 좁히면 적은 데이터에서도 더 안정적인 예측을 얻을 수 있습니다. 하지만 물리 법칙을 넣었다고 모델이 자동으로 참이 되는 것은 아닙니다. 사용한 법칙이 지나치게 단순하거나 특정 조건에서만 성립하는 근사일 수 있습니다. 마찰과 외부 에너지 유입이 있는 열린 계에 닫힌 계의 보존 법칙을 그대로 적용하면 오히려 잘못된 제약이 될 수 있습니다. 따라서 어떤 물리 가정을 넣었고, 그 가정이 어느 조건에서 유효한지를 함께 밝혀야 합니다.
설명 가능한 AI의 가치는 “왜 그런 답이 나왔는지”를 말처럼 꾸미는 데 있지 않습니다. 어떤 증거가 예측을 뒷받침하는지, 어떤 변수를 바꾸면 결과가 달라지는지, 어느 조건에서 실패하는지를 시험하게 하는 데 있습니다. 좋은 설명은 답을 마무리하는 문장이 아니라, 다음 검증으로 이어지는 길입니다. 과학 AI를 평가할 때는 몇 가지 질문이 필요합니다. 어떤 자료에서 배웠는가. 어떤 변수와 관계를 중요하게 보았는가. 알려진 물리 법칙과 어긋나지 않는가. 사용한 가정은 무엇인가. 새로운 조건에서도 작동하는가. 예측이 틀렸을 때 이를 알아차릴 방법이 있는가.
이 질문에 답한다는 것은 모델 내부의 모든 계산을 사람이 완전히 이해해야 한다는 뜻은 아닙니다. 복잡한 모델에서는 완전한 해석이 불가능할 수도 있습니다. 대신 모델의 행동을 반복해서 시험하고, 물리적·통계적 기준과 비교하며, 신뢰할 수 있는 사용 범위를 정해야 합니다. 설명 가능한 AI에서 설명이란 소프트웨어 기능이라기보다 과학적 태도에 가깝습니다. 설명은 AI의 답을 아름답게 포장하는 일이 아닙니다. 그 답이 어떤 근거와 가정 위에 서 있으며, 어디에서 현실과 만나는지 공개하는 일입니다. AI의 예측이 검증 방법과 실패 조건을 함께 제시할 때, 우리는 그 결과를 맹목적으로 따르지 않고 과학적 판단의 한 요소로 사용할 수 있습니다.
11.9 AI가 이론을 만들 수 있는가
새로운 악보에는 모든 음표가 적혀 있을 수 있습니다. 그러나 그 음악이 어떤 전통과 대화하는지, 왜 특정 부분에서 긴장이 높아지고 침묵이 이어지는지를 이해하려면 음표의 배열을 넘어선 해석이 필요합니다. 과학 이론도 수식과 예측값의 목록만은 아닙니다. 흩어진 사실을 하나의 개념과 원리로 연결하고, 아직 보지 못한 현상을 새롭게 묻게 하는 지적 구조입니다. AI가 과학 이론을 만들 수 있는가라는 질문은 이제 단순한 공상만은 아닙니다. AI는 데이터에서 방정식 후보를 찾고, 새로운 알고리즘을 만들며, 가설과 실험 계획을 제안할 수 있습니다. 많은 후보를 빠르게 평가해 기존 방법보다 나은 해결책을 찾는 데도 강점을 보입니다. 그러나 새로운 수식이나 성능 좋은 알고리즘을 찾았다고 해서 곧바로 새로운 과학 이론이 만들어진 것은 아닙니다.
AI로 만든 이론 후보가 통과해야 할 과정
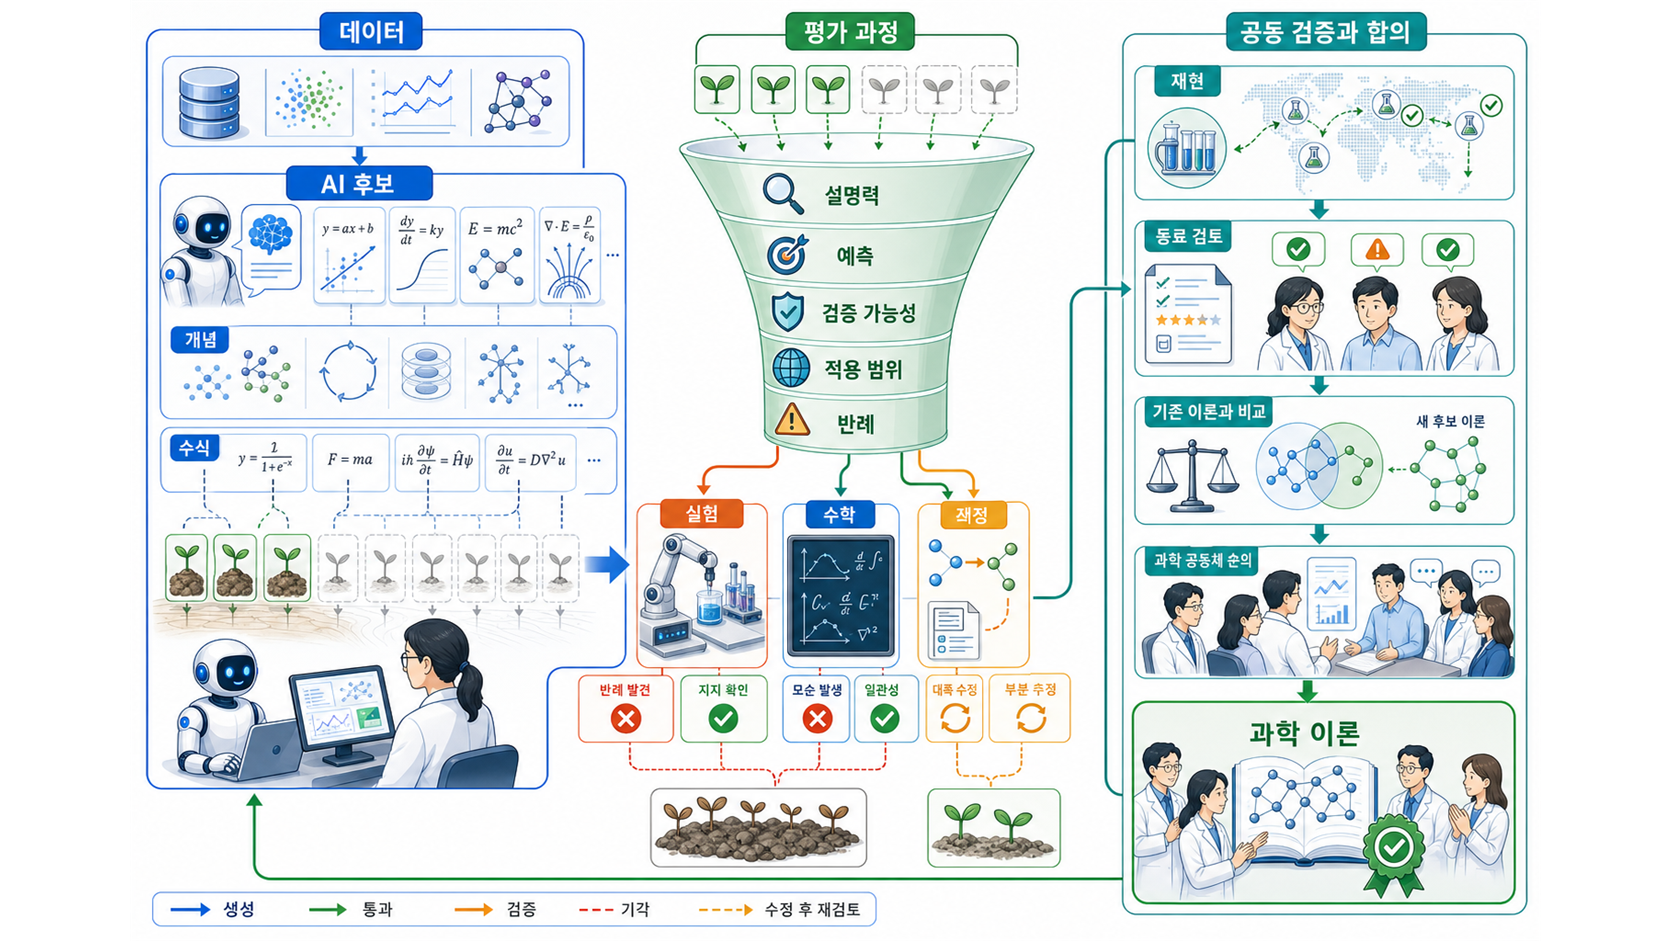
AI가 제안한 개념과 수식이 과학 이론이 되려면 설명력과 예측력, 검증 가능성과 적용 범위, 반례와 재현성, 동료 검토를 통과해야 합니다.
과학 이론에는 몇 가지 조건이 필요합니다. 먼저 개념이 있어야 합니다. 세계의 어떤 대상을 하나로 묶고, 어떤 차이를 중요하게 볼지 정해야 합니다. 질량, 에너지, 유전자, 장, 시공간 같은 개념은 단순한 이름이 아니라 현상을 바라보는 방식을 바꾸었습니다.
둘째, 개념들 사이의 관계와 원리가 필요합니다. 어떤 조건에서 무엇이 변하고, 어떤 양이 보존되며, 서로 다른 현상이 왜 같은 법칙으로 설명되는지를 보여 주어야 합니다. 셋째, 적용 범위가 있어야 합니다. 뉴턴 역학은 일상적 속도와 규모에서 매우 정확하지만, 빛에 가까운 속도나 강한 중력장에서는 상대성이론이 필요합니다. 좋은 이론은 자신이 어디에서 잘 맞고 어디에서 수정되어야 하는지도 드러냅니다.
넷째, 시험 가능해야 합니다. 어떤 관측이 나오면 이론이 지지되고, 어떤 결과가 나오면 수정되거나 버려져야 하는지가 분명해야 합니다. 모든 결과를 나중에 그럴듯하게 설명할 수 있는 주장은 과학적 검증을 받기 어렵습니다. 좋은 이론은 틀릴 가능성을 열어 둡니다.
AI는 이 과정의 여러 부분을 도울 수 있습니다. 방대한 자료에서 단순한 수학적 관계를 찾고, 멀리 떨어진 연구 결과를 연결하며, 사람이 쉽게 떠올리지 못한 가설의 조합을 제안할 수 있습니다. 데이터와 잘 맞는 방정식 후보를 찾는 기호 회귀(symbolic regression), 수학적 성질을 확인하는 자동 추론(automated reasoning), 문헌을 비교해 충돌하는 가설을 정리하는 언어 모델이 모두 여기에 포함됩니다. 하지만 데이터와 잘 맞는 식이 곧 올바른 이론은 아닙니다. 매개변수가 많은 식은 이미 관측된 자료를 정밀하게 따라가면서도 새로운 조건에서는 실패할 수 있습니다. 제한된 자료 안에서는 서로 다른 방정식이 거의 같은 예측을 내놓을 수도 있습니다. 따라서 이론 후보에는 적합도뿐 아니라 간결성, 일반성, 새로운 예측 능력, 물리적 의미가 필요합니다.
AI가 만든 개념이 인간의 기존 언어로 바로 번역되지 않을 가능성도 있습니다. 어떤 내부 표현은 예측에는 유용하지만 연구자가 익숙한 물리적 개념으로 해석하기 어려울 수 있습니다. 그래도 그 표현이 새로운 실험을 설계하고 이전에 몰랐던 현상을 예측하게 한다면 과학적 가치를 가질 수 있습니다. 다만 계산에 유용한 모형과 세계를 이해하게 하는 이론이 언제 같은지, 언제 다른지는 계속 따져 보아야 합니다. AI 공동 연구자(AI co-scientist)나 자동 연구 시스템도 이론 형성의 초기 단계에 참여할 수 있습니다. 새로운 가설을 제안하고, 실험 코드를 작성하며, 결과를 분석해 다음 실험을 추천할 수 있습니다. 그러나 AI가 만든 논문 초안이나 연구 보고서는 과학적 검토의 끝이 아니라 시작입니다. 인용한 자료가 정확한지, 코드가 실제로 작동하는지, 데이터 처리 과정에서 유리한 결과만 선택하지 않았는지 확인해야 합니다.
이론은 개인이나 기계가 혼자 소유하는 답안이 아닙니다. 연구 공동체가 비판과 검증을 통해 다듬는 공적 지식입니다. 하나의 후보가 이론으로 받아들여지려면 실험, 수학적 분석, 독립적 재현, 동료 검토를 통과해야 합니다. AI가 제안했다는 사실은 흥미로운 출발점일 수 있지만, 신뢰의 근거가 되지는 않습니다. 그렇다고 AI는 후보만 만들고 인간만 의미를 부여한다고 단순히 나눌 필요도 없습니다. AI는 가설을 만들고, 이론 간의 관계를 분석하고, 반례를 찾고, 새로운 실험을 설계하는 데 점점 깊이 참여할 수 있습니다. 미래에는 인간과 AI가 개념, 수학, 실험을 주고받으며 이론을 공동으로 형성하는 장면도 가능해질 것입니다.
여기서 중요한 질문은 “AI가 혼자 이론을 만들 수 있는가”보다 “AI가 제안한 관계가 어떤 과정을 거쳐 검증 가능한 개념과 설명, 공적으로 신뢰받는 이론이 되는가”입니다. 이론은 좋은 예측식 하나가 아닙니다. 세계의 여러 현상을 연결하고, 새로운 질문을 가능하게 하며, 틀릴 위험을 감수하는 검증 가능한 언어입니다. AI는 그 언어를 만드는 과정에 참여할 수 있지만, 그 언어가 과학이 되려면 여전히 검증과 해석, 책임의 과정을 지나야 합니다.
11.10 인문학적 해석: 이해는 책임 있는 관계다
소크라테스의 철학은 자신이 무엇을 모르는지를 아는 데서 출발합니다. AI 시대의 과학에도 이 태도가 필요합니다. AI가 놀라운 예측과 매끄러운 설명을 제시할수록 우리는 너무 빨리 “이제 알았다”고 말하고 싶어집니다. 그러나 이해는 답을 얻는 것만이 아닙니다. 그 답이 어떤 자료와 가정에서 나왔고, 어느 조건에서 맞으며, 어디에서 무너지는지를 아는 일입니다.
이해는 책임 있는 관계
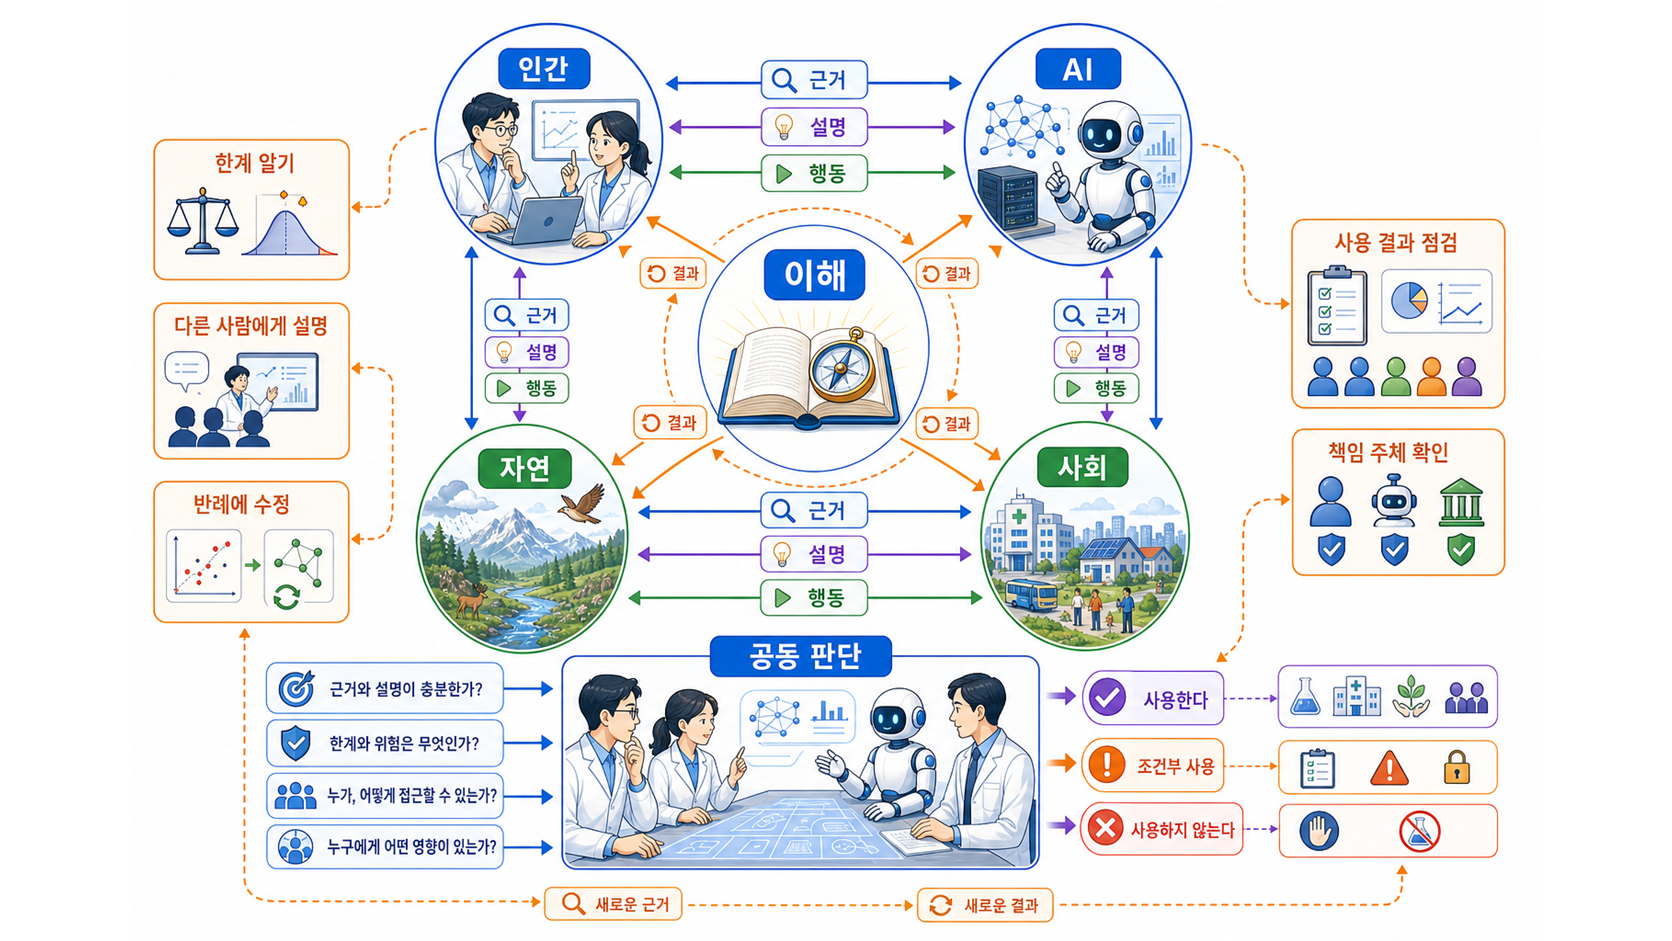
이해란 답을 소유하는 상태가 아니라 인간, AI, 자연, 사회가 근거와 한계를 공유하고 사용 결과를 살피며 함께 책임지는 관계입니다.
AI는 과학의 예측 능력을 크게 넓혀 줍니다. 실험 후보를 만들고, 복잡한 자료에서 패턴을 찾으며, 새로운 가설과 설명의 실마리를 제안할 수 있습니다. 그러나 AI가 많이 맞힌다고 해서 과학적 이해가 자동으로 완성되지는 않습니다. 예측은 원인, 메커니즘, 적용 범위, 불확실성, 반례와 검증을 통과할 때 비로소 이해에 가까워집니다. AI가 더 많은 가능성을 더 빠르게 내놓을수록 인간의 책임은 줄어들지 않습니다. 오히려 무엇을 검증하고, 무엇을 보류하며, 어떤 실험을 허용할지 판단하는 책임은 더 커집니다. 잘못된 데이터와 코드, 과도한 결론과 위험한 실험 제안 앞에서 “AI가 만들었다”는 말은 책임의 설명이 될 수 없습니다. 모델을 설계한 사람, 데이터를 제공한 사람, 결과를 검토한 연구자, 실험을 승인한 기관의 책임이 분명해야 합니다.
이해는 책임 있는 관계입니다. 이것은 과학적 사실과 가치 판단을 뒤섞자는 뜻이 아닙니다. 현상이 실제로 어떻게 일어나는지를 밝히는 일과, 그 지식을 어떻게 사용할지를 결정하는 일은 구별되어야 합니다. 그러나 연구 주제를 고르고, 데이터를 모으고, 위험을 허용하는 과정에는 이미 판단이 들어갑니다. 과학적 지식이 사회적 행동으로 이어지는 순간, 우리는 그 사용에 대한 책임을 피할 수 없습니다. AI 시대의 겸손은 기술을 두려워하는 태도가 아닙니다. AI가 잘하는 일을 정확히 인정하면서도, 아직 모르는 것을 숨기지 않는 태도입니다. 예측의 성공을 기뻐하되, 그것을 이해의 완성으로 부풀리지 않는 태도입니다. 더 많이 맞히는 능력보다 중요한 것은 왜 맞았는지 묻고, 언제 틀릴 수 있는지 밝히며, 그 지식이 가져올 결과까지 살피는 일입니다.
AI와 함께하는 과학은 예측이라는 강력한 엔진을 얻었습니다. 그러나 속도만으로 방향을 정할 수는 없습니다. 설명과 검증, 겸손과 책임이 그 방향을 잡아야 합니다. 우리가 지향해야 할 과학적 이해는 세계를 완전히 소유하는 일이 아니라, 우리가 만든 모델과 설명이 어디까지 닿는지 알고, 닿지 않는 영역 앞에서 다시 질문하는 능력입니다.
제12강. 시민의 AI 교양
오래된 마을에 공동 우물이 있습니다. 우물은 목마른 사람에게 물을 내어 주지만, 마을을 대신 살아 주지는 않습니다. 가뭄이 들었을 때 물을 어떻게 나눌지, 우물이 더러워지면 누가 고칠지, 어린아이가 빠지지 않도록 어떤 울타리를 세울지는 마을 사람들이 함께 결정해야 합니다.
AI 물리학: 시민 교양의 새로운 지도
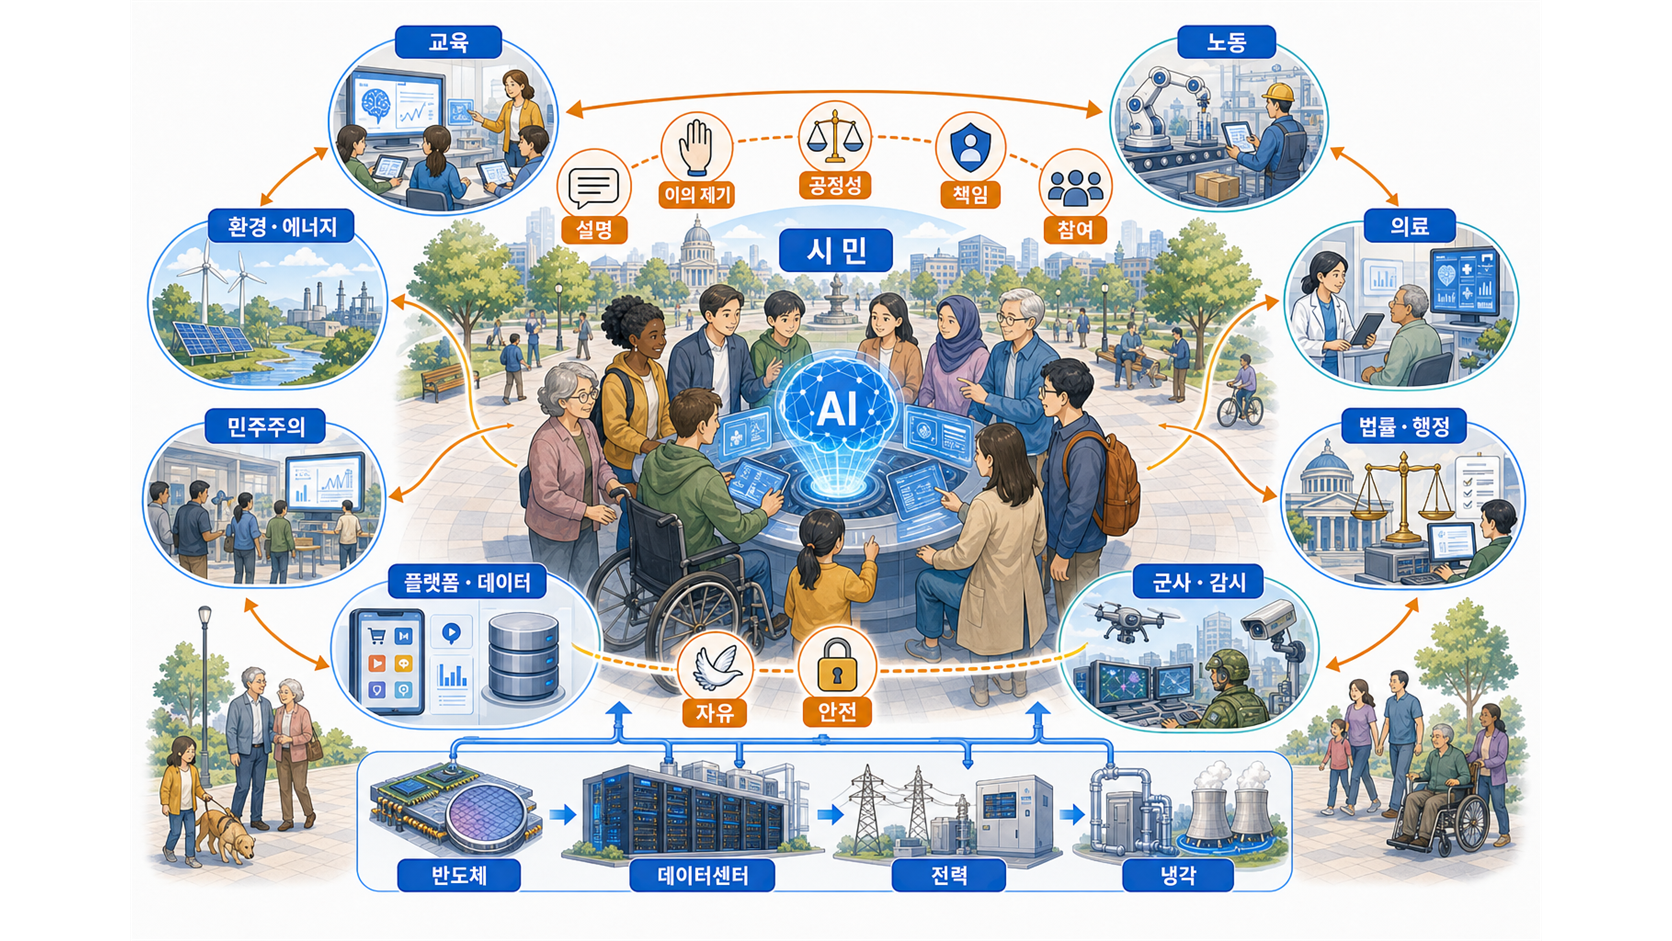
AI 물리학은 시민이 기술을 숭배하거나 두려워하기 전에 교육과 노동, 의료와 법률, 플랫폼과 민주주의가 AI를 통해 어떻게 연결되는지 살펴보게 하는 새로운 교양 지도입니다.
우물은 삶을 돕는 기술이지만, 물을 나누는 질서는 공동체의 몫입니다. AI도 이와 같습니다. 언어를 번역하고, 질병의 징후를 찾고, 복잡한 자료에서 패턴을 발견하며, 기계의 움직임을 계획하는 놀라운 도구입니다. 그러나 어떤 판단을 AI에 맡길지, 어느 순간 사람이 개입해야 할지, 오류로 피해가 생겼을 때 누가 책임질지는 AI가 스스로 결정할 수 없습니다. 그 선택은 시민과 제도, 전문가와 공동체가 함께 내려야 합니다. 우리는 앞선 열두 강에서 물리학의 언어로 AI를 살펴보았습니다. 데이터와 법칙, 확률과 에너지, 물질과 생명, 기후와 우주, 양자와 열역학, 자동화 실험과 과학적 이해를 따라왔습니다. 그 여정 끝에서 마주하는 질문은 기술의 성능을 넘어섭니다.
AI라는 거대한 힘을 우리는 어떤 사회적 조건 속에서 사용할 것인가?
시민의 AI 교양은 모든 사람이 개발자가 되어야 한다는 주장이 아닙니다. 기술을 숭배하거나 막연히 두려워하지 않고, 그 힘이 어디에서 오며 누구에게 어떤 영향을 미치는지 읽는 능력입니다. 공동의 우물을 함께 돌보듯, 사회가 사용하는 지능의 도구를 함께 이해하고 돌보는 일입니다.
12.1 왜 시민에게 AI 물리학이 필요한가
비가 자주 내리는 지역에 사는 사람은 하늘을 지배할 수 없습니다. 그러나 구름의 움직임, 강의 수위, 배수로와 대피로의 위치를 알면 위험 앞에서 더 나은 선택을 할 수 있습니다. 모든 사람이 기상학자가 될 필요는 없지만, 경보가 무엇을 뜻하고 어디까지 믿을 수 있는지는 이해해야 합니다. AI 시대의 시민에게도 이와 같은 감각이 필요합니다.
시민에게 AI 물리학이 필요한 이유
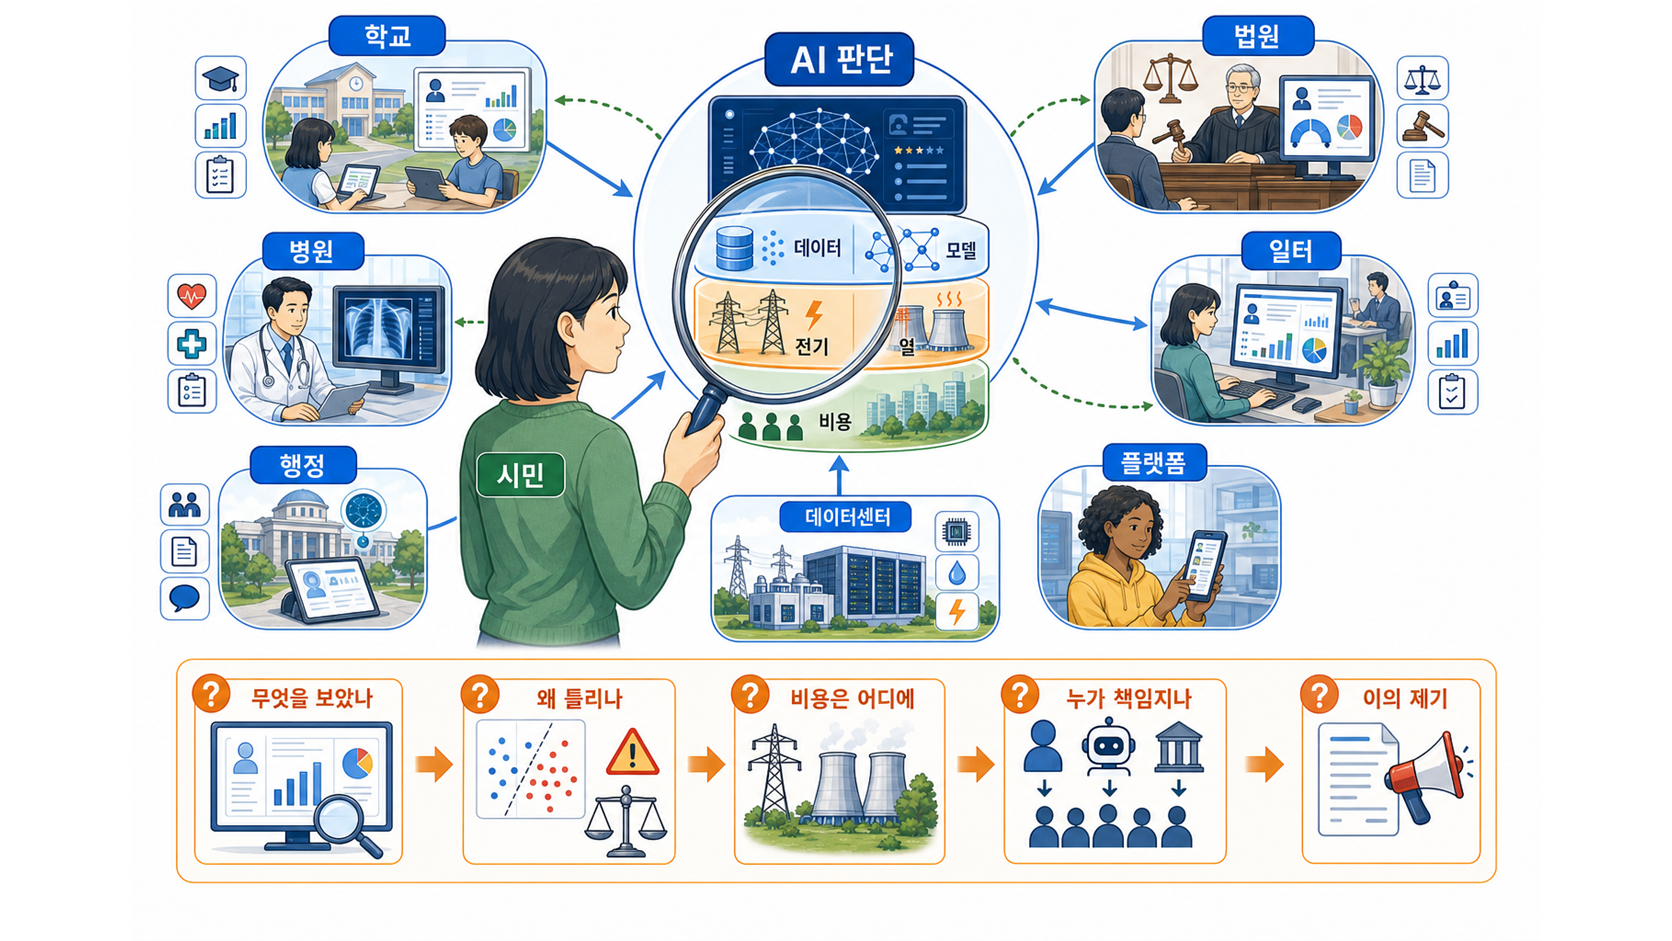
AI 물리학은 기술을 만들기 위한 전문 지식만이 아니라, 데이터센터와 병원, 학교와 법원, 산업 현장이 연결된 사회를 시민이 판단하기 위한 교양입니다.
모든 시민이 AI를 개발하거나 복잡한 수식을 풀 필요는 없습니다. 다만 AI가 어떤 자료를 바탕으로 판단하는지, 왜 그럴듯하게 틀릴 수 있는지, 예측의 정확도가 곧 이해를 뜻하지는 않는다는 사실은 알아야 합니다. 이 책에서 말하는 AI 물리학은 AI를 화면 속 소프트웨어만으로 보지 않는 태도입니다. AI는 데이터를 계산하고, 반도체와 전력을 사용하며, 열을 내보내고, 사람과 조직의 판단을 바꿉니다. AI는 이미 학교, 병원, 행정, 기업, 플랫폼 안에서 작동하고 있습니다. 학습 자료를 만들고, 의료 영상을 분석하며, 민원을 분류하고, 채용과 평가를 돕고, 우리가 보는 뉴스와 영상의 순서를 조정합니다. 문제는 이런 판단의 기준이 잘 보이지 않는다는 데 있습니다. 어떤 데이터가 쓰였는지, 누구의 경험이 빠졌는지, 틀렸을 때 어떻게 바로잡을 수 있는지 알기 어려울 때가 많습니다.
그러므로 AI가 보이지 않는 권력이 되는 것을 막으려면, 거대한 전문 지식보다 아래와 같이 질문하는 능력이 점점 더 중요해지고 있습니다.
이 결과는 무엇을 근거로 만들어졌는가? 누구의 자료가 포함되고 누구의 자료가 빠졌는가? 틀렸을 때 이를 알아차리고 바로잡을 길이 있는가? 이 판단으로 이익을 얻는 사람과 위험을 부담하는 사람은 누구인가?
민주주의는 모든 시민이 모든 기술을 아는 체제가 아닙니다. 중요한 결정이 내려질 때 시민이 이유를 물을 수 있고, 전문가가 이해 가능한 언어로 답하며, 잘못된 판단에 이의를 제기할 수 있는 체제입니다. AI 시대의 교양은 코딩 실력만이 아닙니다. 예측을 읽고, 불확실성을 알아보며, 설명을 요구하고, 결과에 책임을 묻는 능력입니다. 시민에게 필요한 것은 AI를 완전히 통제하는 지식이 아니라, AI 앞에서 질문을 잃지 않는 태도입니다. 화면의 답변 너머에서 어떤 데이터와 계산, 전력과 제도가 움직이는지 묻는 힘입니다.
12.2 교육은 무엇을 바꾸어야 하는가
아이에게 처음 망원경을 건네주면 먼 산의 나무와 달 표면의 그림자를 신기하게 바라봅니다. 그러나 좋은 선생은 망원경을 눈에 대는 방법만 가르치지 않습니다. 초점을 맞추는 법, 흔들림을 줄이는 법, 렌즈가 보여 주는 것과 보여 주지 못하는 것을 함께 알려 줍니다. 도구를 배운다는 것은 그 힘과 한계를 함께 배우는 일입니다.
교육은 무엇을 바꾸어야 하는가
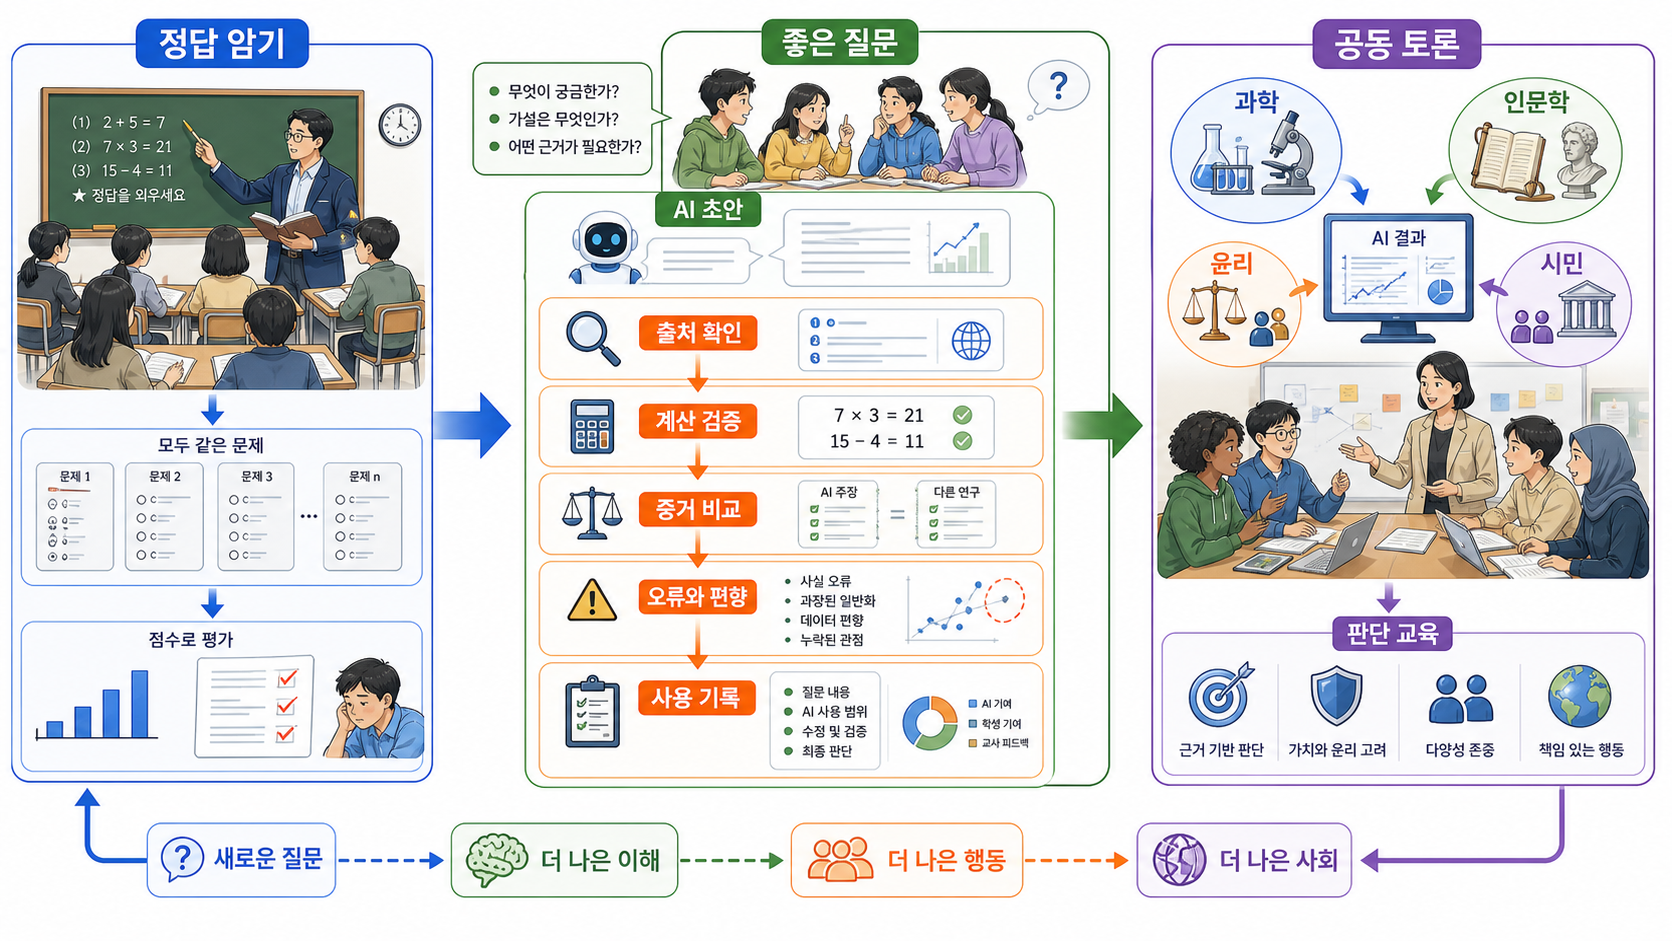
AI 시대의 교육은 정답을 외우는 교실에서 벗어나, 학생이 도구와 함께 질문을 만들고 결과를 검증하며 자신의 판단을 설명하는 배움으로 나아가야 합니다.
AI 교육도 그래야 합니다. 생성형 AI에 질문을 입력하고 답을 받는 법만 익혀서는 충분하지 않습니다. 답변이 사실인지 확인하고, 출처를 찾아보고, 서로 다른 설명을 비교하며, AI가 모르는 것을 아는 것처럼 말할 수 있다는 점까지 배워야 합니다. AI의 문장을 빌릴 수는 있지만, 그 문장을 자신의 생각으로 검토하는 과정까지 맡겨서는 안 됩니다. AI가 정답처럼 보이는 문장을 빠르게 만들어 주는 시대에는 교육의 중심도 달라져야 합니다. 이미 알려진 답을 얼마나 빨리 기억하는가보다, 눈앞의 답을 얼마나 깊이 검토할 수 있는지가 더 중요해집니다. 학생은 AI와 속도 경쟁을 할 필요가 없습니다. 대신 그 답이 질문에 제대로 응답했는지, 중요한 맥락을 빠뜨리지 않았는지, 사실과 의견을 섞지 않았는지 판단할 수 있어야 합니다.
이 책에서 다룬 AI 물리학의 관점은 이런 교육의 좋은 바탕이 됩니다. AI의 예측은 실험과 검증을 거쳐야 하며, 화면 속 답변도 반도체와 전력, 데이터센터 위에서 만들어집니다. 정확한 예측이 곧 이해를 뜻하지는 않고, 그럴듯한 설명이 곧 근거 있는 지식도 아닙니다. 학생은 AI의 답을 보며 “왜 맞는가?”, “언제 틀릴 수 있는가?”, “무엇을 더 확인해야 하는가?”를 물을 수 있어야 합니다. AI 교육에서는 과학과 인문학을 억지로 갈라놓을 필요가 없습니다. 과학은 증거, 측정, 검증, 불확실성을 가르칩니다. 인문학은 언어가 사람에게 어떤 영향을 주는지, 하나의 판단이 누구의 삶을 바꾸는지, 어떤 가치를 선택해야 하는지를 묻습니다. AI의 답변 하나를 두고도 수학적으로 타당한가, 물리적으로 가능한가, 근거가 충분한가, 표현은 정직한가, 특정한 사람에게 불리하게 작용하지는 않는가를 함께 물을 수 있습니다.
학교는 AI를 무조건 금지하거나 몰래 쓰는 도구로 만들어서는 안 됩니다. 금지만으로는 학생이 교실 밖에서 만나는 AI를 비판적으로 사용할 수 없습니다. 반대로 아무 기준 없이 맡기면 생각하는 과정이 보이지 않는 곳으로 사라질 수 있습니다. 더 나은 길은 AI와 함께 작업한 과정을 드러내는 것입니다. 어느 단계에서 AI의 도움을 받았고, 그 결과를 어떻게 검토했으며, 무엇을 고치고 왜 고쳤는지 설명하게 해야 합니다. 평가 방식도 바뀌어야 합니다. 완성된 답만 보면 학생이 직접 생각했는지, AI의 결과를 옮겼는지 구분하기 어렵습니다. 질문을 세우는 과정, 자료를 선택한 이유, 오류를 수정한 기록, 자신의 말로 설명하는 능력을 함께 보아야 합니다. 중요한 것은 AI를 사용했는가가 아니라, AI와 어떤 관계를 맺었는가입니다.
교사의 역할도 줄어들지 않습니다. AI가 많은 답을 만들어 낼수록 교사는 그럴듯한 답과 타당한 답의 차이를 보여 주는 사람이 됩니다. 학생이 질문을 포기하지 않도록 기다려 주고, 더 깊은 질문으로 나아가게 돕는 역할은 더 중요해집니다. AI 시대의 교육은 기계를 능숙하게 부리는 사람만을 길러서는 부족합니다. 기계의 도움을 받으면서도 자신의 판단을 잃지 않고, 그 판단의 근거를 다른 사람에게 설명할 수 있는 사람을 길러야 합니다. 교육의 목표는 AI보다 빨리 답하는 학생이 아닙니다. AI의 답을 넘어 더 좋은 질문을 발견하고, 그 질문을 함께 나눌 수 있는 시민입니다.
12.3 노동과 전문성의 변화
별을 보고 길을 찾던 항해사 곁에 위성항법 장치가 놓이면서 항해의 풍경은 크게 바뀌었습니다. 배의 위치와 항로를 계산하는 일은 쉬워졌지만, 항해사의 책임이 사라진 것은 아닙니다. 기기가 고장 나거나 날씨가 갑자기 바뀌고, 화면에 표시되지 않은 위험을 만났을 때 마지막 판단은 여전히 사람에게 남습니다. 도구가 바뀌면 숙련의 자리도 달라집니다.
노동과 전문성의 변화
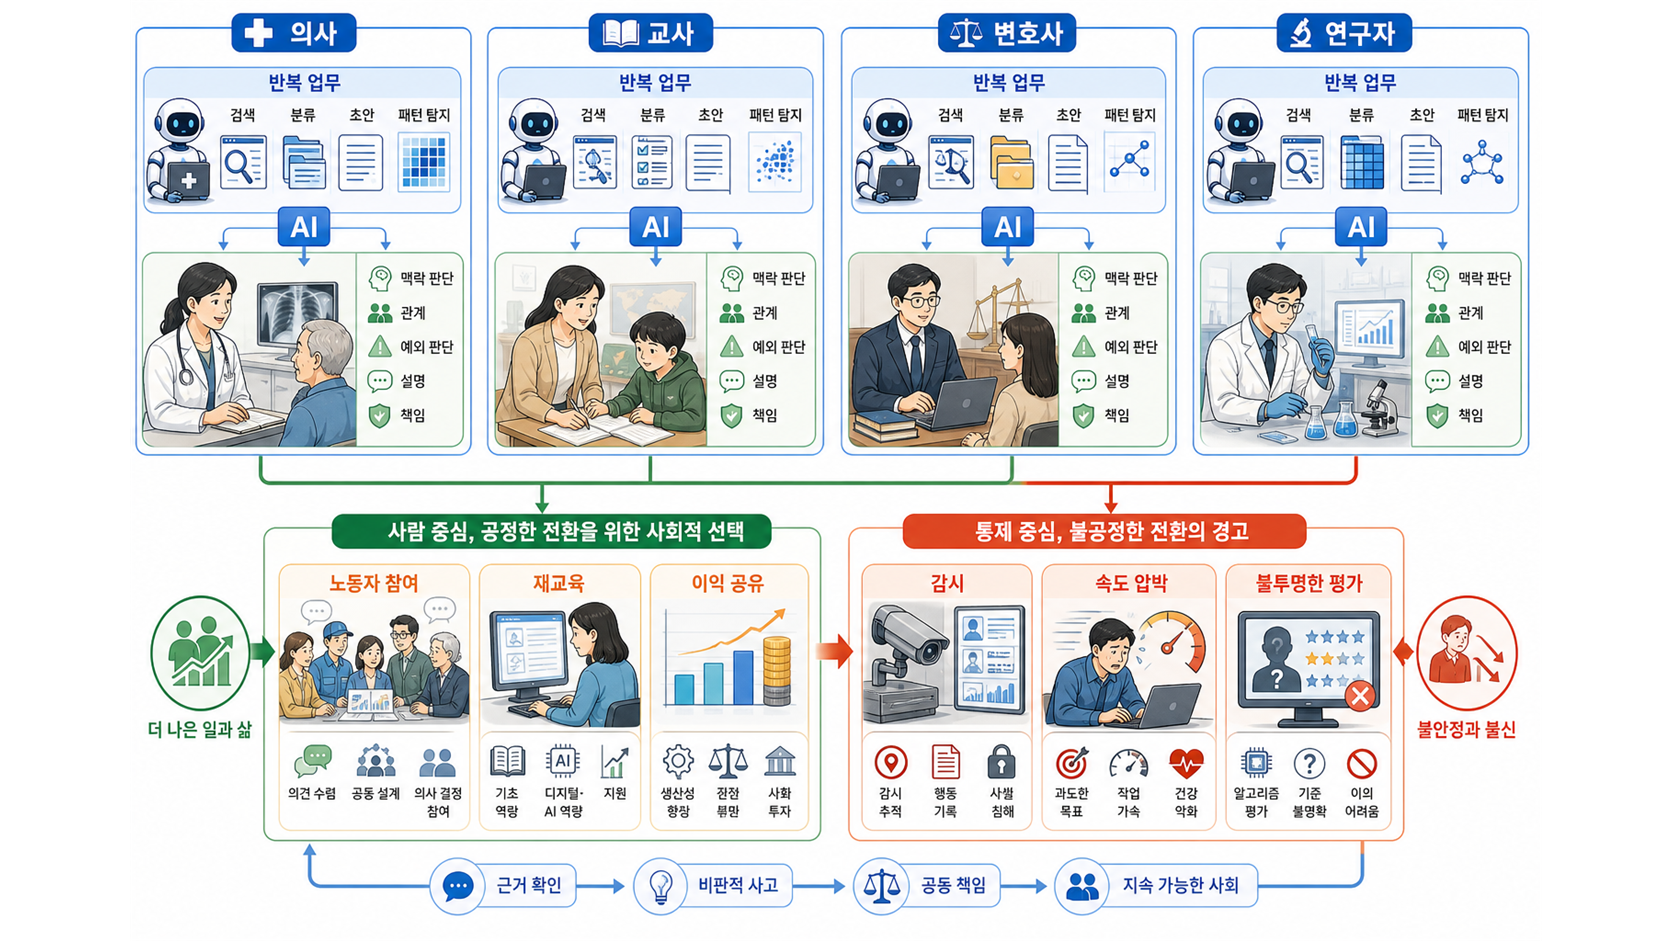
AI는 일을 사라지게만 하는 것이 아니라 업무의 구성을 바꾸고, 사람에게 필요한 판단과 책임, 관계의 능력을 새롭게 정의합니다.
AI는 이미 여러 직업의 하루를 바꾸고 있습니다. 문서 초안을 쓰고, 회의 내용을 정리하며, 고객 문의를 분류하고, 의료영상 판독과 판례 검색, 설계 후보 생성과 실험 조건 탐색을 돕습니다. 그러나 이것은 어떤 직업이 통째로 사라지고 다른 직업이 곧바로 대체되는 단순한 변화가 아닙니다. 한 직업 안에서도 어떤 업무는 자동화되고, 어떤 업무는 더 중요해지며, 이전에는 없던 검토와 관리의 일이 생깁니다. 직업보다 먼저 바뀌는 것은 업무의 구성입니다. AI의 도입을 생산성이라는 숫자만으로 보면 중요한 질문을 놓치기 쉽습니다. AI가 같은 시간에 더 많은 일을 처리하게 할 수는 있습니다. 그러나 그 속도가 누구를 편하게 하고 누구를 더 바쁘게 만드는지는 별개의 문제입니다. 반복 작업이 줄어 사람이 더 창의적인 일에 집중할 수도 있지만, 절약된 시간이 더 많은 업무와 촘촘한 감시로 채워질 수도 있습니다. 기술이 아껴 준 시간이 누구에게 돌아가는지는 조직과 제도가 결정합니다.
AI는 좋은 동료가 될 수 있습니다. 위험한 작업을 대신하고, 지루한 반복을 줄이며, 초보자가 필요한 정보를 빠르게 찾도록 도울 수 있습니다. 시각, 청각, 이동에 어려움이 있는 사람에게는 더 넓은 일을 가능하게 하는 보조 기술이 될 수도 있습니다. 그러나 같은 기술이 노동자를 끊임없이 측정하고 순위를 매기며 속도를 압박하는 장치가 될 수도 있습니다. 동반자와 감시자를 가르는 것은 기술의 외형이 아니라, 그것을 둘러싼 권리와 규칙입니다. 전문성의 의미도 달라집니다. 전문가는 AI를 쓰지 않는 사람이 아닙니다. AI가 내놓은 결과의 가치와 한계를 판단하고, 결과가 이상할 때 알아차릴 수 있는 사람입니다. 의사는 AI의 위험도 예측을 참고하되 환자의 병력과 삶의 맥락을 함께 보아야 합니다. 변호사는 AI가 찾아낸 판례를 이용할 수 있지만 논증의 책임을 넘길 수 없습니다. 연구자는 AI가 제안한 실험을 검토하되, 그 실험이 과학적으로 의미 있고 안전한지 판단해야 합니다.
AI가 초안을 많이 만들수록 최종 판단의 무게는 오히려 커질 수 있습니다. 기계가 수십 개의 후보를 내놓으면 인간은 무엇을 선택하고 무엇을 버릴지 결정해야 합니다. 속도가 빨라질수록 검토해야 할 결과도 많아지고, 작은 판단 하나가 더 넓은 범위에 적용될 수 있습니다. 그래서 일터의 교육은 단순한 AI 사용법에 머물러서는 안 됩니다. 자동화된 업무의 원리를 이해하고, 예외 상황을 다루며, 필요할 때 AI 없이도 핵심 업무를 수행할 수 있는 기반을 남겨야 합니다. 직접 해 본 경험이 없으면 AI가 이상한 결과를 내놓았을 때 알아차리기 어렵기 때문입니다.
노동 현장에 AI를 도입할 때는 당사자의 목소리도 필요합니다. 어떤 업무를 자동화할지, 평가 자료를 어떻게 사용할지, 오류에 이의를 제기할 절차를 어떻게 만들지 결정하는 과정에 노동자가 참여해야 합니다. 설명도 없이 알고리즘의 평가를 받거나, 자신도 모르는 자료가 인사 결정에 쓰인다면 신뢰는 오래 유지되기 어렵습니다. AI가 일의 모습을 바꾸는 흐름을 완전히 멈출 수는 없을지 모릅니다. 그러나 변화의 방향이 미리 정해진 것은 아닙니다. AI가 인간의 시간을 되돌려 주는 기술이 될지, 모든 순간을 더 촘촘하게 쥐어짜는 기술이 될지는 사회가 어떤 규칙을 세우느냐에 달려 있습니다. 좋은 기술은 인간을 불필요하게 만드는 기술이 아니라, 사람이 반복과 위험에서 조금 벗어나 더 깊이 판단하고 자신의 일에 의미를 느낄 여백을 돌려주는 기술입니다.
12.4 의료·법률·행정에서의 판단
응급실의 순서는 단순한 줄서기가 아닙니다. 먼저 도착한 사람이 아니라 더 위급한 사람이 먼저 치료받습니다. 혈압과 산소포화도, 증상과 병력은 숫자로 기록되지만, 그 숫자 끝에는 숨이 가쁜 한 사람이 있습니다. AI는 흩어진 정보를 빠르게 모으고 위험 신호를 찾아낼 수 있습니다. 의료영상을 살피고, 약물의 상호작용을 확인하며, 복잡한 법률 문서와 행정 기록을 정리하는 데 도움을 줍니다. 그러나 이 영역에서 한 번의 오류는 단순한 오답으로 끝나지 않습니다. 치료가 늦어지거나, 복지의 문이 닫히거나, 한 사람의 권리가 흔들릴 수 있습니다.
의료·법률·행정에서의 판단
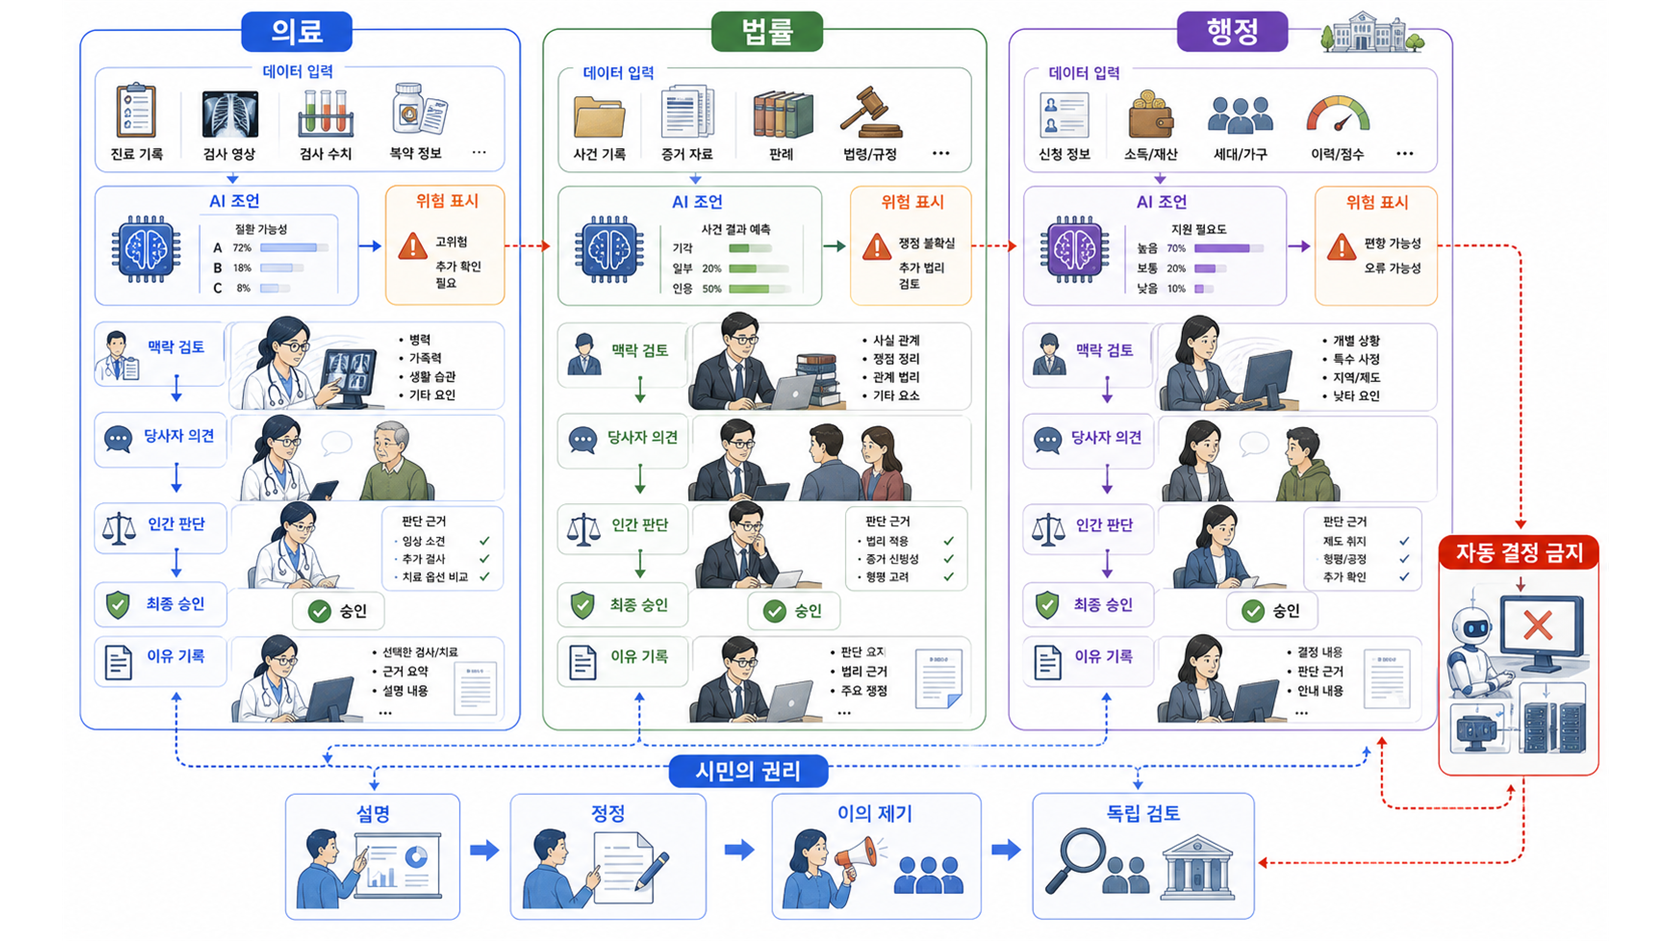
의료와 법률, 행정에서 AI의 예측은 판단을 돕는 자료입니다. 사람의 삶을 바꾸는 결정에는 설명과 재검토, 책임질 수 있는 제도가 함께 있어야 합니다.
AI의 정확도는 모든 사람에게 똑같지 않을 수 있습니다. 특정 병원과 지역, 특정 연령과 집단의 자료를 중심으로 학습했다면 낯선 환경에서는 더 자주 틀릴 수 있습니다. 의료 AI를 평가할 때는 “얼마나 정확한가”뿐 아니라 “누구에게 정확한가”를 물어야 하는 이유입니다. 법률과 행정에서도 속도만으로 좋은 판단을 만들 수는 없습니다. 시민은 자신이 왜 그런 결정을 받았는지 알 수 있어야 하며, 잘못되었다고 생각할 때 다시 살펴 달라고 요구할 수 있어야 합니다. 이유를 들을 수도, 문을 두드릴 수도 없는 판단은 효율적일지 몰라도 정의롭다고 말하기 어렵습니다.
AI가 위험도를 표시했다고 해서 의사의 판단이 끝나는 것은 아닙니다. 알고리즘이 의심 사례를 골랐다고 해서 시민의 권리가 사라지는 것도 아닙니다. AI의 출력은 판단의 재료이지, 책임의 종착지가 아닙니다. 좋은 제도는 AI를 뒤에 숨기지 않습니다. 어떤 자료가 사용되었는지 밝히고, 오류를 고칠 통로를 남기며, 최종 결정에 책임질 사람과 기관을 분명히 합니다. 기술이 아무리 빨라져도 사람의 사정을 들을 시간까지 지워서는 안 됩니다. 편리함은 판단의 손을 가볍게 할 수 있습니다. 그러나 생명과 권리를 다루는 손은 마지막 순간까지 사람의 무게를 기억해야 합니다.
> AI 확신의 밀실: 매끄러운 답이 현실을 가릴 때 > > ‘사이버 사이코시스’라는 표현은 정식 의학 진단명이 아닙니다. 여기서는 AI가 자신에게 맞추어 내놓는 답을 반복해서 받아들이는 동안, 반대 증거와 타인의 목소리로부터 멀어지는 상태를 비유적으로 가리킵니다. > > AI의 문장은 매끄럽습니다. 사용자의 전제와 말투를 따라가며 듣고 싶은 답을 그럴듯하게 만들어 냅니다. 그러나 유창함은 사실의 보증서가 아닙니다. 자신을 지지하는 답만 되풀이해 듣다 보면 불편한 자료와 현장의 경고는 소음처럼 느껴질 수 있습니다. > > 상승 곡선과 현실의 절벽 >
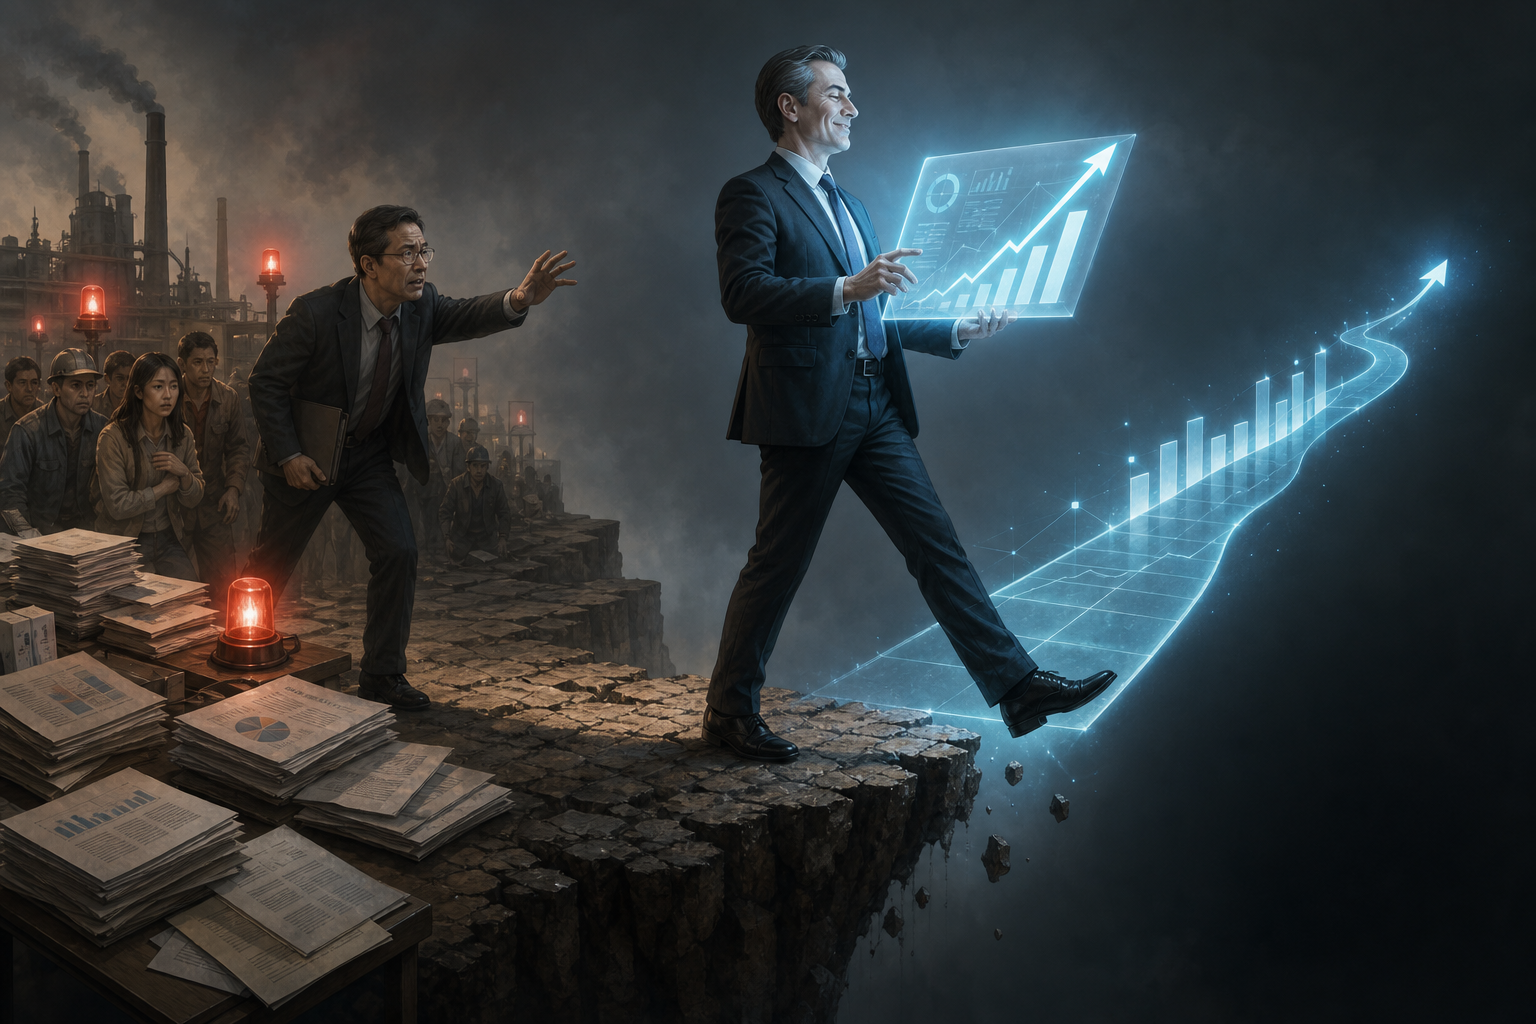
> > AI가 그린 상승 곡선은 허공까지 이어지지만 현실의 땅은 이미 끝나 있습니다. 반대 증거를 잃은 확신은 추락 직전까지도 자신을 성공이라 부를 수 있습니다. > > 기업의 성공 전망도, 행정의 효율 점수도, 예술 작품에 대한 찬사도 AI 안에서는 얼마든지 매끈하게 이어질 수 있습니다. 그러나 현실에는 데이터에 들어오지 않은 소비자의 변덕과 시민의 사정, 인물의 모순과 창작자의 고통이 남아 있습니다. > > 우리를 다시 멈춰 세우는 것은 ‘현실의 마찰력’입니다. 예상과 다른 결과, 현장의 경험, 동료의 반론, 설명되지 않는 한 사람의 고통이 확신의 속도를 늦춥니다. > > AI를 잘 사용한다는 것은 그 답을 많이 믿는 일이 아닙니다. 답이 현실과 부딪힐 때 멈추고, 반대편의 증거를 찾으며, 마지막 판단의 책임을 자신에게 되돌리는 일입니다.
12.5 금지선: 군사와 감시 기술
밤길의 가로등은 사람을 지켜 줍니다. 그러나 같은 빛이 누군가의 모든 걸음을 뒤쫓는 감시등이 될 수도 있습니다. 기술의 빛에는 보호와 통제라는 두 개의 그림자가 따라다닙니다. AI는 재난과 사이버 공격을 빠르게 감지하고, 실종자를 찾으며, 위험한 임무에서 사람을 대신할 수 있습니다. 동시에 얼굴과 이동 경로를 추적하고, 표적을 식별하며, 허위정보를 대량으로 만들어 낼 수도 있습니다. 이 영역에서 중요한 질문은 기술이 얼마나 영리한가가 아니라, 누가 그 힘을 행사하고 누가 멈출 수 있는가입니다.
군사와 감시 기술
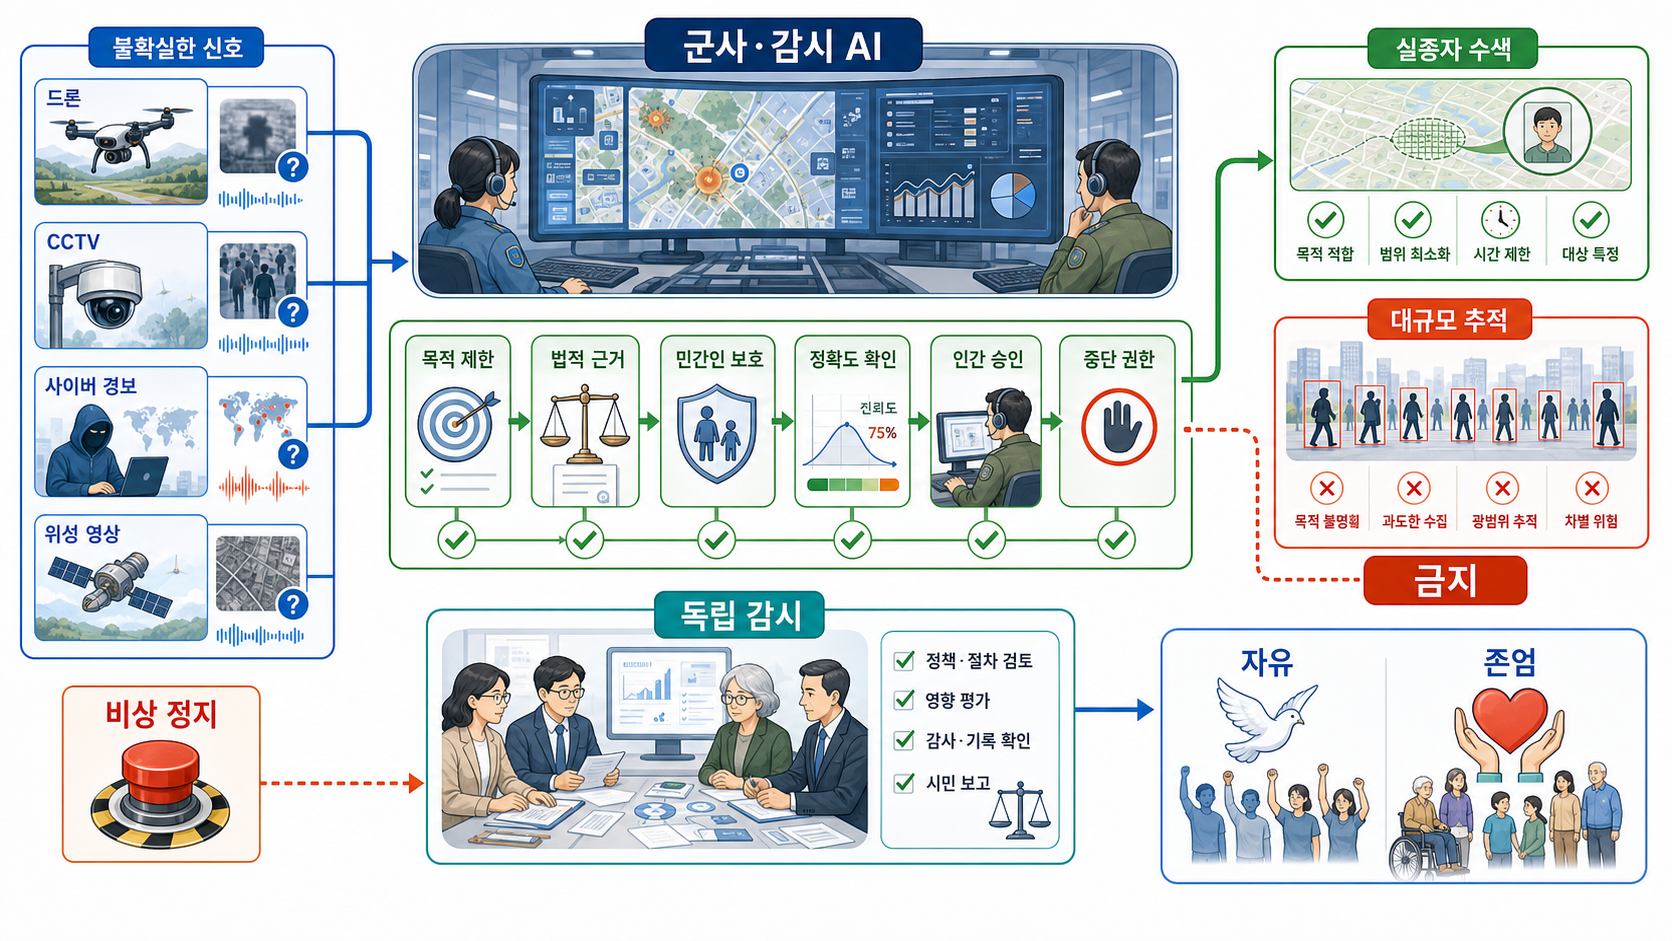
군사·감시 AI에서 핵심은 무엇을 할 수 있는가보다 무엇을 허용하지 않을 것인가, 그리고 위험한 판단을 누가 중단할 수 있는가에 있습니다.
생명을 빼앗는 결정은 되돌릴 수 없습니다. 전쟁의 속도가 빨라져 판단과 공격 사이의 시간이 짧아질수록, 오류를 검토하고 명령을 거부할 여지는 줄어듭니다. 인간의 통제는 화면에 승인 버튼 하나를 남겨 두는 것으로 충분하지 않습니다. 상황을 이해하고, 명령을 멈추며, 그 결과에 책임질 실질적인 권한이 있어야 합니다. 감시도 안전이라는 이름으로 시작될 수 있습니다. 그러나 모든 거리가 관찰되고 모든 표정과 이동이 기록된다면, 시민은 처벌받지 않더라도 스스로 말을 줄이게 됩니다.
민주주의는 투표함만으로 살아 있지 않습니다. 감시받는다는 두려움 없이 말하고, 모이고, 권력을 비판할 수 있는 여백 속에서 숨을 쉽니다. 합성 영상과 음성, 자동화된 여론 조작은 그 여백의 토양을 흐릴 수 있습니다. 무엇이 사실인지 끊임없이 의심해야 하는 사회에서는 거짓말뿐 아니라 진실도 힘을 잃습니다. 안전을 위해 어느 정도의 감시가 필요한 순간은 있을 수 있습니다. 그러나 예외로 허용된 눈이 일상의 천장에 영구히 매달려서는 안 됩니다. 범위와 기간, 사용 목적을 제한하고, 독립적인 감시와 사법적 통제를 두어야 합니다. 강한 기술을 가진 사회에는 그보다 더 강한 민주적 제동 장치가 필요합니다. 멈추지 못하는 힘은 보호의 도구가 아니라 두려움의 체제가 되기 쉽기 때문입니다.
> 누가 AI의 금지선을 정하는가 > 2026년 2월 공개된 앤트로픽과 미국 국방부의 갈등은 AI 윤리가 추상적 선언이 아니라 계약 조건과 사용 권한의 문제임을 보여 주었습니다. 앤트로픽은 국방·정보 분야에 자사 모델을 제공하면서도 미국 내 대규모 감시와 인간의 통제 밖에서 표적을 정하는 완전 자율무기에는 사용하지 않는다는 제한을 요구했습니다. > 국방부는 합법적인 군사 목적에서 더 폭넓은 사용 권한이 필요하다는 입장을 보였고, 갈등은 계약과 공급망 문제로 확대되었습니다. 쟁점은 AI를 국방에 사용할 것인가의 찬반만이 아니었습니다. 기업과 국가 가운데 누가 사용의 한계를 정하며, 모델이 틀렸을 때 누가 책임지는가가 핵심이었습니다. > 계약 테이블 위의 AI 안전선
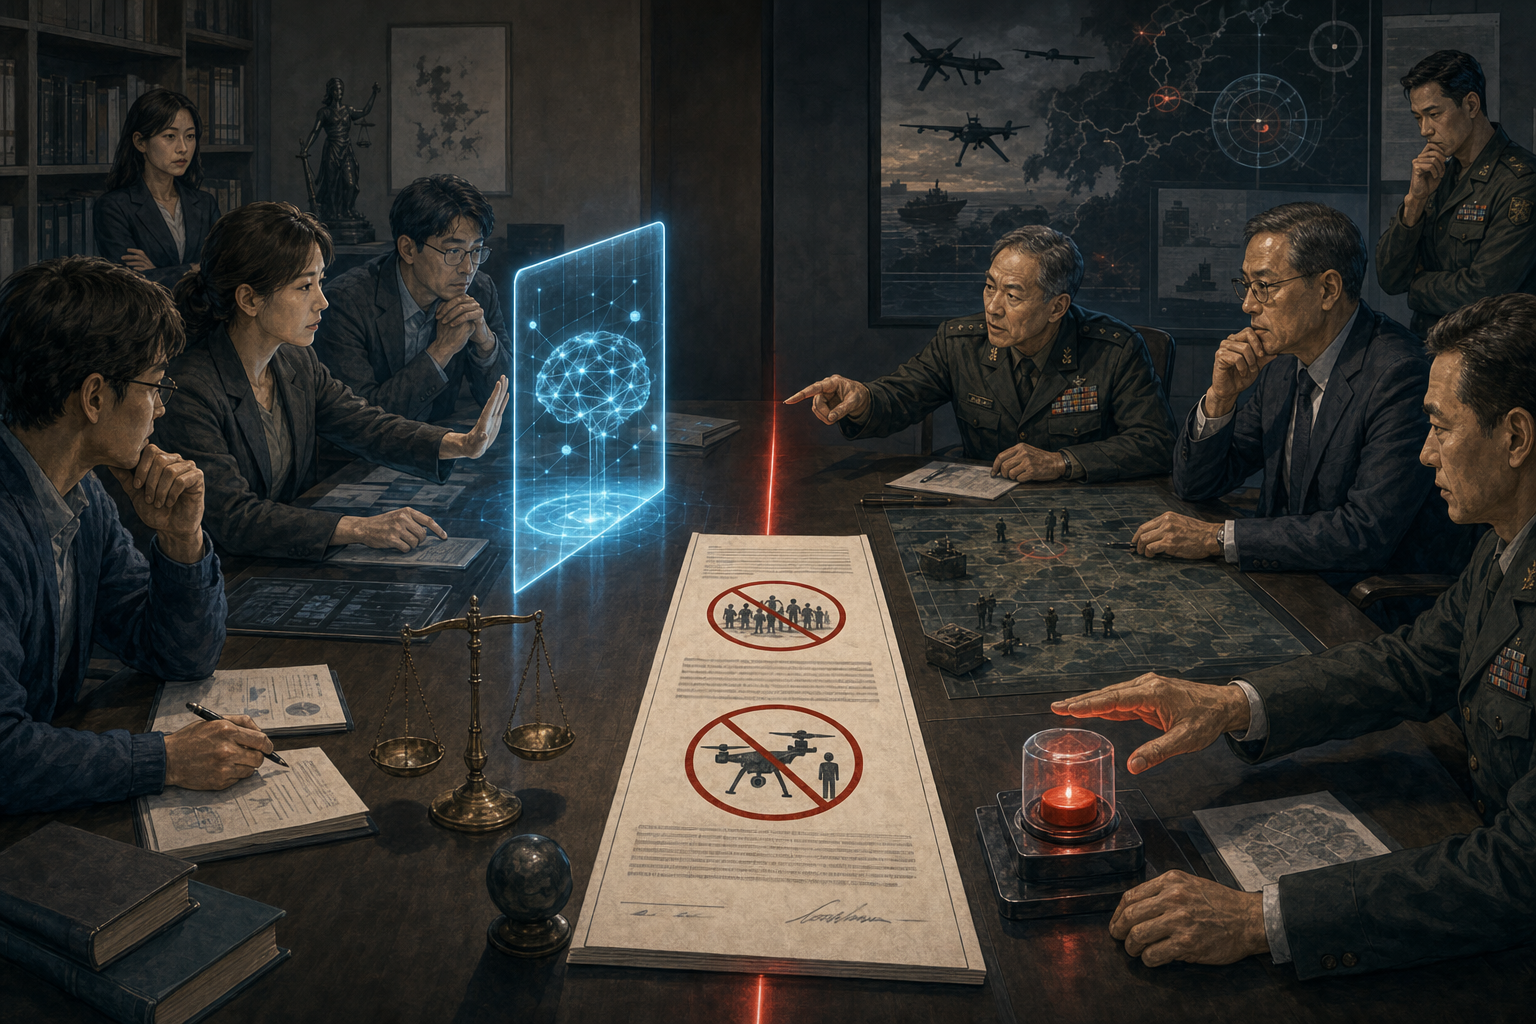
> AI의 사용 범위는 기술 성능만으로 정해지지 않습니다. 금지선, 인간의 최종 통제, 감사 의무와 책임 소재가 계약과 제도 속에 명시되어야 합니다. > 전쟁과 안보에서는 속도가 생명을 구할 수 있지만 잘못된 속도는 오판도 확대합니다. AI가 정보 분석과 작전 계획에 깊이 들어갈수록 “얼마나 똑똑한가”와 함께 “누가 통제하고, 무엇을 금지하며, 실패했을 때 누가 책임지는가”를 물어야 합니다. > 출처: Anthropic, “Statement on the Department of War”, U.S. Department of Defense의 관련 계약 발표
12.6 플랫폼 권력과 데이터
옛 도시에서는 시장으로 들어가는 길목이 중요했습니다. 길목을 차지한 사람은 더 많은 손님을 만났고, 물건과 소문의 흐름을 먼저 알았습니다. 오늘날의 플랫폼은 검색과 뉴스, 쇼핑과 영상, 대화와 결제가 지나가는 디지털 길목입니다. 플랫폼은 편리합니다. 원하는 정보를 빠르게 찾고, 취향에 맞는 음악과 영상을 만나며, 멀리 있는 사람과 즉시 연결됩니다. 그러나 길목을 가진 기업은 우리가 무엇을 보고 지나치는지, 어느 가게 앞에 멈추고 어떤 이야기에서 오래 머무는지도 알게 됩니다.
플랫폼 권력과 데이터
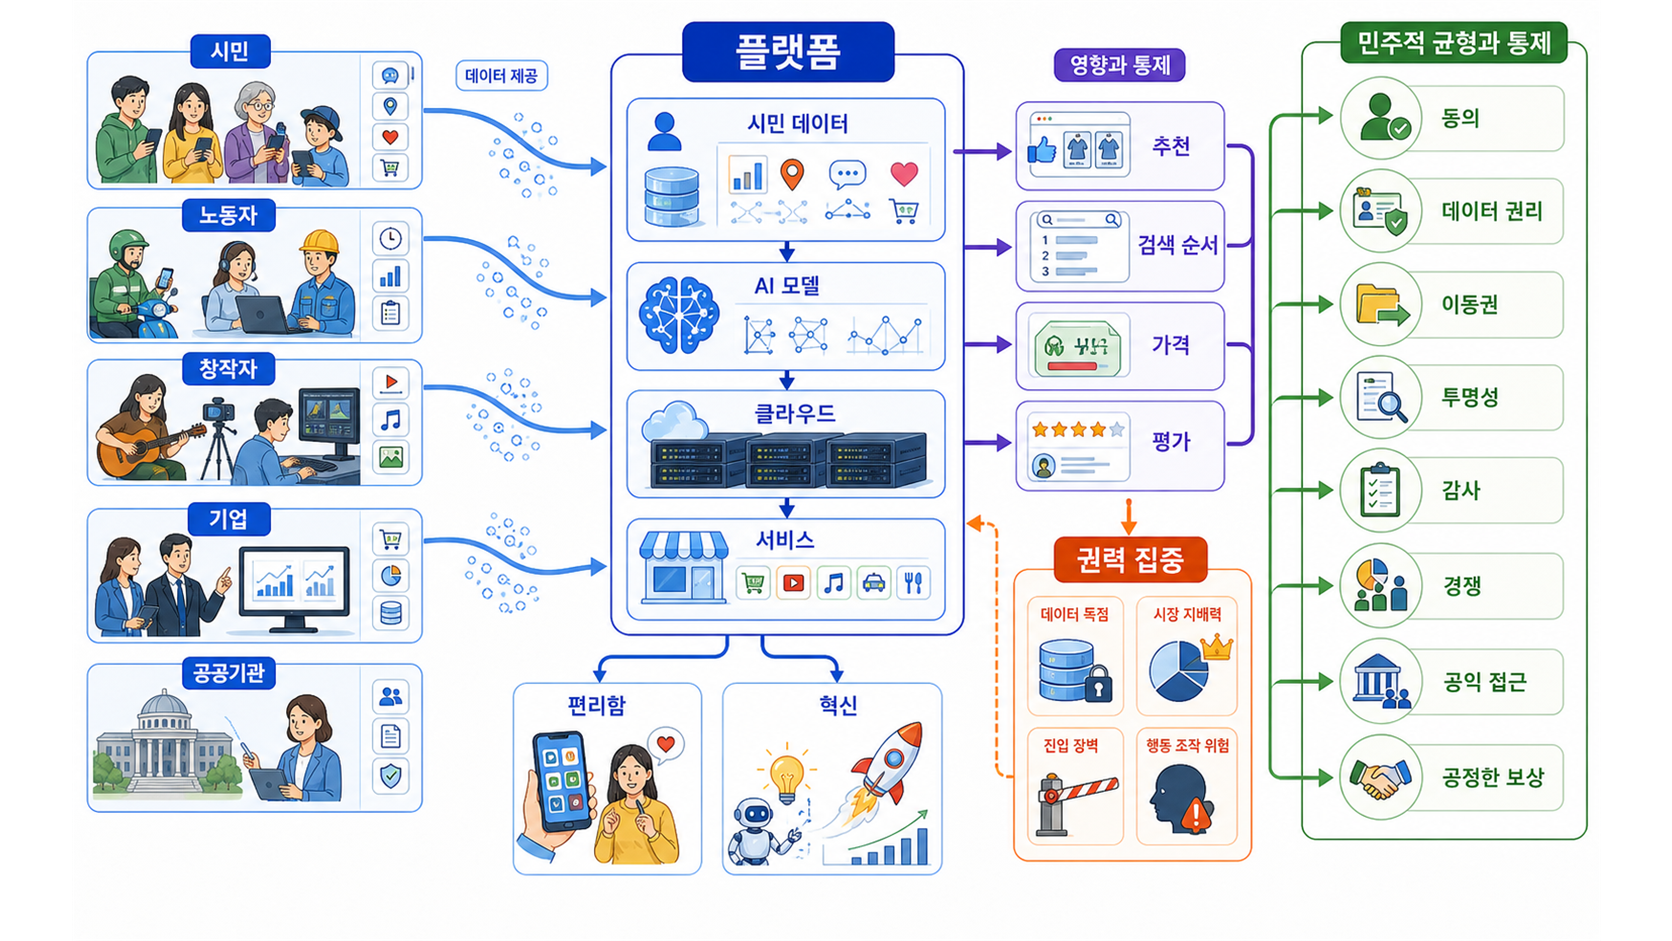
AI 시대의 권력은 알고리즘 하나보다 데이터와 모델, 서버와 서비스를 함께 통제하는 디지털 길목에서 더욱 크게 자랍니다.
AI 시대에는 이러한 힘이 더 짙어집니다. 사용자 데이터와 대규모 모델, 클라우드와 광고, 결제와 개발자 생태계가 한곳에 모이면 플랫폼은 서비스를 제공하는 회사를 넘어 사회의 시선을 배열하는 존재가 됩니다. 검색 결과의 순서와 추천 목록의 첫 화면은 작은 선택처럼 보이지만, 수많은 사람에게 반복되면 여론과 문화의 흐름을 바꿀 수 있습니다. 데이터는 차가운 숫자의 더미가 아닙니다. 우리가 걸어간 길과 좋아한 노래, 아팠던 기록과 일했던 시간, 망설이다 지운 문장의 흔적입니다.
AI는 이 삶의 부스러기에서 패턴을 배웁니다. 따라서 데이터의 문제는 소유권만이 아니라 기억과 존엄의 문제입니다. 플랫폼의 크기 자체가 잘못은 아닙니다. 거대한 계산 시설과 전문 인력은 유용한 서비스를 가능하게 합니다. 문제는 크기가 아니라, 그 힘을 들여다보고 되돌릴 수 없게 되는 순간입니다. 왜 어떤 정보가 추천되었는지 물을 수 없고, 다른 서비스로 옮기기 어렵고, 피해를 입어도 호소할 곳이 없다면 편리한 길목은 어느새 닫힌 성문이 됩니다. 데이터 거버넌스는 이 성문에 규칙을 세우는 일입니다. 무엇을 왜 수집하는지, 얼마나 오래 보관하는지, 누구와 나누는지, 잘못 사용되었을 때 누가 책임지는지를 정합니다. 시민이 데이터의 원천이면서 아무런 권리도 갖지 못한다면 협력은 쉽게 수탈로 변합니다.
그렇다고 모든 데이터를 봉인하는 것이 답은 아닙니다. 안전하게 공유된 자료는 질병과 재난을 연구하고 공공서비스를 개선하는 데 쓰일 수 있습니다. 필요한 것은 무조건적인 개방이나 독점이 아니라, 목적과 동의, 보호와 공익 사이의 섬세한 문입니다. 물리학에서 장은 눈에 보이지 않지만 물체의 움직임을 바꿉니다. 플랫폼도 비슷합니다. 추천 목록과 검색 순서, 평점과 자동 분류는 우리를 강제로 끌고 가지 않으면서도 매일 조금씩 방향을 바꿉니다. 우리는 장을 직접 보지 못하지만, 어느새 그 장이 만든 길을 걷고 있을 수 있습니다. 시민은 플랫폼의 손님인 동시에 그 세계를 만드는 데이터의 주인공입니다. 편리한 서비스를 누르는 손가락이 자신의 삶의 흔적을 어디에 남기는지 바라볼 때, 사용자는 비로소 시민이 됩니다. 디지털 길목은 사유지처럼 운영될 수 있어도 그곳을 오가는 삶은 공적입니다. 그래서 플랫폼의 권력에는 설명과 선택, 이동과 이의 제기의 통로가 함께 놓여야 합니다. 길목은 사람을 붙잡는 문이 아니라, 더 넓은 세상으로 건너가게 하는 다리여야 합니다.
12.7 민주주의와 설명 가능한 기술
마을의 낡은 다리 가운데 하나만 먼저 고쳐야 한다고 생각해 봅시다. 이용자 수, 붕괴 위험, 보수 비용, 대체 도로의 유무를 계산하면 우선순위를 정할 수 있습니다. 그러나 자기 마을의 다리가 뒤로 밀린 주민은 숫자만 통보받고 싶어 하지 않습니다. 어떤 기준으로 결정했는지, 자료가 틀렸다면 어떻게 바로잡을 수 있는지 알고 싶어 합니다. 이를 뒷받침하는 제도가 민주주의입니다. 민주주의는 결과만 나누는 제도가 아닙니다. 이유를 묻고, 설명을 듣고, 이의를 제기할 수 있는 절차입니다. 다수결도 중요하지만, 다수결이 정당성을 얻으려면 결정의 근거가 공개되고, 소수자의 피해가 검토되며, 잘못된 판단을 고칠 수 있는 통로가 있어야 합니다. 민주주의는 단순히 빠른 결정을 내리는 방식이 아니라, 함께 감당할 이유를 만드는 방식입니다.
민주주의와 설명 가능한 기술
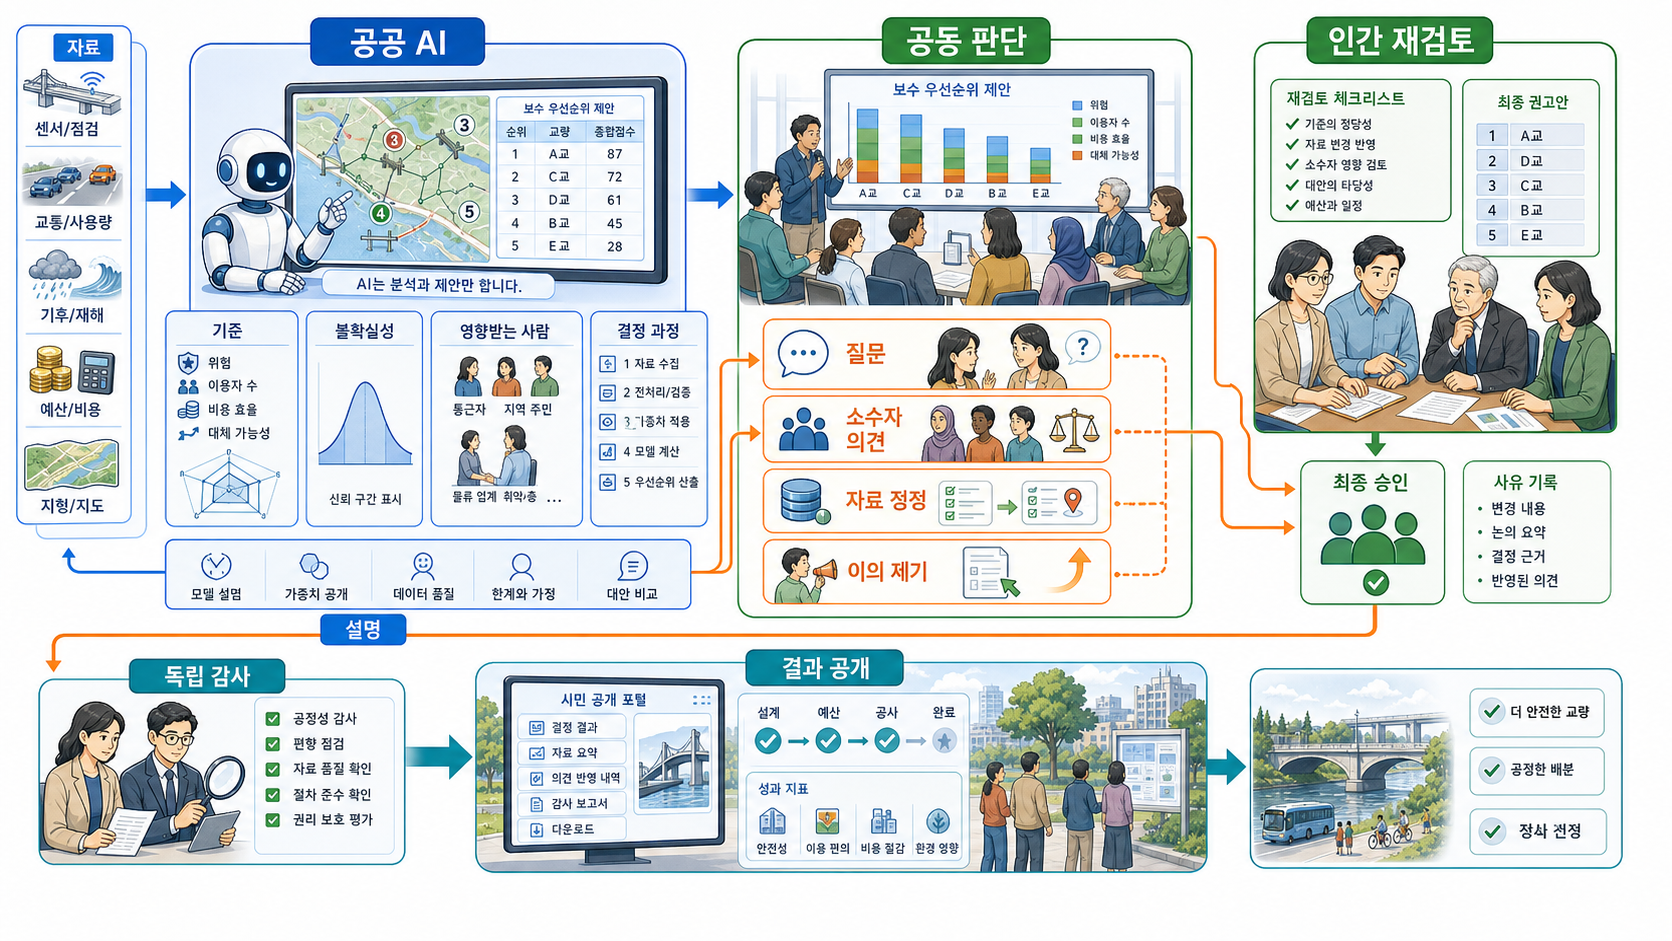
민주주의의 AI는 결정을 빠르게 내리는 기술에 머물지 않습니다. 시민이 결정의 흐름을 보고 질문하며, 잘못된 결과에 이의를 제기할 수 있는 공론장을 필요로 합니다.
역사적으로 민주주의는 기술 문명의 발전과 무관하게 성장하지 않았습니다. 인쇄술은 지식과 사상을 더 넓게 퍼뜨렸고, 신문과 우편 제도는 공론장을 넓혔습니다. 철도와 전신, 라디오와 텔레비전은 멀리 떨어진 사람들을 같은 사건과 토론에 연결했습니다. 인터넷은 시민이 정보를 찾고 의견을 조직하는 방식을 크게 바꾸었습니다. 기술은 민주주의를 자동으로 성숙하게 만들지는 않았지만, 시민들이 더 많이 알고 더 넓게 연결될 수 있는 조건을 제공해 왔습니다.
AI도 그런 기술이 될 수 있습니다. 복잡한 예산과 정책 자료를 시민이 이해하기 쉽게 요약하고, 법률과 행정 문서를 쉬운 언어로 풀어 주며, 장애가 있는 시민에게 음성·자막·번역 도구를 제공할 수 있습니다. 지역별 정책 효과를 비교하고, 공청회 의견을 정리하며, 반복되는 민원과 위험 신호를 찾아낼 수도 있습니다. 잘 쓰인다면 AI는 시민을 침묵시키는 기술이 아니라, 더 많은 사람이 공적 결정에 참여하도록 돕는 기술이 될 수 있습니다. 그러나 AI가 공공 판단에 들어올수록 설명은 더 중요해집니다. 복지 대상 선정, 채용, 교육 평가, 행정 심사처럼 시민의 삶에 직접 영향을 주는 결정에 AI가 쓰인다면 시민은 그 판단의 이유를 들을 수 있어야 합니다. 어떤 자료가 사용되었는지, 어떤 기준이 중요하게 작용했는지, 잘못된 정보가 있다면 어떻게 수정할 수 있는지 알아야 합니다. 기술이 복잡하다는 이유로 시민의 질문이 막혀서는 안 됩니다.
여기서 필요한 것은 시민이 AI 내부의 모든 수식과 코드를 이해하는 일이 아닙니다. 중요한 것은 자신에게 영향을 준 결정의 근거를 이해 가능한 언어로 듣는 일입니다. 모델이 어떤 자료를 사용했고, 어느 범위에서 검증되었으며, 어떤 경우에 틀릴 수 있는지 설명해야 합니다. 시민이 결과에 이의를 제기하고 다시 판단받을 수 있는 절차도 필요합니다. 이런 조건을 알고리즘 책임성(algorithmic accountability)이라고 부를 수 있습니다. AI의 설명을 두 가지로 나누어 말할 수 있습니다. 하나는 기술적 설명입니다. 어떤 데이터와 기준으로 결과가 나왔는지, 모델이 어떤 한계를 갖는지를 밝히는 일입니다. 다른 하나는 제도적 설명입니다. 왜 그 AI를 사용했는지, 누가 승인했는지, 오류가 생기면 누가 책임지는지를 밝히는 일입니다. 기술적 설명만 있고 책임지는 사람이 없다면 시민은 기계 앞에 홀로 서게 됩니다. 반대로 제도적 책임을 말하면서 기술의 작동 방식이 가려져도 신뢰는 생기기 어렵습니다.
민주주의에서 AI의 역할은 결정을 대신하는 데 있지 않습니다. AI는 자료를 정리하고, 선택지의 영향을 비교하고, 놓치기 쉬운 위험을 표시할 수 있습니다. 하지만 공동체가 어떤 가치를 우선할지, 비용과 혜택을 어떻게 나눌지, 누구의 피해를 어떻게 보상할지는 시민과 제도가 결정해야 합니다. 민주주의는 가장 계산이 빠른 답을 고르는 일이 아니라, 서로 다른 삶의 목소리를 들으며 함께 책임질 답을 찾는 과정입니다. AI가 민주주의를 도우려면 몇 가지 조건이 필요합니다. 공공 AI는 사용 목적과 자료의 출처를 밝혀야 합니다. 오류를 발견했을 때 고칠 수 있어야 합니다. 특정 집단에게 불리하게 작동하지 않는지 점검해야 합니다. 시민이 이해할 수 있는 설명을 제공하고, 중요한 결정에서는 인간의 검토와 책임이 남아 있어야 합니다. 설명 가능성(explainability)은 기술의 장식이 아니라 시민권의 조건입니다.
기술 문명은 민주주의를 넓힐 수도 있고 좁힐 수도 있습니다. 인쇄술이 지식을 퍼뜨렸지만 선전도 퍼뜨렸고, 방송이 공론장을 넓혔지만 여론 조작의 도구가 되기도 했습니다. AI도 마찬가지입니다. 시민의 이해와 참여를 돕는 도구가 될 수도 있고, 보이지 않는 기준으로 사람을 분류하고 침묵시키는 장치가 될 수도 있습니다. 방향은 기술 자체가 아니라 사회가 세우는 규칙과 책임 구조에 달려 있습니다. 좋은 공공 AI는 시민을 조용하게 만드는 기술이 아닙니다. 더 잘 묻고, 더 넓게 참여하며, 더 정확한 이유를 요구하게 하는 기술이어야 합니다. 설명을 요구할 권리는 기술 시대에 새로 생긴 요구가 아닙니다. 권력 앞에서 이유를 묻는 시민의 오래된 권리가 AI 시대에 새로운 형태로 다시 등장한 것입니다.
12.8 동서양 고전이 주는 균형 감각
이 자리에서 동서양 고전을 돌아보는 것은 과거로 물러나기 위해서가 아닙니다. 빠르게 달리는 기술 곁에 오래된 나침반 하나를 놓기 위해서입니다. 도구는 바뀌어도 힘과 책임, 자유와 절제 사이에서 흔들리는 인간의 문제는 쉽게 낡지 않습니다. AI가 아무리 빠른 답을 내놓아도, 그 답을 어떻게 사용할지 판단하는 일은 여전히 인간에게 남아 있습니다.
동서양 고전이 주는 균형 감각
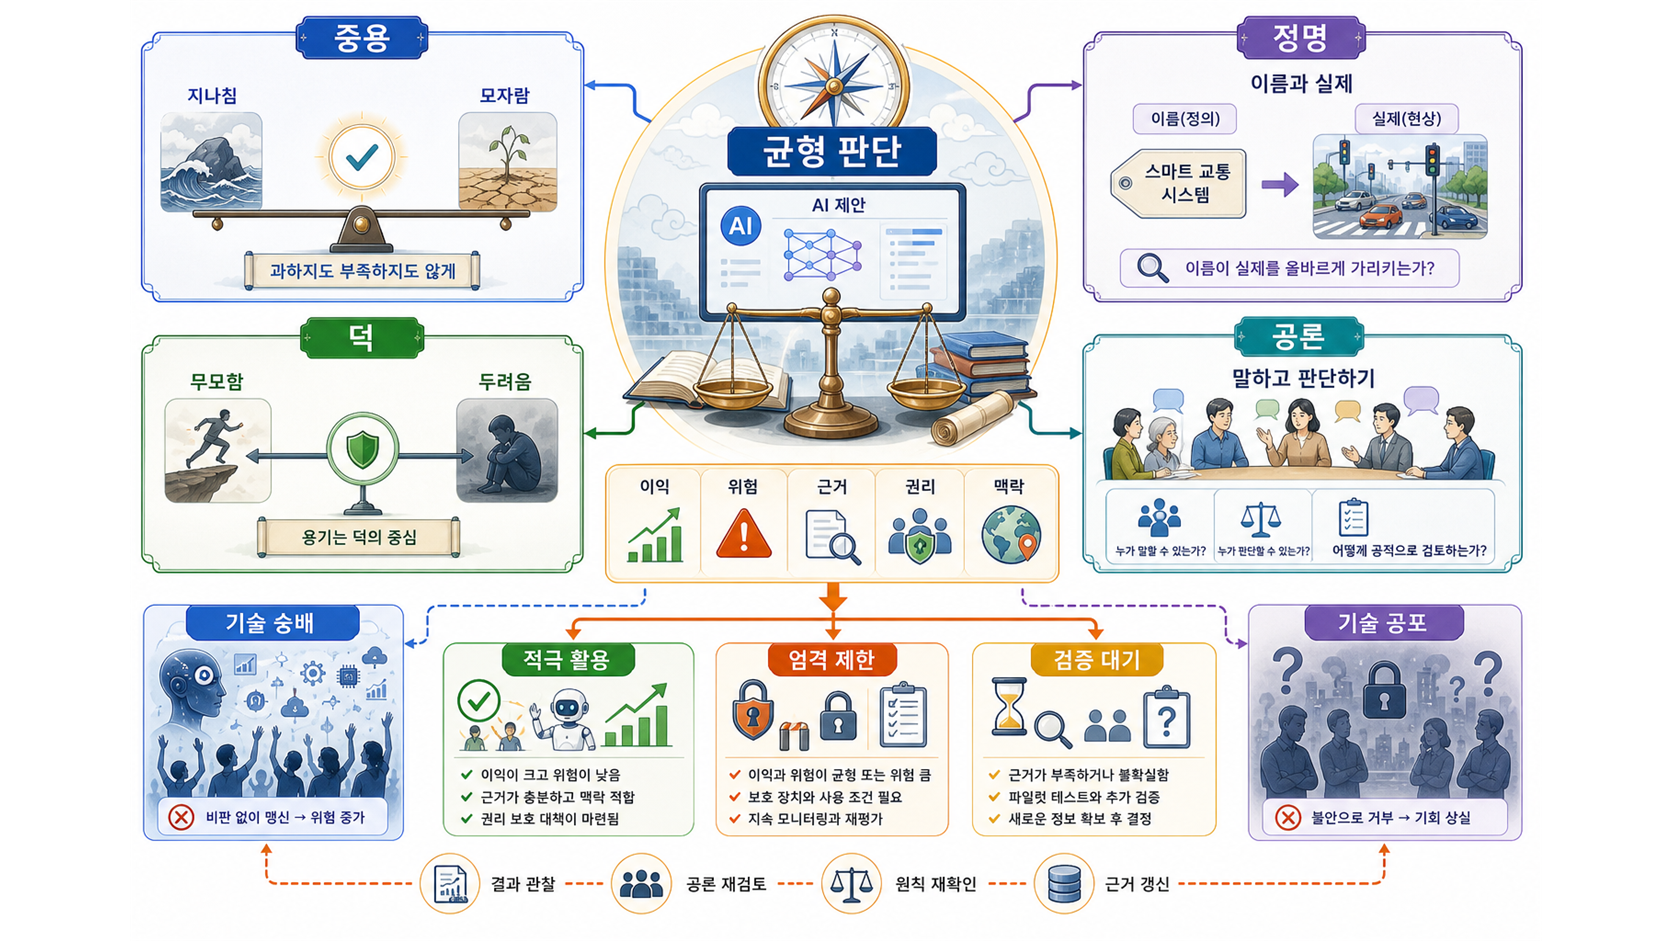
고전은 새로운 기술을 멈추게 하는 과거가 아니라, 절제와 책임, 개인과 공동체의 균형을 다시 살피게 하는 나침반입니다.
고전은 오래된 문장이 아니라 오래 살아남은 질문입니다. 인간은 어떻게 배워야 하는가, 권력은 무엇으로 정당화되는가, 자유는 어디에서 방종으로 바뀌는가, 지식은 어떤 책임을 동반하는가. 이런 질문은 기술이 발전할수록 사라지는 것이 아니라 더 날카로워집니다. AI 시대에 고전이 필요한 까닭도 여기에 있습니다. 고전은 새로운 기술을 거부하라고 말하지 않습니다. 다만 기술의 힘 앞에서 인간이 잃지 말아야 할 기준을 묻게 합니다.
공자는 혼란한 춘추 시대에 과거의 문헌과 예악 전통을 다시 읽었습니다. 그는 주나라의 문헌과 제도, 시와 예의 정신을 단순히 보존한 사람이 아니었습니다. 흩어진 전통 속에서 인간과 공동체가 다시 설 수 있는 언어를 길어 올렸습니다. 『시경』과 『서경』, 예와 음악의 전통은 공자를 거치며 동아시아 문명 특히 교육, 정치, 윤리의 중심 언어가 되었습니다. 공자가 남긴 고전의 힘은 낡은 권위를 반복하는 데 있지 않았습니다. 무너진 시대 속에서 다시 사람답게 살기 위한 기준을 세우는 데 있었습니다. 가령 공자의 정명(正名) 사상은 이름과 실제가 어긋나지 않아야 한다는 생각을 전합니다. AI 시대에는 자칫 ’지능’, ‘자율’, ‘공정’, ‘동반자’ 같은 말이 실제 능력보다 먼저 달려가기 쉽습니다. 이름이 과장되면 판단도 흐려집니다. AI가 통계를 계산하는 것인지, 결정을 내리는 것인지, 조언을 하는 것인지, 책임을 지는 것인지 구분해야 합니다. 이름을 바로 묻는 일은 기술 시대 시민의 지혜입니다.
서양 고전도 같은 방식으로 우리를 사로잡습니다. 도스토예프스키의 소설은 현대 문학과 심리, 실존적 사유의 중요한 기반이 되었습니다. 그는 인간을 합리적 계산만으로 움직이는 존재로 보지 않았습니다. 죄책감과 욕망, 자유와 자기기만, 구원과 파괴의 충동이 한 사람 안에서 어떻게 뒤얽히는지 집요하게 보여 주었습니다. 『죄와 벌』과 『카라마조프가의 형제들』이 오래 읽히는 까닭은 인간이 단순한 문제풀이 기계가 아니라, 스스로를 설득하고 속이며 책임 앞에서 흔들리는 존재라는 사실을 드러내기 때문입니다. 이 통찰은 AI 시대에도 중요합니다. AI는 인간의 선택을 예측하고, 취향을 분석하며, 행동을 유도할 수 있습니다. 그러나 인간을 데이터의 패턴으로만 보면 중요한 것이 빠집니다. 사람은 효율만으로 움직이지 않고, 의미와 두려움, 인정 욕구와 죄책감, 사랑과 책임 속에서 선택합니다. 도스토예프스키가 현대 문화에 남긴 힘은 바로 이 복잡한 인간을 단순화하지 말라는 경고에 있습니다.
AI는 고전을 새롭게 읽는 데 큰 도움을 줄 수 있습니다. 어려운 문장을 풀어 주고, 번역을 비교하며, 서로 다른 시대와 문명의 개념을 연결해 줄 수 있습니다. 공자의 예와 정명, 아렌트의 공적 세계, 도스토예프스키의 자유와 책임을 한자리에서 비교하도록 도울 수도 있습니다. 그러나 AI가 고전의 지혜를 대신 살아 줄 수는 없습니다. 고전은 정보를 얻는 창고가 아니라, 자신의 삶과 시대를 비추어 보는 거울이기 때문입니다. 좋은 AI는 고전을 대체하는 기술이 아니라, 더 많은 사람이 고전에 접근하도록 돕는 기술이어야 합니다. 어려운 문헌을 쉽게 안내하고, 다양한 해석을 나란히 보여 주며, 질문을 더 깊게 만드는 도구가 될 수 있습니다. 그러나 마지막 판단은 독자와 공동체에게 남아야 합니다. 어떤 문장을 오늘의 삶에 적용할지, 어떤 해석이 위험한 단순화인지, 어떤 지혜가 지금의 기술 문명에 필요한지는 사람이 함께 토론해야 합니다.
기술 문명은 고전의 지혜와 만날 때 더 성숙할 수 있습니다. 공자가 오래된 문헌을 통해 무너진 시대의 질서를 다시 물었듯이, 우리는 AI라는 새로운 힘 앞에서 인간과 공동체의 기준을 다시 물어야 합니다. 도스토예프스키가 인간 내면의 어둠과 자유를 파고들었듯이, 우리는 AI가 편리하게 정리해 주는 세계 너머에서 인간의 책임과 모순을 직시해야 합니다. 고전이 전하는 결론은 거창하지 않습니다. 빠른 답보다 좋은 판단이 오래갑니다. 좋은 판단은 기술의 힘을 인정하면서도 그 힘이 넘어서는 안 될 경계를 잊지 않는 데서 시작합니다. AI는 우리의 지적 능력을 넓힐 수 있지만, 그 능력을 어디에 쓸지는 고전이 오래 묻고 인간이 다시 답해야 할 질문입니다. 균형 감각은 과거에 머무는 태도가 아닙니다. 더 빠른 미래를 더 인간답게 맞이하기 위한 가장 오래된 기술입니다.
12.9 현대 시민 교양의 새 목록
과거의 교양이 문학과 역사, 철학과 예술을 통해 인간을 이해하는 일이었다면, 오늘날의 교양은 여기에 과학기술의 언어를 더해야 합니다. 기술이 더 이상 삶의 바깥에 놓인 도구가 아니기 때문입니다. AI는 우리가 보는 정보의 순서를 바꾸고, 행정과 교육, 의료와 노동의 판단에 참여하며, 때로는 우리가 스스로를 이해하는 방식까지 바꿉니다.
현대 시민 교양의 새 목록
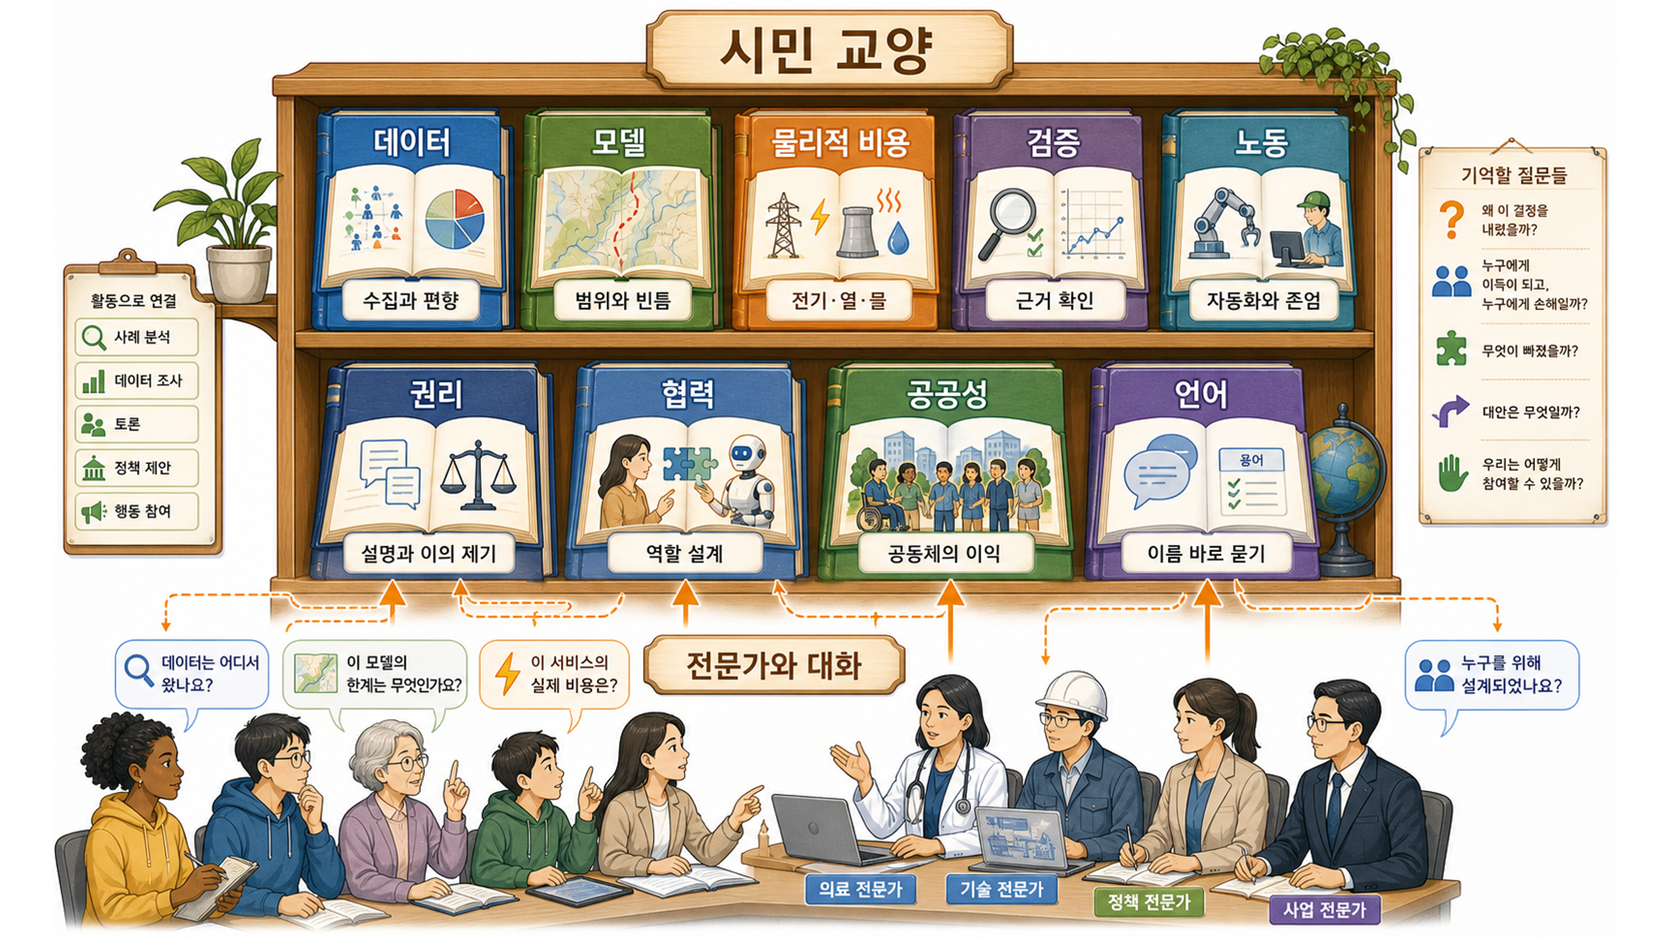
AI 시대의 시민 교양은 기술 지식 한 권으로 이루어지지 않습니다. 물리학과 데이터, 윤리와 법, 역사와 철학, 민주주의와 환경이 함께 꽂힌 열린 책장에 가깝습니다.
현대 시민 교양의 첫 번째 목록은 데이터를 읽는 눈입니다. 어떤 자료가 어디에서 왔는지, 누구의 경험이 포함되고 누구의 경험이 빠졌는지 물을 수 있어야 합니다. 예를 들어 복지 대상자를 찾는 AI가 있다면, 그 모델이 어떤 가구의 정보를 충분히 배웠는지, 서류에 잘 남지 않는 빈곤과 돌봄의 현실을 놓치지는 않았는지 살펴야 합니다. 데이터는 현실의 거울이지만, 모든 현실을 고르게 비추는 거울은 아닙니다.
두 번째는 AI 모델을 지도처럼 읽는 감각입니다. 지도는 길을 알려 주지만 땅 자체는 아닙니다. AI의 예측도 마찬가지입니다. 의료 위험도, 학습 진단, 채용 추천, 기후 예측이 유용할 수 있지만, 그것이 현실 전체를 대신하지는 않습니다. 시민은 AI의 답을 그대로 받아들이기보다 “어떤 조건에서 맞는가?”, “어떤 사람에게 약할 수 있는가?”, “틀렸을 때 바로잡을 방법은 있는가?”를 물을 수 있어야 합니다.
세 번째는 기술의 몸을 보는 시선입니다. 매끄러운 화면 뒤에는 반도체와 전력망, 데이터센터와 냉각 장치, 광산과 노동이 있습니다. AI는 구름처럼 보이지만 땅 위의 시설에서 작동합니다. 시민 교양은 디지털 편리함의 물질적 비용도 함께 묻습니다. 이 서비스가 얼마나 많은 계산을 요구하는지, 그 계산이 어떤 전력과 자원 위에서 이루어지는지, 이익과 부담이 누구에게 돌아가는지 살펴야 합니다.
네 번째는 이유를 요구하고 이의를 제기하는 목소리입니다. 자신에게 영향을 미치는 AI 판단이 어떻게 내려졌는지 설명을 들을 수 있어야 합니다. 학교의 평가, 복지 심사, 채용 추천, 대출 판단에 AI가 쓰인다면 시민은 결과만 통보받는 대상이 되어서는 안 됩니다. 어떤 기준이 적용되었고, 오류가 있다면 어떻게 수정할 수 있는지 알 권리가 있습니다. 설명을 요구하는 능력은 기술 시대의 시민권입니다.
AI는 이러한 시민 교양을 약화시킬 수도 있지만, 잘 쓰이면 오히려 강화할 수 있습니다. 어려운 정책 문서를 쉬운 말로 풀어 주고, 예산 자료를 비교해 주며, 법률과 행정 절차를 시민이 이해할 수 있게 도울 수 있습니다. 청각·시각 장애가 있는 시민에게 자막과 음성, 이미지 설명을 제공하고, 외국어 자료를 번역해 참여의 문턱을 낮출 수도 있습니다. AI는 시민을 대신해 판단하는 기계가 아니라, 시민이 더 잘 묻고 더 넓게 참여하도록 돕는 도구가 되어야 합니다. 교육 현장에서도 AI는 시민 교양의 훈련 도구가 될 수 있습니다. 학생은 AI가 만든 답을 그대로 제출하는 대신, 그 답의 근거를 확인하고 오류를 찾아내며 다른 설명과 비교할 수 있습니다. 지역의 환경 문제를 조사할 때 AI는 자료를 모으고 그래프를 만들고 관련 법규를 요약할 수 있습니다. 그러나 어떤 자료를 믿을지, 누구의 의견을 더 들어야 할지, 어떤 해결책이 공정한지는 학생과 교사가 함께 판단해야 합니다. 이 과정에서 AI는 정답 제조기가 아니라 질문 훈련장이 됩니다.
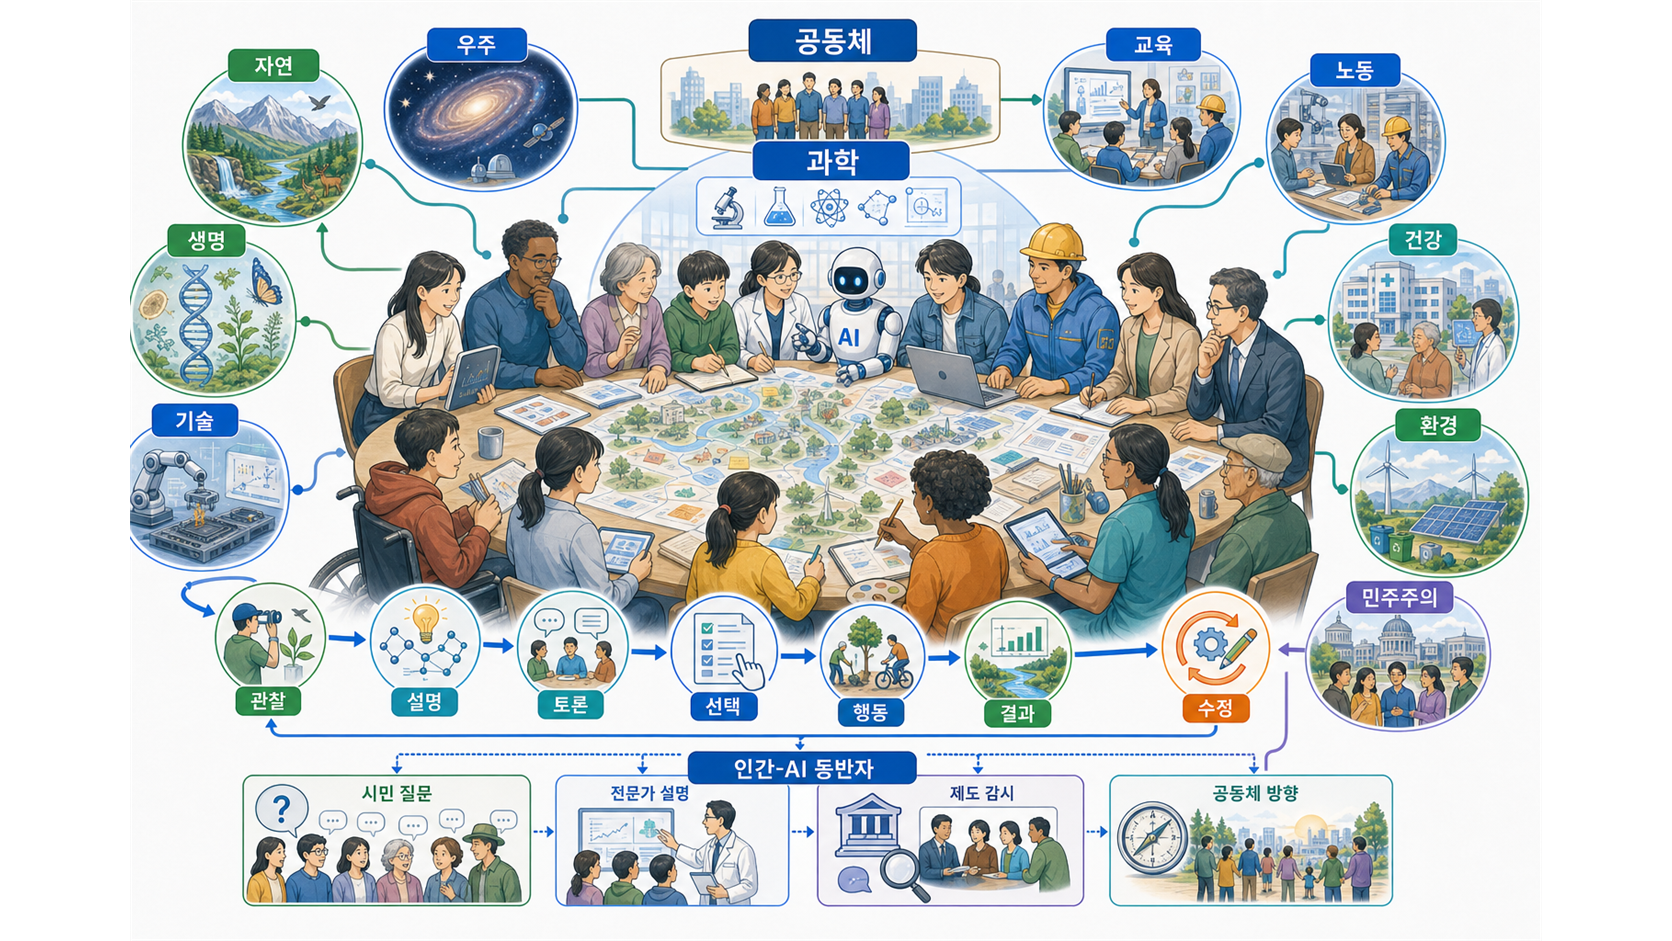
과학은 전문가의 지식 창고에 머무르지 않습니다. 시민과 과학자, 학생과 노동자가 자연과 생명, 우주와 AI를 함께 바라보며 자신들이 어떤 세계를 만들고 있는지 성찰하는 공동의 언어입니다.
시민 교양은 전문가가 되기 위한 목록이 아닙니다. 전문가와 대화하고, 기업과 정부에 설명을 요구하며, 동료 시민과 기술의 방향을 의논하기 위한 언어입니다. AI를 이해한다는 것은 기계의 구조를 모두 아는 일이 아닙니다. 그 기계가 바꾸는 세계 안에서 소비자로만 머물지 않고 시민으로 살아가는 법을 배우는 일입니다. 과학은 자연을 설명하는 지식인 동시에 공동체의 자기 이해입니다. 어떤 문제를 연구하고, 어떤 위험을 감수하며, 발견의 혜택을 누구와 나눌 것인지에는 그 사회의 가치가 담깁니다. AI도 우리가 던지는 질문과 정한 목표를 따라 움직입니다. 더 많은 속도와 이익만 요구하면 그 방향으로 달리고, 돌봄과 안전, 공정과 지속 가능성을 함께 묻는다면 다른 가능성을 찾게 됩니다.
앞으로의 세계를 결정하는 것은 더 영리한 기계만이 아닙니다. 기계 앞에서도 질문을 잃지 않고, 서로의 삶을 들으며, 필요할 때 멈추고 방향을 바꿀 수 있는 시민의 지혜입니다. 현대 시민 교양은 바로 그 지혜를 위한 새 목록입니다. 데이터를 읽고, 모델의 한계를 알고, 기술의 몸을 보며, 설명을 요구하고, AI를 더 나은 공동체를 위한 도구로 다루는 능력입니다.
에필로그
질문을 잃지 않기 위한 지도
이 책은 인공지능을 따라가다가 물리학을 만났고, 물리학을 따라가다가 다시 인간과 사회의 문제로 돌아왔습니다. 처음에는 낯선 말들이 높은 문턱처럼 느껴졌을지 모릅니다. 하지만 이 책이 독자 여러분께 꼭 남기고 싶은 것은 용어의 목록이 아닙니다.
제가 이 책을 쓴 이유는 조금 단순합니다. 인공지능이 아무리 빠르고 거대해 보여도, 우리가 그 앞에서 적어도 다음과 같은 질문을 놓치지 않았으면 했습니다.
이 AI는 무엇을 근거로 답했는가? 그 대답이 틀릴 수 있다면 어디에서 틀릴 수 있는가? 그 결과가 우리의 삶을 바꿀 때, 누가 설명하고 책임지는가?
이 질문들을 품고 있다면 복잡한 수식을 모두 알지 못해도 인공지능과 대화를 시작할 수 있습니다. AI는 단백질 구조를 예측하고, 새로운 물질을 제안하며, 날씨와 우주의 희미한 신호를 읽어 냅니다. 그러나 후보와 발견은 다르고, 예측과 이해도 다릅니다. 컴퓨터가 가능성을 보여 줄 수는 있어도, 자연이 실제로 그런지는 실험과 관측으로 다시 물어야 합니다. 과학의 오래된 겸손은 AI 시대에도 여전히 필요합니다.
앞으로 AI는 글과 그림뿐 아니라 의료와 교육, 연구와 행정, 노동과 정치의 풍경까지 크고 빠르게 바꾸어 갈 것입니다. 어떤 변화는 우리를 위험하고 지루한 반복에서 벗어나게 할 것입니다. 그러나 어떤 변화는 새로운 감시와 불평등을 가져올 수도 있습니다. 그 변화의 방향은 기술만으로 결정되지 않습니다. 우리가 어떤 목적을 세우고, 어떤 규칙을 만들며, 누구의 목소리를 들을 것인가에 따라 달라집니다.
시민의 한 사람으로서 독자 여러분은 인공지능이 갖지 못한 능력을 이미 가지고 있습니다. 상상하고, 질문하고, 의심하고, 공감하고, 경험하며, 다시 도전하는 능력입니다. 물리학을 배운다는 것은 이 감각을 버리고 수식만을 믿는 일이 아닙니다. 오히려 인간을 이해하는 언어 위에 자연과 기술을 읽는 언어를 하나 더 놓는 일입니다.
물리학은 우리가 살아가는 세계의 조건을 보여 줍니다. 인문학은 그 조건 속에서 어떤 삶을 선택할 것인지 묻습니다. 시민 교양은 이 두 언어가 서로 등을 돌리지 않게 하는 다리입니다. AI 시대에 필요한 교양은 기술을 숭배하는 태도도, 무작정 두려워하는 태도도 아닙니다. 기술의 힘을 인정하되, 그 힘이 무엇을 놓치고 누구에게 영향을 미치는지 묻는 태도입니다.
끝까지 이 길을 함께 걸어 주신 독자 여러분께 깊이 감사드립니다. 어려운 개념 앞에서 책장을 덮지 않고, 익숙한 비유와 일상의 장면을 따라 여기까지 와 주신 여러분의 호기심이 이 책을 완성했습니다. 부디 이 책이 더 좋은 질문을 함께 시작할 수 있는 작은 지도가 되었으면 합니다.
이제부터는 여러분의 시간입니다. 새로운 AI와 낯선 기술을 만났을 때 잠시 멈추어 그것이 무엇을 보고, 무엇을 놓치며, 누구의 삶을 바꾸는지 바라보십시오. 이해되지 않는다면 당당히 이유를 물어 주십시오. 설명을 요구하는 일은 무례가 아니라 시민의 권리입니다.
AI가 어느 길로 나아갈 것인지 정하는 일은 여전히 인간의 몫입니다. 이 책의 마지막 문장이 끝난 뒤에도 여러분의 질문이 오래 이어졌으면 합니다. 그 질문들이 모여 AI가 인간의 존엄과 지구의 미래를 돌보는 방향으로 흐르게 하는, 작지만 당당한 물길이 되기를 기대해 봅니다.